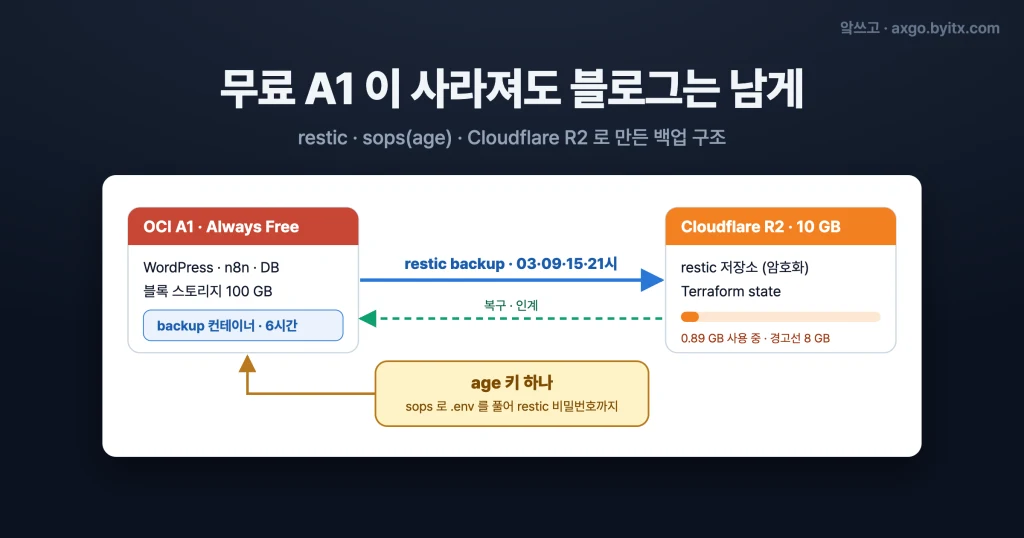
이 블로그는 오라클 클라우드의 Always Free A1 인스턴스 한 대에서 돈다. 서버비는 0원이다. 그런데 이 공짜에는 단서가 붙는다. 오라클은 7일 동안 CPU·네트워크·메모리 사용률이 모두 20% 아래인 무료 인스턴스를 회수할 수 있다고 문서에 적어 두었다. 정책이 바뀔 수도 있고 계정에 문제가 생길 수도 있다. OCI VM에 OS부터 워드프레스까지 힘들게 구성해 놓은 블로그를 갑자기 뺏어가버려도 Always Free 사용자는 어찌할 도리가 없다는 말이다.
아래의 OCI 문서의 내용을 이유로 인스턴스를 회수 당했을 경우, 다시 Always Free A1 인스턴스 한대를 다시 만드는 것도 쉽지만은 않은 일이다. 지난 9월 오사카 리전에서 A1 한 대를 만드는 데 3,132번 시도하면서 70시간 38분이 걸렸다. Always Free 인스턴스 할당량 자체가 너무 적은게 현실이다.
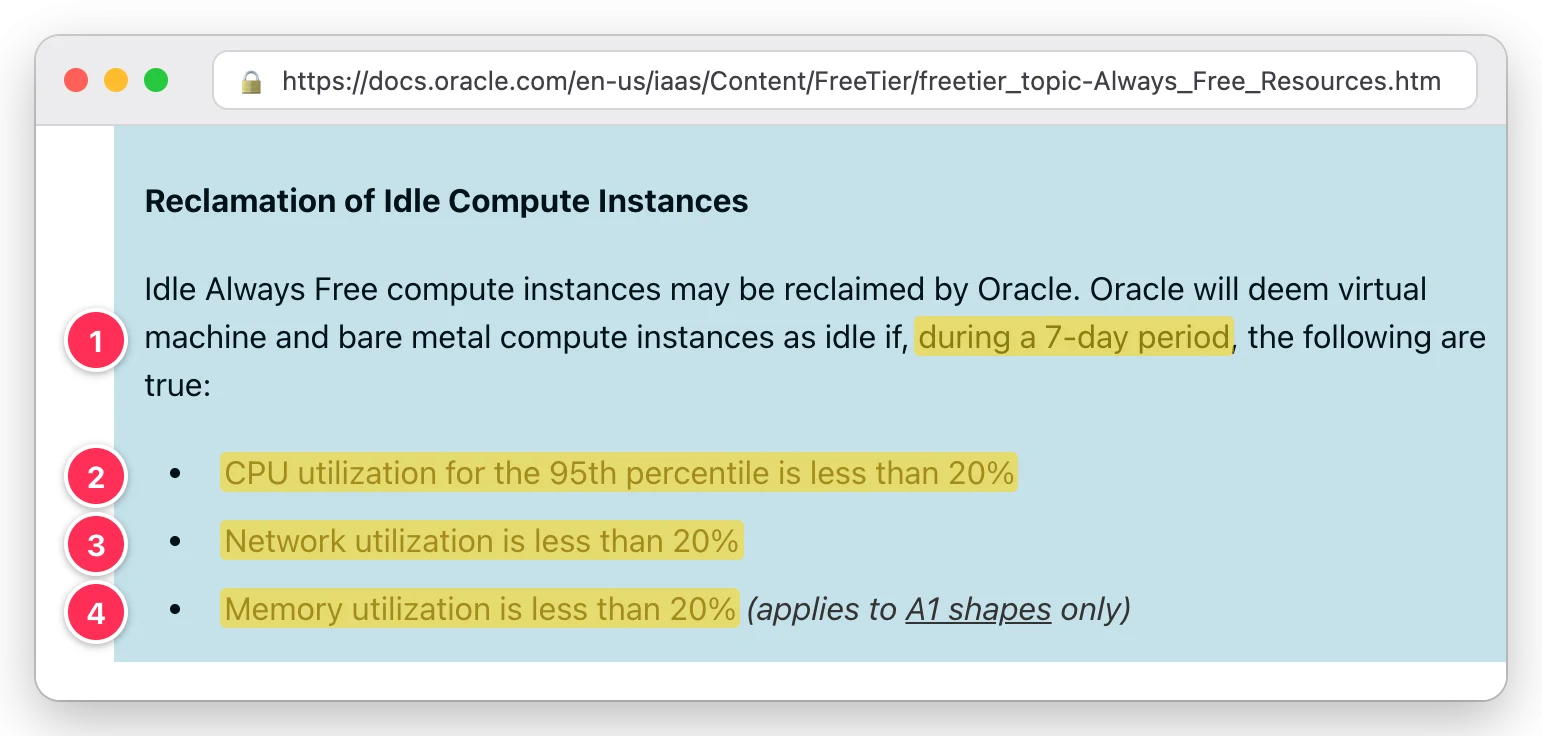
때문에 A1 인스턴스가 언제든 갑자기 없어져도 멀쩡히 복구할 수 있는 대상으로 만들어 둬야했다. 또한, 복구가 가능한 백업을 오라클 클라우드 밖에 보관하는 원칙을 지키고자 했다.
IT 일을 하면서 공포스러운 그 장면을 여러 번 봤다.(식은땀이 주르륵…) 잘 돌아갈 때 백업은 아무 일도 하지 않는 비용처럼 보이기도 한다. 디스크가 날아가고 모든 것이 한순간 휘발되는 공포를 겪은 뒤에야 그 비용에 의미를 참 아프게(?) 배운다. 그래서 이 블로그는 서버보다 백업을 먼저 설계했다.
이 글에서는 byitx.com의 백업이 어떤 구조로 만들어져 있는지 정리했다. restic 이 6시간마다 A1 의 데이터를 Cloudflare R2 로 올린다. restic 을 암호화하는 비밀번호는 sops 로 암호화한 .env 안에 있고 .env 는 age 키 하나로 연다. 또한 R2 는 Terraform 상태 저장소로도 사용되도록 했다. 끝에는 지금 실제로 얼마를 쓰고 있고 무료 10 GB 로 몇 년을 버틸 수 있는지도 계산했다. 무료 구성 요소들로 고민했던 과정은 앞 글에 적었다.
목차
전체 구조 — 무료 서비스 세 곳과 키 하나
백업 대상은 블로그가 도는 OCI A1, 백업이 쌓이는 Cloudflare R2(AWS S3 호환), 코드와 age키로 암호화된 설정(.sops.env)이 저장된 GitHub Private 저장소, 그리고 이 모든 것을 관리 가능한 곳은 내 Local Mac 이다.
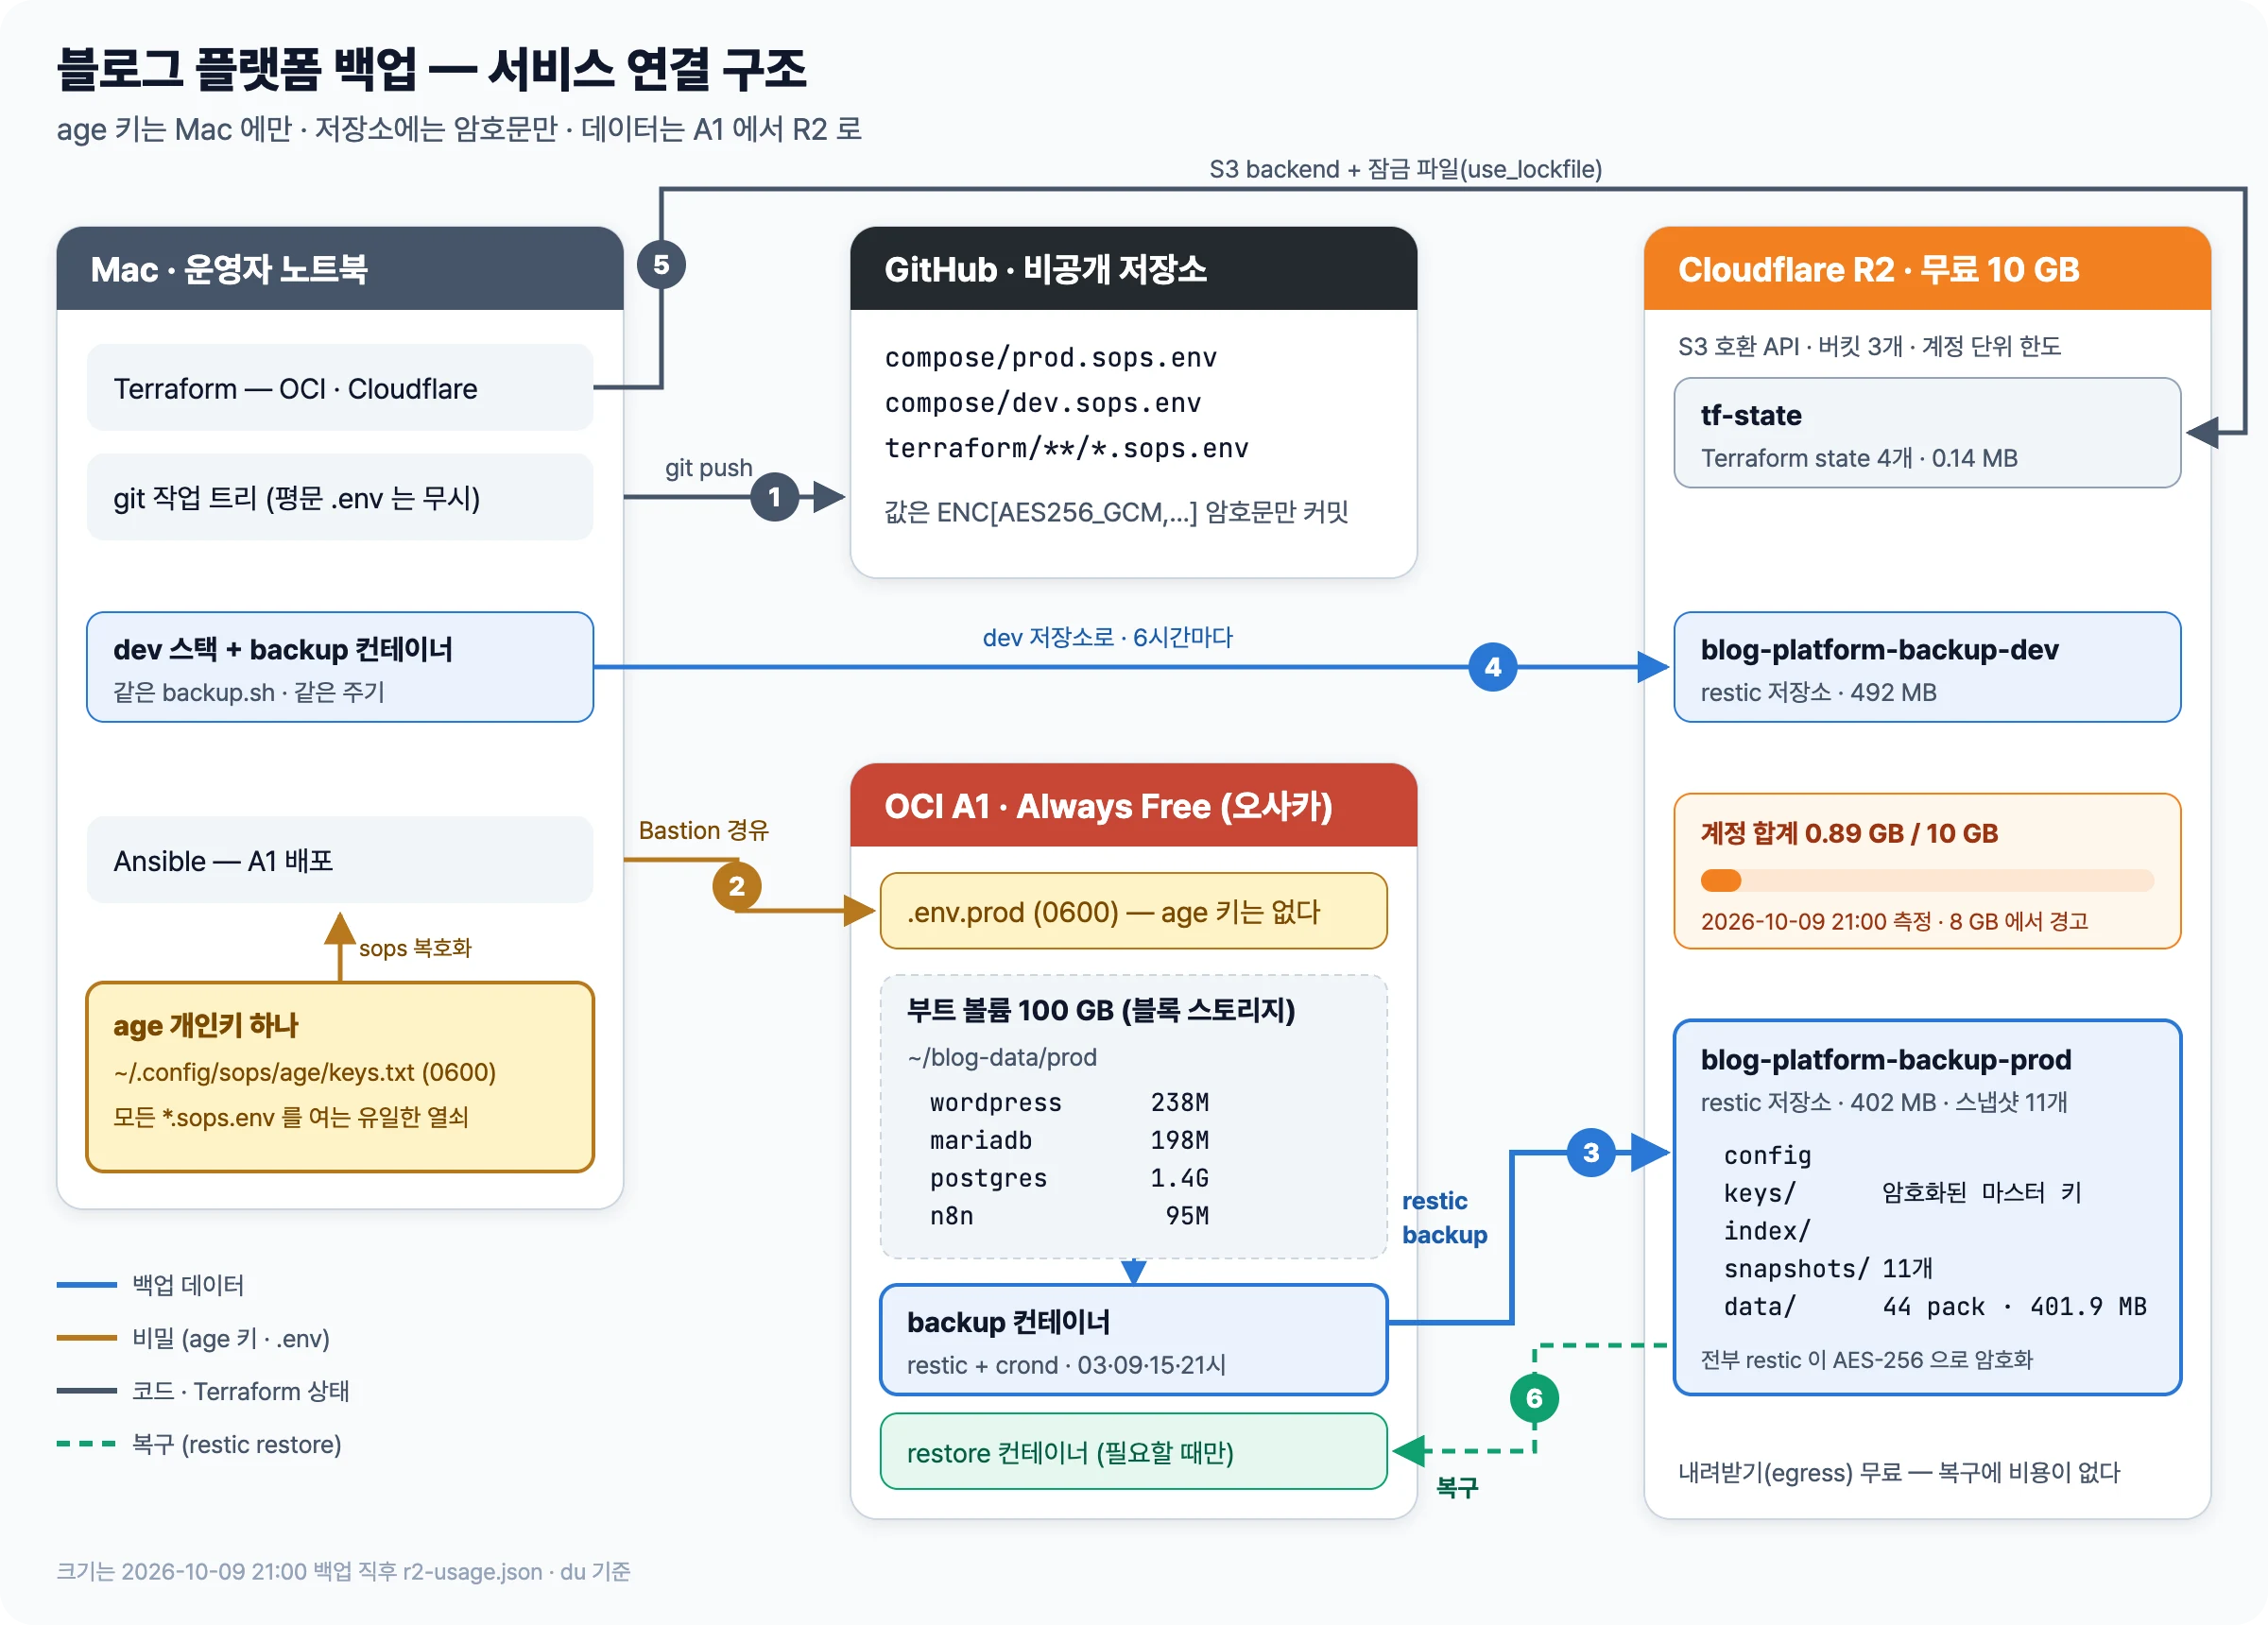
그림의 번호를 따라가면 이렇다.
- ① Mac 에서 고친 코드와 암호화된
.sops.env파일은 git 으로 GitHub 에 올라간다. 평문.env는.gitignore에 등록해 올라가지 않도록 했다. - ② A1 에 배포할 때는 Mac 의 Ansible 이 sops 파일을 풀어
.env를 만들고 OCI Bastion 을 거쳐 git archive 로 소스코드를 전송하면서 권한 0600 으로 보낸다. A1 에는 age 키도 sops 도 없다. - ③ A1 의 backup 컨테이너가 하루 네 번 restic 으로 데이터를 R2 의 prod 저장소에 올린다.
- ④ Mac 의 dev 스택도 같은 backup 컨테이너를 돌려 dev 저장소에 따로 쌓는다.
- ⑤ Terraform 은 OCI 와 Cloudflare 의 state 파일을 같은 R2 계정의
tf-state버킷에 둔다. - ⑥ 복구할 때는 어느 기계든 R2 에서 스냅샷을 내려받아 restore 컨테이너로 되살릴 수 있다.
| 구성 | 맡은 일 | 무료 범위 |
|---|---|---|
| OCI A1 (오사카) | 블로그 실행, 데이터는 부트 볼륨 100 GB 에 | Arm 2 OCPU · 메모리 12 GB · 블록 스토리지 200 GB |
| Cloudflare R2 | restic 저장소 2개 + Terraform 상태 | 저장 10 GB-월, Class A 100만 · Class B 1,000만 회, 내려받기 무료 |
| GitHub 비공개 저장소 | 코드와 암호화된 설정 | 무료 |
| Mac | age 키 보관, Terraform·Ansible 실행, 블로그 플랫폼의 dev 스택도 여기서 운영한다. | — |
당장 A1 이 사라져도 마지막 백업 뒤의 몇 시간만(최대 6h) 유실된다. 코드는 GitHub 에, 데이터는 R2 에, 그것을 여는 age 열쇠는 Mac 에 있다. 이 셋 가운데 age 열쇠는 다시 만들 수 없으니 요놈만 잘 보관하면 되는 구조다.
age 키 하나로 여는 sops 암호화 .env
처음에는 .env 가 평문 그대로 Mac 에만 있었다. DB 비밀번호, R2 키, restic 비밀번호가 다 거기 들어 있었다. 그 상태라면 Mac 을 잃는 순간 R2 에 백업이 멀쩡히 있어도 열 방법이 없다. 백업을 잘해 놓고도 복구를 할 수 없는 구조였던 셈이다.
그래서 .env 를 sops 로 암호화해 git 에 함께 넣었다. sops 는 dotenv 파일의 키 이름은 그대로 두고 값만 AES-256-GCM 으로 암호화한다. 값을 암호화한 데이터 키는 다시 age 공개키로 감싸 파일 끝에 붙인다. 공개키만 알면 누구나 암호화할 수 있고 푸는 것은 age 개인키를 가진 쪽만 할 수 있다.
② git 이 추적하는 sops 파일 7개
③ .gitignore 에 걸린 평문 .env.prod
④ 값만 암호화된 비밀
⑤ age 로 감싼 데이터 키와 공개키.
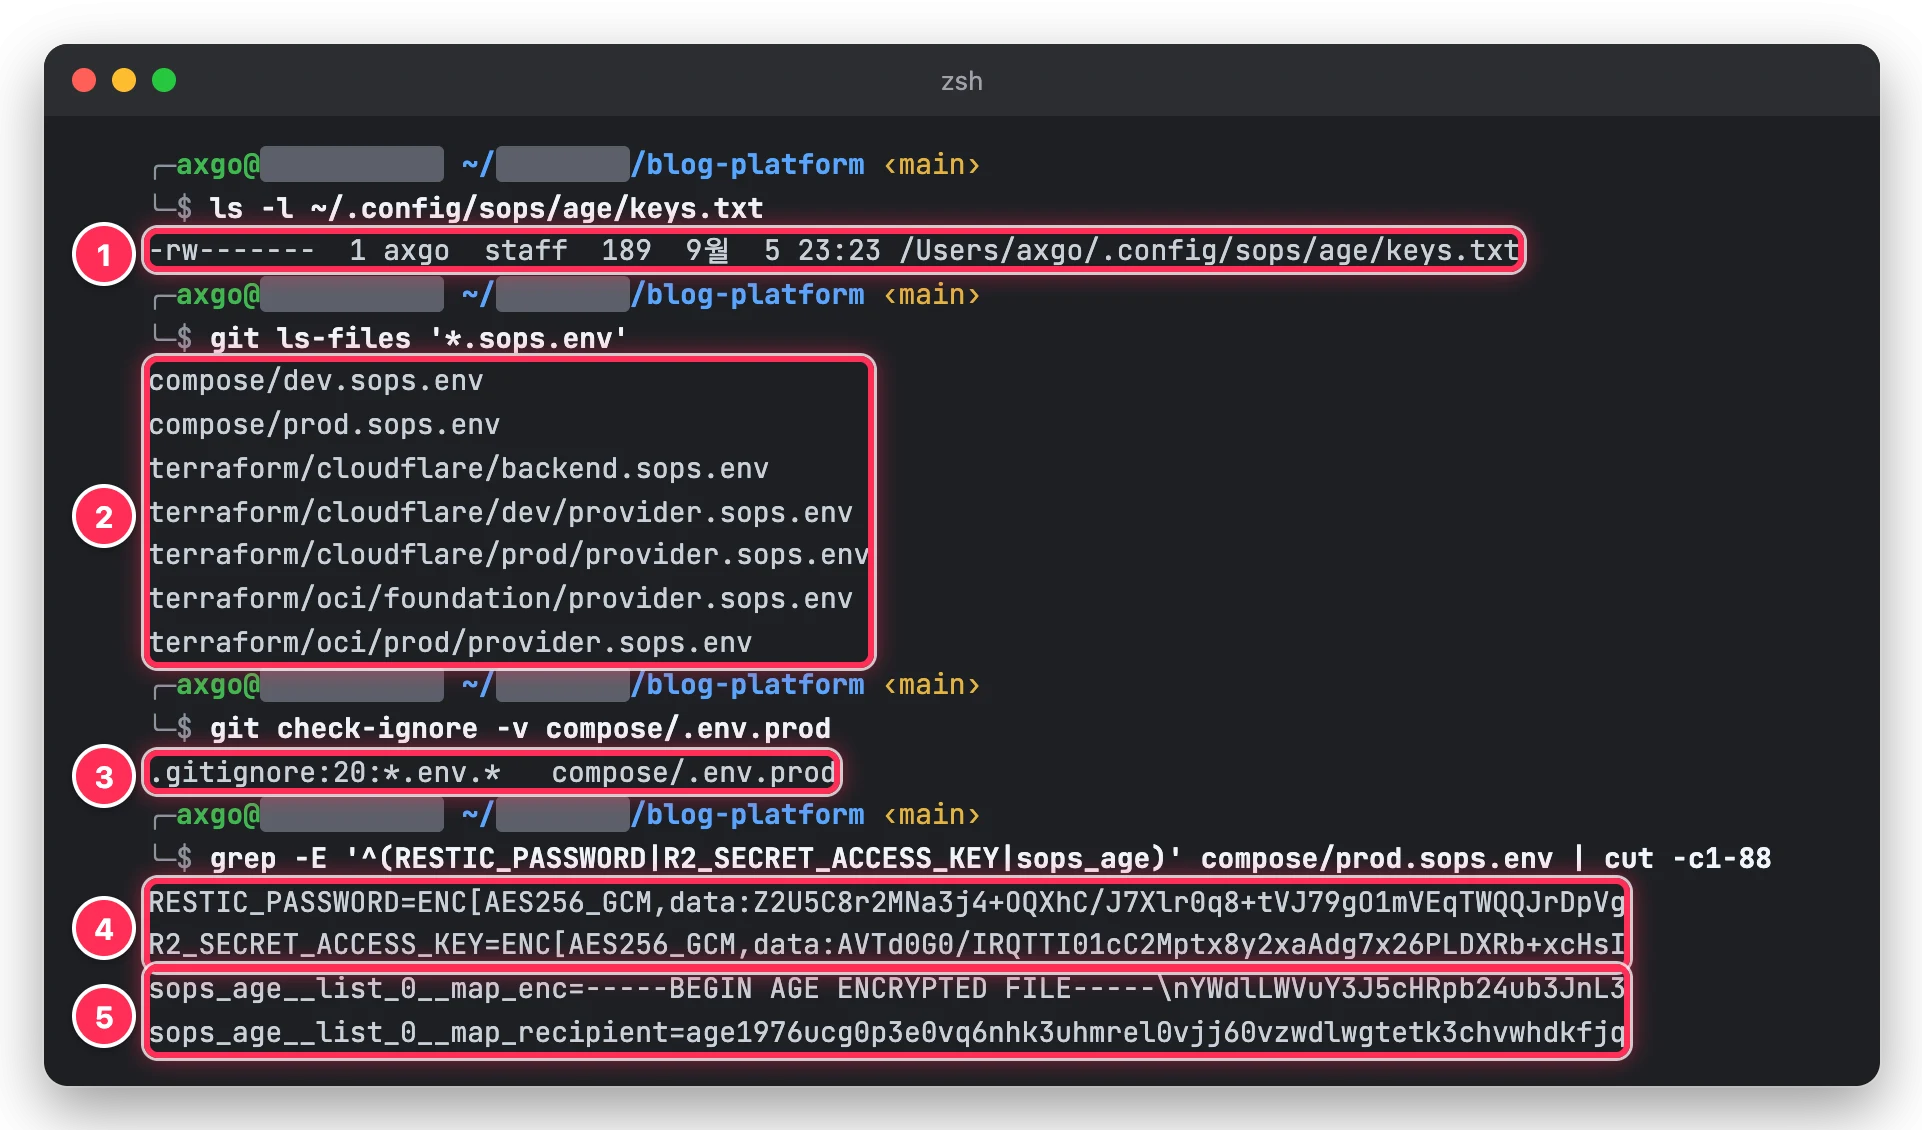
화면에서 ① 이 그 개인키다. 189바이트짜리 파일 하나이고 권한은 0600 이다. ② 는 git 이 추적하는 sops 파일 7개로, compose 의 dev·prod 설정과 Terraform 자격증명이 전부 여기 있다. ③ 은 평문 .env 가 .gitignore 로 제외되어 있다는 확인이다. ④ 를 보면 RESTIC_PASSWORD 와 R2 비밀 키의 값이 ENC[AES256_GCM,…] 로만 보인다. ⑤ 는 데이터 키를 age 공개키로 감싼 덩어리와 그 공개키(recipient)다.
평문과 암호문은 scripts/env.sh 스크립트로 양방향 전환이 가능하도록 했다.
scripts/env.sh encrypt prod   # .env.prod 의 주석·빈 줄을 지우고 prod.sops.env 로 암호화한 뒤 verify
scripts/env.sh decrypt prod   # prod.sops.env → .env.prod (0600)
scripts/env.sh verify prod    # 복호화 결과와 평문이 바이트 단위로 같은지 diff (값은 숨기고 키 이름만 출력)
Code language: Bash (bash)
sops 의 dotenv 형식은 주석을 평문으로 남기므로 암호화 전에 주석부터 지운다. 주석에 비밀번호를 메모해 둔 줄이 있으면 그대로 git 에 올라간다. 실제로 처음 옮길 때 게이트 비밀번호가 주석에 평문으로 있었고 그 비밀번호는 바꿨다. 설명이 필요한 주석은 값이 없는 .env.example 에만 두도록 했다.
A1 쪽은 더 단순하다. Ansible 이 Mac 에서 community.sops 로 파일을 풀어 메모리에 들고 있다가 A1 에 0600 파일로 쓴다. 이 단계는 no_log 로 로그에도 값이 남지 않는다. A1 에는 rsync·git·sops 가 아예 없고 알아야 할 값만 받는다.
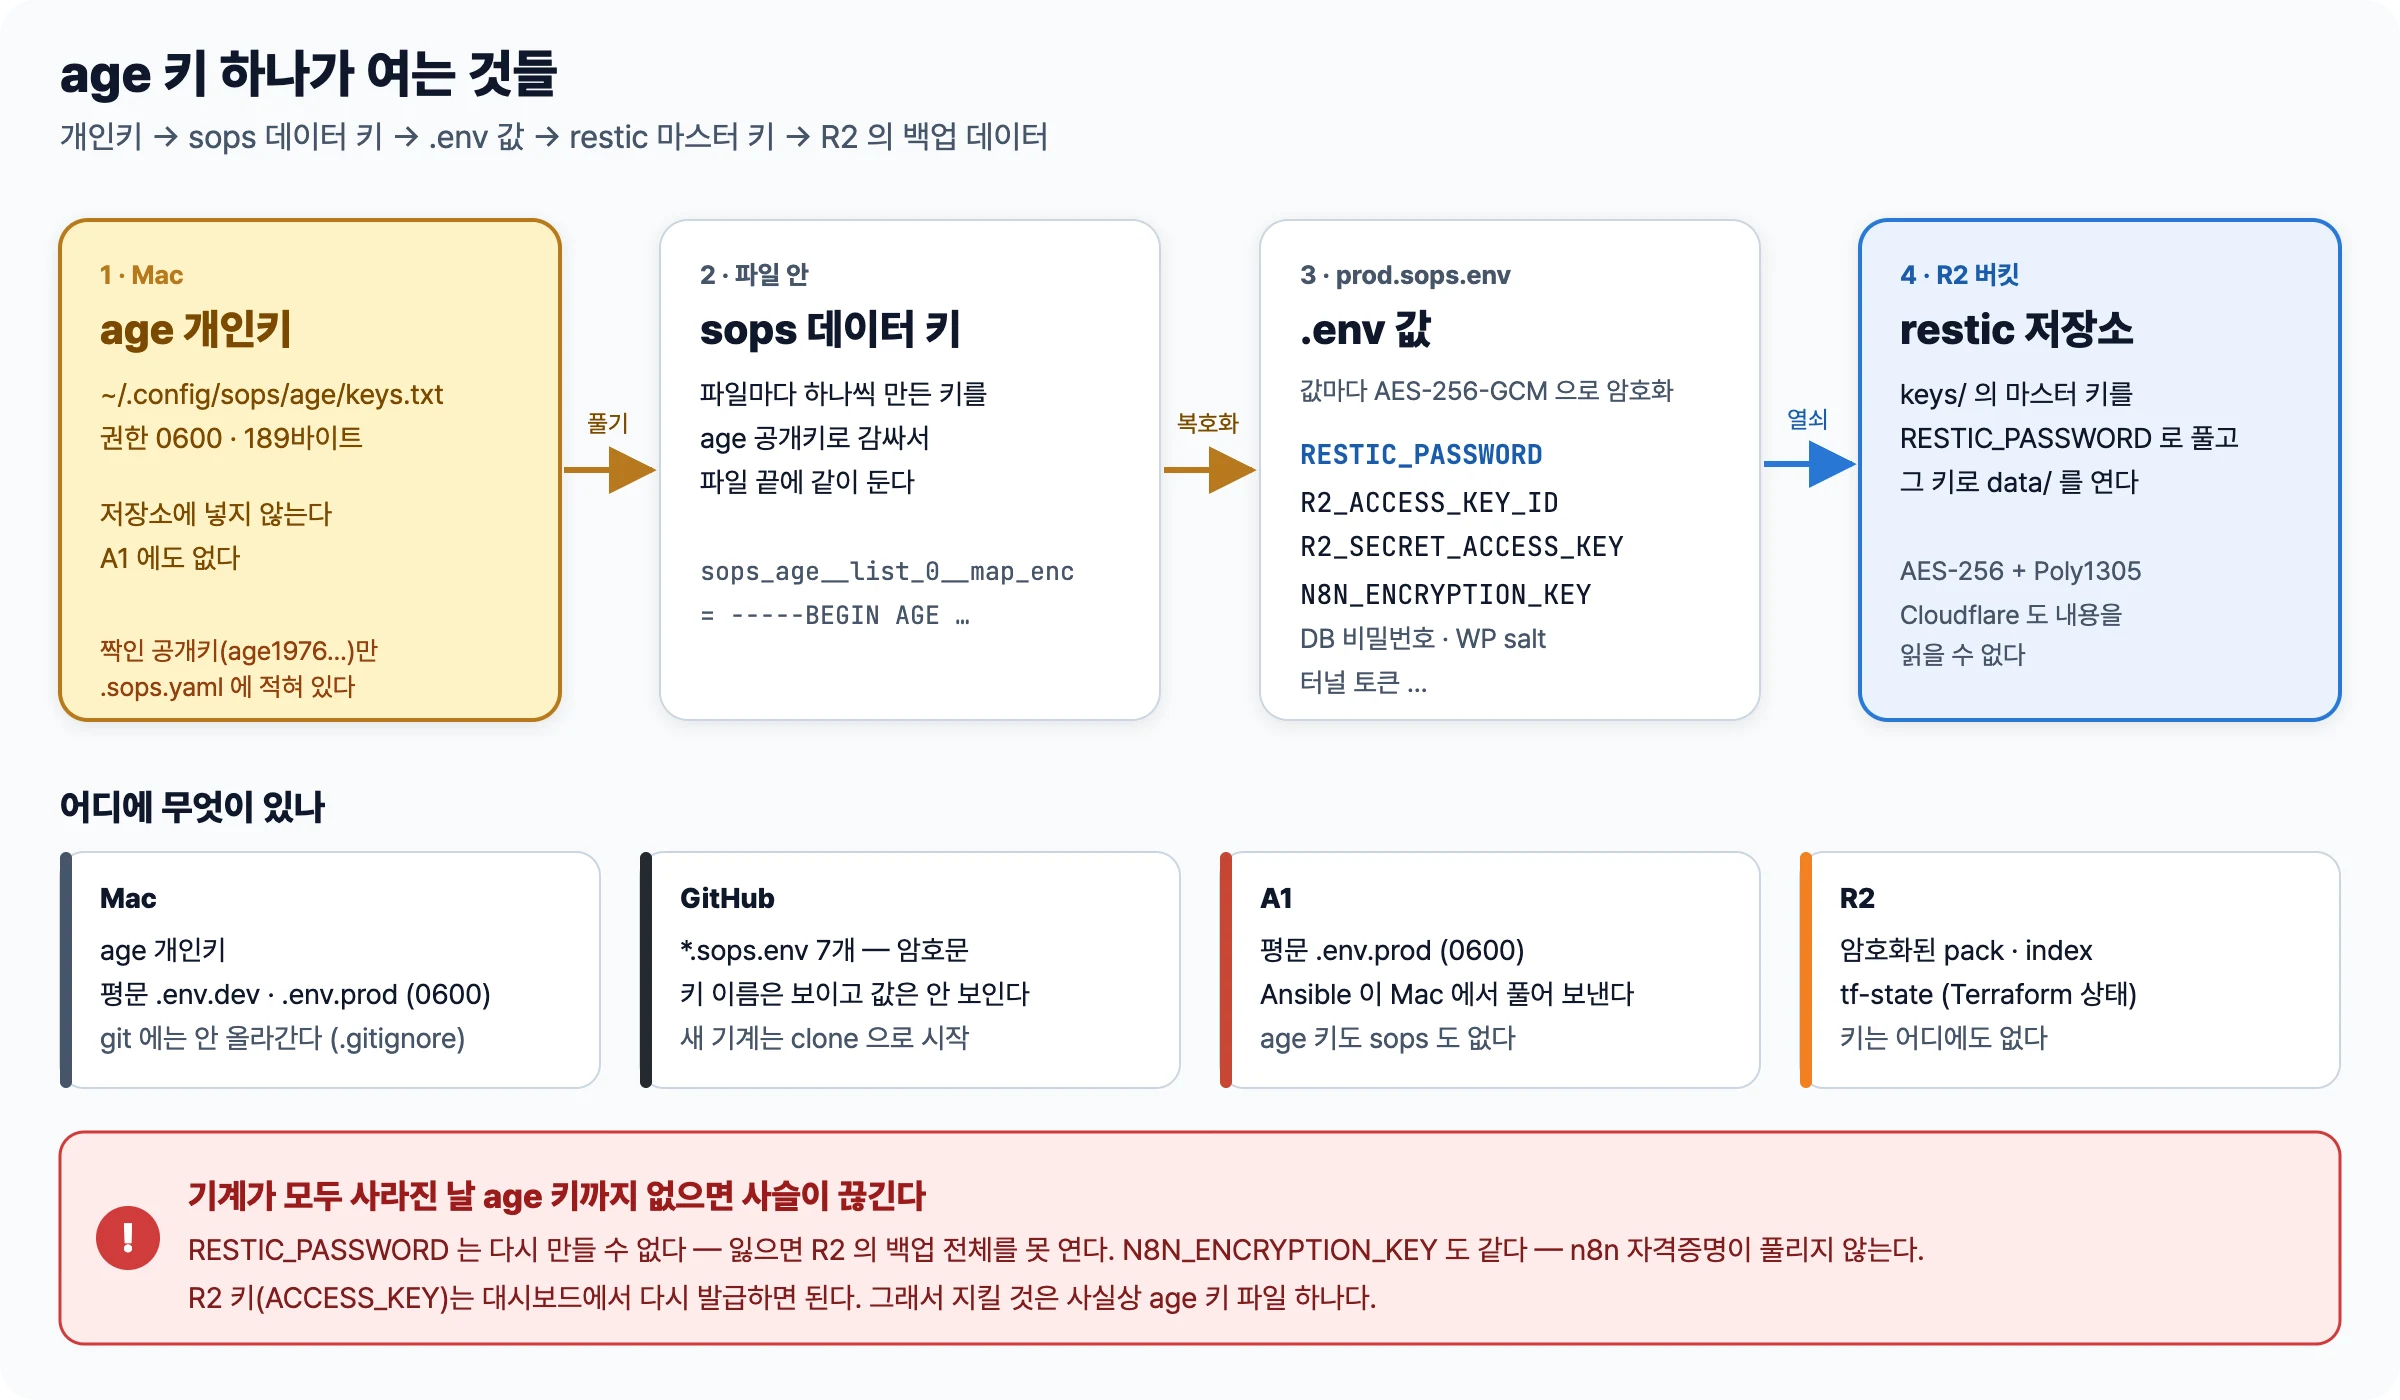
키 체인은 age 개인키에서 시작한다. 이 키가 sops 데이터 키를 풀고 데이터 키가 .env 값을 또 푼다. 그 안의 RESTIC_PASSWORD 가 R2 에 있는 restic 저장소의 마스터 키를 열수 있도록 해준다. restic 은 데이터를 AES-256 으로 암호화하고 Poly1305 로 무결성을 확인한다. R2 에 올라간 것은 전부 암호문이라 Cloudflare 도 내용을 읽을 수 없도록 했다.
① 비밀번호를 잃으면 데이터도 잃는다
② S3 호환 저장소
③ 저장소 주소 형식.
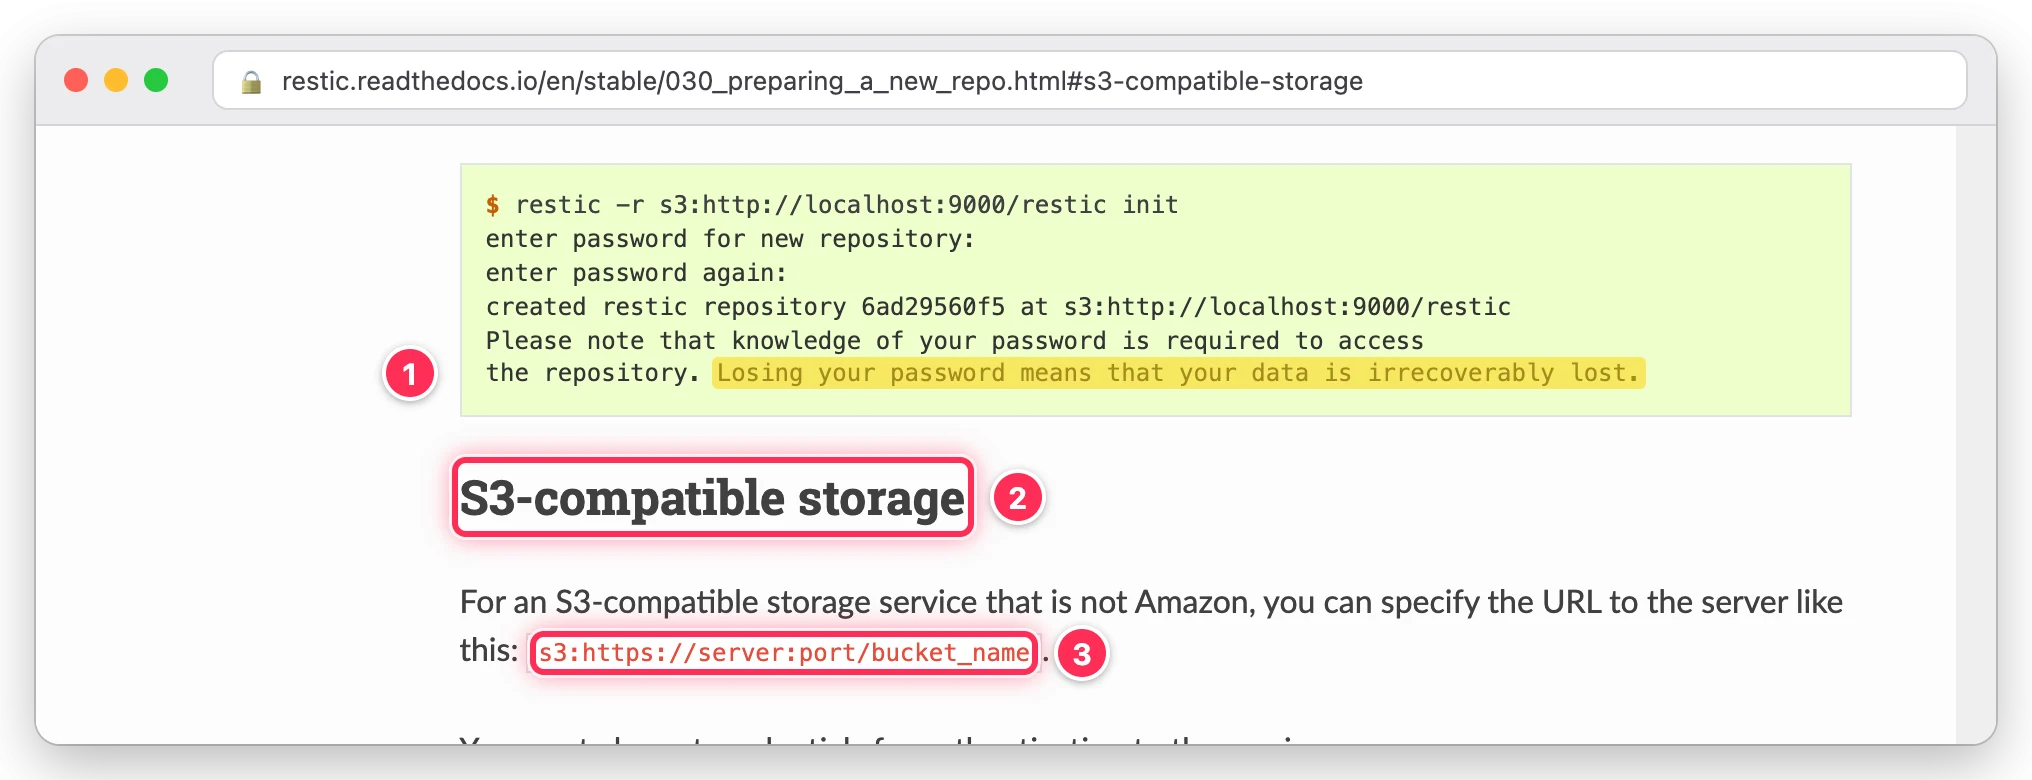
restic 문서는 이 비밀번호를 두고 분명하게 경고한다. ① 의 문장대로, 비밀번호를 잃으면 데이터는 되돌릴 수 없게 사라진다. R2 키는 대시보드에서 다시 발급하면 그만이다. 하지만 RESTIC_PASSWORD 와 n8n 자격증명을 암호화하는 N8N_ENCRYPTION_KEY 는 다시 만들 수 없다. 이 두 값은 sops 파일 안에 있고 sops 파일은 age 키로만 열린다. Mac 과 A1 이 동시에 사라지면서 age 키까지 없어져야 데이터 복구가 불가능해지는 구조다. 그래서 age 키 파일은 저장소에 절대 넣지 않고 Mac 밖에도 매우 은밀한(?) 여러 위치에 사본을 보관하고 있다. 이 파일 하나만 지키면 나머지는 git clone 한 번으로 쉽게 복구를 시작할 수 있다.
R2 10 GB — S3 호환 백업도, Terraform 백엔드도 가능하다
Cloudflare R2 는 Free Tier로 10 GB 를 사용가능 하며, 내려받기(egress) 요금도 없고! S3 API 와 호환돼서 매우 유용하다. 그중에서도 S3 호환이 가장 중요했다. S3 를 연동할 수 있는 도구라면 R2 를 그대로 착! 붙여 쓸 수 있다. restic 도, Terraform 도 S3 스토리지 호환성을 가지고 있기 때문에 R2를 연동해 사용할 수 있다.
restic 쪽은 위 문서 화면의 ② ③ 처럼 저장소 주소만 s3:https://… 로 주면 된다. compose로 올라오는 backup 컨테이너와 restore 컨테이너가 같은 백업 환경변수들을 사용한다.
# compose.yaml 발췌
x-backup-env: &backup-env
  RESTIC_REPOSITORY: s3:https://${R2_ACCOUNT_ID}.r2.cloudflarestorage.com/${R2_RESTIC_BUCKET}
  RESTIC_PASSWORD: ${RESTIC_PASSWORD}
  RESTIC_HOST: ${RESTIC_HOST}          # blog-dev | blog-prod 로 고정
  AWS_ACCESS_KEY_ID: ${R2_ACCESS_KEY_ID}
  AWS_SECRET_ACCESS_KEY: ${R2_SECRET_ACCESS_KEY}
  AWS_DEFAULT_REGION: auto
  BACKUP_KEEP_DAILY: ${BACKUP_KEEP_DAILY:-14}
  BACKUP_KEEP_WEEKLY: ${BACKUP_KEEP_WEEKLY:-8}
  BACKUP_KEEP_MONTHLY: ${BACKUP_KEEP_MONTHLY:-6}
Code language: YAML (yaml)
${…} 의 값은 모두 앞에서 본 sops 파일에서 텍스트로 봤을때의 내용이다. 내려받기가 무료라는 점도 백업에서는 크다. 복구는 결국 저장소 전체를 내려받는 일인데, 몇 번을 연습해도 egress 비용이 0원이다.
Terraform 도 같은 계정의 tf-state 버킷을 S3 백엔드로 쓴다. Terraform 상태 파일에는 터널 토큰이나 SSH 키 같은 민감한 값이 들어가므로 로컬 디스크 한 곳에만 두기 불안했다. 설정은 한 파일에 모으고 init 스크립트로만 주입한다.
② 계정별 R2 엔드포인트(계정 ID 는 가렸다)
③ R2 에 필요한 체크섬·잠금 설정
④ 버킷 안의 상태 파일 4개.
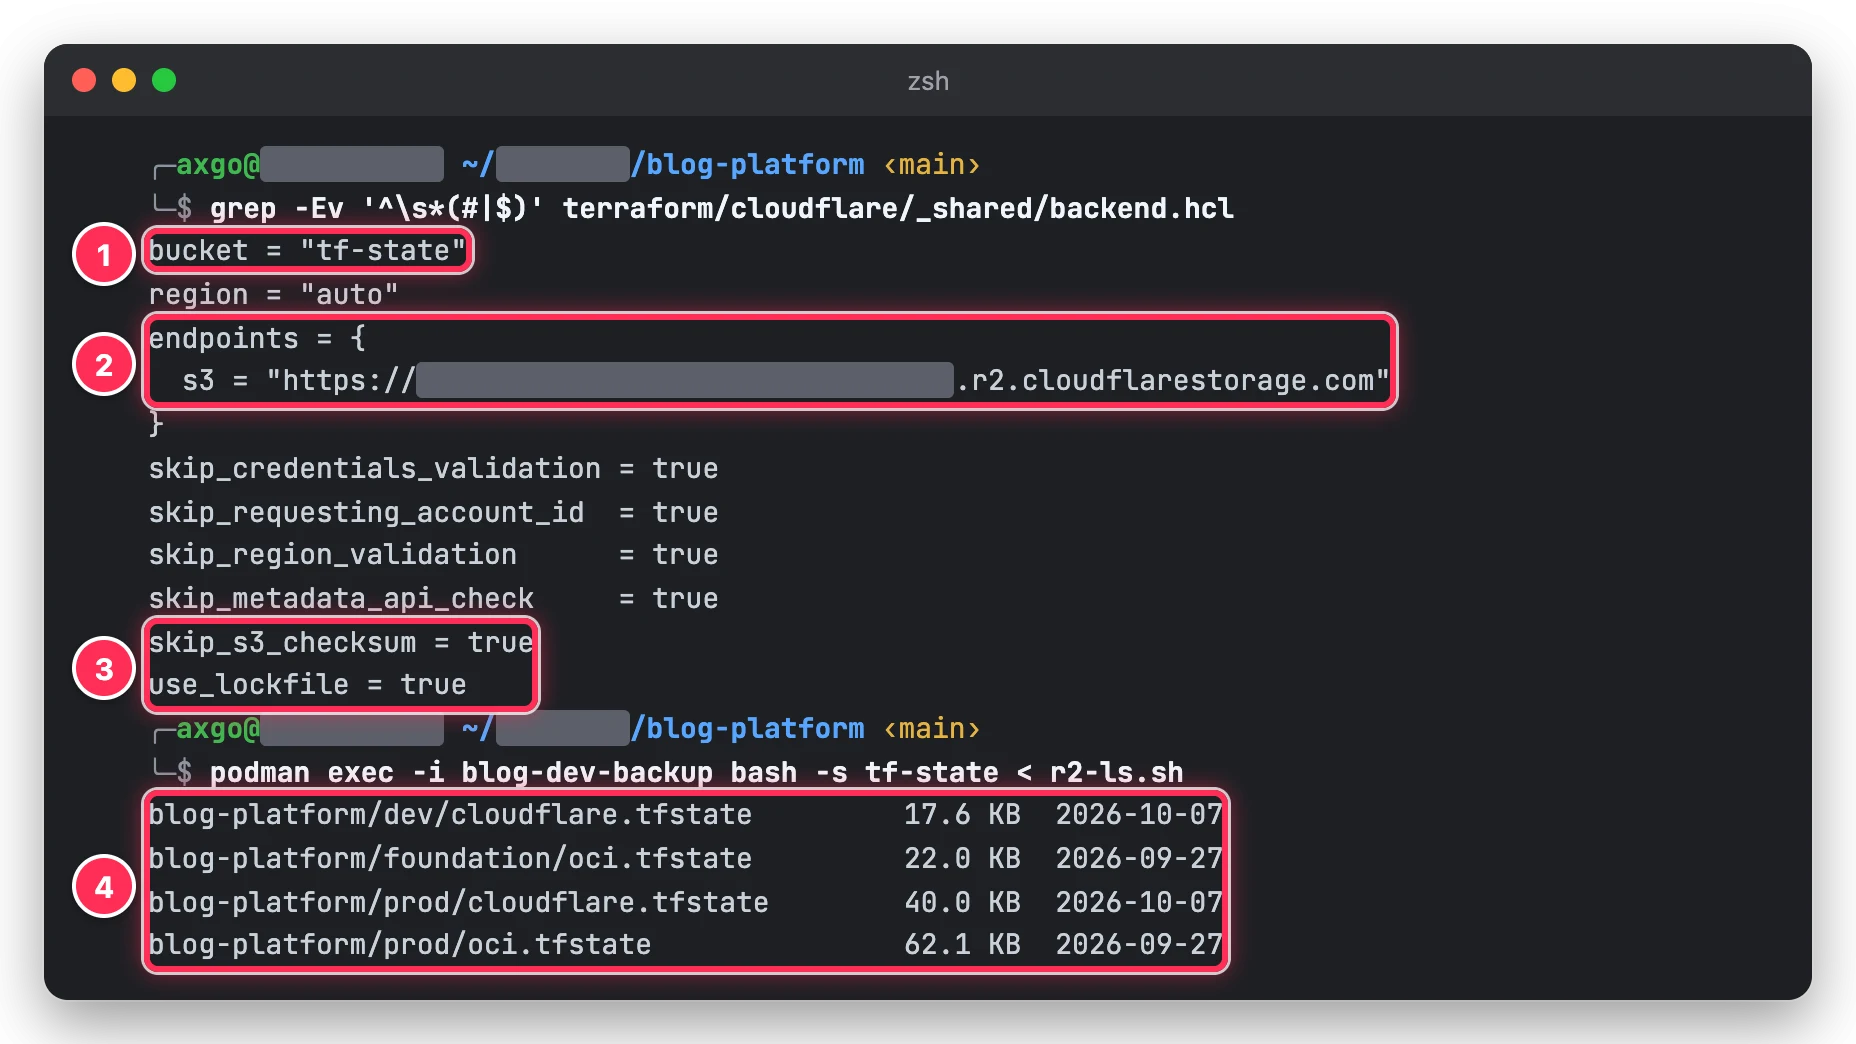
① 버킷 이름은 tf-state, ② 주소는 계정별 R2 엔드포인트다. AWS 가 아니므로 STS·IAM·메타데이터 API 를 찾지 않게 skip_* 를 켠다. ③ 의 두 줄은 R2 에서 특히 중요하다. skip_s3_checksum 이 없으면 Terraform 이 PUT 요청마다 SHA256 체크섬을 붙이는데, R2 가 이를 받지 않아 상태 쓰기가 깨진다. use_lockfile 은 Terraform 1.11 에서 생긴 S3 자체 잠금이다. 조건부 PutObject 로 .tflock 파일을 만들기 때문에 DynamoDB 같은 잠금 테이블이 따로 필요 없다. ④ 를 보면 버킷 안에는 Cloudflare dev·prod 와 OCI foundation·prod, 상태 파일 네 개가 모두 합쳐 0.14 MB 남짓 들어 있다.
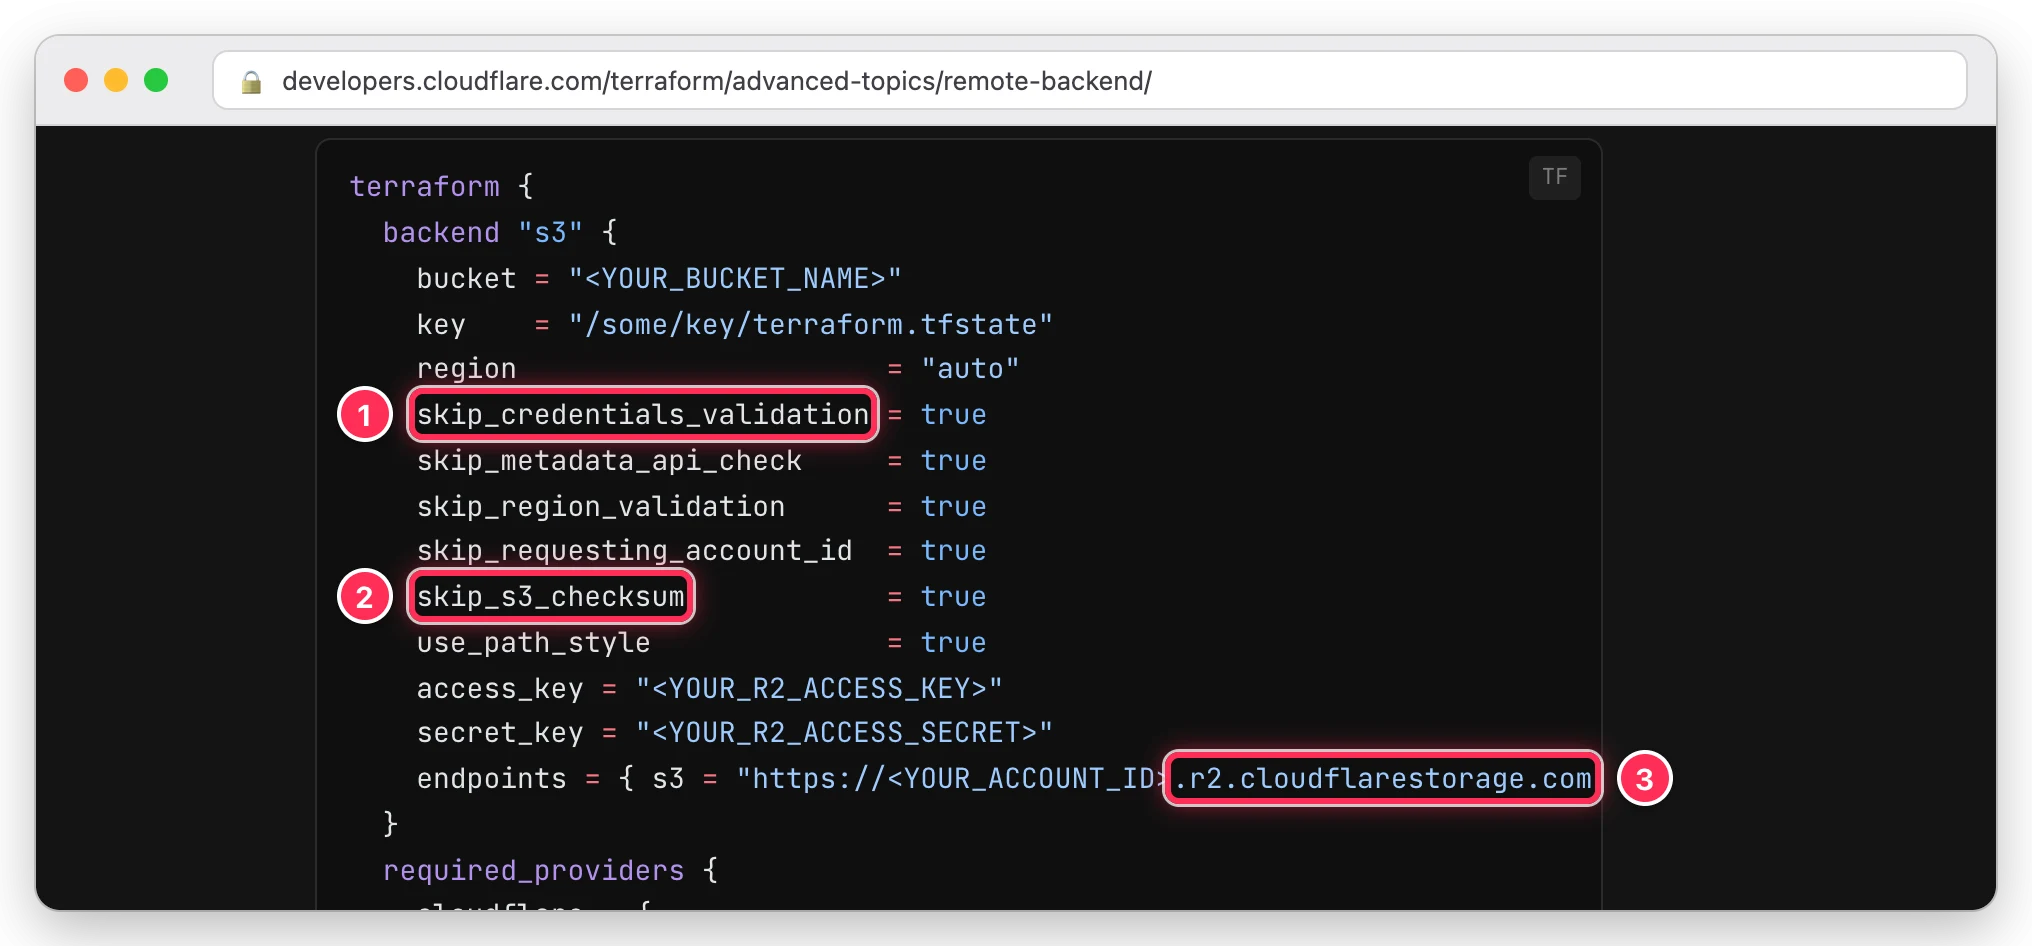
Cloudflare 의 Terraform 문서도 R2 를 원격 백엔드로 쓰는 예시를 위와 같이 보여주고 있다. ① ② 처럼 검증을 건너뛰는 설정과 R2 엔드포인트 ③ 이 내 설정과 같다. 문서 예시와 달리 나는 키를 파일에 적지 않고 backend.sops.env 를 풀어 환경변수로 넘긴다. 직접 terraform init 을 치지 않고 -input=false 를 건 tf-init.sh 만 쓰도록 하는 규칙을 만들었다. 직접 치면 값을 대화형으로 물어보는데 거기서 잘못 입력하면 dev 가 조용히 prod 상태를 가리킬 수 있다.
backup 컨테이너 — 6시간마다 R2 로 증분 백업
A1 의 블로그 데이터는 부트 볼륨(블록 스토리지) 아래 ~/blog-data/prod 에 모여 있다. WordPress 업로드와 테마, MariaDB, n8n 의 PostgreSQL 과 작업 파일들 이다. 이것을 R2 로 옮기는 일은 compose 안의 backup 컨테이너 하나가 맡도록 했다. Alpine 이미지에 restic, DB 클라이언트, zstd 를 넣고 crond 를 이용해 정기적으로 백업을 실행 한다.
# compose.yaml 발췌
backup:
  hostname: blog-${BLOG_LOCATION}-${BLOG_MODE}-backup
  volumes:
    - ${BLOG_DATA_ROOT}/${BLOG_MODE}:/data:ro          # 데이터는 읽기 전용
    - ${BLOG_DATA_ROOT}/${BLOG_MODE}/backups:/backups
  healthcheck:                                         # 8시간 안에 성공이 없으면 unhealthy
    test: ["CMD-SHELL", "find /backups/last-success -mmin -480 | grep -q ."]
  command:
    - -c
    - |
      printf '%s\n' \
        '0 3 * * * FULL=1 /opt/backup/backup.sh >> /backups/cron.log 2>&1' \
        '0 9,15,21 * * * /opt/backup/backup.sh >> /backups/cron.log 2>&1' \
        > /etc/crontabs/root
      exec crond -f -l 2
Code language: YAML (yaml)
하루 네 번, 03시·09시·15시·21시에 돈다. 최악이면 마지막 백업 뒤 6시간 데이터를 잃는다(RPO 6시간). 03시 회차만 FULL=1 로 오래된 스냅샷 정리와 무결성 검사까지 한다.
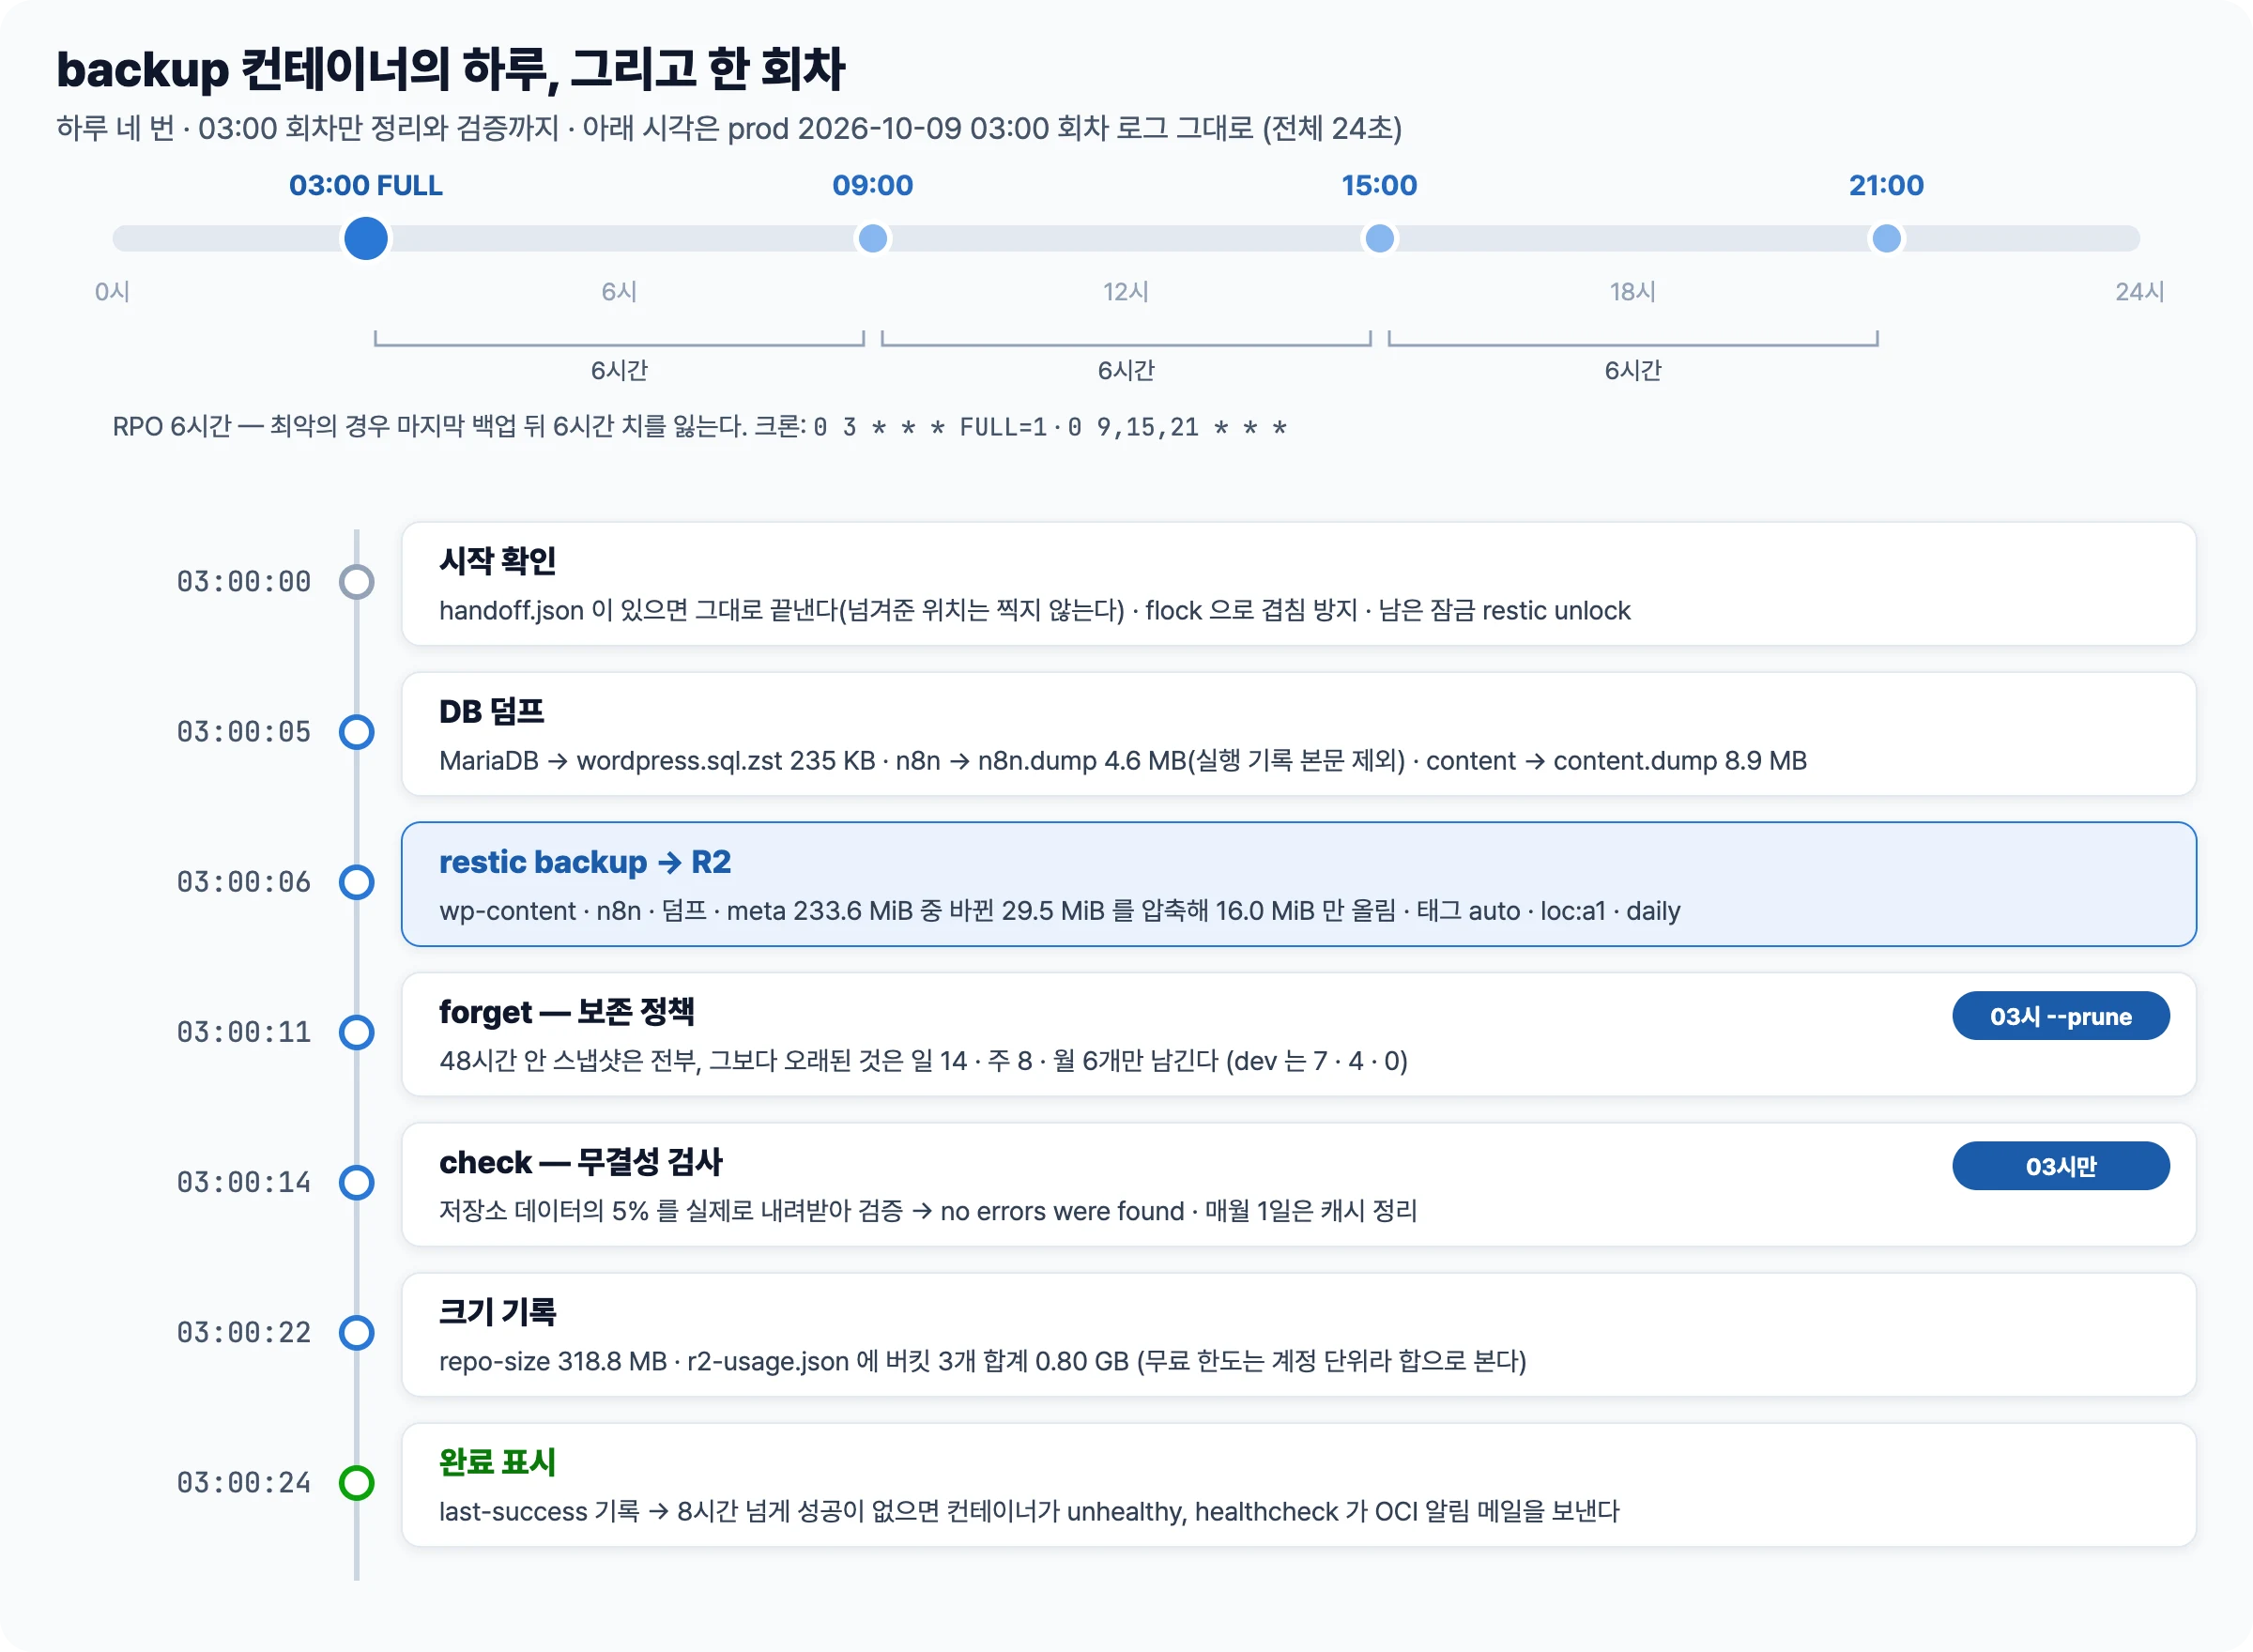
한 회차가 실제로 하는 일을 10월 9일 03시 prod 로그로 확인해 봤다.
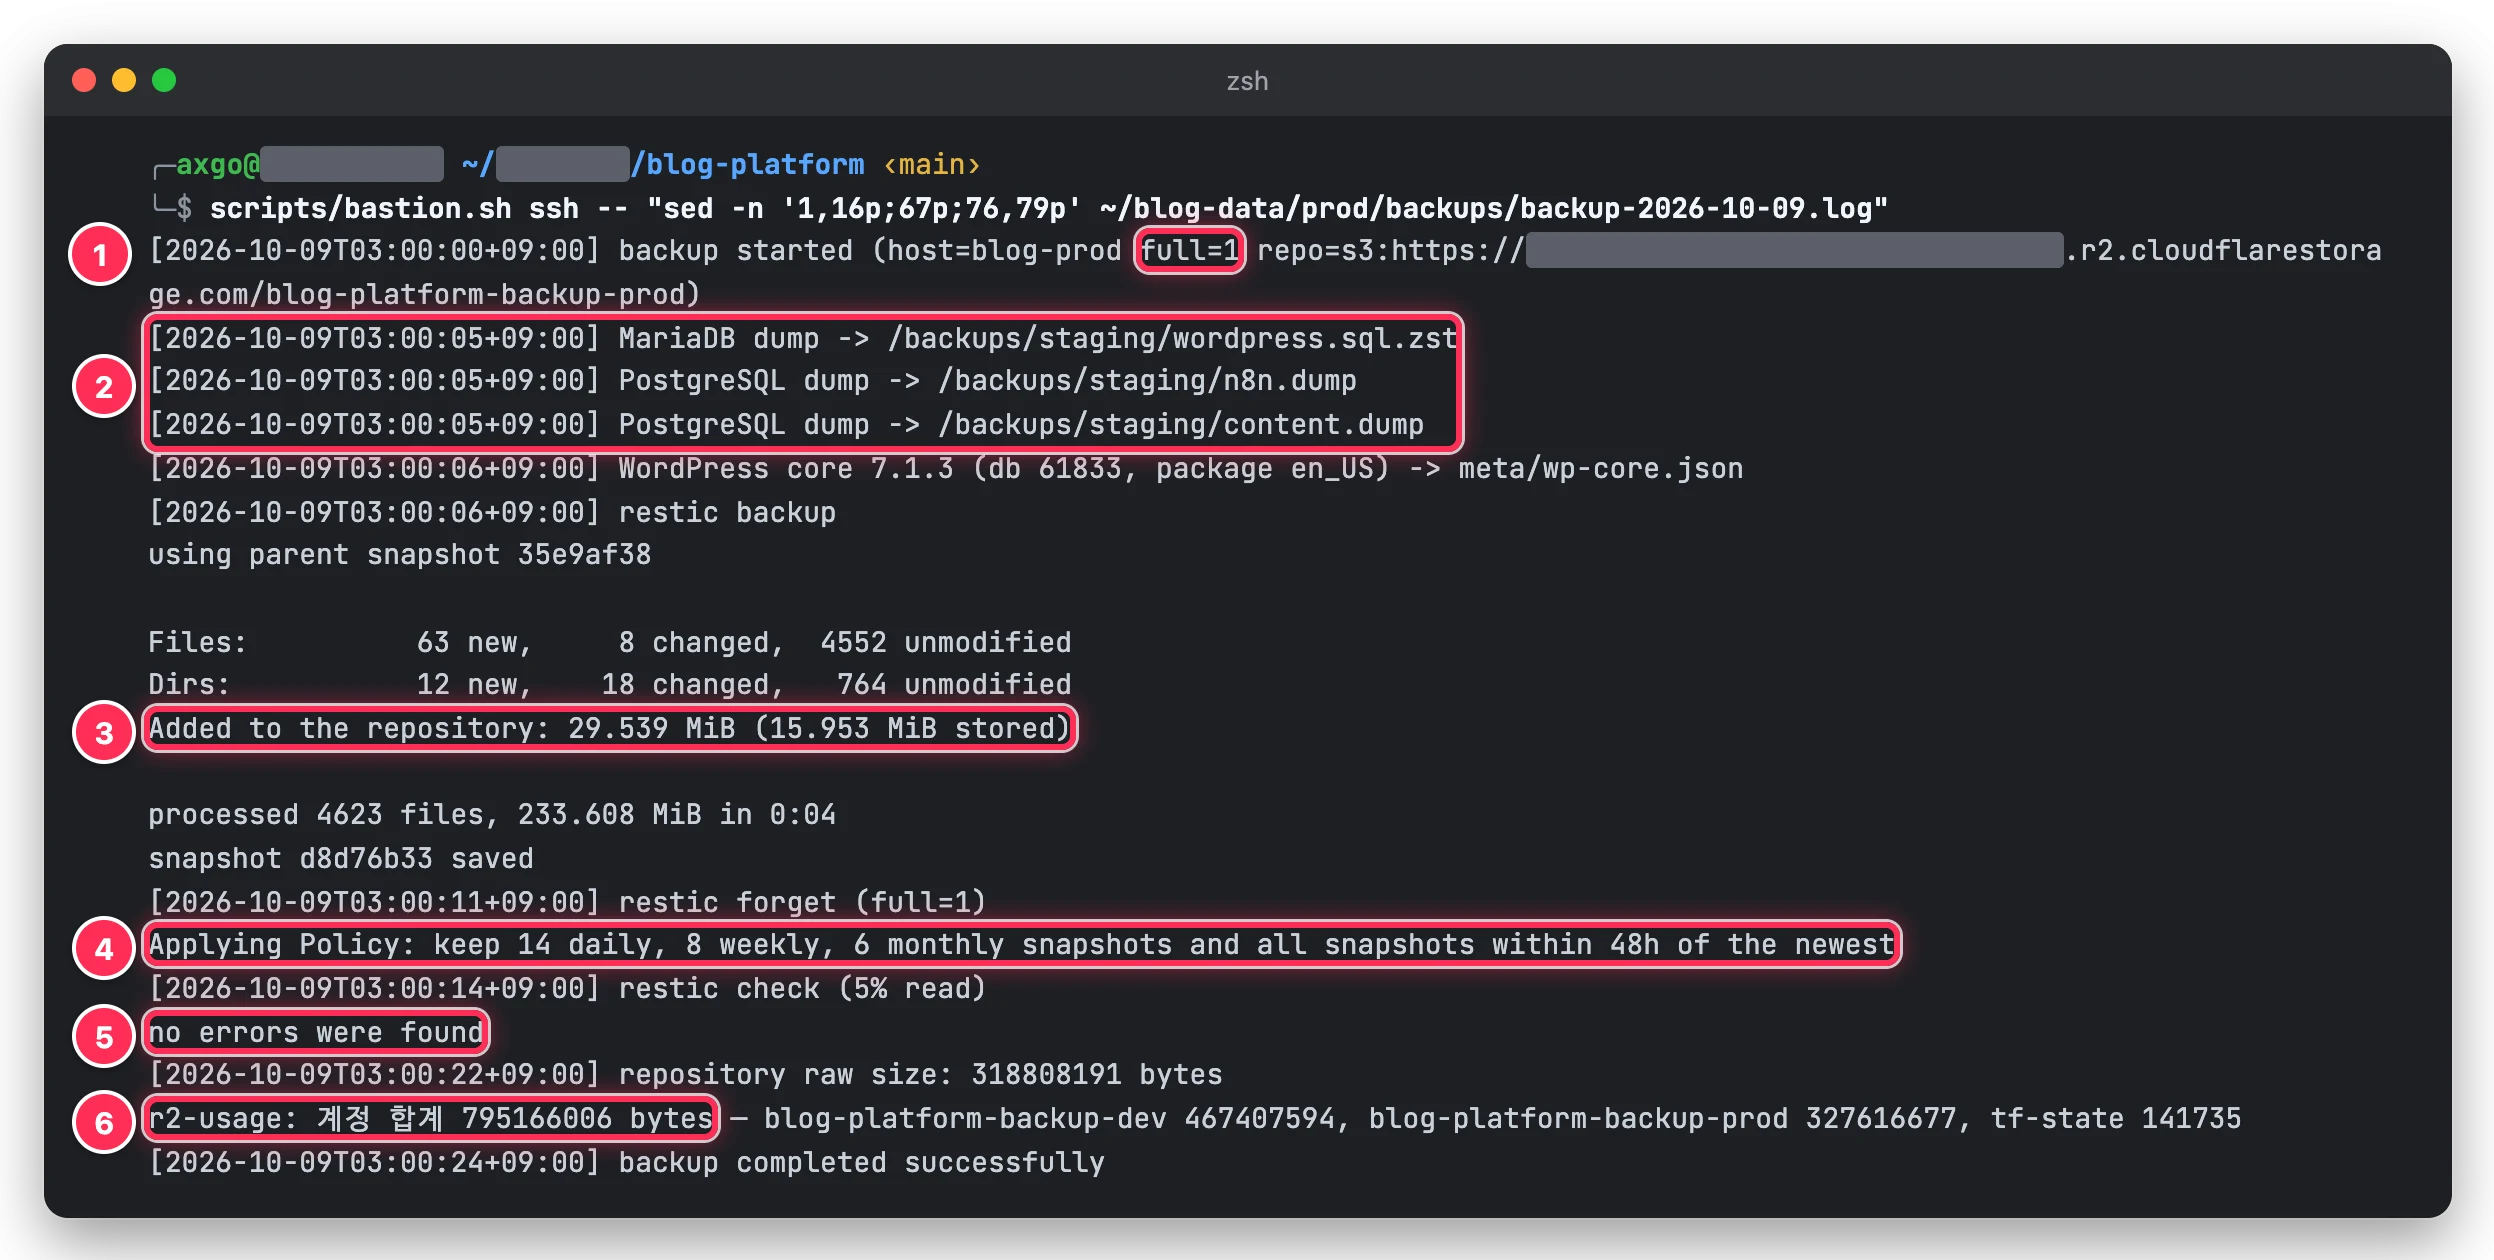
② DB 덤프 세 개
③ 새로 올린 양
④ 보존 정책
⑤ 무결성 검사
⑥ R2 계정 합계.
① full=1 표시를 봤을때 03시 백업에 대한 로그다. ② MariaDB, n8n, content 세 DB 를 먼저 덤프한다. 덤프 파일 이름은 매번 같다. 이름이 바뀌면 restic 이 스냅샷을 서로 다른 백업으로 보기 때문이다. ③ 이번 회차가 훑은 데이터는 4,623개 파일, 233.6 MiB 다. 그중 바뀐 것은 29.5 MiB, 압축해 실제로 올린 것은 16 MiB 다. 걸린 시간은 4초. restic 은 내용 단위로 중복을 걸러 내서 매번 전체를 올리지 않는다. ④ 보존 정책은 48시간 안의 스냅샷은 유지, 그보다 오래된 것은 하루 14개·주 8개·달 6개만 남긴다. ⑤ 저장소 데이터의 5% 를 실제로 내려받아 검사했고 오류는 없었다. ⑥ 마지막으로 R2 계정 전체 사용량을 다시 셌다. 시작부터 끝까지 24초다.
이 업로드는 모니터링 화면에도 그대로 찍힌다. A1 의 Alloy 가 지표를 Tailscale 터널을 통해 Mac 으로 보내고 그것을 Grafana 로 볼수 있도록 했다. 아래 화면은 A1 에서 Grafana 트래픽 위젯에서 백업에 해당하는 트래픽 표시다.
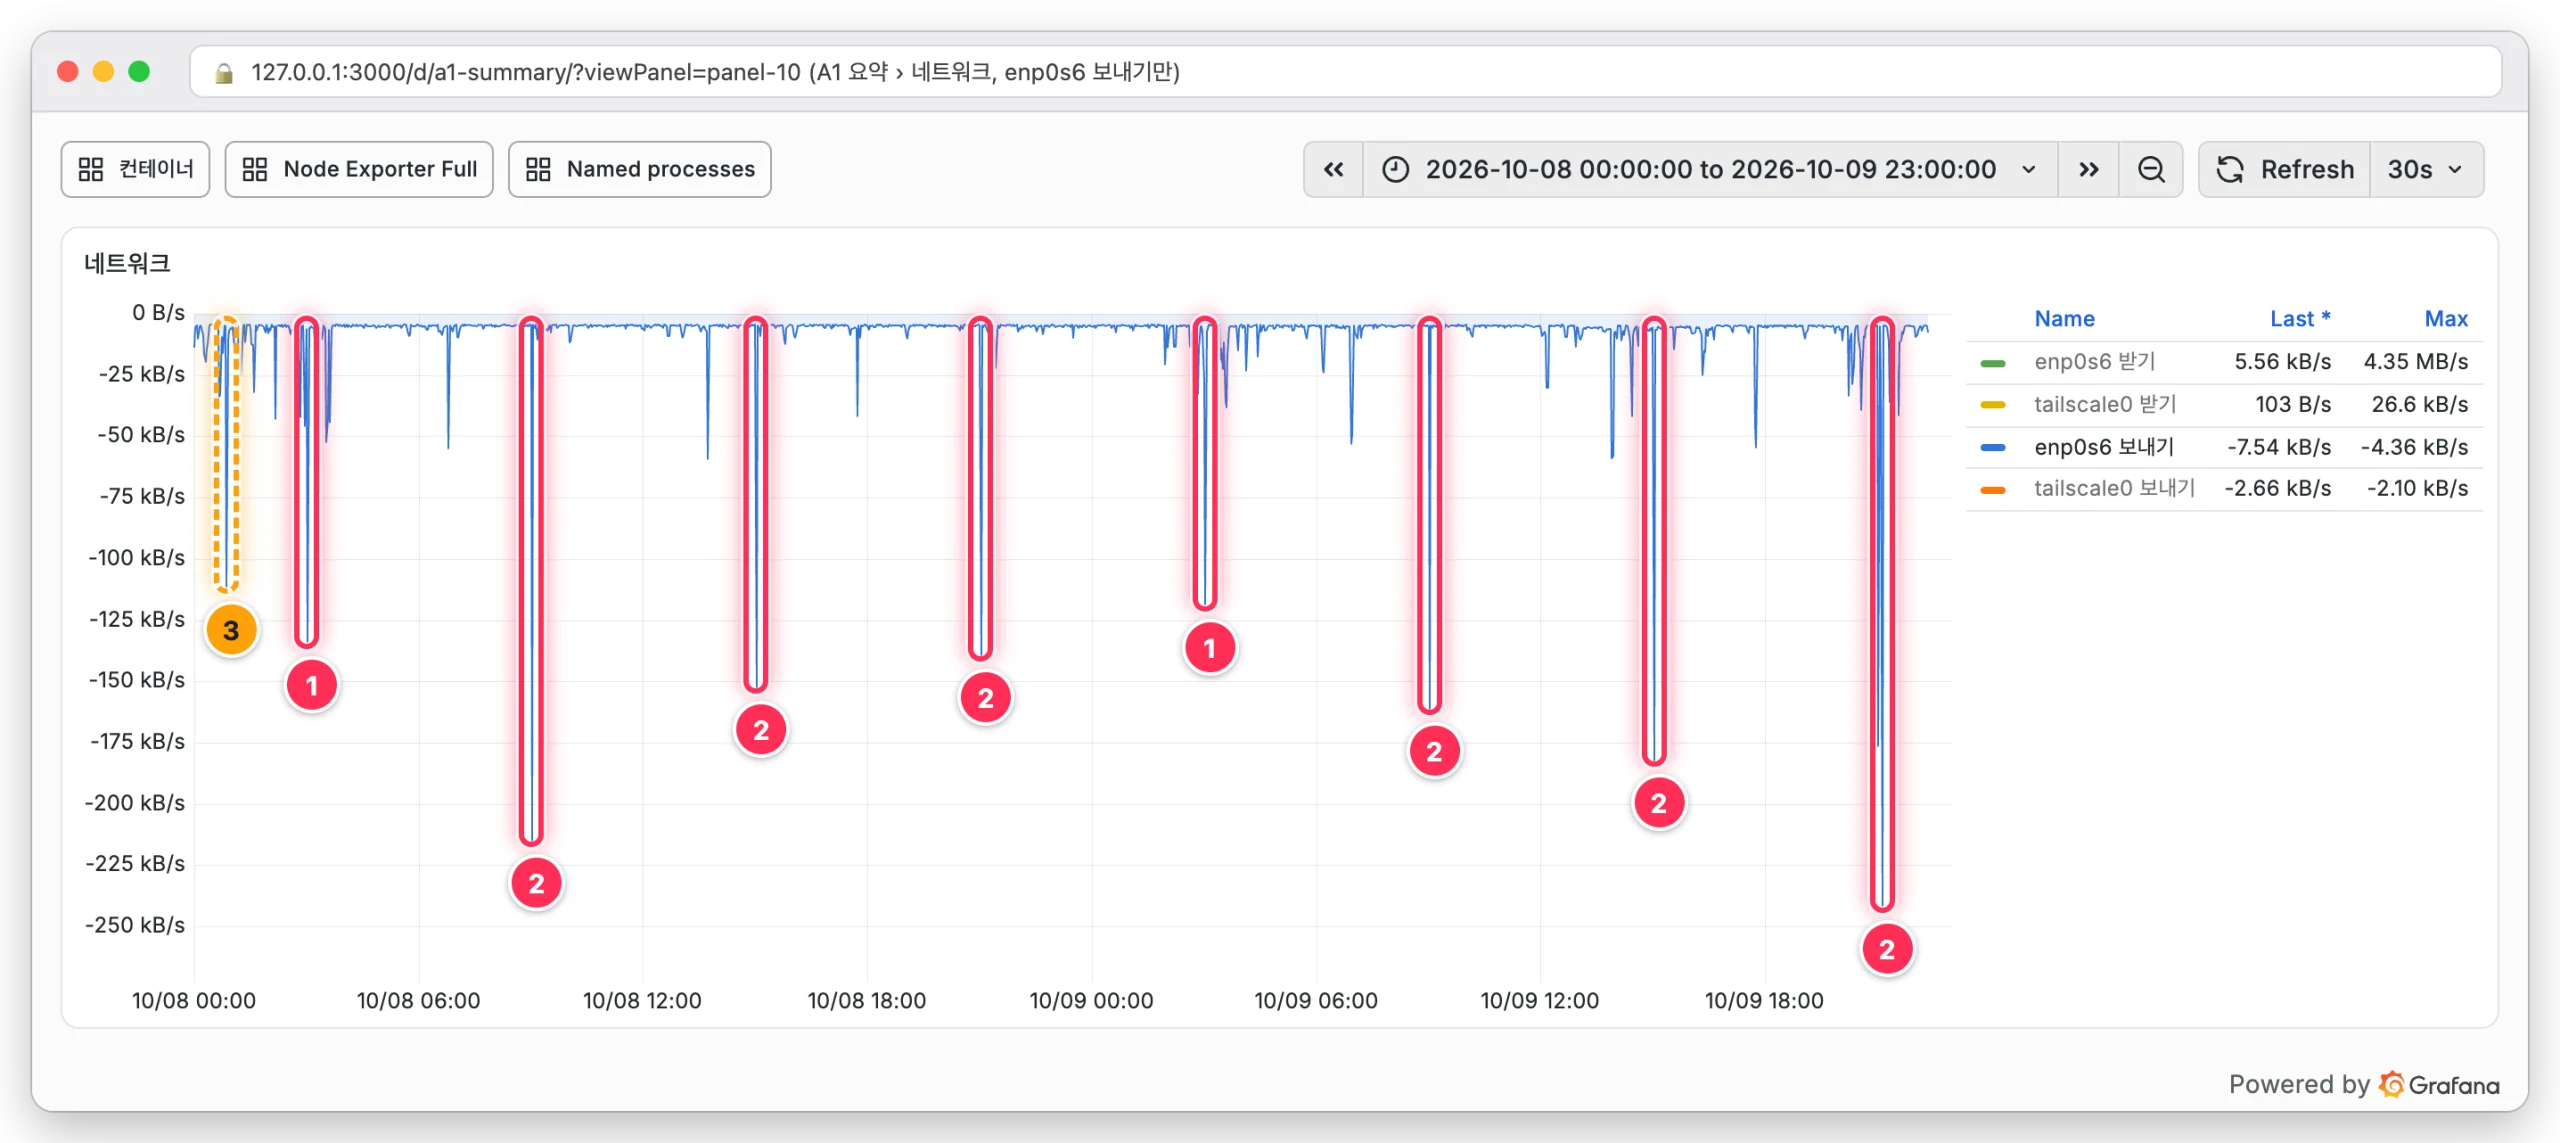
① 03시 회차
② 09·15·21시 회차
③ n8n 업그레이드 직전 수동 백업.
① 은 03시 회차, ② 는 09시·15시·21시 회차다. 이틀 동안 여덟 번, 의도된 시간에 정확히 동작하고 있다. ③ 은 10월 8일 00시 50분에 손으로 돌린 백업이다. n8n 을 업그레이드하기 직전이었다. 이런 수동 백업에는 tag를 붙여 놓았다.
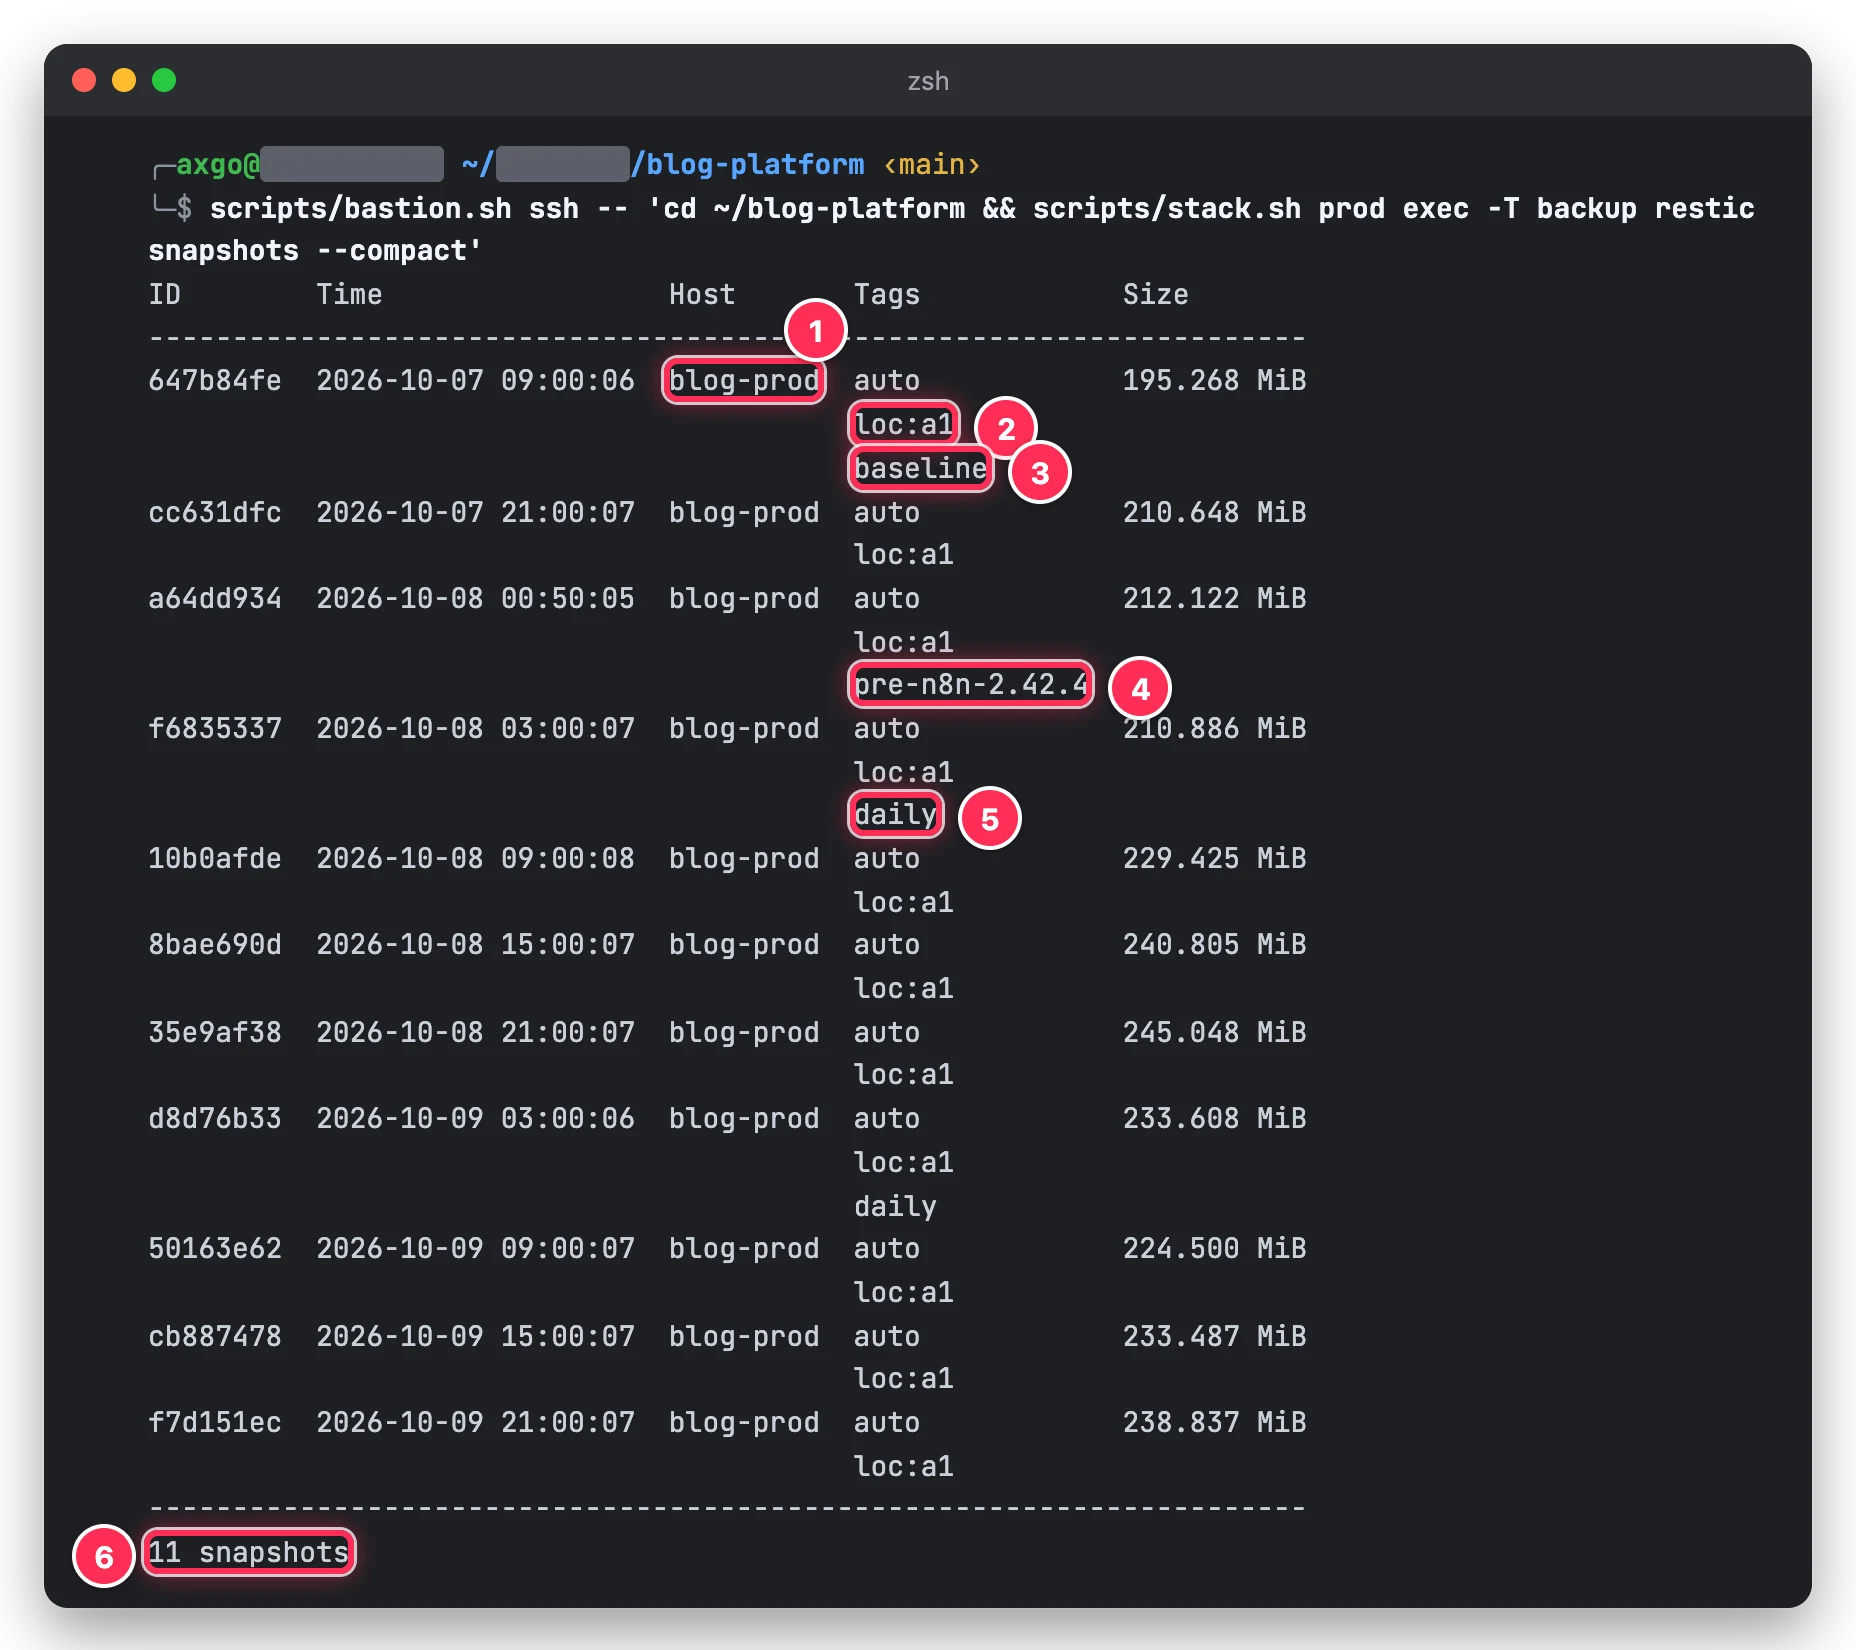
② 찍은 위치 태그
③ 초기화 기준점
④ 업그레이드 직전 수동 백업
⑤ 03시 회차
⑥ 스냅샷 11개.
R2 의 prod 저장소에 남아 있는 스냅샷은 지금 11개다. ① host 는 항상 blog-prod 로 고정한다. 처음에는 이 값을 정하지 않아 컨테이너의 임의 hostname 이 들어갔다. restic 은 host 와 백업 대상 폴더 목록으로 스냅샷을 묶어 보존 정책을 적용하므로, 실행할 때마다 묶음이 새로 생겨 어떤 스냅샷도 지워지지 않았었다.(용량이 불어나고 있었다) ② loc:a1 은 어느쪽에서 실행되었는지를 위해 남기는 태그다. prod 를 Mac 이 잠시 맡으면 loc:mac 이 붙는다. ③ baseline 은 콘텐츠를 초기화한 직후의 기준점이다. ④ pre-n8n-2.42.4 가 앞 Grafana 화면에서 보였던 ③ 의 수동 백업이다. ⑤ daily 는 03시 회차 표시다.
백업 스크립트는 몇 가지 문제들을 겪은 뒤에 수정을 했는데. 백업과 수동 실행이 겹치지 않도록 flock 으로 막는다. 백업이 도중에 끊겨 남은 restic 잠금은 다음 실행 첫머리에 restic unlock 으로 지우도록 했다. prod 를 다른 호스트에 넘겨준 쪽에는(from) handoff.json 표식을 남겨 컨테이너가 재부팅으로 되살아나도 낡은 데이터로 새 스냅샷을 찍지 않게 한다. 백업이 8시간 넘게 성공하지 못하면 healthcheck 가 OCI 알림 메일을 보내도록 했다.
백업과 복구
복구해 보지 않은 백업은 백업이라고 부르기 어렵다. 복구 절차도 스크립트로 만들고 실제로 서빙 위치를 옮겨 가며 연습했다.
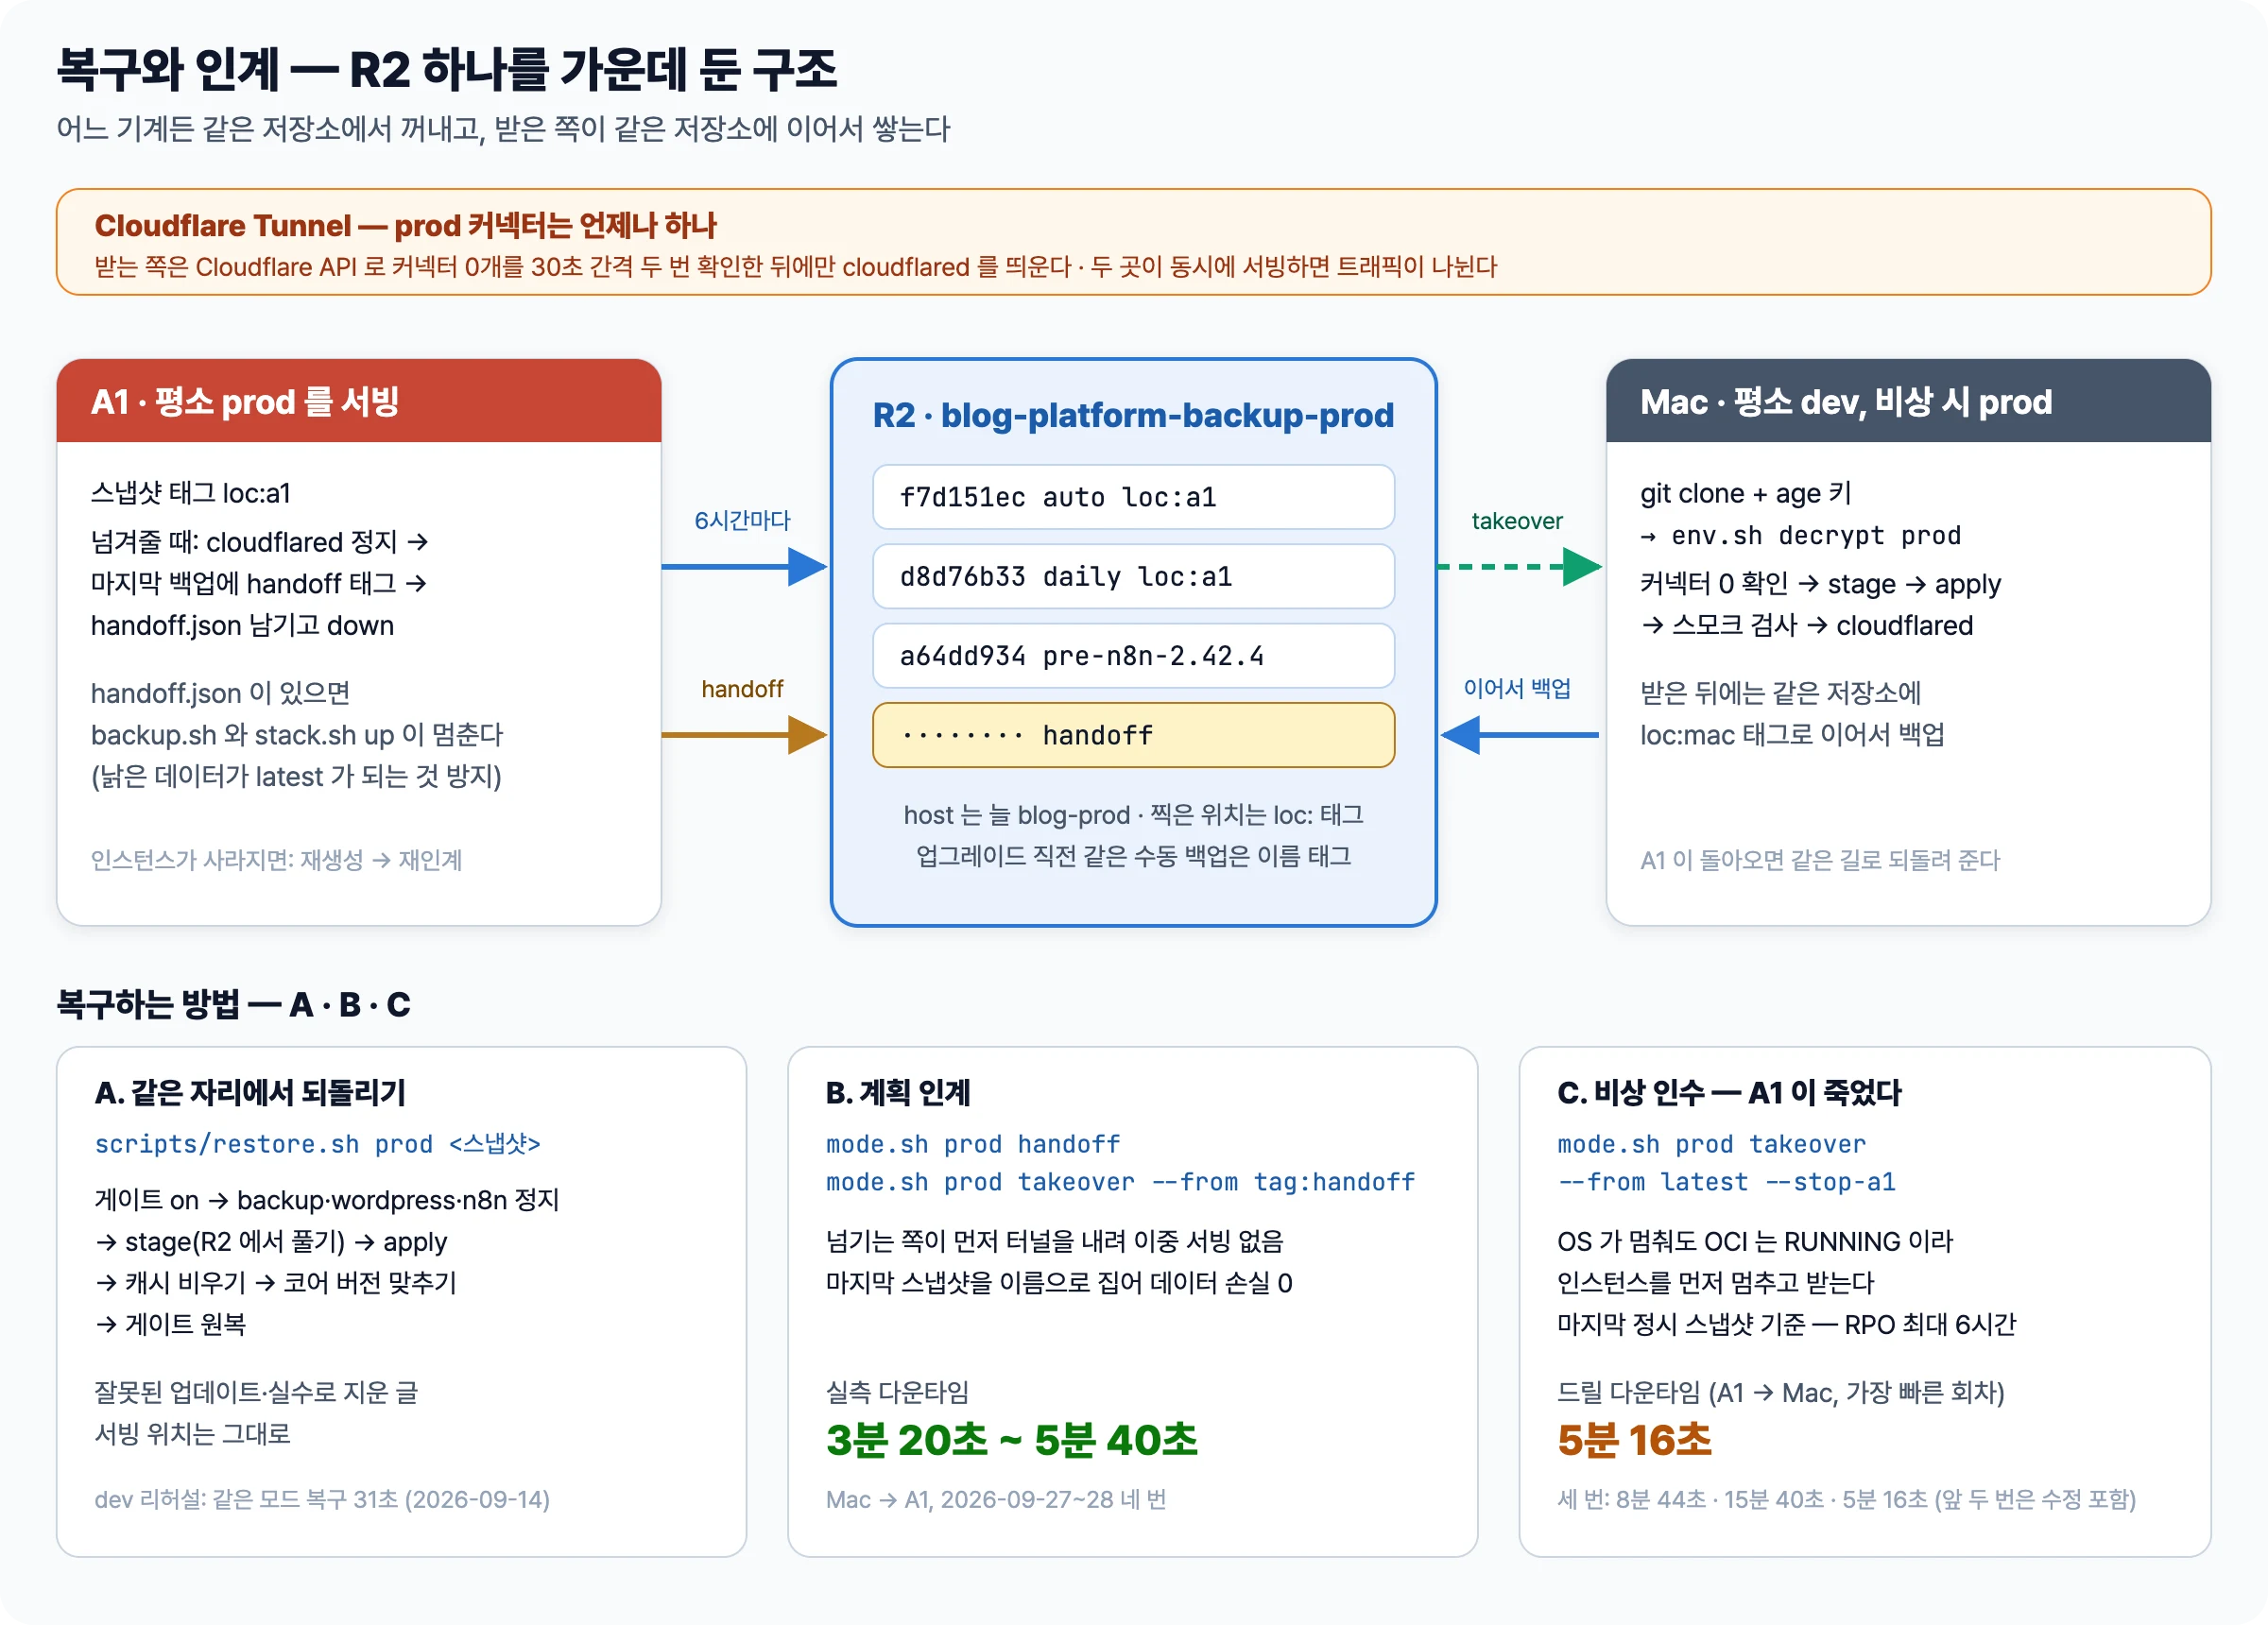
복구하는 방법은 세 가지다.
- A 는 같은 자리에서 되돌리는 경우다. 잘못된 업데이트나 실수로 지운 글을 특정 스냅샷으로 돌린다.
- B 는 계획 인계다. A1 에서 Mac 으로, 또는 그 반대로 prod 를 옮길 때 쓴다. 넘기는 쪽이 먼저 Cloudflare 터널을 내리고
handoff태그를 붙인 마지막 백업을 남긴다. 받는 쪽은 그 스냅샷을 이름을 지정해 복원하므로 잃는 데이터가 없다. - C 는 비상 인수다. A1 이 갑작스럽게 나를 떠났을때 Mac 이 마지막 스냅샷으로 prod 를 받는 경우다.
어느 방법이든 R2가 데이터를 지켜주는 백업 위치에 있다. 받는 쪽은 Cloudflare API 로 prod 터널의 커넥터가 0개인지 30초 간격으로 두 번 확인한 뒤에만 터널을 띄운다. A1과 Mac 둘다 터널을 열고 동시에 서빙하면 방문자 트래픽이 둘로 나뉘기 때문이다. (원치 않는 로드밸런싱이 ㅎㅎ)
A1 이 통째로 사라지는 비극의 그날이 왔을때
(당황하지 않고) 아래 명령만 치면 즉시 Local Mac이 prod 로 동작 할 수 있게 된다.
git clone <비공개 저장소> ~/blog-platform-prod && cd ~/blog-platform-prod
cp <오프라인 사본>/keys.txt ~/.config/sops/age/keys.txt && chmod 600 ~/.config/sops/age/keys.txt
scripts/env.sh decrypt prod
scripts/mode.sh prod takeover --from latest --stop-a1 --yes   # 커넥터 0 확인 → R2 에서 받기 → 복원 → 터널
Code language: Bash (bash)
--stop-a1 은 OCI API 로 인스턴스를 먼저 멈추는 옵션이다. 복구 테스트중 알게 된 사실인데, A1 의 OS 가 멈춰도 OCI 콘솔에서는 RUNNING 으로 유지되는 경우가 있다. 죽은 줄 알았던 서버가 나중에 살아나 터널을 다시 잡으면 안 되기 때문에 확실히 멈추고 받도록 OCI API로 A1을 중단 시키도록 기능을 추가 했다.
9월 27일부터 28일 사이에 이 전환 작업을 몇번이고 돌려 봤는데. Mac 에서 A1 으로 넘기는 계획 인계는 네 번 해서 다운타임이 3분 20초에서 5분 40초였다. A1 이 죽었다고 가정한 비상 인수는 8분 44초, 15분 40초, 5분 16초가 걸렸다. 앞의 두 번은 도중에 결함을 찾아 고치느라 길어졌고 세 번째에 처음으로 멈춤 없이 끝났다.
복구가 되는지는 평소에도 가볍게 확인할 수 있다. restic 의 --dry-run 은 아무것도 쓰지 않고 복원할 목록만 계산한다.
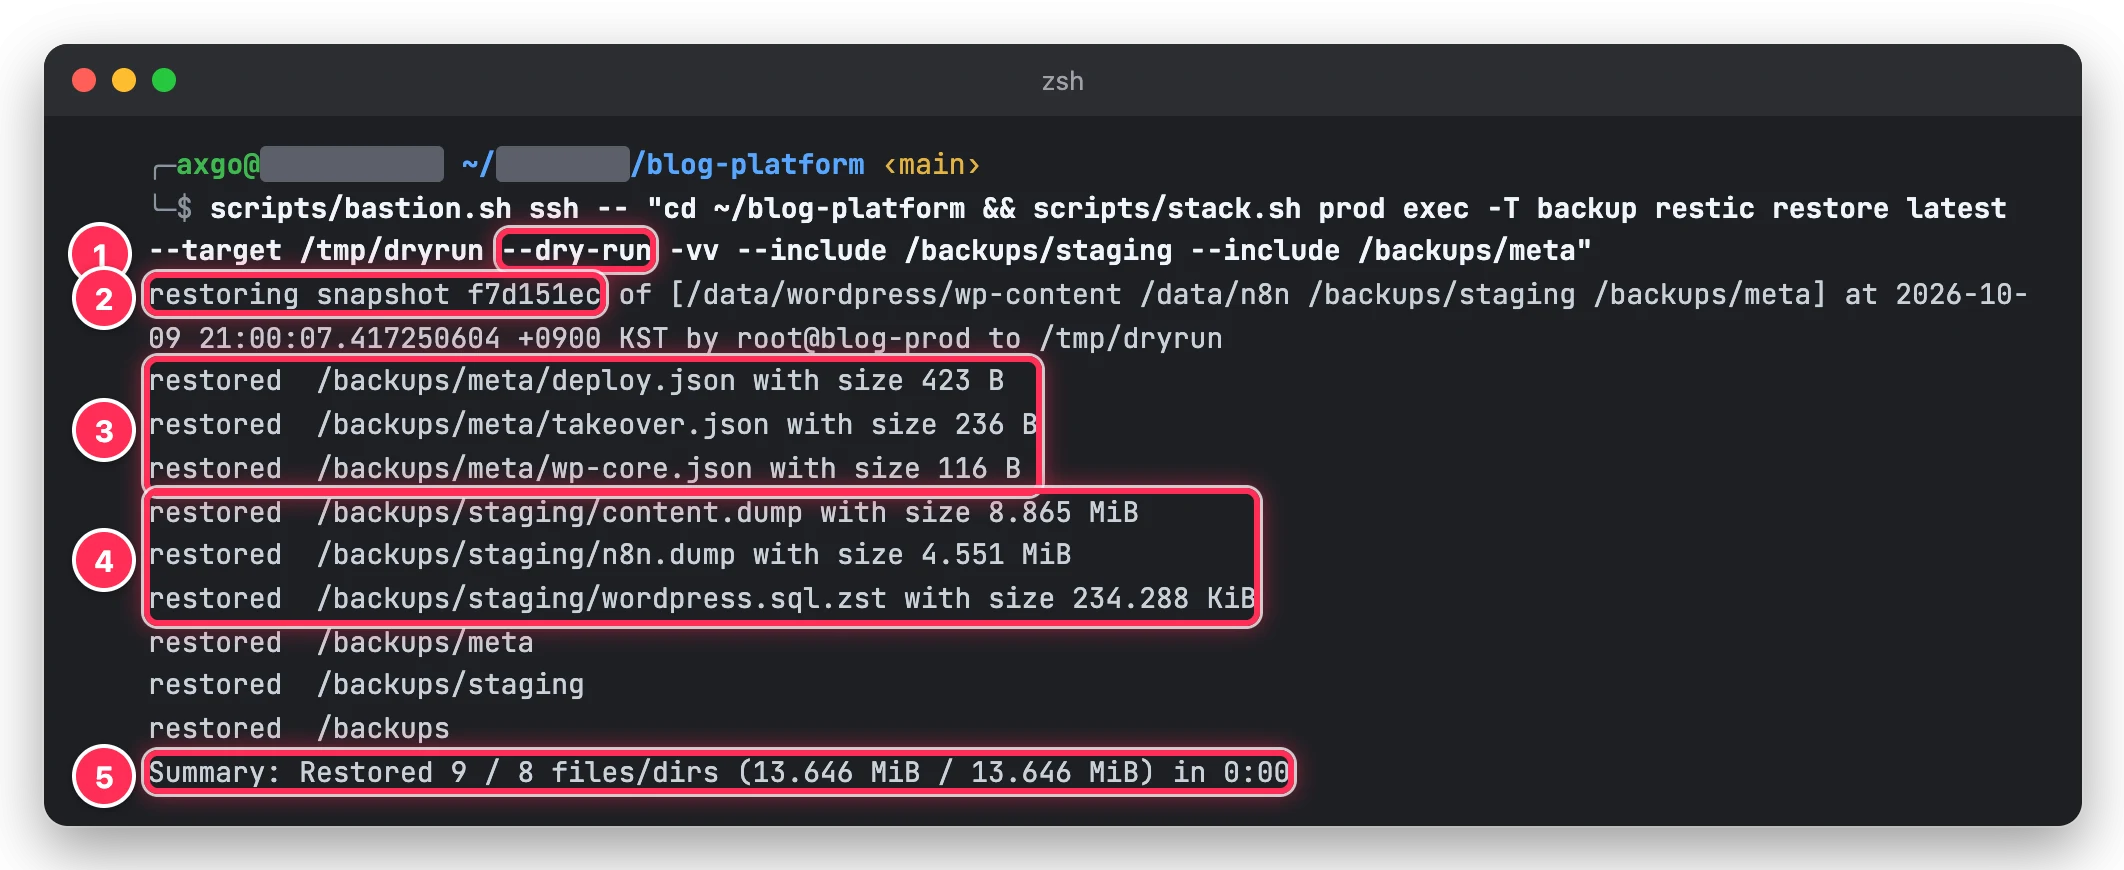
② 최신 스냅샷
③ 배포·코어 버전 기록
④ DB 덤프
⑤ 복원할 양.
① --dry-run 이라 실제로는 파일을 하나도 쓰지 않는다. ② 대상은 가장 최근의 21시 스냅샷이다. ③ 배포 기록(deploy.json)과 WordPress 코어 버전(wp-core.json)이 함께 들어 있다. 이 메타 정보가 있어서 몇 년 뒤 복구할 때도 어떤 코드와 어떤 버전으로 돌던 데이터인지 알 수 있다. ④ 세개의 DB 덤프가 그대로 있고 ⑤ 합계 13.6 MiB 를 0초 만에 계산했다.
용량 관리 — 지금 얼마를 쓰고, 몇 년을 버틸 수 있을까?
R2 무료 10 GB 는 한도가 버킷 단위가 아니라 계정 단위라서 놓치기 쉽다. prod 저장소만 보고 있으면 안 되고 dev 저장소와 Terraform 상태까지 합쳐 봐야 한다. 백업이 끝날 때마다 S3 목록 API 로 계정의 모든 버킷 크기를 더해 r2-usage.json 에 남긴다.
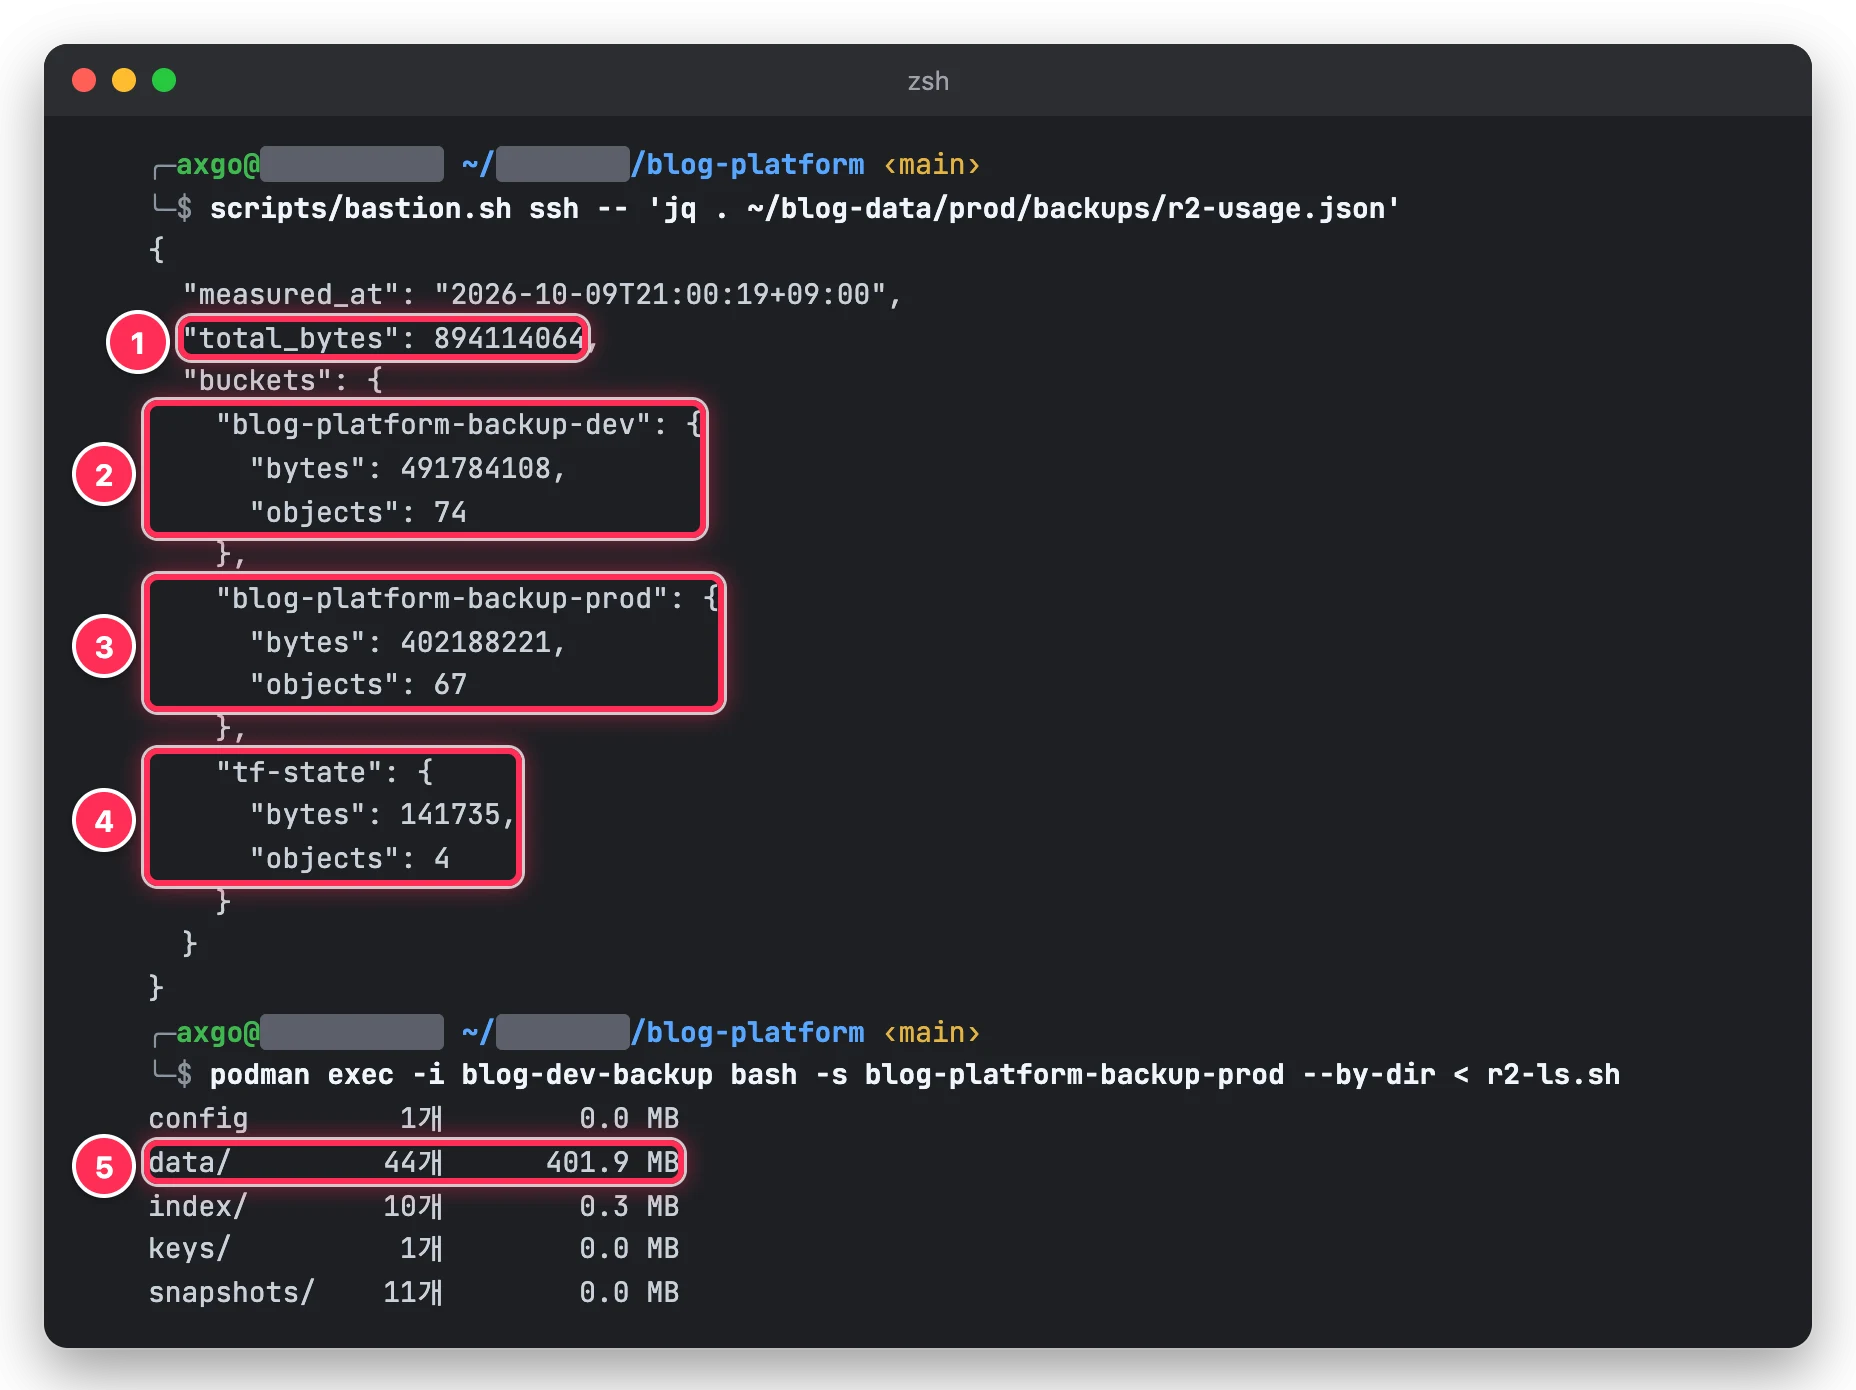
② dev 저장소 사이즈
③ prod 저장소 사이즈
④ Terraform tfstate 사이즈
⑤ prod 백업 데이터 폴더 사이즈
10월 9일 21시 기준 ① 계정 합계는 894,114,064바이트, 약 0.89 GB 다. 무료 한도의 9% 쯤이다. ② dev 저장소가 491.8 MB, ③ prod 저장소가 402.2 MB, ④ Terraform 상태가 0.14 MB 다. ⑤ prod 저장소 안을 들여다보면 거의 전부가 data/ 아래 백업 데이터 파일로 44개다. 목록 조회는 R2 에서 Class A 요청으로(메타 조회) 비용이 발생할 수 있지만 백업마다 네 번 남짓이라 무료 100만 회에 비하면 미미하다.
A1 쪽 디스크는 여유가 많다.
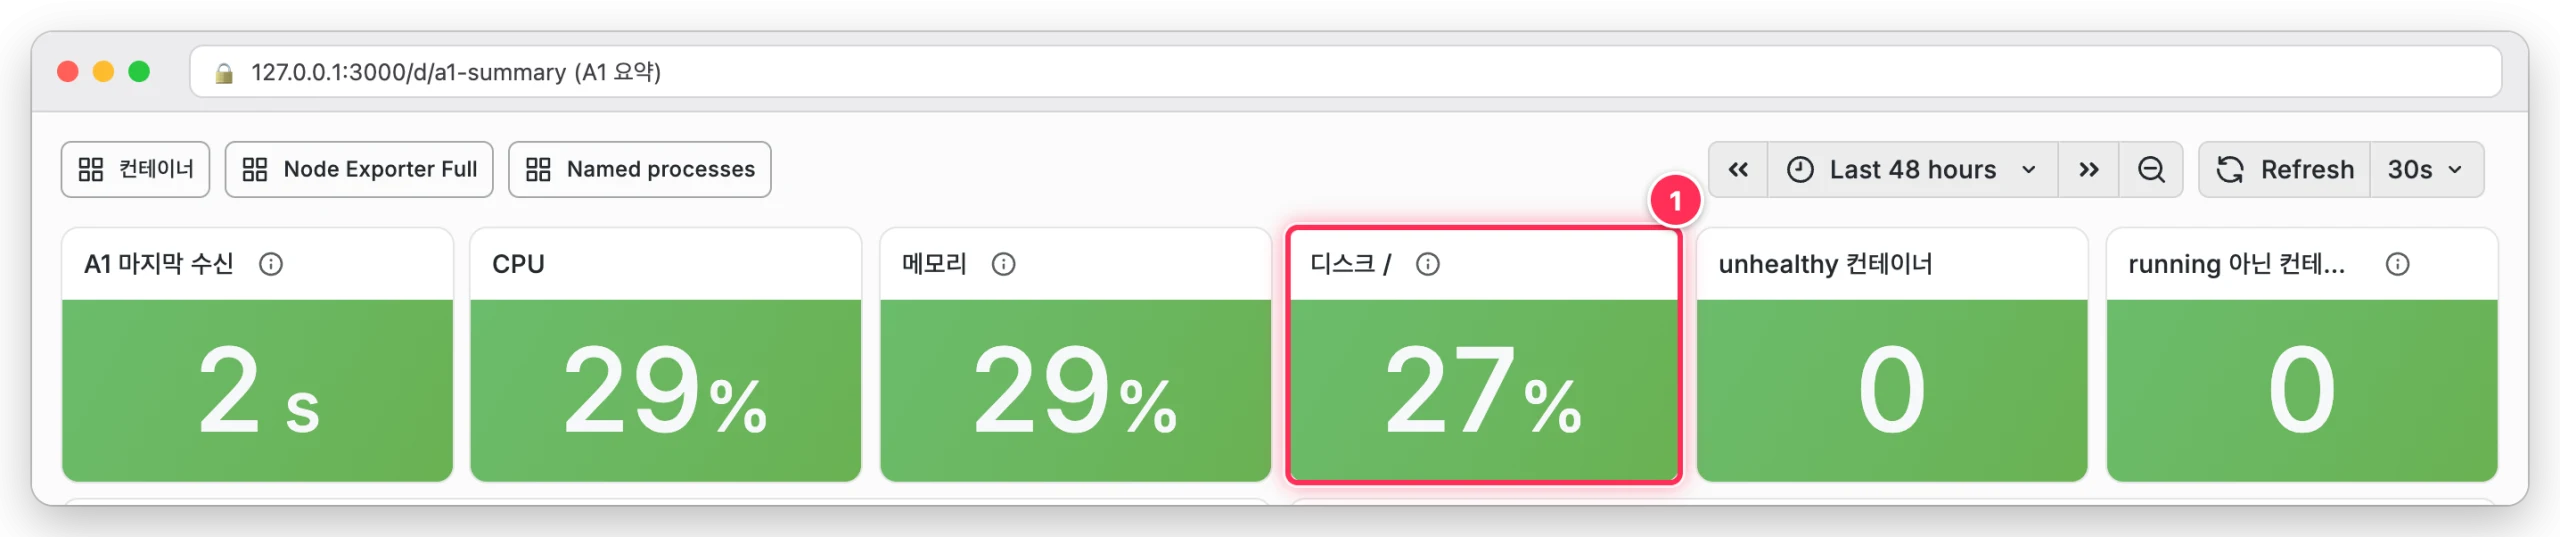
① 부트 볼륨의 루트 파일시스템 사용률은 27% 다. 블로그 데이터는 그 안의 2 GB 남짓이다.
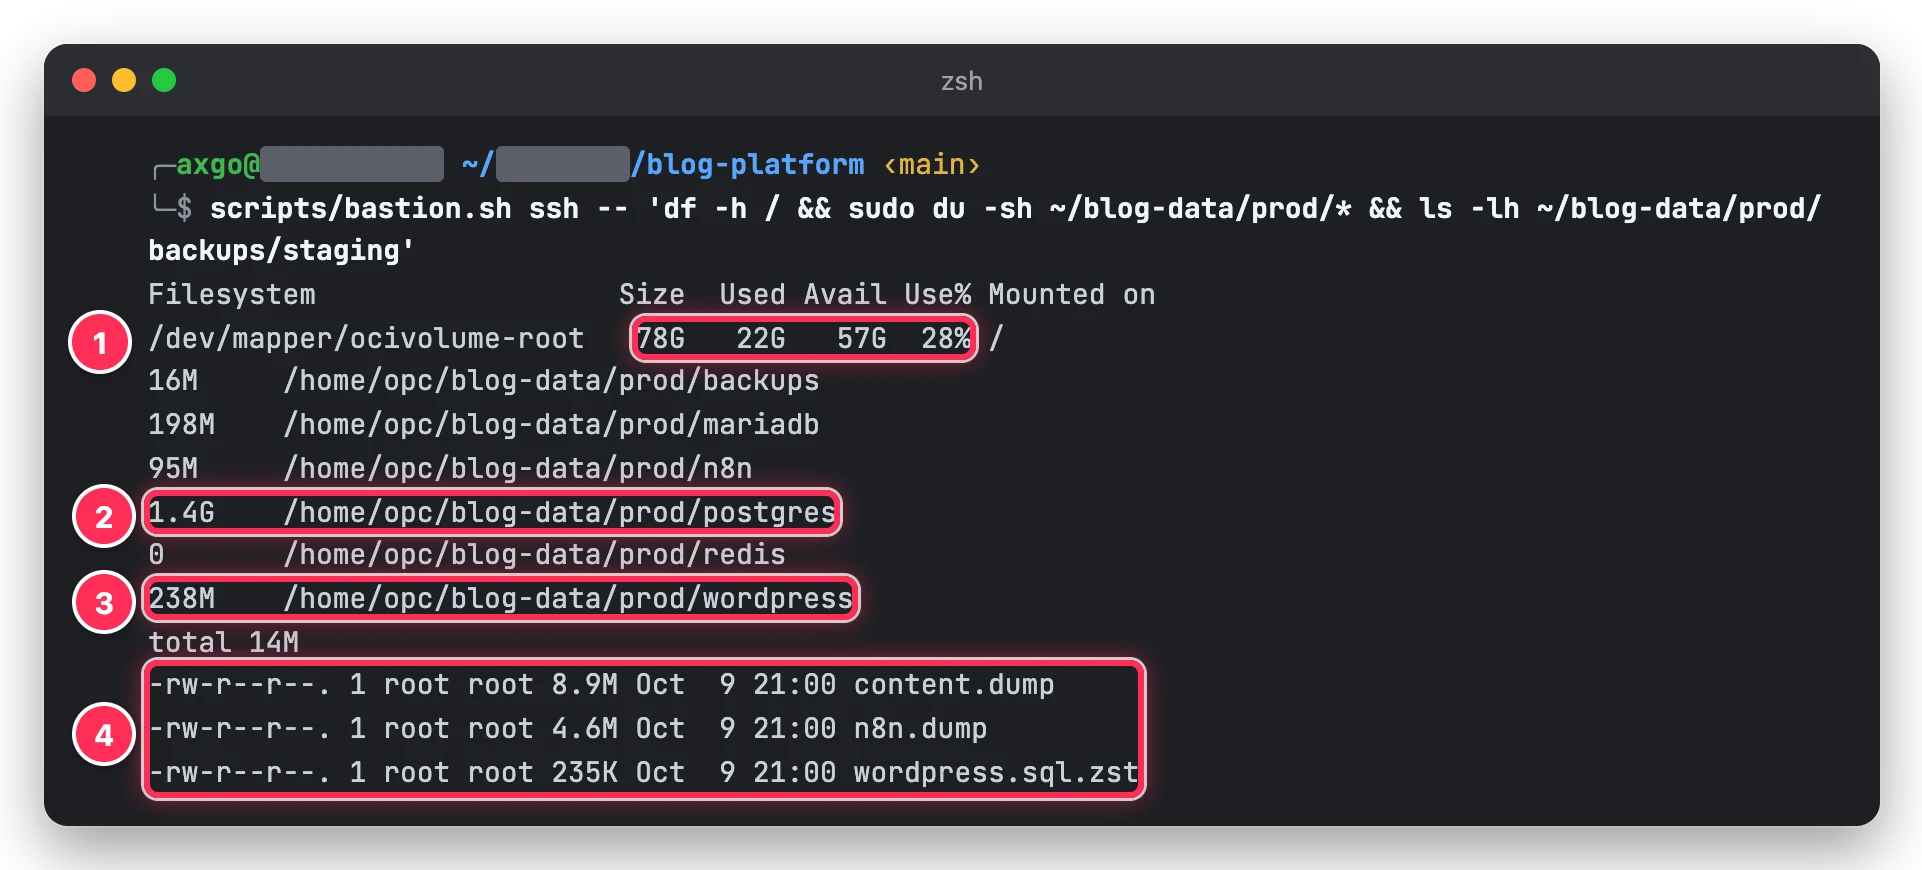
② PostgreSQL 데이터 1.4 GB
③ WordPress 디렉터리
④ 실제로 백업에 들어가는 DB 덤프.
① 루트 78 GB 중 22 GB 를 쓴다. 컨테이너 이미지가 7.6 GB, 블로그 데이터가 2 GB 남짓이고 나머지는 운영체제와 그 밖의 파일이다. ② 와 ④ 는 차이가 크다. PostgreSQL 데이터 디렉터리는 1.4 GB 인데, 백업으로 덤프한 n8n 과 content DB 는 합쳐 14 MB 가 안 된다. n8n 실행 기록의 본문과 검색용 임베딩 pgvector 를 일부러 덤프에서 빼놨기 때문이다. ③ WordPress 디렉터리 238 MB 가운데 백업 대상인 wp-content(업로드·테마·플러그인)는 restic 이 중복을 걸러 내서 처음 한 번만 올라가고 그 뒤로는 새 파일만 올라간다.
이 차이는 한 번 크게 데이고 나서 만들었다. 처음에는 n8n DB 를 통째로 덤프했다. 실행 기록 본문이 450~500 MB 라 덤프가 매번 250~290 MB 였다. 압축된 덤프는 restic 이 중복으로 걸러 낼 수 없어서 하루 네 번 거의 새로 올라갔다. 9월 24일에 보니 dev 저장소가 2.12 GB, prod 가 1.6 GB 였다. 2주 만이었다. 복구에는 워크플로와 자격증명이 필요할 뿐 지난 실행의 상세 기록까지는 필요 없다. 실행 기록 본문은 표 구조만 남기고 데이터를 빼도록 바꿨고 실행 기록 보관 기간도 14일에서 3일로 줄였다. 덕분에 덤프를 290 MB 에서 1.3 MB 로 줄일 수 있었다.
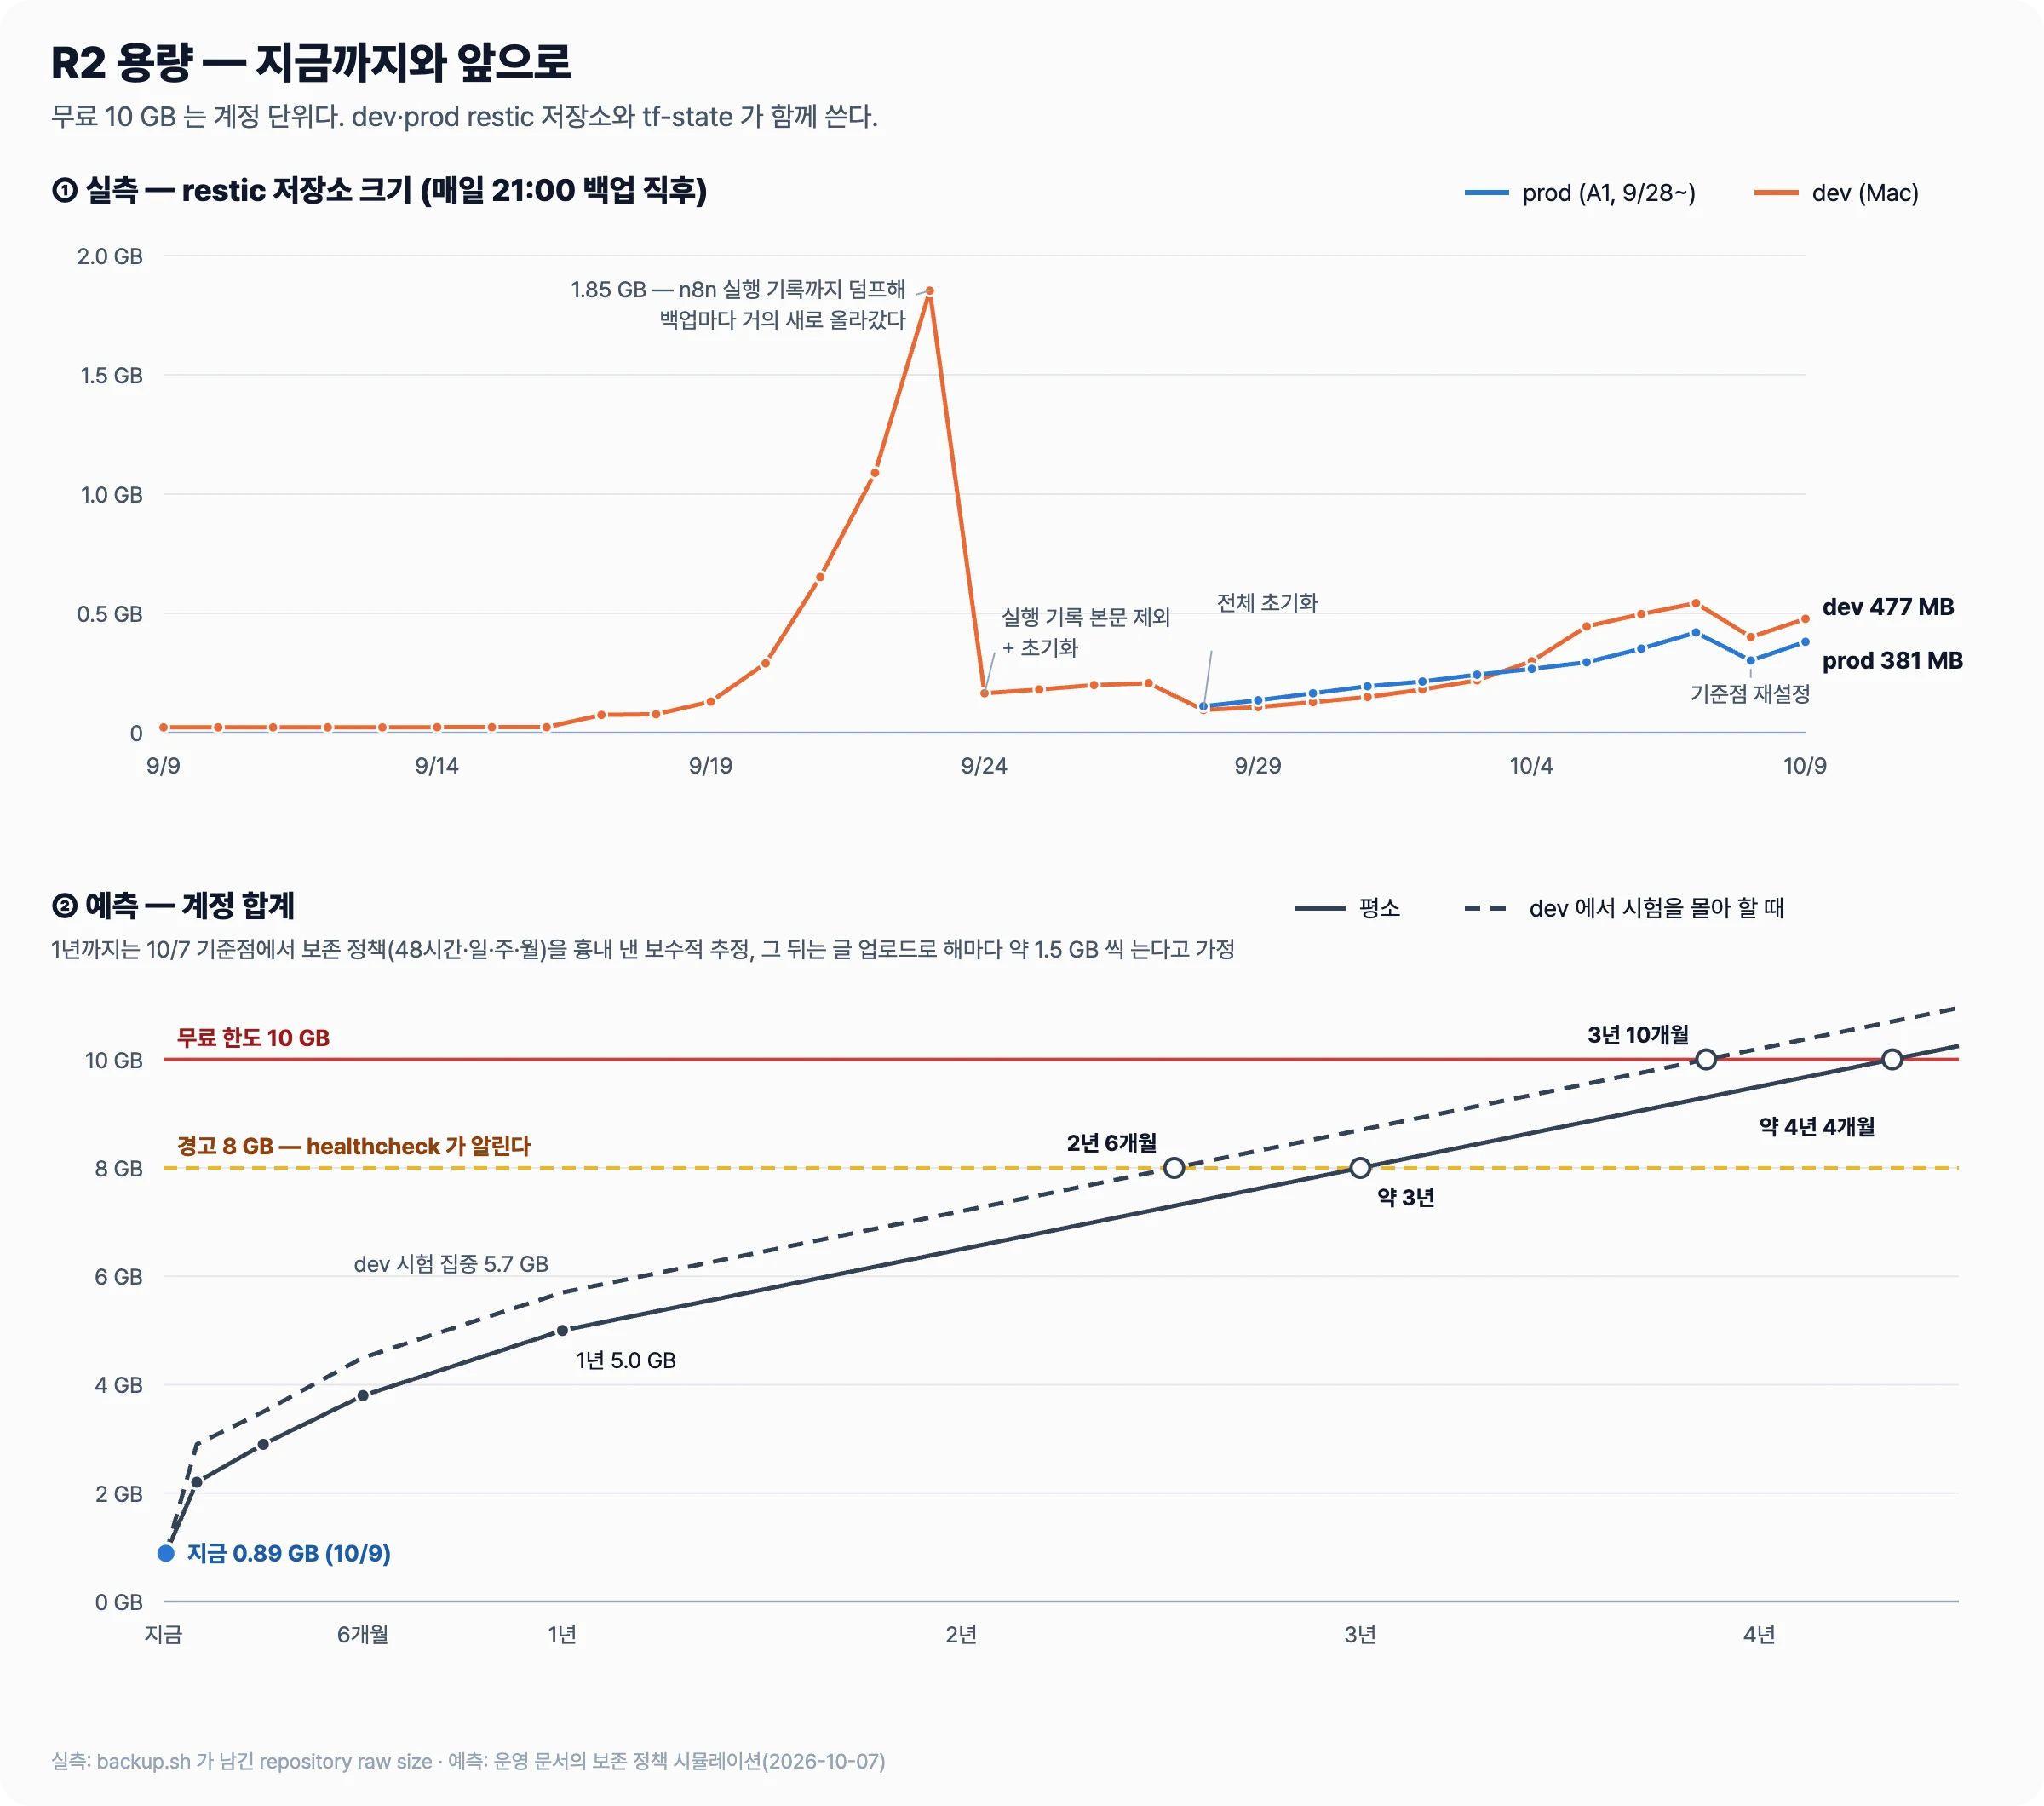
그림의 위쪽 그래프가 그동안의 실측이다. 9월 23일의 1.85 GB 스파이크가 그 사고이고 이후 두 번의 초기화와 10월 7일 기준점 재설정을 거쳐 지금에 이르렀다. 9월 28일부터 10월 7일까지 하루 평균 prod 는 약 34 MB, dev 는 약 50 MB 씩 늘었다.
보존 정책이 오래된 스냅샷을 지우니 이 속도가 그대로 이어지지는 않는다. 48시간이 지난 정시 스냅샷은 하루 하나만 남고 2주가 지나면 주 하나, 두 달이 지나면 달 하나만 남는다. 처음 몇 주는 빠르게 늘다가 반년쯤 지나면 거의 평평해진다. 그 뒤로는 새 글의 이미지처럼 지워지지 않는 것만 쌓인다. 보존 정책을 그대로 흉내 내 계산한 예측이 그림의 아래쪽 그래프이고 그 숫자를 아래 표에 옮겼다.
| 시점 | 계정 합계 (평소) | dev 에서 자주 실험 했을때 |
|---|---|---|
| 30일 | 2.2 GB | 2.9 GB |
| 90일 | 2.9 GB | 3.5 GB |
| 180일 | 3.8 GB | 4.5 GB |
| 1년 | 5.0 GB | 5.7 GB |
| 8 GB 경고 도달 | 약 3년 | 약 2년 6개월 |
| 10 GB 한도 도달 | 약 4년 4개월 | 약 3년 10개월 |
1년까지는 운영 문서에 적은 보수적 추정이고 그 뒤는 글 업로드로 해마다 1.5 GB 쯤 는다고 가정했다. 첫 10일 실측보다 1.5배 크게 잡은 값이라 실제로는 더 오래 버틸 가능성이 크다.
한도에 다가갈 때 조절할 수 있는 설정도 미리 마련했다. 보존 개수는 BACKUP_KEEP_DAILY·WEEKLY·MONTHLY 환경변수로 바꾼다. dev 는 이미 7·4·0 으로 줄여 몇 달 치를 남기지 않는다. 계정 합계가 8 GB 를 넘으면 healthcheck 가 경고 메일을 보낸다. 그때 prod 보존을 줄이거나, 가장 큰 몫인 n8n 의 그림 파일을 따로 떼어 낼 생각이다.
정리 — A1은 갑자기 사라질 수 있다. 지켜야 할 것은 백업이다.
이 블로그를 되살리는 데는 GitHub 의 비공개 저장소, Cloudflare 계정의 R2, 그리고 age 키 파일 하나가 필요하다. A1 은 이 목록에 없다. 사라지면 다시 만들고 만들기 어려우면 그동안 Mac 이 대신 서빙한다. (맥북 안끄고 버티기!)
백업 사본이 아직 R2 한 곳뿐인 건 약점이다. Cloudflare 계정이 막히면 백업도 함께 묶인다. 두 번째 사본을 다른 저장소에 두는 일은 다음 과제로 남겼다.
지금 백업은 하루 네 번, 한 번에 20초 남짓 돈다. 이 백업으로 복구해야 하는 날은 오지 않기를 바란다. 그날이 오더라도 몇 분이면 돌아올 수 있다는 건 세 번의 복구작업 전환 검증으로 확인했다.