블로그 자동화 시스템(blog-platform)은 n8n이 RSS와 공시 피드로 경제·투자 기사를 하루 1,500건쯤 모으는 데서 시작한다. 모은 기사를 분류하고 같은 사건끼리 묶어 점수를 매긴다. 점수가 높은 사건은 LLM이 초안으로 쓴다. 그런데 기사를 모으기 시작하자마자 가장 시급히 해결이 필요했던 것은 중복 제거였다. 연합뉴스는 같은 기사를 “(종합)”, “(종합2보)”로 고쳐 다시 내보내고 토큰포스트는 하루 네 번 같은 틀의 시세 브리핑을 올린다. DART 공시는 회사 이름만 다르고 문장이 똑같은 서류가 줄줄이 들어온다.
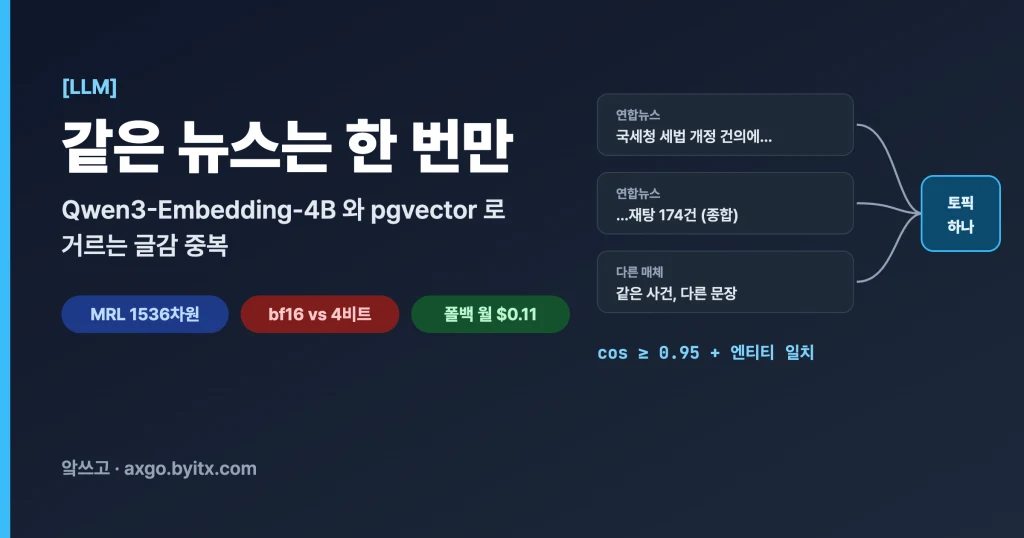
중복을 제거하지 않으면 같은 뉴스와 사건이 글감 여러 개로 쪼개진다. 쪼개진 만큼 “여러 매체가 다룬 사건”처럼 점수에서 과도한 차이가 발생하고, 지난주에 발행했던 글을 이번 주에 발행하는 일이 발생한다. 이 글은 그 중복을 임베딩으로 극복한 기록이다. 임베딩 모델은 Qwen3-Embedding-4B, 벡터 저장소는 pgvector를 사용하게 되면서 이 두 가지를 선택한 이유, Local Mac에서 MLX 4비트 양자화 버전으로 시작했다가 bf16 원본으로 변경하게된 테스트 근거, Local Mac 임베딩 모델과 최소한의 오차로 OpenRouter 임베딩 모델을 사용하는 이중화 구조와 그 비용, 백업에서 백터DB 를 빼고 서버를 마이그레이션하는 방법까지 적었다.
기사 분류를 Jev 결정 모델로 바꾼 이야기는 n8n 뉴스 분류 글에, 백업 구조는 restic·R2 백업 글에 따로 정리해 두었다.
목차
같은 뉴스가 하루에도 몇 번씩 들어오고 있다
처음에는 중복을 두 단계로 거를 생각이었다.
먼저 주소를 고유값으로 처리한다. 수집 워크플로우가 기사 주소에서 utm_ 같은 추적 값을 지우고 sha256 해시를 만들어 url_hash 열에 UNIQUE를 건다. 같은 주소가 다시 들어오면 ON CONFLICT DO NOTHING으로 버린다. 여기까지 생각하기는 어렵지 않았다. 하지만 주소는 다른데 내용이 같은 기사들이 존재 하는 경우들이 발생했다.
그다음은 임베딩이다. 기사 제목과 요약 앞 300자를 벡터로 바꾸고, 최근 72시간 안에 들어온 기사 중 가장 가까운 것과 코사인 유사도를 잰다. 처음 계획에는 기준값을 이렇게 잡아 두었다.
- 유사도 0.92 이상: 같은 기사로 보고 건너뛴다
- 유사도 0.85~0.92: 같은 주제로 보고 한 글로 묶는다
- 유사도 0.80 미만: 새로운 기사
dev에 기사 400건을 넣고 실제 측정을 해보니 이 기준을 써먹기는 어려운 상태었다. 같은 뜻을 다르게 쓴 “코스피 2% 상승”과 “코스피 지수 2퍼센트 상승”은 0.80이었다. 반대로 회사만 다르고 양식이 같은 공시, “첼린저제사십차”와 “제사십일차 유동화전문유한회사”는 0.9902가 나왔다. 같은 것이 낮고 다른 것이 높으니 코사인 기준값 하나로 판정하기 어려웠다.
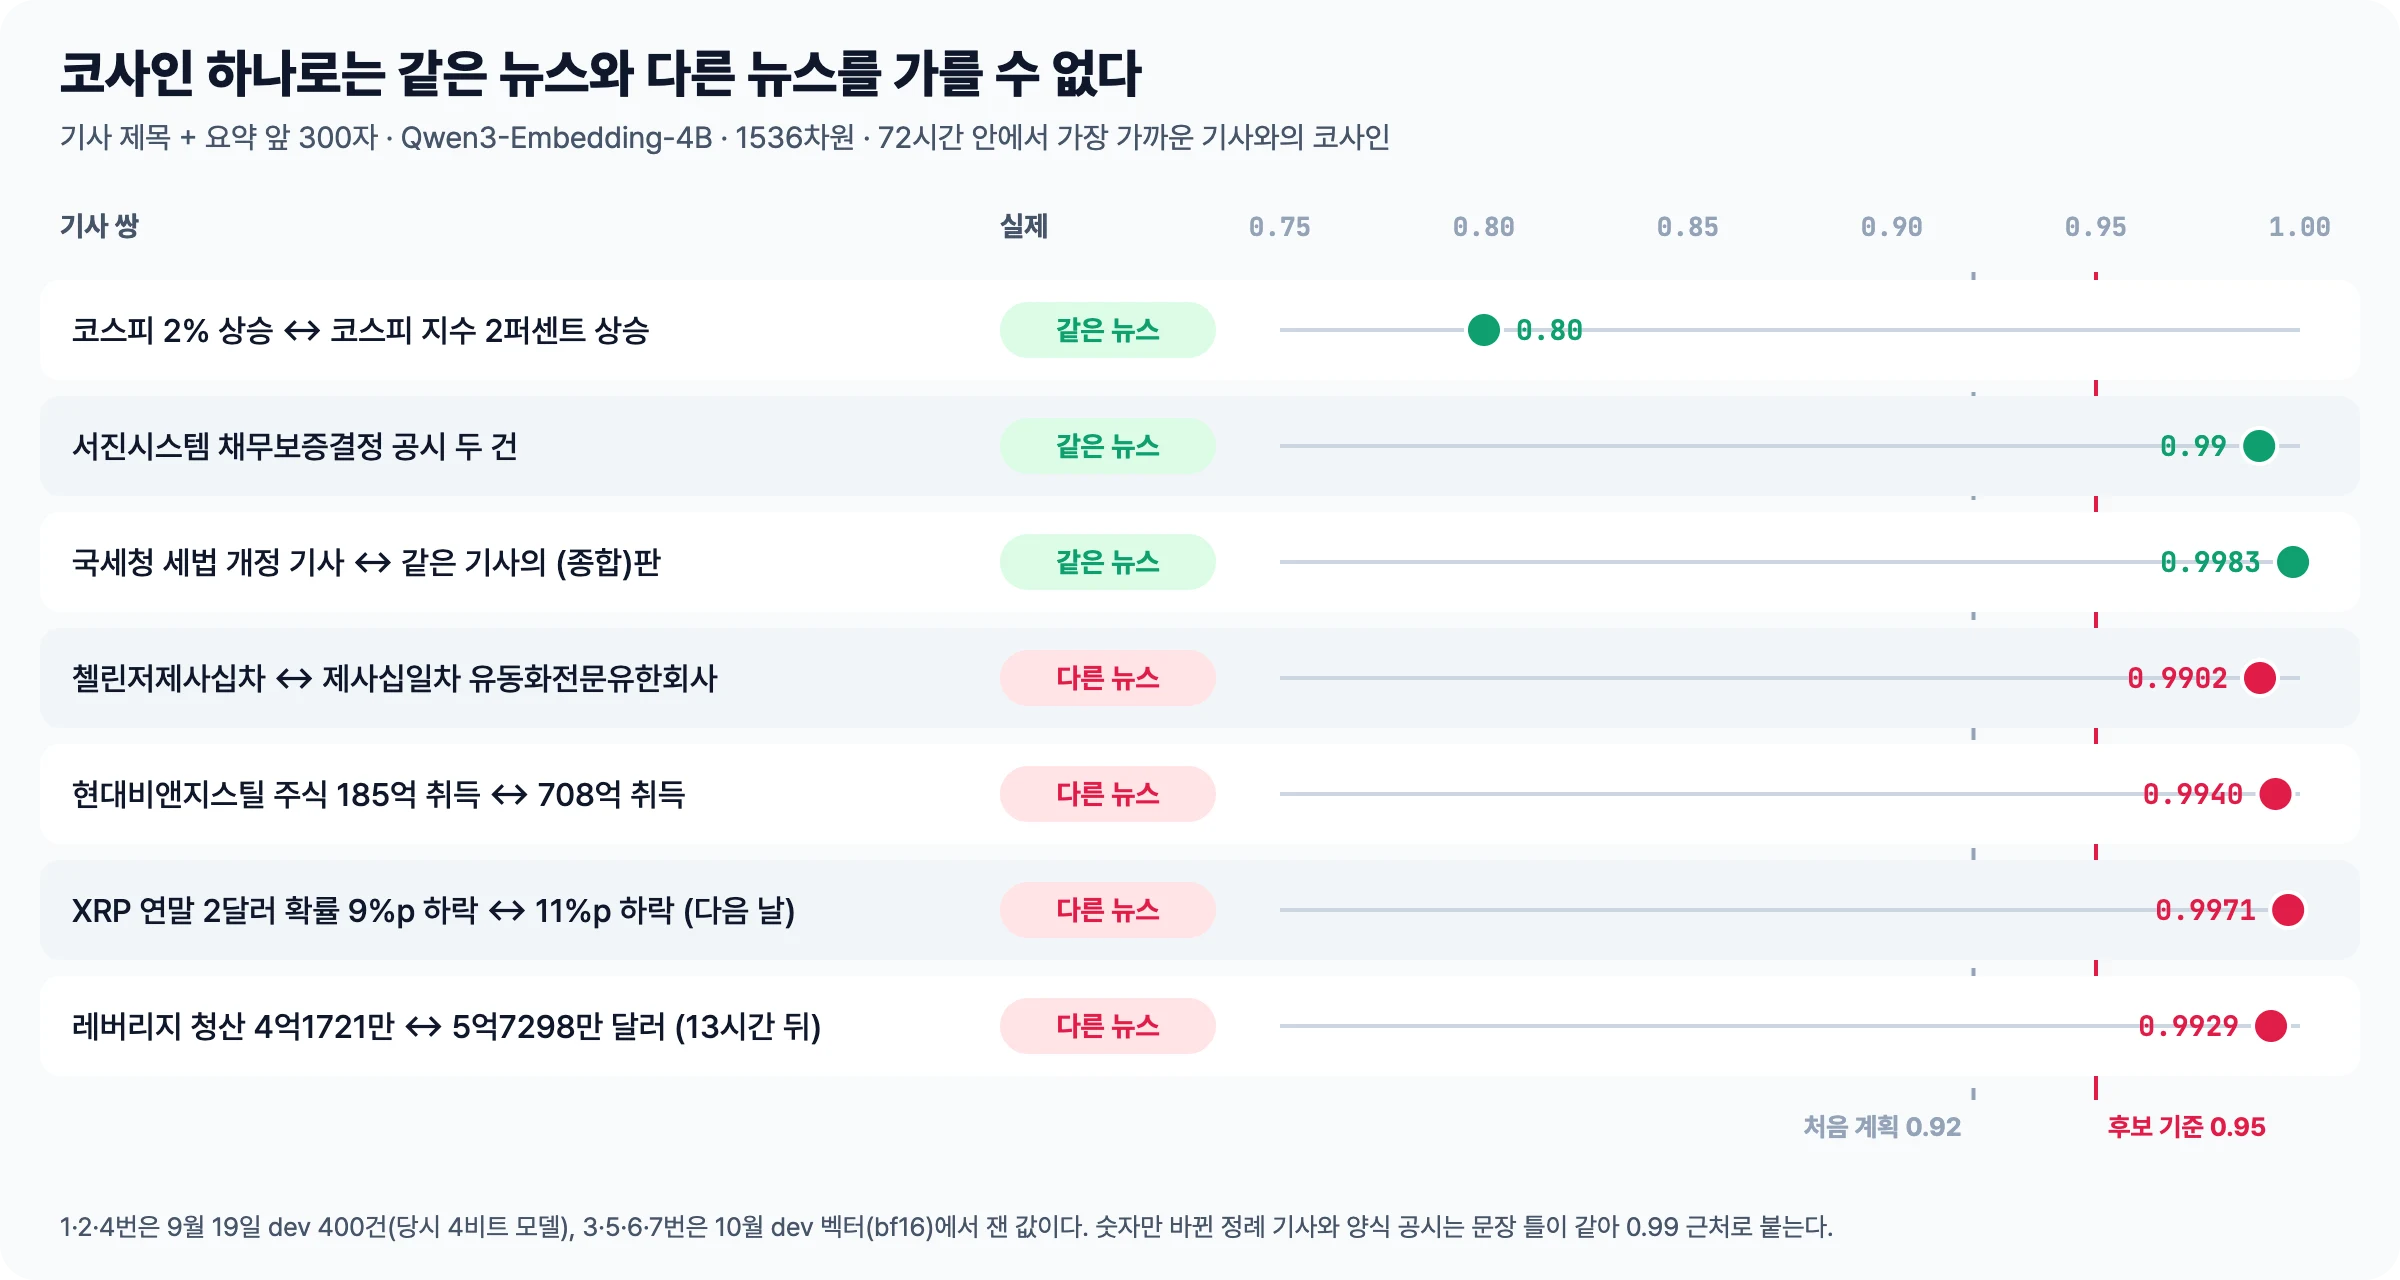
그래서 코사인에는 후보를 고르는 일만 맡겼다. 0.95 이상인 쌍을 후보로 올리고 분류 단계에서 뽑아 둔 엔티티(회사·종목·기관·인물 이름)가 겹칠 때만 중복으로 본다. 첼린저 두 회사는 엔티티가 겹치지 않아 빠지고 서진시스템의 같은 공시 두 건은 겹쳐서 묶인다. 이 규칙 하나로 dev 400건의 중복 후보가 23건에서 8건으로 줄었고 첼린저 같은 양식 공시 5건은 정확히 빠졌다. 글자까지 거의 똑같은 재게재(0.999 이상)만 엔티티 없이도 중복으로 본다. 임베딩이 분류보다 먼저 도는 경우가 많아 막 들어온 기사에는 아직 엔티티가 없기 때문이다.
지금 dev 벡터에서 코사인이 높은 쌍을 뽑아 보면 이 문제가 그대로 보인다.
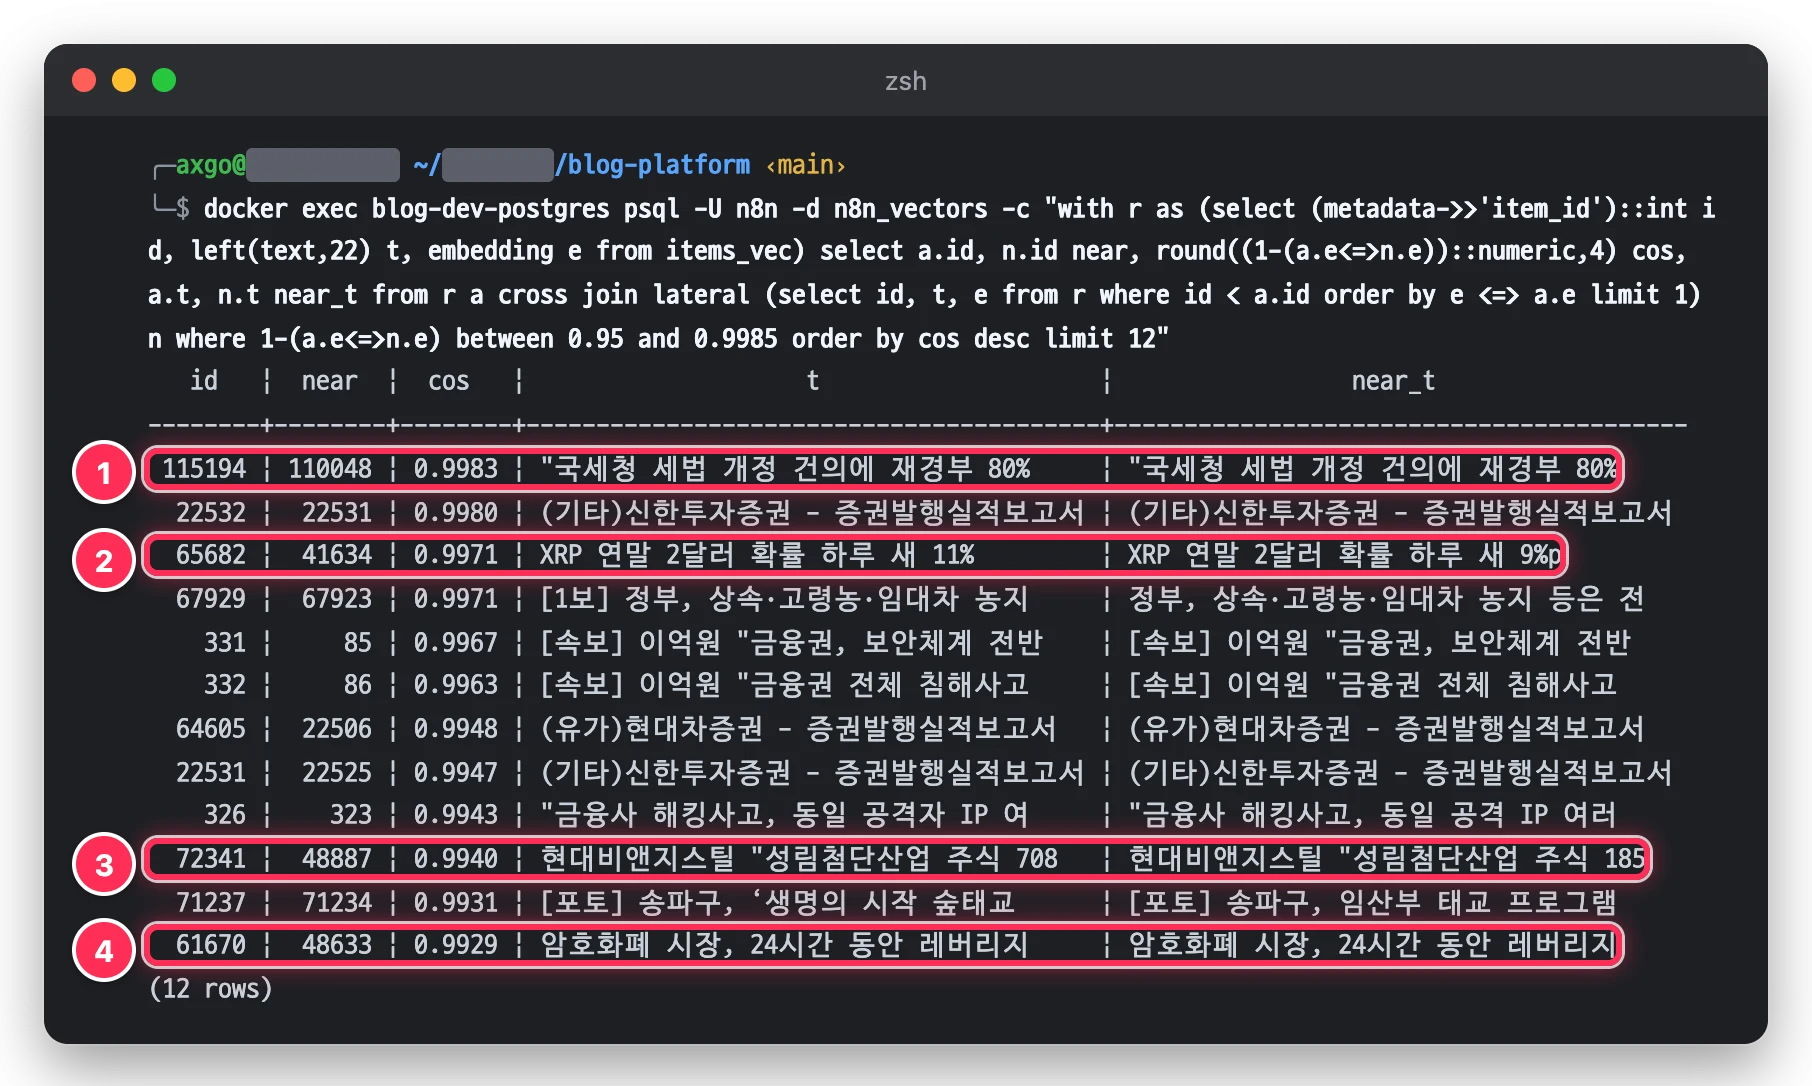
① 같은 기사의 (종합)판
② 하루 차이로 숫자가 바뀐 XRP 기사
③ 185억 원과 708억 원, 서로 다른 취득 공시
④ 13시간 간격으로 나온 레버리지 청산 통계.
0.99 근처에 같은 기사의 종합판과, 숫자만 다른 다른 날 기사가 섞여 있다. XRP 기사는 하루 차이로 9%p가 11%p로 바뀌었다. 현대비앤지스틸 공시는 185억 원 취득과 708억 원 취득이라는 서로 다른 건이다. 정례 기사와 양식 공시는 문장 틀이 같아서 코사인만 보면 같은 기사처럼 보인다.
엔티티가 아직 없어 임베딩 단계를 그냥 통과한 종합판은 다음 집계 단계에서 그룹핑한다. 분류가 끝나면 집계 워크플로우가 72시간 안의 벡터끼리 이웃을 찾고 엔티티가 겹치는 쌍을 이어 같은 사건으로 그룹핑한다. 위 화면의 국세청 기사 두 건은 중복 표시 없이 따로 분류 됐지만 집계 단계에서 하나의 토픽으로 합쳐졌다.
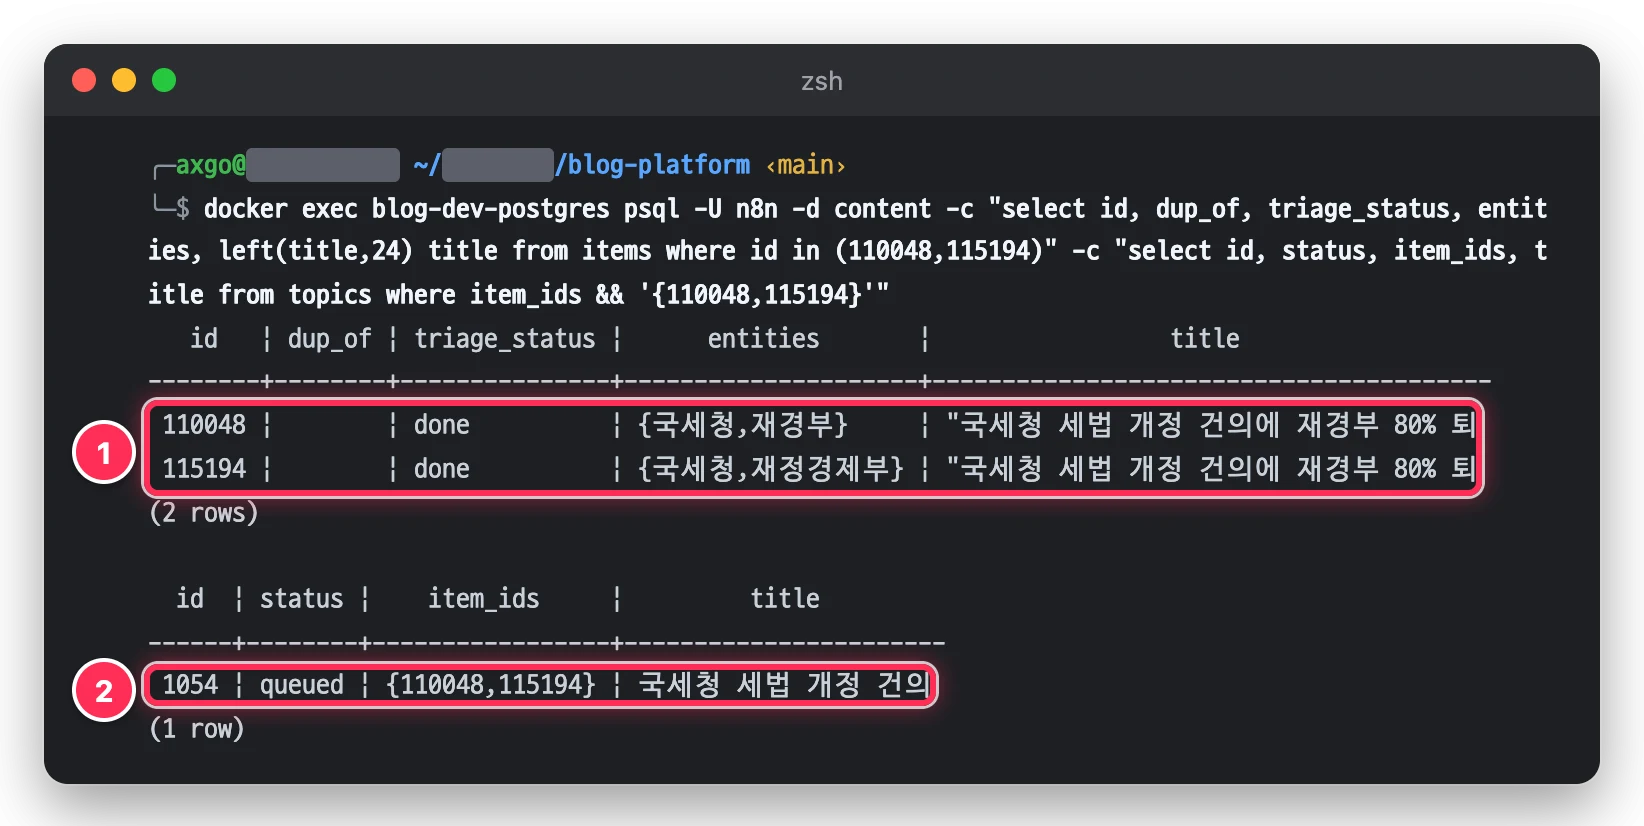
② 집계 워크플로우가 두 기사를 토픽 1054 하나로 묶었다
결국 최종 중복 제거는 다섯 단계를 거치게 됐다. 수집 워크플로우가 같은 주소를 버리고 임베딩 워크플로우가 거의 같은 재게재 여부를 표시한다. 분류는 표시가 없는 기사만 분류 한다. 집계에서 같은 사건을 하나로 묶고, 초안을 쓰기 전에 이미 발행된 글과 한 번 더 비교한다.
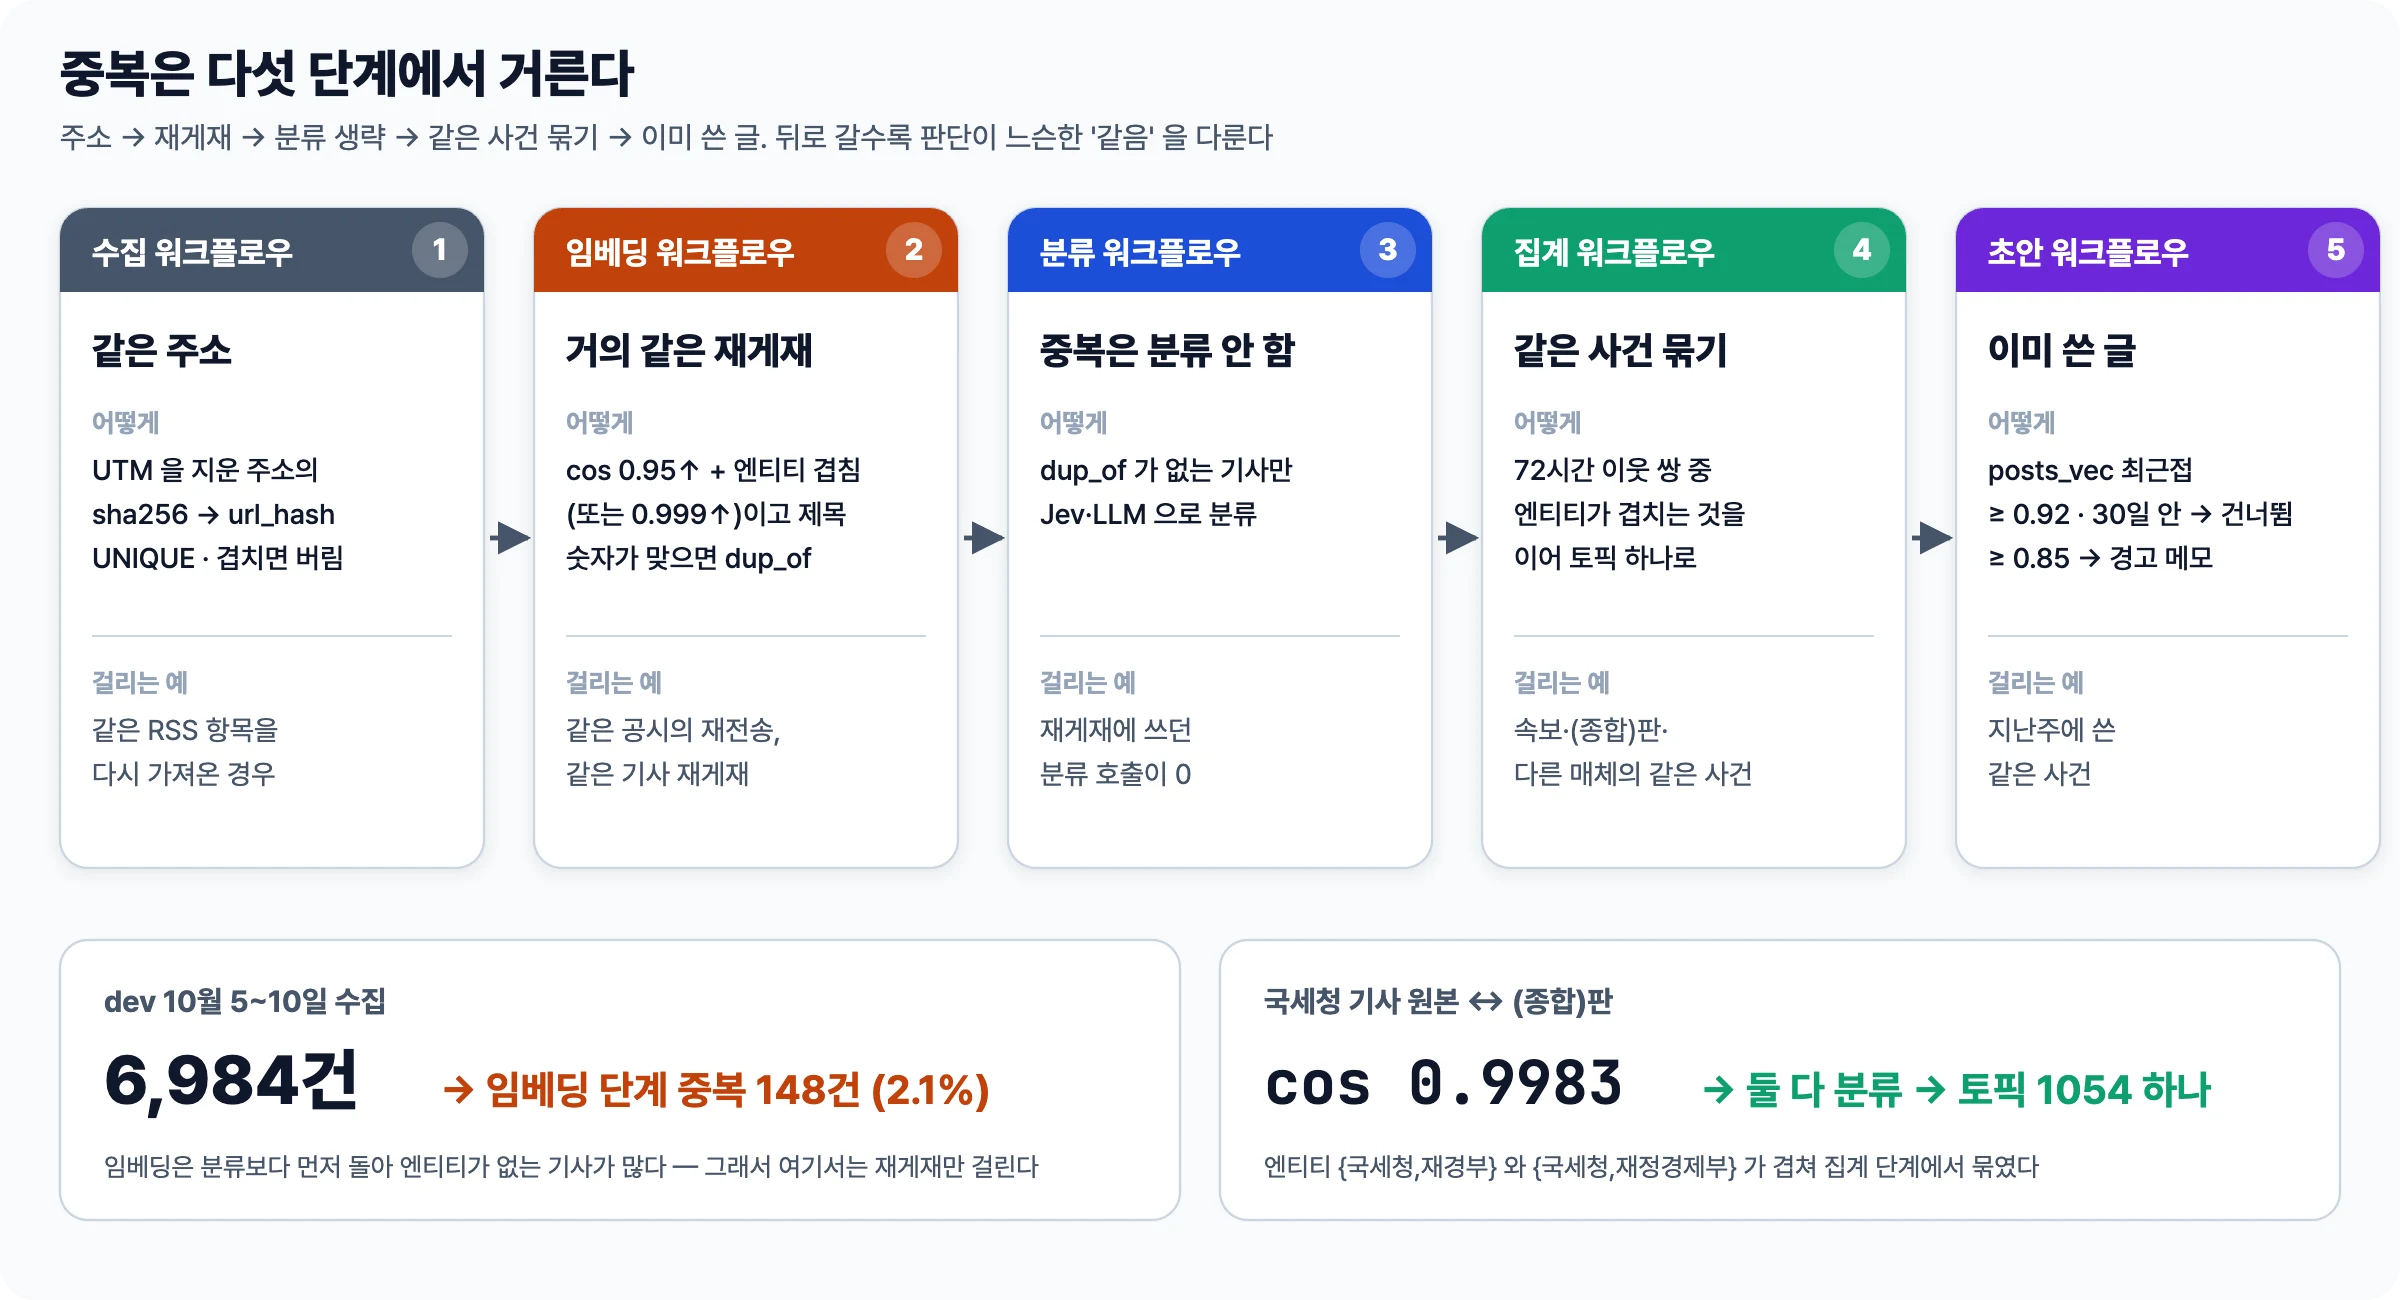
dev에서 10월 5일부터 10일까지 모인 기사 6,984건 가운데 임베딩 단계에서 중복으로 표시된 것은 148건(2.1%)이었다. 생각보다 적다. 같은 뉴스/사건 그룹핑은 집계 워크플로우가 맡고 임베딩 단계는 분류에 Jev·LLM을 쓰기 전에 똑같은 기사만 덜어 내는 역할이라 그렇다.
같은 회사의 같은 양식의 공시는 엔티티가 겹친다. 현대비앤지스틸 두 건이 분류를 먼저 받아 엔티티가 붙은 상태였다면, 코사인 0.994에 엔티티도 같으니 708억 원 공시가 185억 원 공시의 중복으로 그룹핑되어 분류에서 빠졌을 것이다. 이 두 건은 임베딩이 분류보다 먼저 돌아서 운 좋게 피해 갔을 뿐이다. dev에서 중복 148건을 다시 훑어보니 7건은 실제로 이렇게 묶여 있었다. 숫자만 바뀐 24시간 청산 통계 5건, 글로벌 유동성 레이더 1건, “삼성전자 영업이익 100조 돌파”와 “삼성전자 107조 4천억 원” 기사 1건이다.
그래서 임베딩 워크플로우의 중복 판정에 조건을 하나 더 넣었다. 두 제목에서 숫자를 뽑아, 한쪽 숫자 묶음이 다른 쪽에 다 들어 있을 때만 중복으로 본다. 한쪽에 숫자가 없거나 숫자를 더 붙인 경우는 그대로 중복으로 처리한다. “(종합2보)”의 2나 “[1보]”의 1 같은 표지 숫자는 기사의 내용이 아니라서 빼도록 했다. 트랜잭션 안에서 시험해 보니 185억/708억 공시와 9%p/11%p XRP 기사는 코사인을 0.9999로 쿼리를 해봐도 다른 토픽으로 분류 되었다, 반면 국세청 원본과 뉴스기사는 그대로 그룹핑 되었다. 방식을 정리하고 최근 72시간 안에 이미 잘못 묶여 있던 기사는 분류를 다시 잡았다.
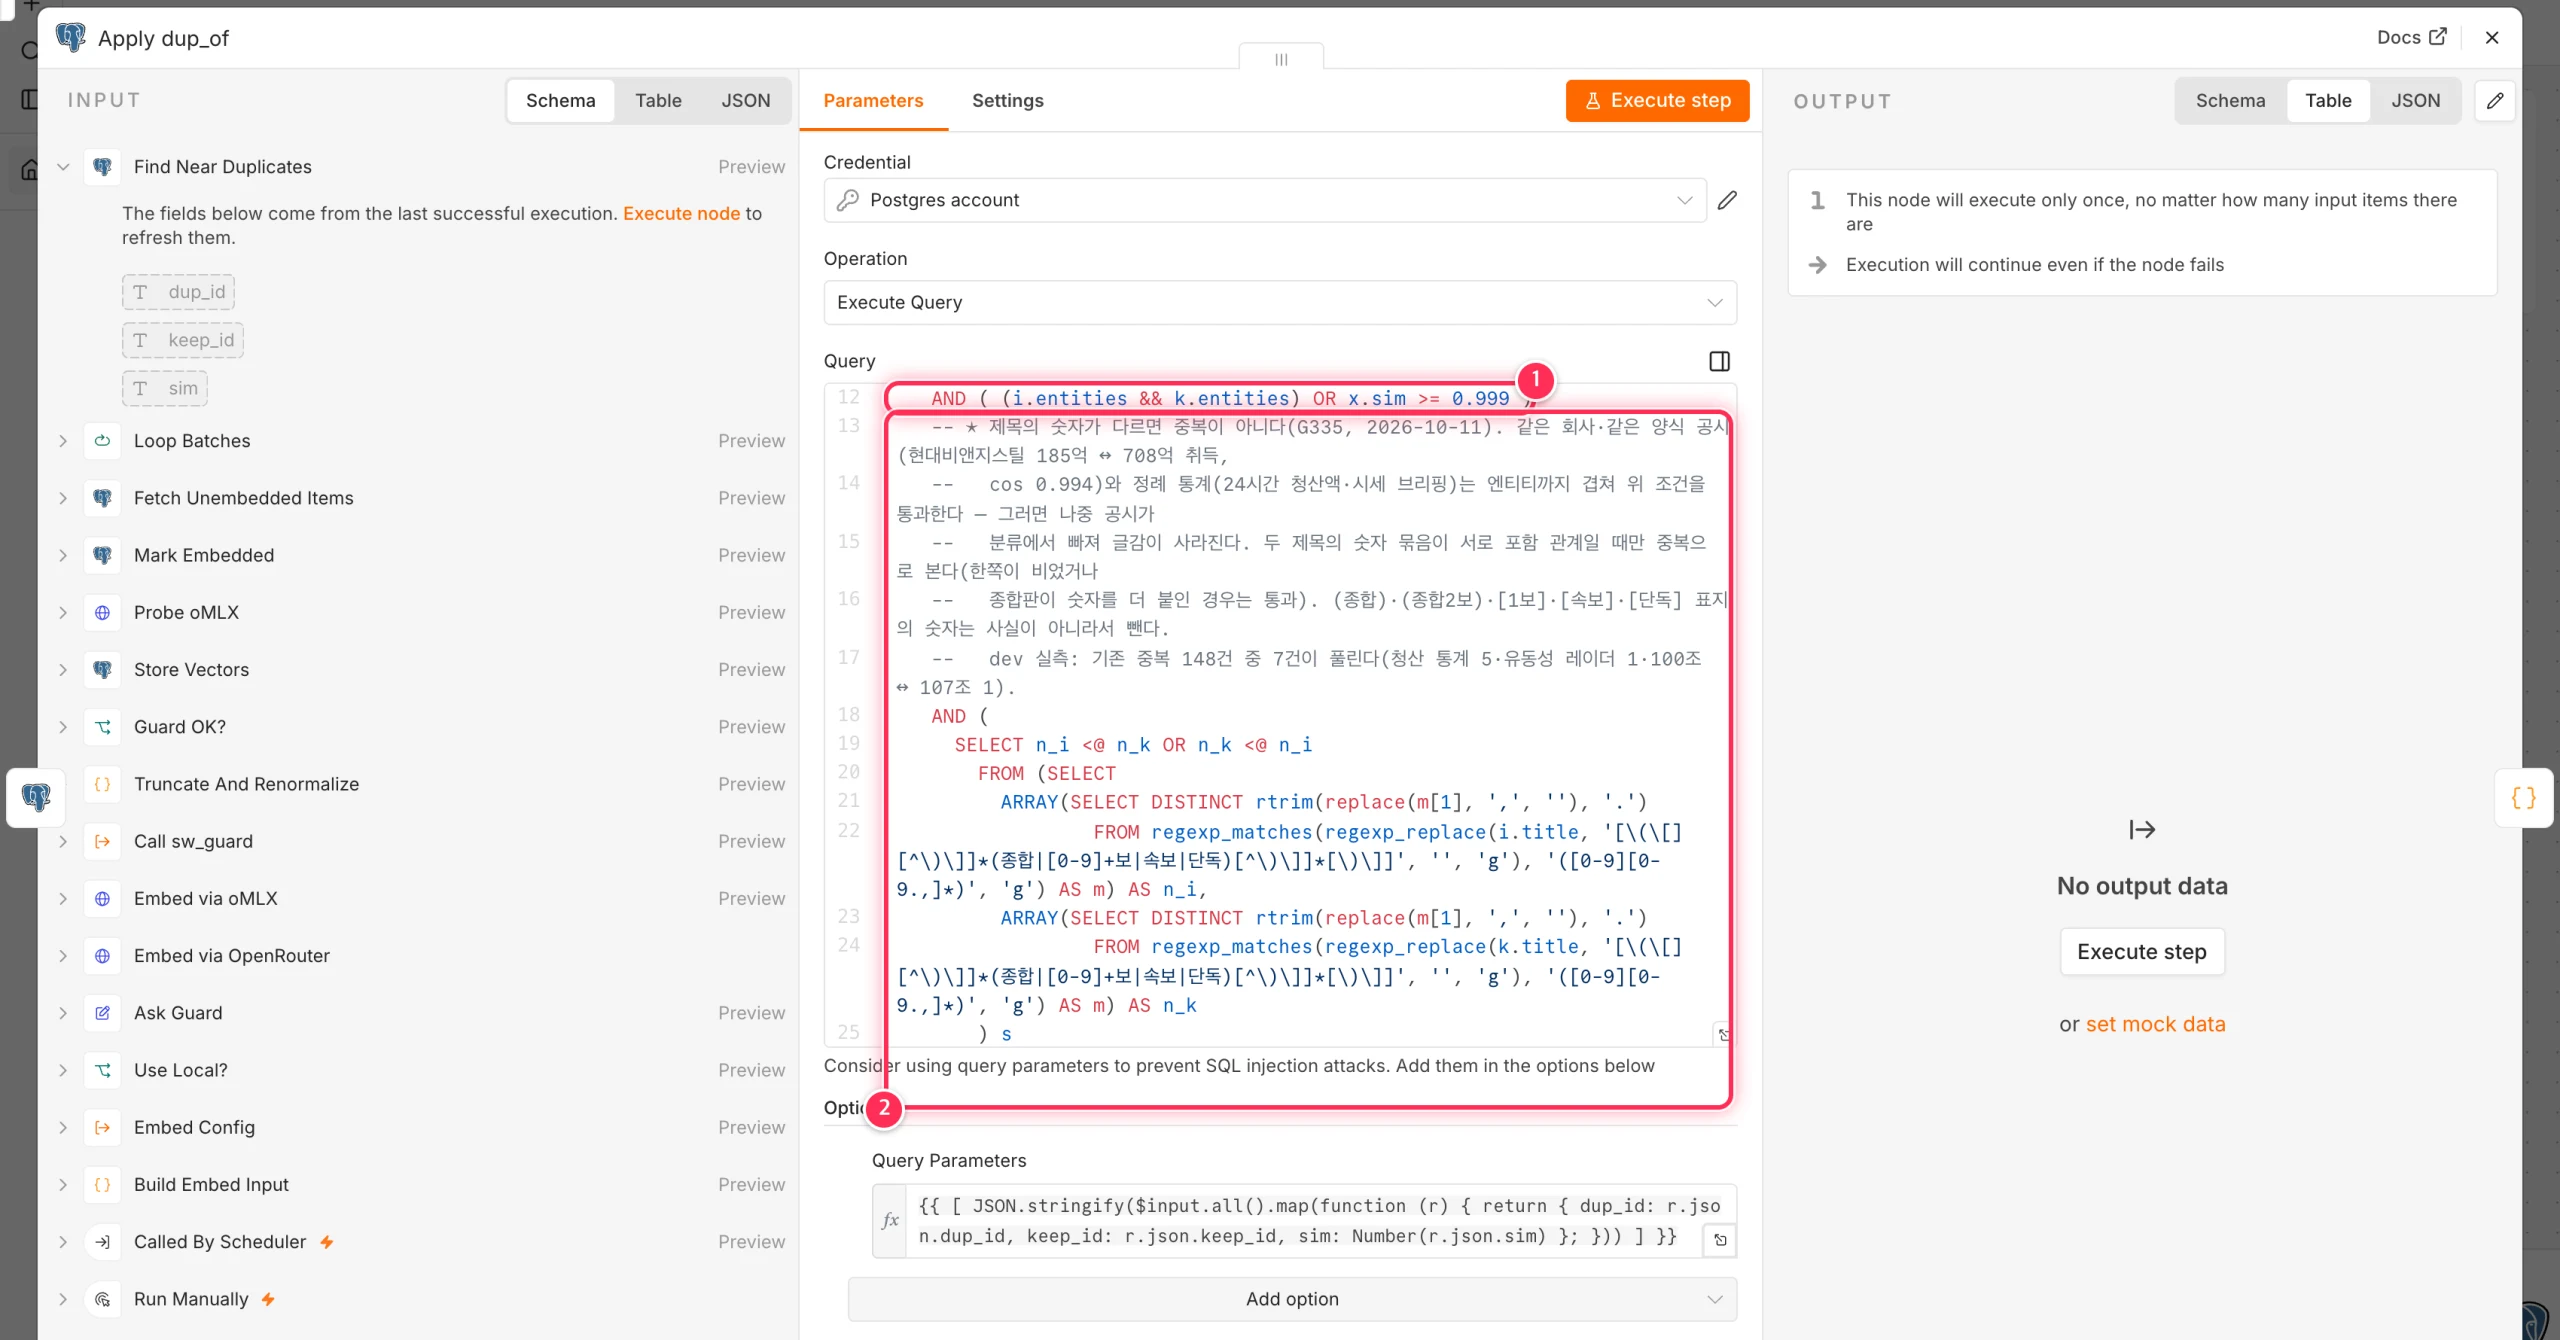
① 원래 조건: 엔티티가 겹치거나 코사인 0.999 이상
② 새로 넣은 조건: 두 제목의 숫자 묶음이 서로 포함 관계여야 한다.
n8n에서 흔한 Qdrant 대신 pgvector
n8n으로 RAG를 만드는 예제를 찾아보면 벡터 저장소는 대개 Qdrant다. n8n에 Qdrant Vector Store 노드가 있고 템플릿도 많다. 처음엔 나도 Qdrant 컨테이너를 하나 더 띄울 생각이었는데 클라우드 서버가 마음에 걸렸다.
prod는 오라클 클라우드 무료 등급의 A1 인스턴스(2 OCPU, 메모리 12 GB) 한 대에서 WordPress·MariaDB·Redis·PostgreSQL·n8n·nginx·백업 컨테이너를 다 돌린다. 여기에 Qdrant를 넣으면 메모리를 따로 먹는 서비스가 하나 늘고 볼륨·백업 범위·버전 올리기·장애 감시도 하나씩 늘어나야 한다. 그런데 PostgreSQL은 n8n 메타 DB용으로 이미 사용중이었다. 이미지만 postgres:17.6-alpine에서 pgvector/pgvector:0.8.6-pg17로 바꾸면 같은 컨테이너에서 벡터를 다룰 수 있었다(지금은 0.8.7).
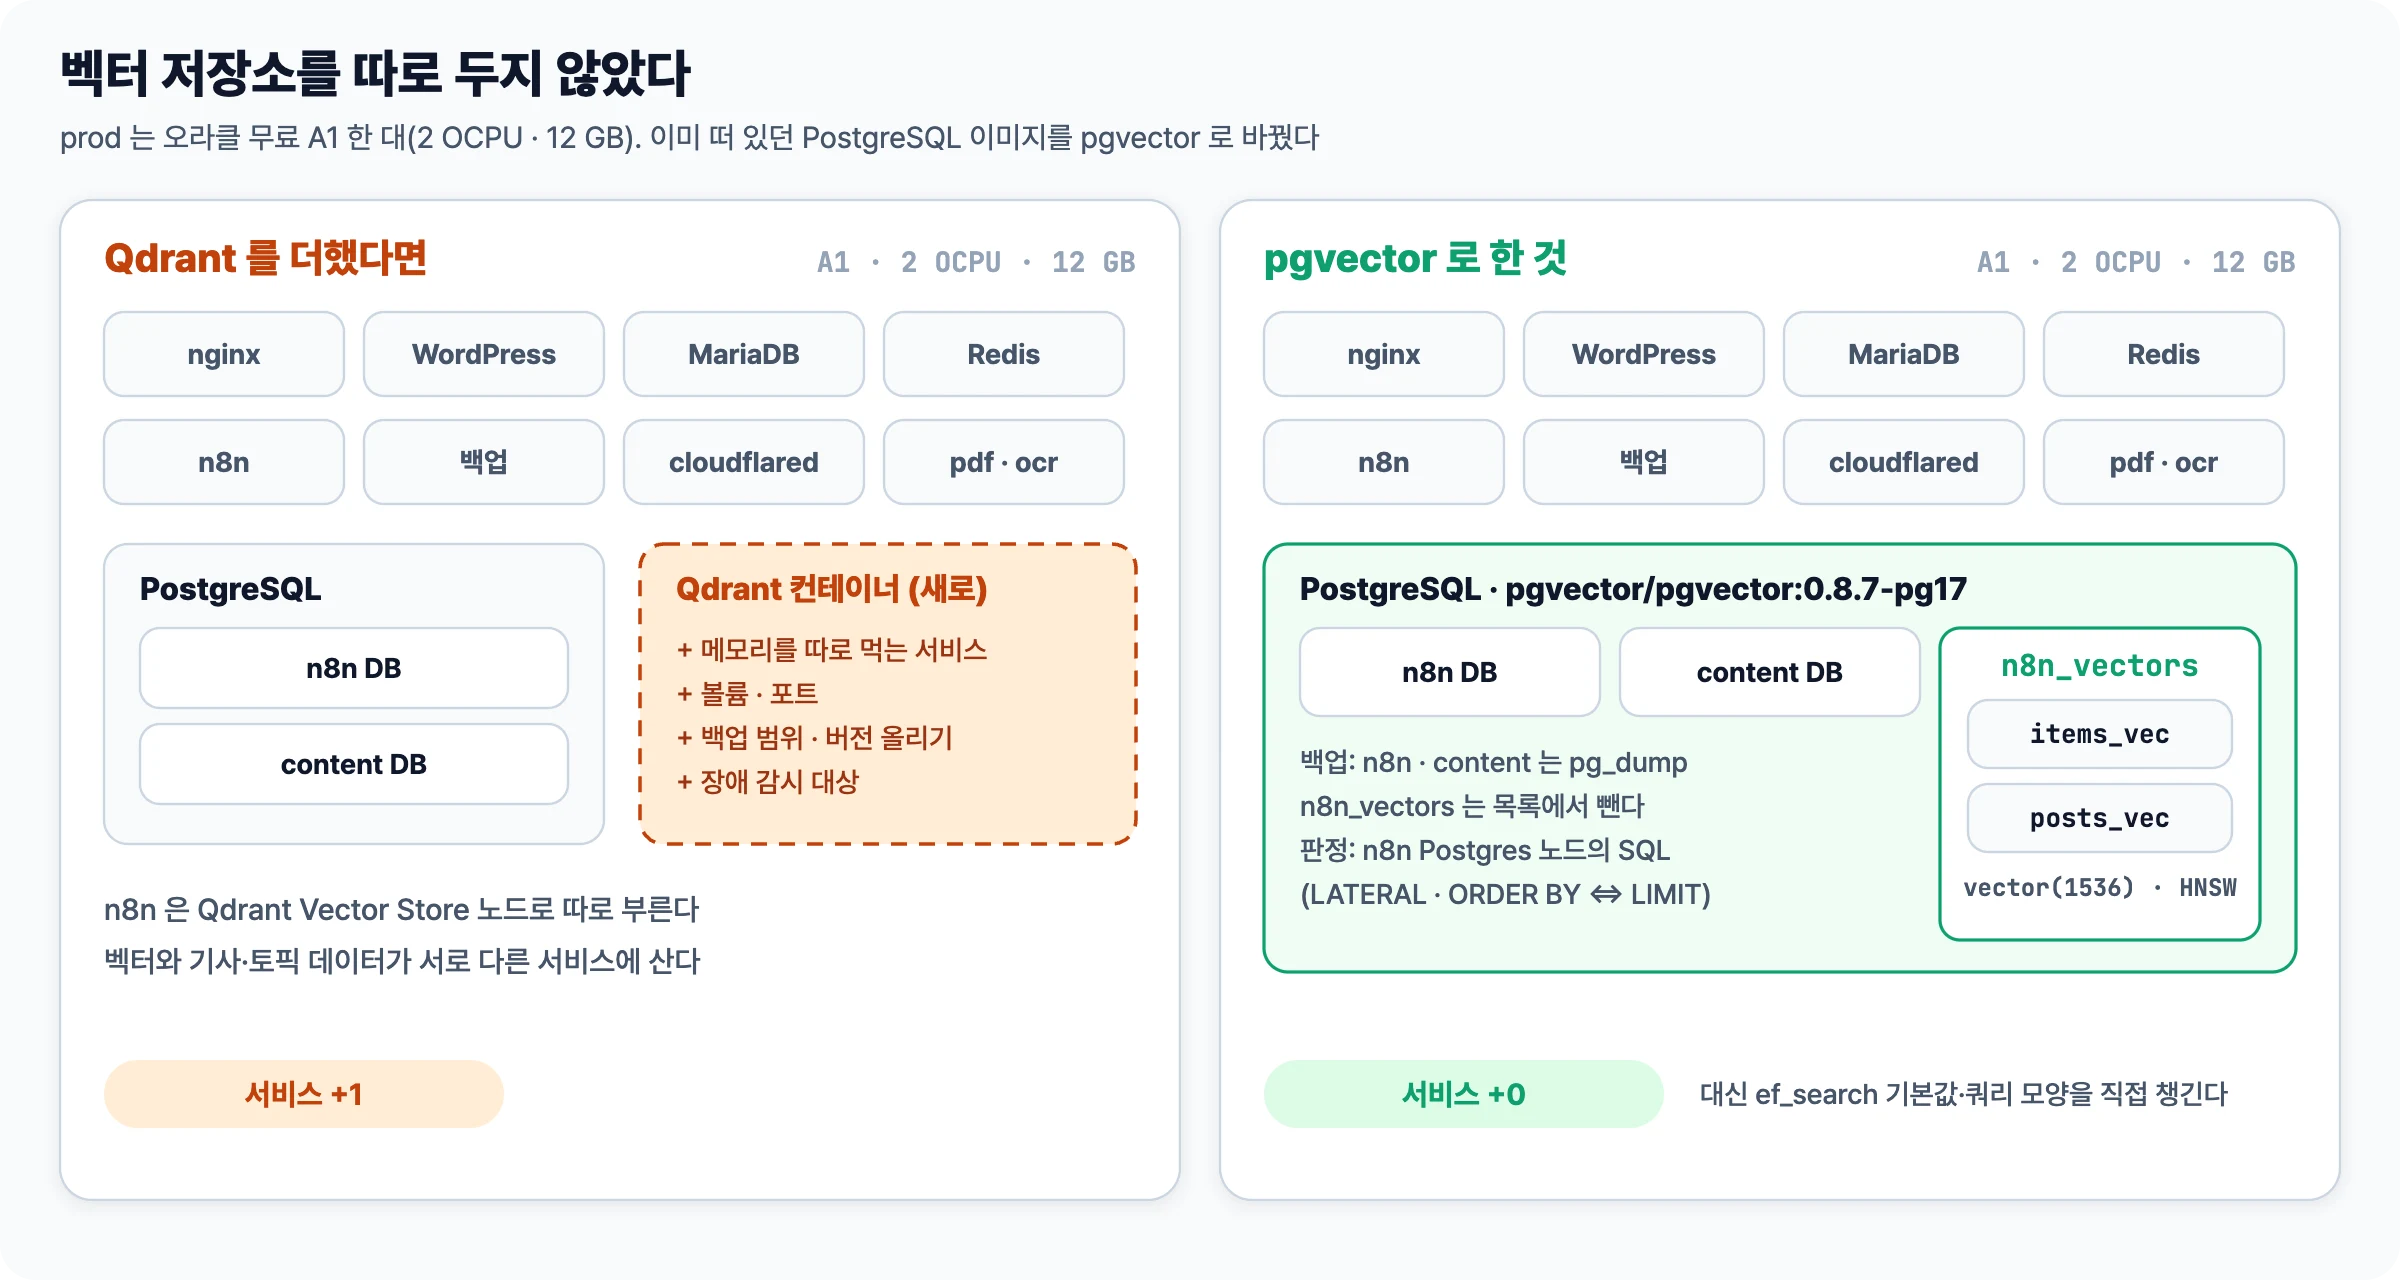
바꾸고 나서 좋았던 점은 이렇다.
- 서비스가 늘지 않았다. 벡터는 같은 PostgreSQL 안의 별도 DB
n8n_vectors에 둔다. 컨테이너·포트·모니터링 대상에 변경이 없다. - 판정을 SQL로 짤 수 있다. 중복 판정은 “최근 72시간 안에 들어온 기사 중 오래되고 유사도가 가장 가까운 것”을 찾는 일이다.
ORDER BY embedding <=> 기준 LIMIT 20을LATERAL로 감싸고 시각·id 조건을 바깥에서 거르면 SQL 한 문장이 된다. n8n의 Postgres 노드에서 SQL을 그대로 호출할 수 있다. - 백업에서 빼기 쉽다. 백업 컨테이너는 DB 단위로
pg_dump를 한다.n8n_vectors만 목록에 넣지 않으면 된다. - 늘 쓰던 도구로 확인할 수 있다. psql로 벡터 개수, 제공자별 분포, 인덱스 크기를 바로 확인할 수 있다.
하지만 완전히 이득만 있는 것은 아니었다.
- alpine(musl) 이미지에서 Debian(glibc) 이미지로 옮기는 거라 데이터 디렉터리를 그대로 쓸 수 없었다(collation이 어긋난다). dev는
pg_dump→ 새로 initdb →pg_restore로 마이그레이션 작업이 필요했다. - HNSW 인덱스를 타면
LIMIT 80이 40행만 돌려준다. 검색 후보 수hnsw.ef_search의 기본값이 40이라서다. 처음엔 이유도 몰랐다. n8n pgsql 노드에서 세션 설정을 할 수 없어서 DB 기본값을 240으로 설정해뒀다. 무작위 벡터 2,000행으로 재 보니 정확 탐색 대비 상위 80개 재현율이 ef 80에서 84%, 160에서 90%, 240에서 98%였다. - 쿼리가 나쁘면 인덱스를 안 탄다. 처음 짠 중복 판정은 CTE를 두 번 참조하는 바람에 PostgreSQL에서 최근 72시간 기사 전체를 서로 다 비교했다. 그 쿼리를 n8n 노드가 입력한 항목 수만큼, 42번 반복했다. prod postgres가 30분마다 최대 12분씩 CPU를 100%로 사용하는 상태가 발생했다. 실행중 임베딩 하려는 기사만 판정하고 Inner 검색을
ORDER BY <=> LIMIT 20으로 바꾸자 42건 판정이 1.9초만에 끝났다.
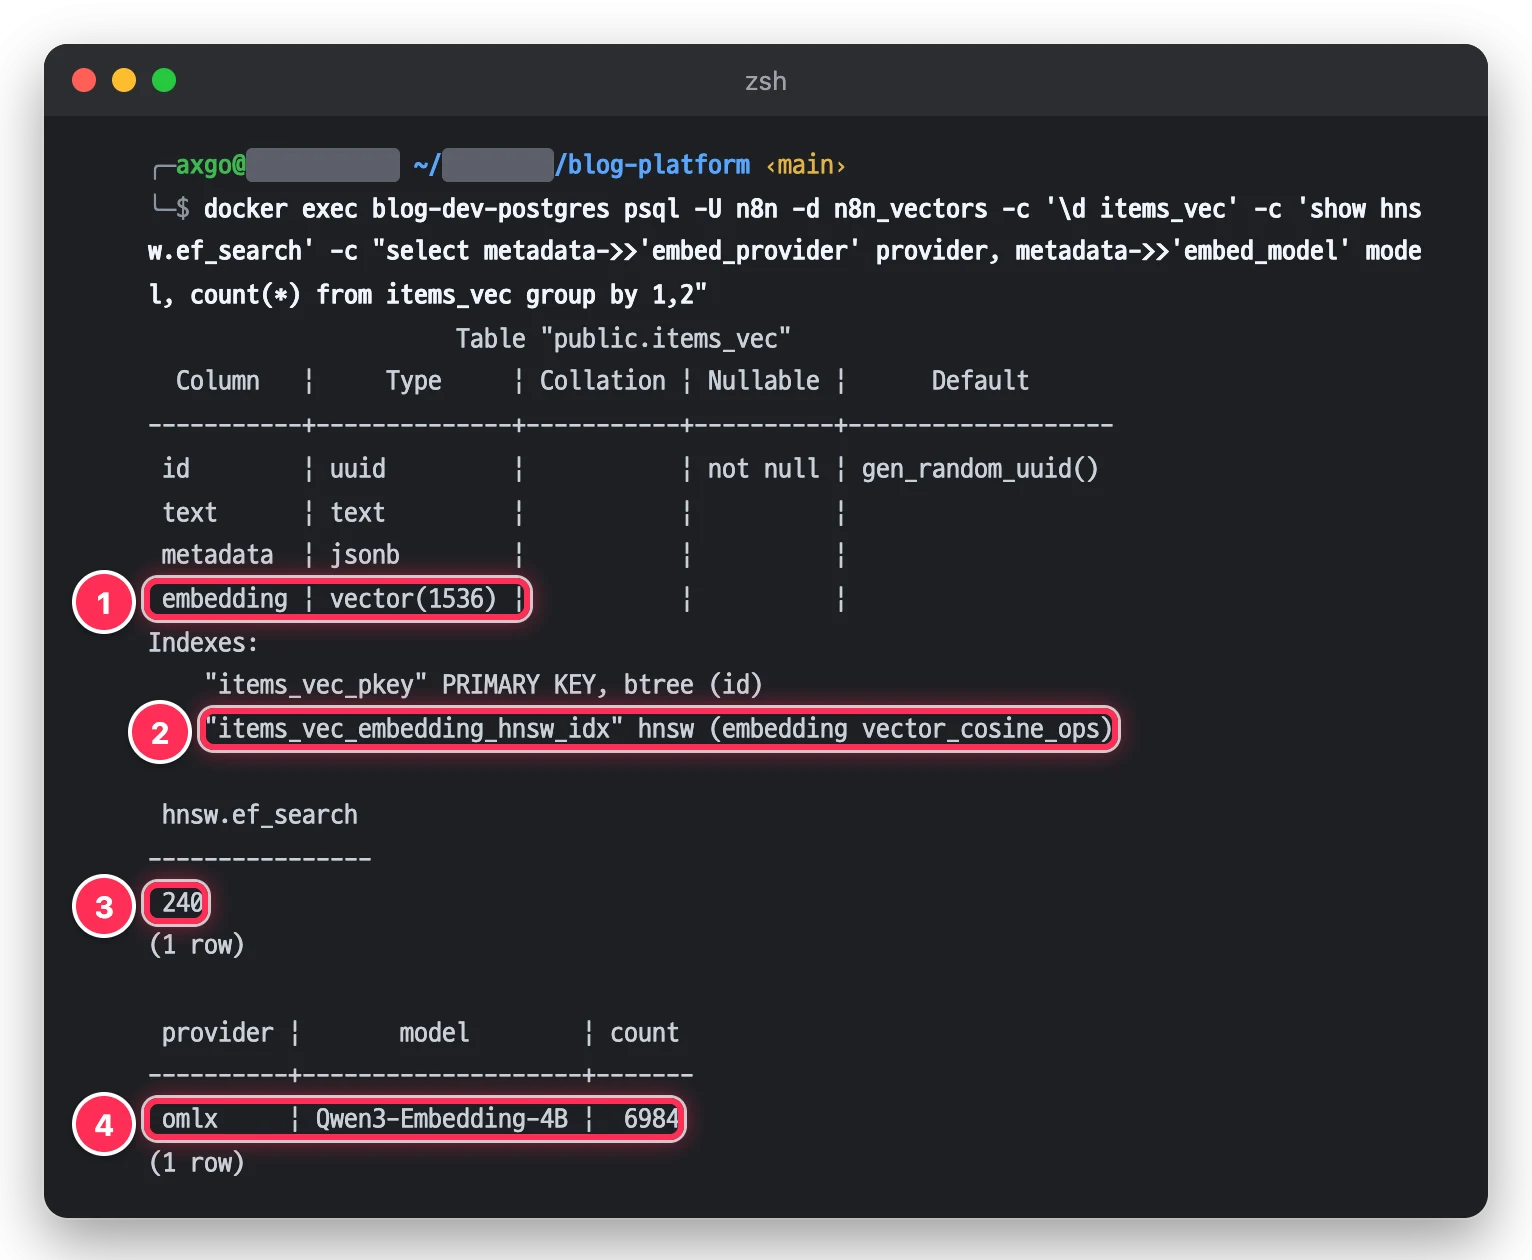
① vector(1536) 열
② HNSW 코사인 인덱스
③ DB 기본값으로 설정한 ef_search 240
④ 벡터마다 남긴 제공자·모델(dev는 지금 전부 Mac oMLX).
pgvector 문서에도 두 숫자가 그대로 적혀 있다. HNSW로 색인할 수 있는 차원은 vector가 2,000, halfvec이 4,000까지이고 ef_search 기본값은 40이다. 이 2,000이라는 제약 때문에 벡터 디멘전을 1536차원으로 사용중이다.
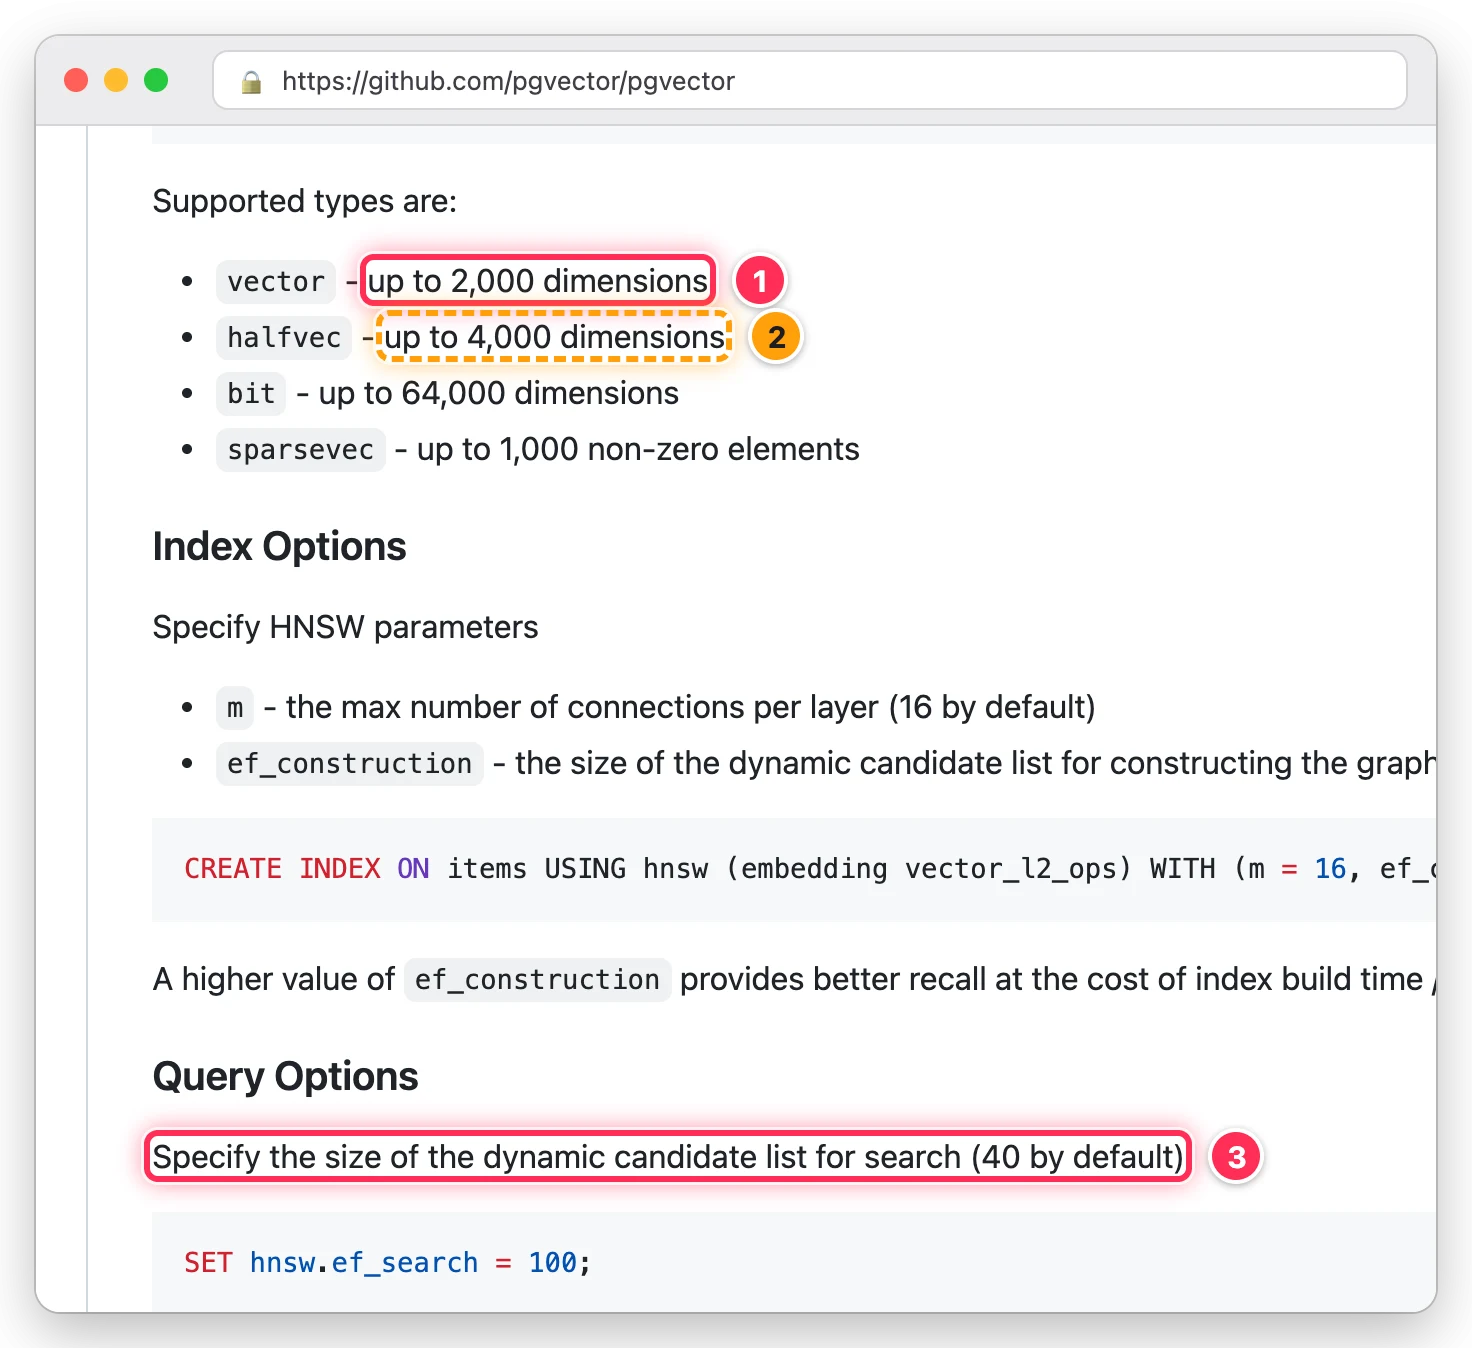
① vector는 2,000차원까지 색인된다
② halfvec은 4,000차원까지
③ 검색 후보 수 ef_search 기본값은 40이다.
벡터 생성에 Qwen3-Embedding-4B을 사용하는 이유
임베딩 모델에 요구되는 조건은 셋이다. 한국어와 영어 기사를 함께 다룰수 있을 것, 유료 API를 되도록 안 쓰도록 Mac에서 돌수 있을 것, Mac에서 도는 글쓰기 LLM·그림 모델과 함께 운영하기에 부담이 적을 것. 사용중인 Mac은 M4 Max 128 GB이지만 글쓰기·판정용 LLM 두 개만으로도 100 GB 가까이 쓰고 있기 때문이다.
공개되어 있는 Qwen3-Embedding은 100개가 넘는 언어를 지원한다. Hugging Face 모델 카드의 다국어 MTEB(MMTEB) 평균 점수는 0.6B=64.33, 4B=69.45, 8B=70.58이다. 같은 표에서 multilingual-e5-large-instruct가 63.22, BGE-M3가 59.56이니 크기에 비해 점수가 매우 좋은 편에 속한다.
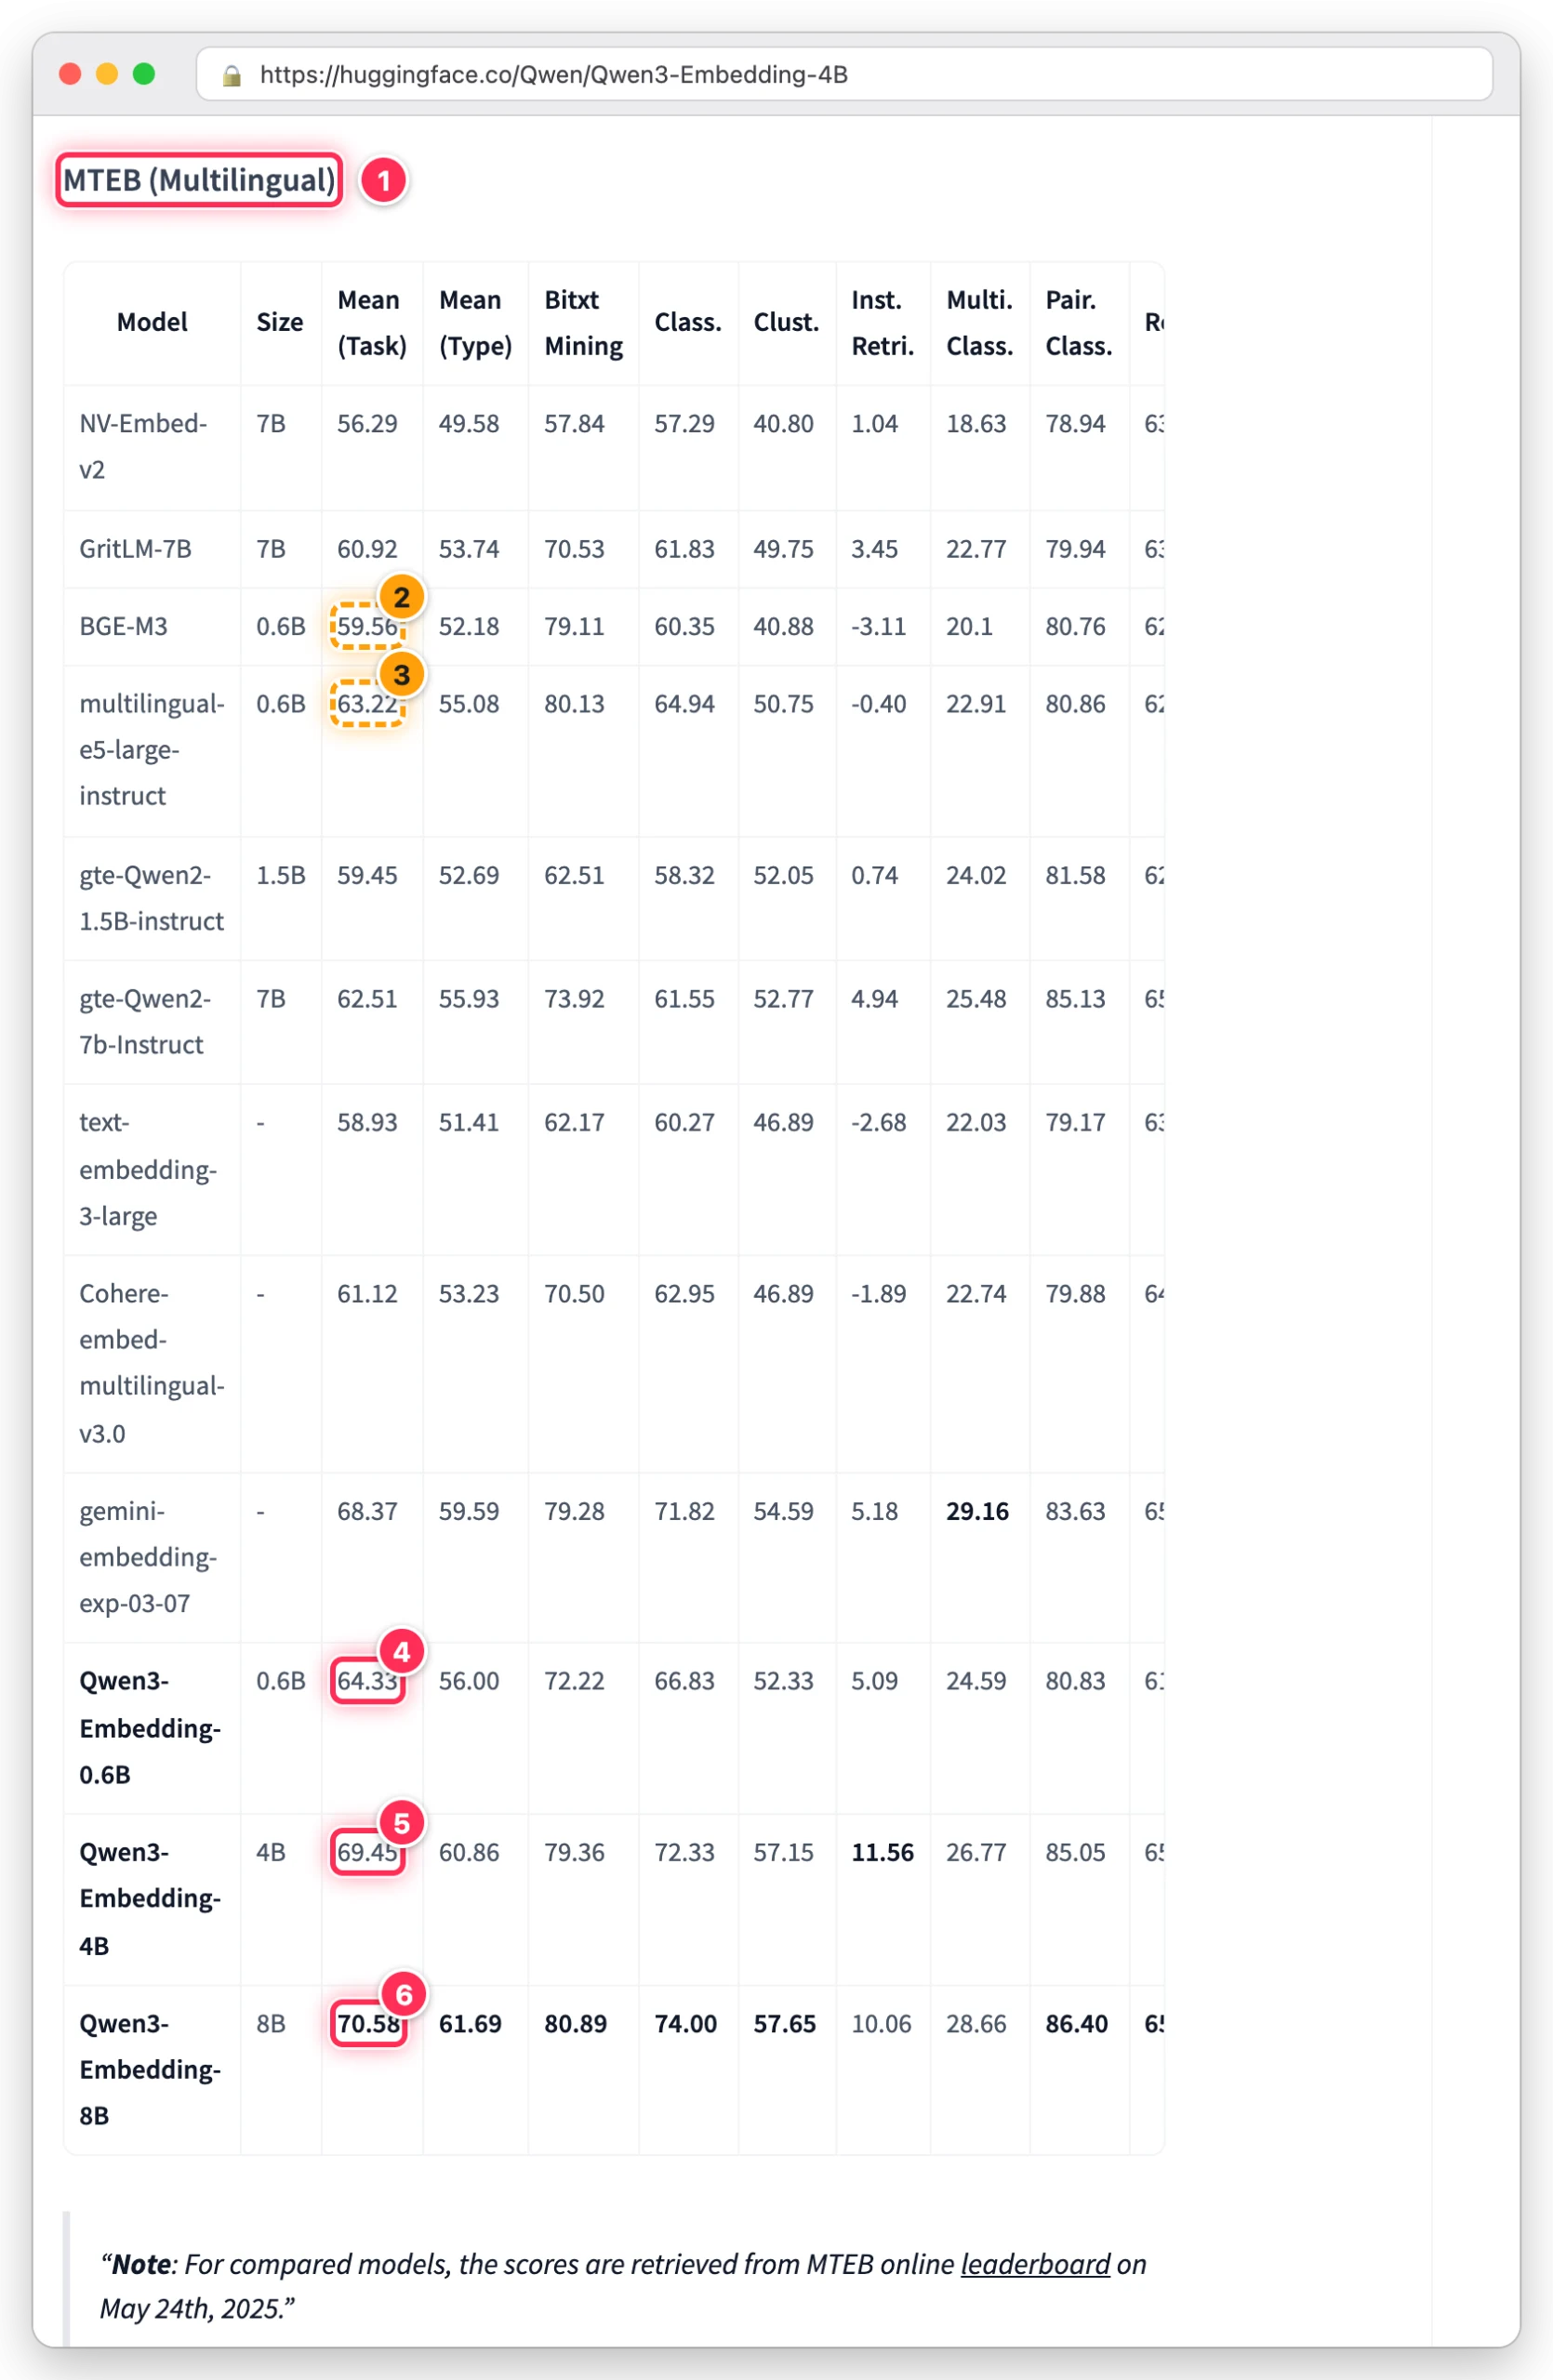
② BGE-M3 59.56
③ multilingual-e5-large-instruct 63.22
④ Qwen3 0.6B 64.33
⑤ Qwen3 4B 69.45
⑥ Qwen3 8B 70.58.
처음에는 8B를 사용하려고 했다. 그런데 8B의 원래 차원은 4096이라 pgvector 인덱스 한도보다 큰 값이고 인덱스 없이 검색을 한다면 Full Seach를 해야만한다. 때문에 차원을 낮추기로 하면서 임베딩 모델에서도 4B를 이용하는 것으로 계획을 변경했다. 8B와 4B의 점수 차는 1.1점인데 크기는 두 배다. 하루 1,500건 남짓한 기사 제목과 요약을 비교하는 일에 8B까지 쓸 규모는 아니라고 봤다. 당시는 테이블이 아직 비어 있을 때라 다시 임베딩할 것도 없었다.
나중에 덤으로 얻은 것도 있다. OpenRouter가 같은 4B를 100만 토큰당 $0.02에 판다. Mac이 꺼졌을 때 같은 모델로 넘길 곳이 있다는 뜻인데 임베딩 모델의 이중화 작업은 뒤에서 다시 다루도록 하겠다.
2560차원 모델을 1536차원으로 쓰는 이유
Qwen3-Embedding-4B는 2560차원 벡터를 지원한다. 앞에서 본 pgvector 한도 때문에 이 중 앞 1536개만 잘라서 사용한다. vector 타입은 2,000차원까지만 HNSW 인덱스를 만들 수 있어서 2560을 그대로 넣으면 검색할 때마다 테이블 전체를 검색해야 한다. 1536은 한도 안이라 인덱스를 붙일 수 있고 벡터 한 행도 10,240바이트에서 6,144바이트로 줄어든다. halfvec(2560)으로 원래 차원을 지키면서 인덱스를 붙이는 방법도 있었지만(halfvec은 4,000까지 된다) 8B 시절에 정한 vector(1536) 사용 계획을 그대로 유지했다.
2,000 아래라면 어떤 차원이든 인덱스는 붙는다. 그중 1536을 고른 건 주류 임베딩 모델들이 공통으로 쓰는 크기이기 때문이다. OpenAI의 text-embedding-3-small과 Cohere의 embed-v4.0, Mistral의 codestral-embed는 1536이 기본값이고 Google의 gemini-embedding-001과 Alibaba의 text-embedding-v4도 1536을 공식 선택지로 준다. Qwen3-Embedding도 4B와 8B는 MRL로 1536을 낼 수 있다. 그래서 테이블을 vector(1536)으로 만들어 두면 나중에 임베딩 모델을 바꾸더라도 테이블과 인덱스, 워크플로우의 1536 자르기 코드는 그대로 쓸 수 있다. 모델이 바뀌면 벡터 공간도 달라지니 저장된 벡터만 새 모델로 다시 만들면 된다. 거꾸로 말하면 1536은 앞으로 쓸 임베딩 모델이 최소한 내줘야 하는 크기다. 최대 1024차원까지만 내는 모델(Qwen3-Embedding-0.6B, jina-embeddings-v3 등)로 바꾸려면 그때는 테이블부터 다시 만들어야 한다.
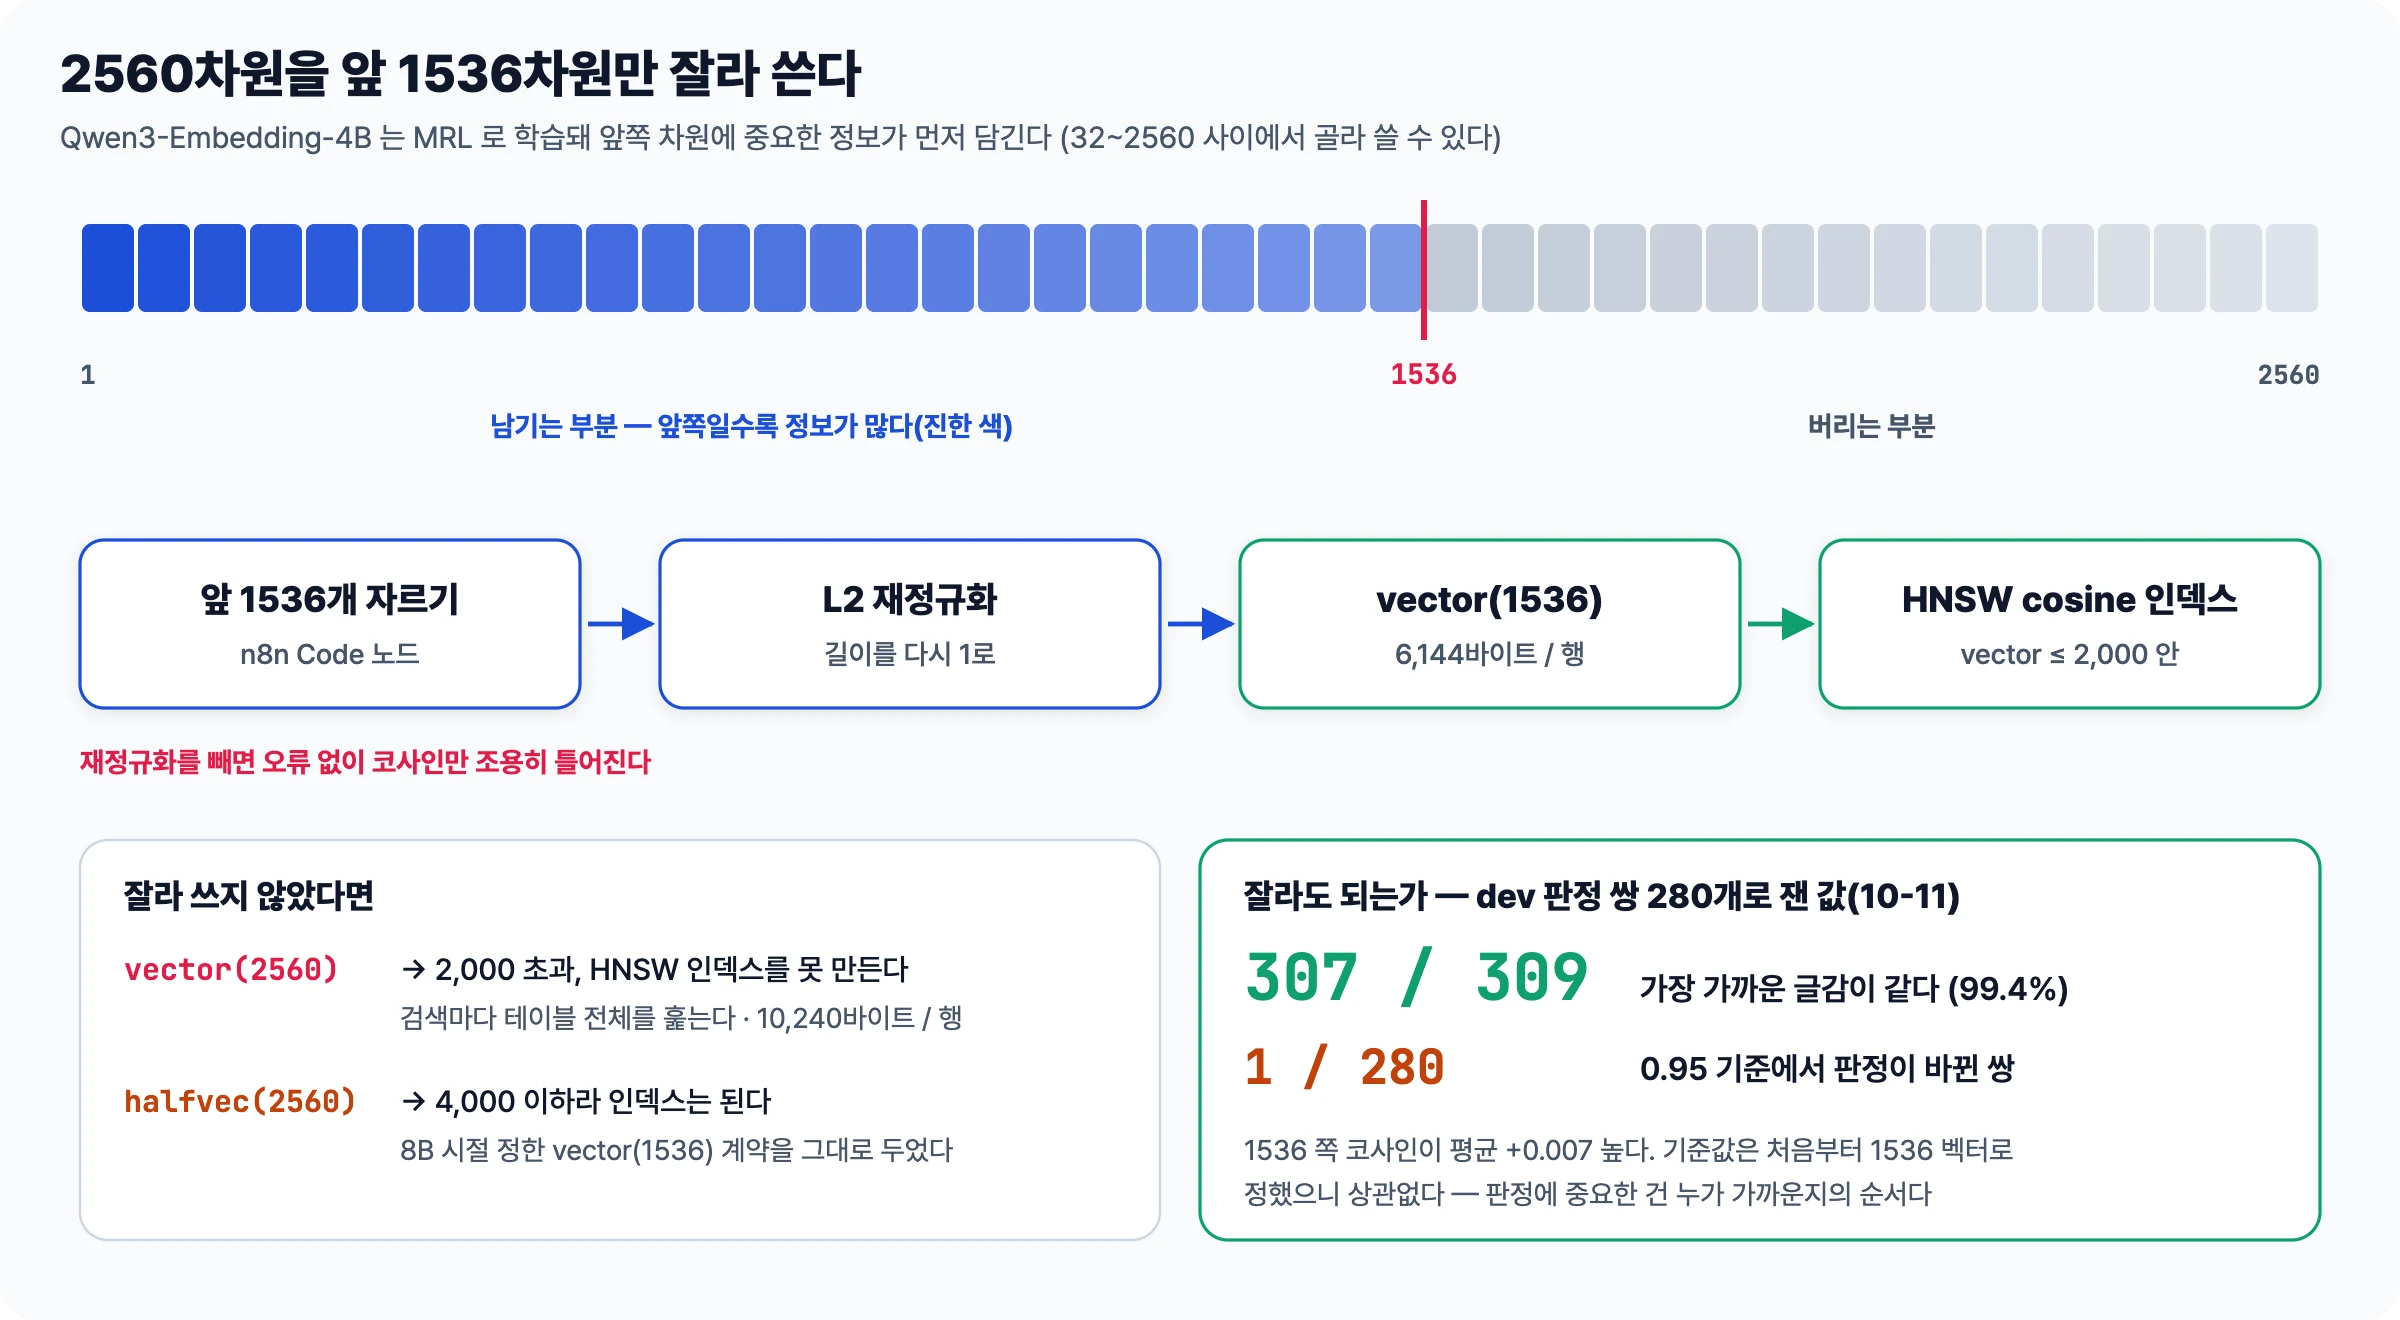
잘라 써도 되는 건 이 모델이 MRL(Matryoshka Representation Learning)로 학습됐기 때문이다. 마트료시카 러시아 인형처럼 앞쪽 차원에 중요한 정보가 먼저 담기도록 학습해서 앞부분만 잘라도 그 자체로 쓸 만한 벡터가 된다. 모델 카드에도 32~2560 사이에서 출력 차원을 골라 쓸 수 있다고 적혀 있다. 대신 자른 뒤에는 꼭 길이를 1로 다시 맞춰야(L2 정규화) 코사인이 맞는다. 이걸 빼면 오류는 안 나는데 유사도만 틀어진다. n8n의 Code 노드가 앞 1536개를 자르고 다시 정규화한다.
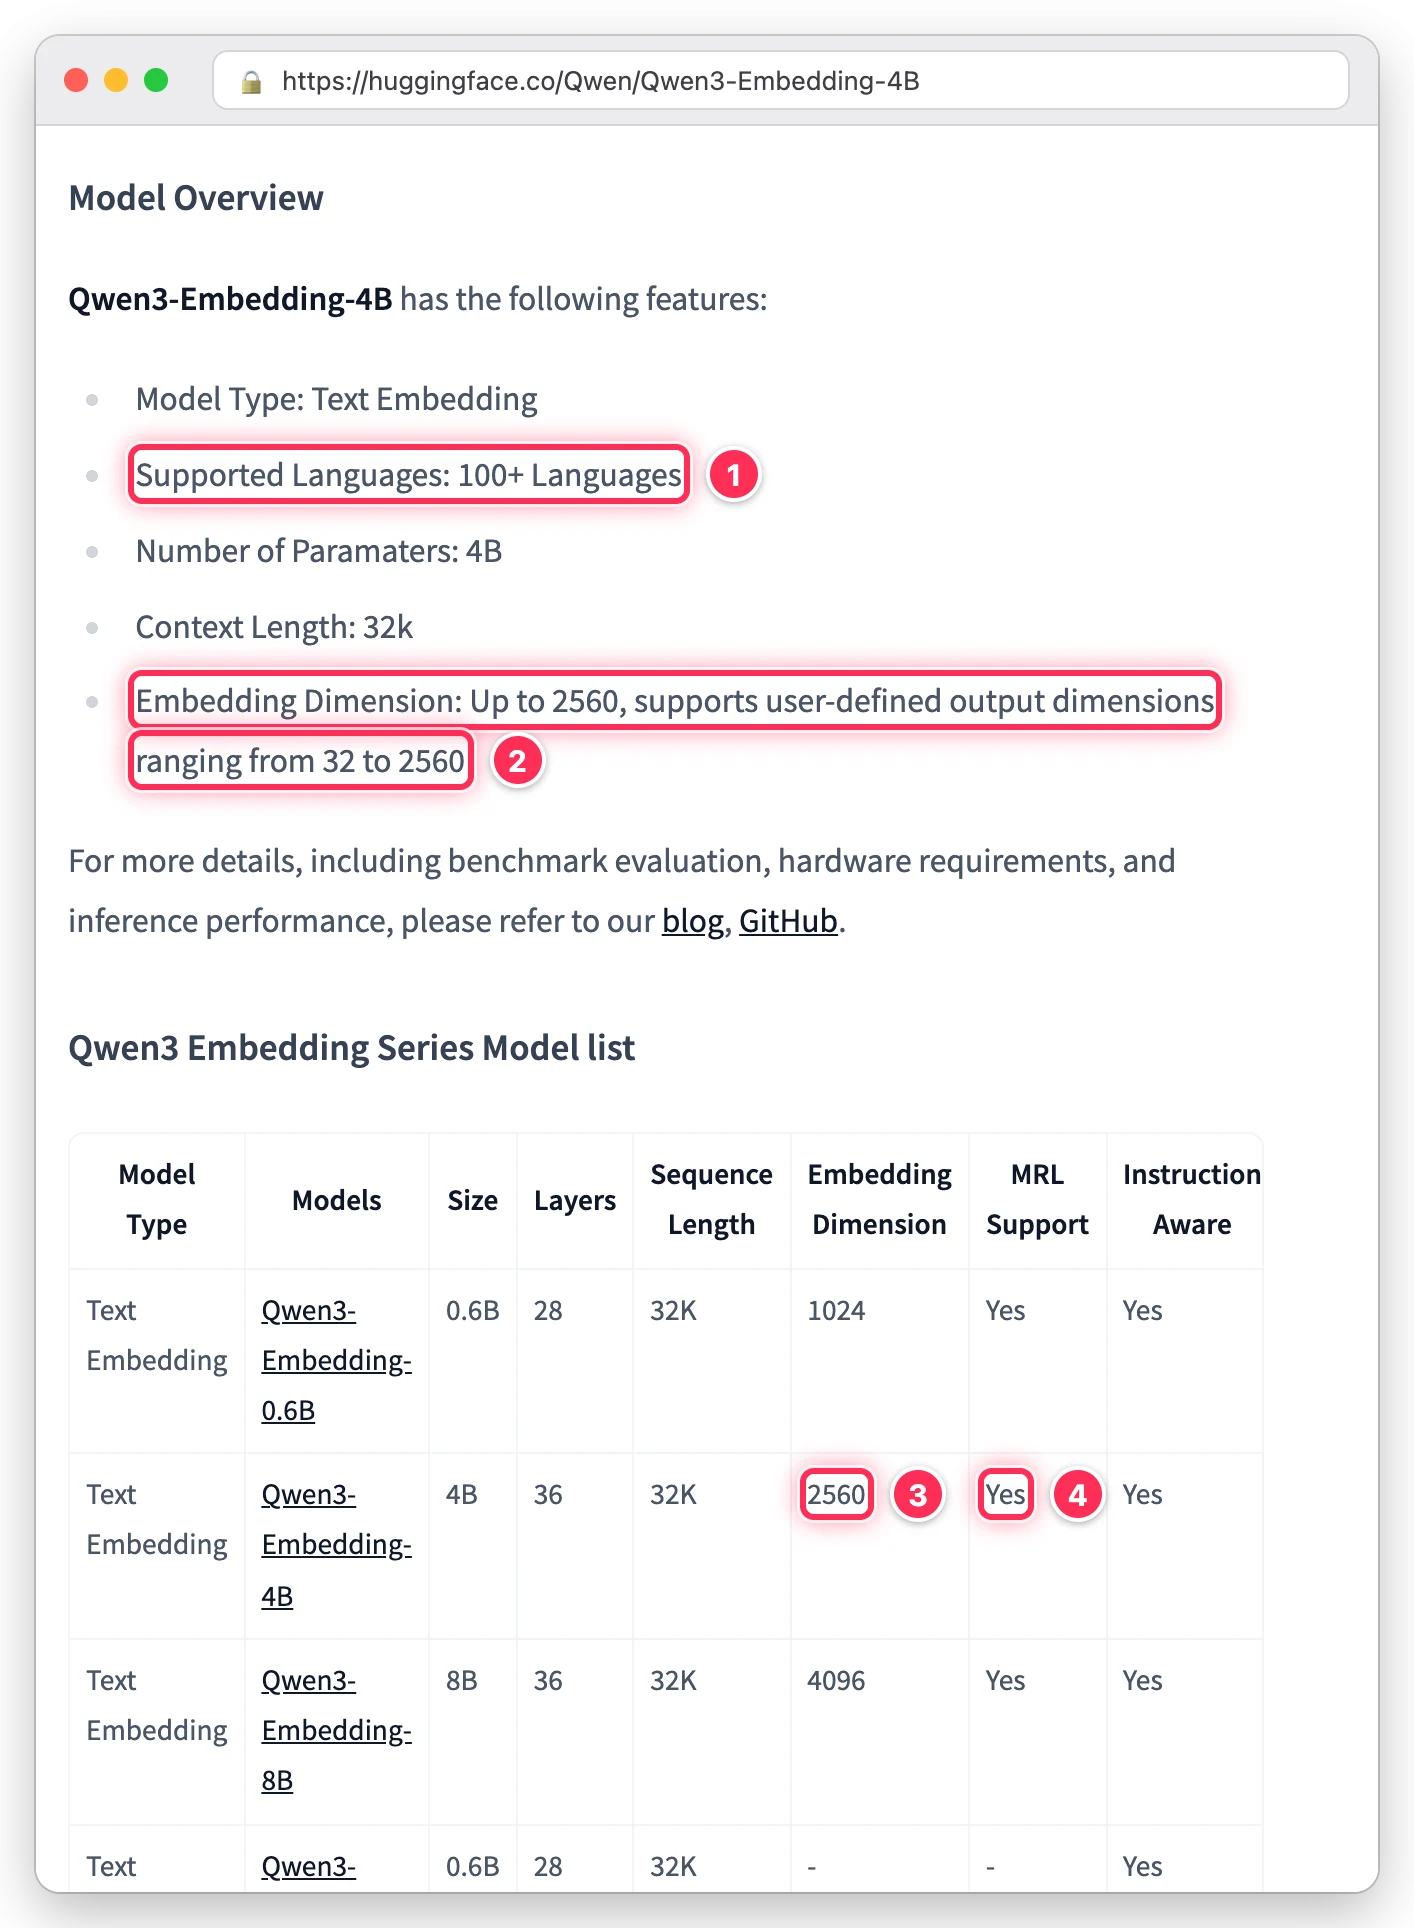
① 100개 넘는 언어 지원
② 출력 차원을 32~2560 사이에서 고를 수 있다
③ 4B의 원래 차원 2560
④ MRL 지원.
말로만 괜찮다고 하기는 찜찜해서 이번 글을 쓰면서 dev 데이터로 직접 재 봤다. 페어링된 280개 뉴스와 공시를 같은 모델로 2560차원과 1536차원 두 번 비교했다. 집계 워크플로우가 같은 토픽으로 묶은 쌍과 중복으로 표시된 쌍, 그러니까 중복이냐 아니냐가 기준값 언저리에서 정해지는 쌍이다.
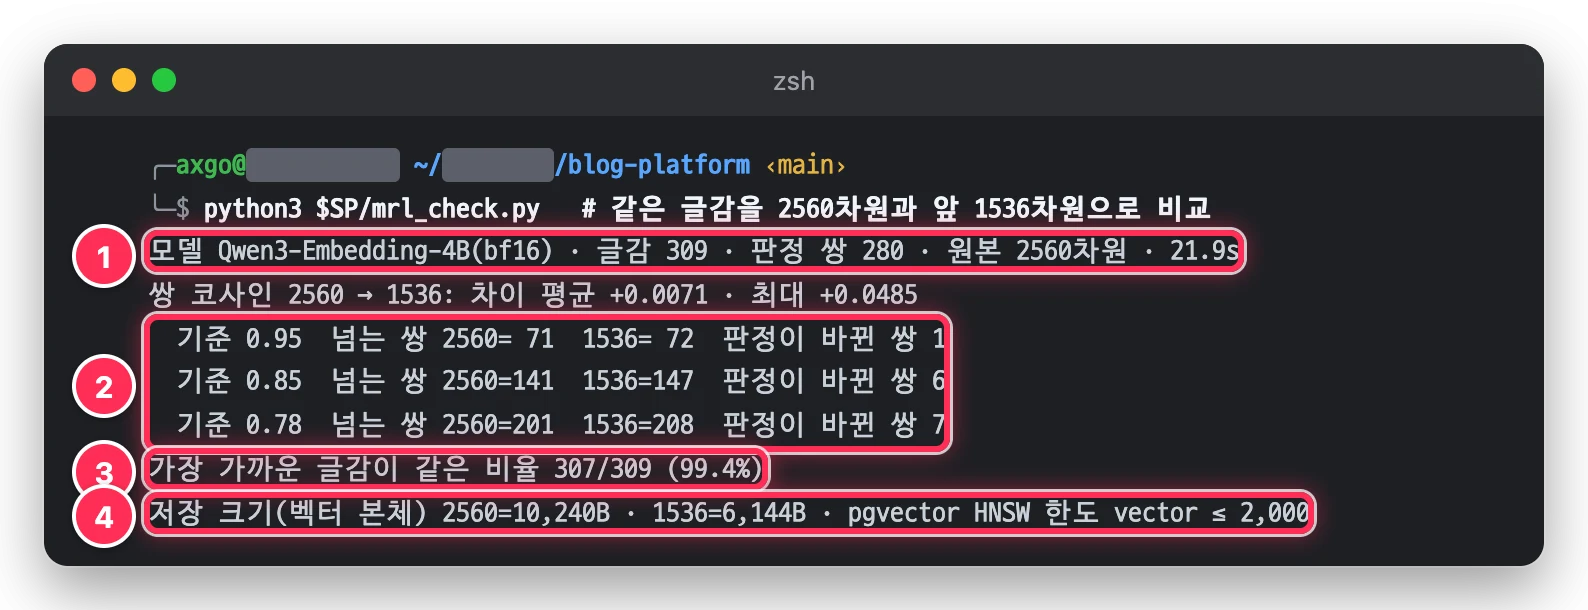
① 글감 309건·판정 쌍 280개
② 기준값(0.95·0.85·0.78)별로 판정이 바뀐 쌍
③ 가장 가까운 글감이 같은 비율
④ 행당 벡터 크기.
글감마다 가장 가까운 글감은 309건 중 307건이 같았다. 1536 쪽 코사인이 평균 0.007 높게 나와 0.95 기준으로 1 쌍이 추가로 발생한다. 하지만 기준값 자체를 처음부터 1536차원 벡터를 보고 정했으니 문제될 일은 아니다. 판정에는 누가 누구와 가까운지 순서가 중요한데 그 순서에는 변화가 없었다.
4비트로 시작해서 bf16 원본으로
처음에는 mlx-community/Qwen3-Embedding-4B-4bit-DWQ를 사용하고 있었다. 2.1 GB로 작고 빠른 MLX로 변환된 모델이다. 9월 19일부터 열흘 남짓 이 모델로 수집 기사를 임베딩했다.
문제는 Mac이 꺼졌을 때 OpenRouter로 임베딩을 하는 이중화를 구성에서 발생했다. Qwen3-Embedding-4B 이면 얼추 비슷할 줄 알았던 것이다. 폴백으로 Openrouter에서 만든 벡터도 Mac에서 만든 벡터와 같은 테이블에 들어 가게 된다. 한 기사는 Mac이, 다른 기사는 OpenRouter에서 만든 벡터를 만들게 되고 서로 비교하게 된다면? 모델 이름이 같아도 양 쪽이 같은 벡터를 출력하지 않는다면 중복 판정은 틀어질수 밖에 없다.
먼저 기사 26건을 양쪽에 보내 같은 글끼리의 코사인을 봤다. OpenRouter는 같은 요청을 두 번 보내면 1.00000이 나와 기준으로 삼기 좋았다.
| 로컬 모델 | 같은 글 Mac↔OpenRouter 최소 코사인 |
|---|---|
| 4bit-DWQ (쓰던 모델) | 0.95829 |
| mlx-community mxfp8 | 0.97651 |
| Qwen/Qwen3-Embedding-4B 원본 bf16 | 0.99970 |
4비트 모델은 같은 글인데도 0.958까지 벌어졌다. 거의 같은 두 기사가 Mac끼리는 0.997인데 한쪽을 OpenRouter로 만들면 0.966으로 떨어졌다. 중복 기준 0.95에 가까운 값이다.
다음 측정에서는 하마터면 틀린 결론을 낼 뻔했다. 무작위 기사 200건(19,900개 쌍)으로 0.95 판정이 몇 쌍이나 달라지는지 쟀더니 모든 모델이 0쌍이었다. 문제없어 보인다. 그런데 무작위 쌍 중에는 0.95를 넘는 쌍이 하나도 없었다. 기준값 가까이에 쌍이 없으니 판정이 달라질 일도 없었던 거다. 중복 여부가 정해지는 곳은 0.95 부근이니, 측정도 그 근처의 쌍으로 해야 한다.
그래서 0.95 가까이에 모인 쌍으로 다시 쟀다. 임베딩 워크플로우가 실제로 중복으로 표시한 쌍과 집계 워크플로우가 같은 토픽으로 묶은 쌍(기사 336건, 판정 쌍 265개, 그중 0.95 이상 59쌍)이다. 8비트로 양자화한 모델 두 개(majentik·sgrankin)도 받아 같이 돌려 봤다. 아래 표의 “섞임”은 한 기사는 Mac, 다른 기사는 OpenRouter로 만든 경우다.
| 로컬 모델 | 크기 | 같은 글 최소 코사인 | 섞였을 때 판정이 달라진 쌍 (0.95 / 0.85 / 0.78) |
|---|---|---|---|
| Qwen/Qwen3-Embedding-4B 원본 bf16 | 7.5 GB | 0.99948 | 0 / 0 / 1 |
| majentik MLX-8bit | 4.0 GB | 0.99944 | 4 / 0 / 0 |
| sgrankin oQ8-fp16 | 4.0 GB | 0.99944 | 4 / 0 / 0 |
| mlx-community 4bit-DWQ | 2.1 GB | 0.90060 | 54 / 23 / 20 |
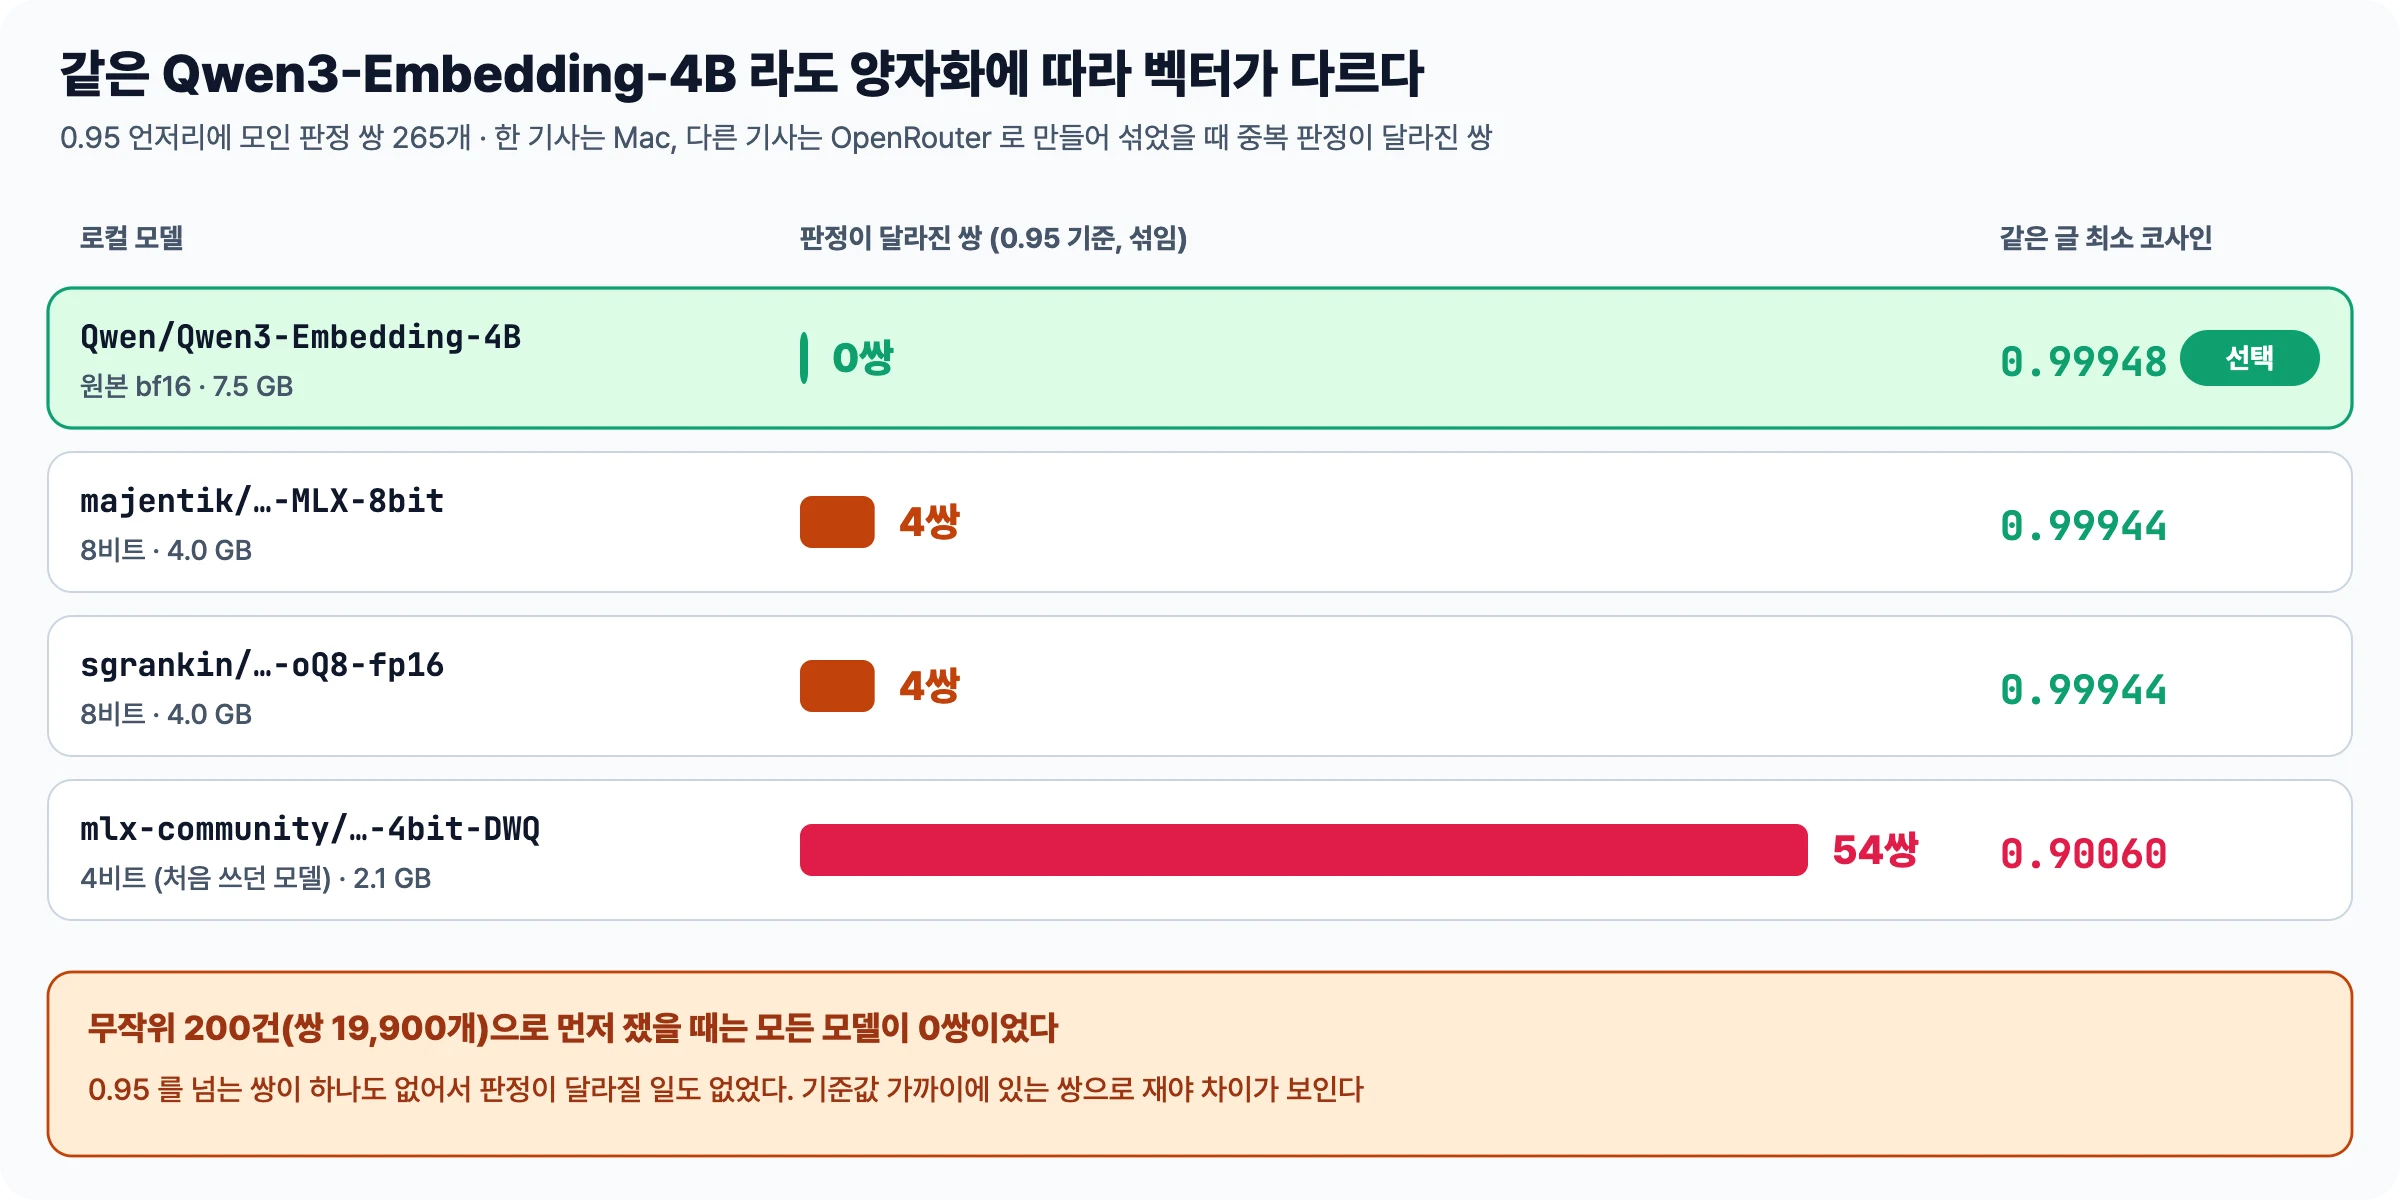
4비트는 섞였을 때 0.95 기준에서 54쌍의 판정이 달라졌다. 중복인 기사를 새 기사로, 새 기사를 중복으로 본다는 뜻이다. 8비트 모델 두 개는 4쌍, bf16 원본은 0쌍이었다. 0.78 기준의 1쌍은 경계에 걸린 쌍이다. 차이가 최대 0.0045밖에 안 돼 어느 쪽으로 재도 판정이 바뀔 수 있다. 두 8비트 모델은 양자화 설정이 같아 결과가 소수 다섯째 자리까지 같았지만 파일 구성은 조금 달랐다.
결국 Openrouter와의 폴백 이중화를 고려해 bf16 원본(Qwen/Qwen3-Embedding-4B)을 사용하는 것으로 정하게 되었다. 4비트보다 메모리를 5.4 GB 더 쓰는 대신 로컬과 이중화된 구성을 사용할때 중복 판정이 하나도 달라지지 않기 때문이다. 확실한건 Openrouter를 통해서 사용하는 임베딩 모델과 다르지 않은 제3자가 변환한 모델이 아니라 공식 저장소 파일이기 때문이기도 하다. (측정하는 동안 Draw Things가 GPU를 같은 쓰고 있어서 속도 비교에서 표에서 뺐다)
모델을 바꾸면 이미 쌓인 벡터는 옛 4비트 공간에 있으니 한 번은 다시 만들어줘야 한다. 이 작업은 GPU 대신 OpenRouter로 했다. 저장된 본문을 그대로 다시 임베딩해 한 트랜잭션으로 바꿔 끼웠고 dev 553,845토큰($0.0111), prod 564,603토큰($0.0113)이 들었다. 무작위로 30개를 골라 저장된 OpenRouter 벡터와 Mac bf16으로 새로 계산한 벡터를 비교해 보니 최소 0.99969로 일치 했다.
이 비교는 저장소에 비교스크립트로 만들어 언제든 다시 확인할 수 있도록 했다. (스크린샷은 4비트·8비트 모델을 이미 지워서 지금 쓰는 bf16만 돌렸다.)
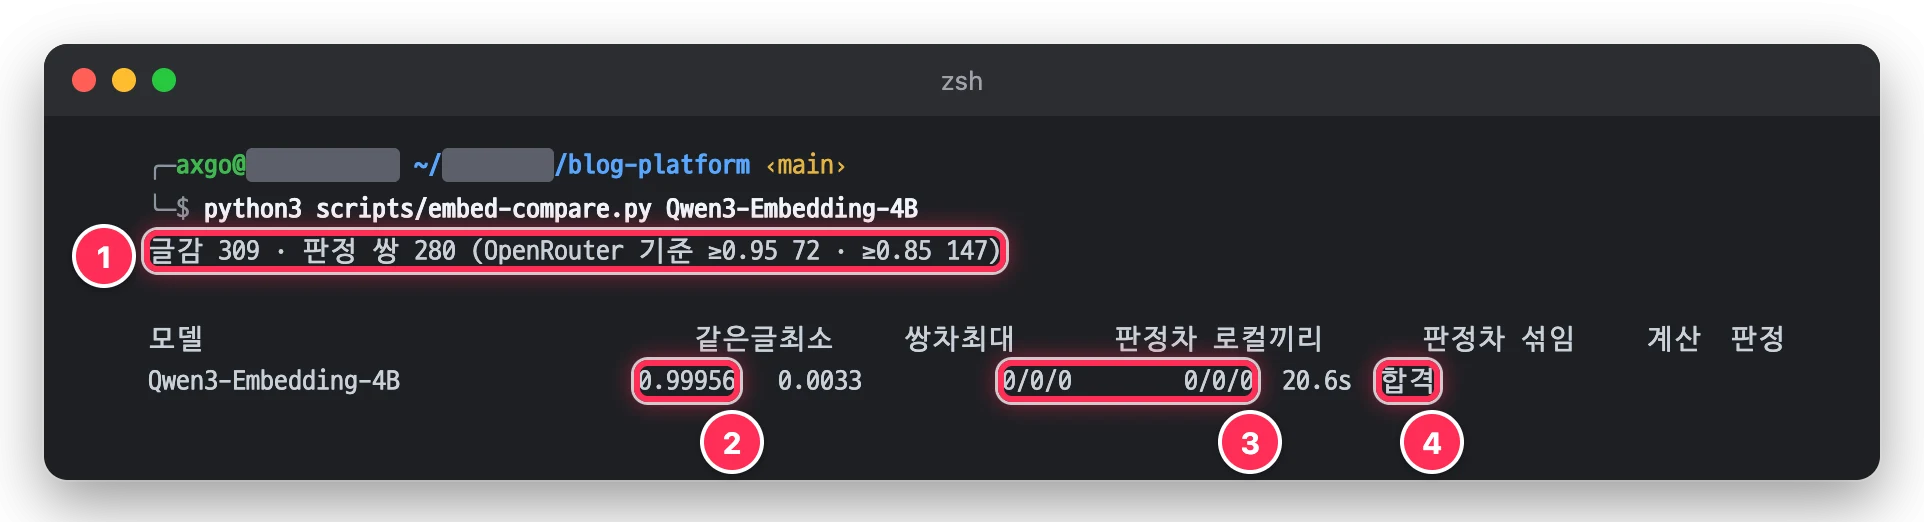
① 비교에 쓴 글감과 판정 쌍
② 같은 글 Mac↔OpenRouter 최소 코사인
③ 로컬끼리 비교해도, 섞어 비교해도 판정이 달라진 쌍은 0
④ 합격 여부
Local Mac 임베딩 작업을 OpenRouter가 대신할 수 있게 되었다
prod는 오라클 A1에 있지만 임베딩은 집에 있는 맥북의 oMLX에서 처리하고 있다. A1의 n8n은 Tailscale로 Mac에 임베딩 모델을 이용하고 있는 것이다. 노트북을 들고 나가거나 Mac이 꺼졌을때 임베딩 작업이 멈출 수 밖에 없다. 그동안 수집된 기사와 공시는 중복 판정도, 집계도 할수 없는 상태가 발생한다.
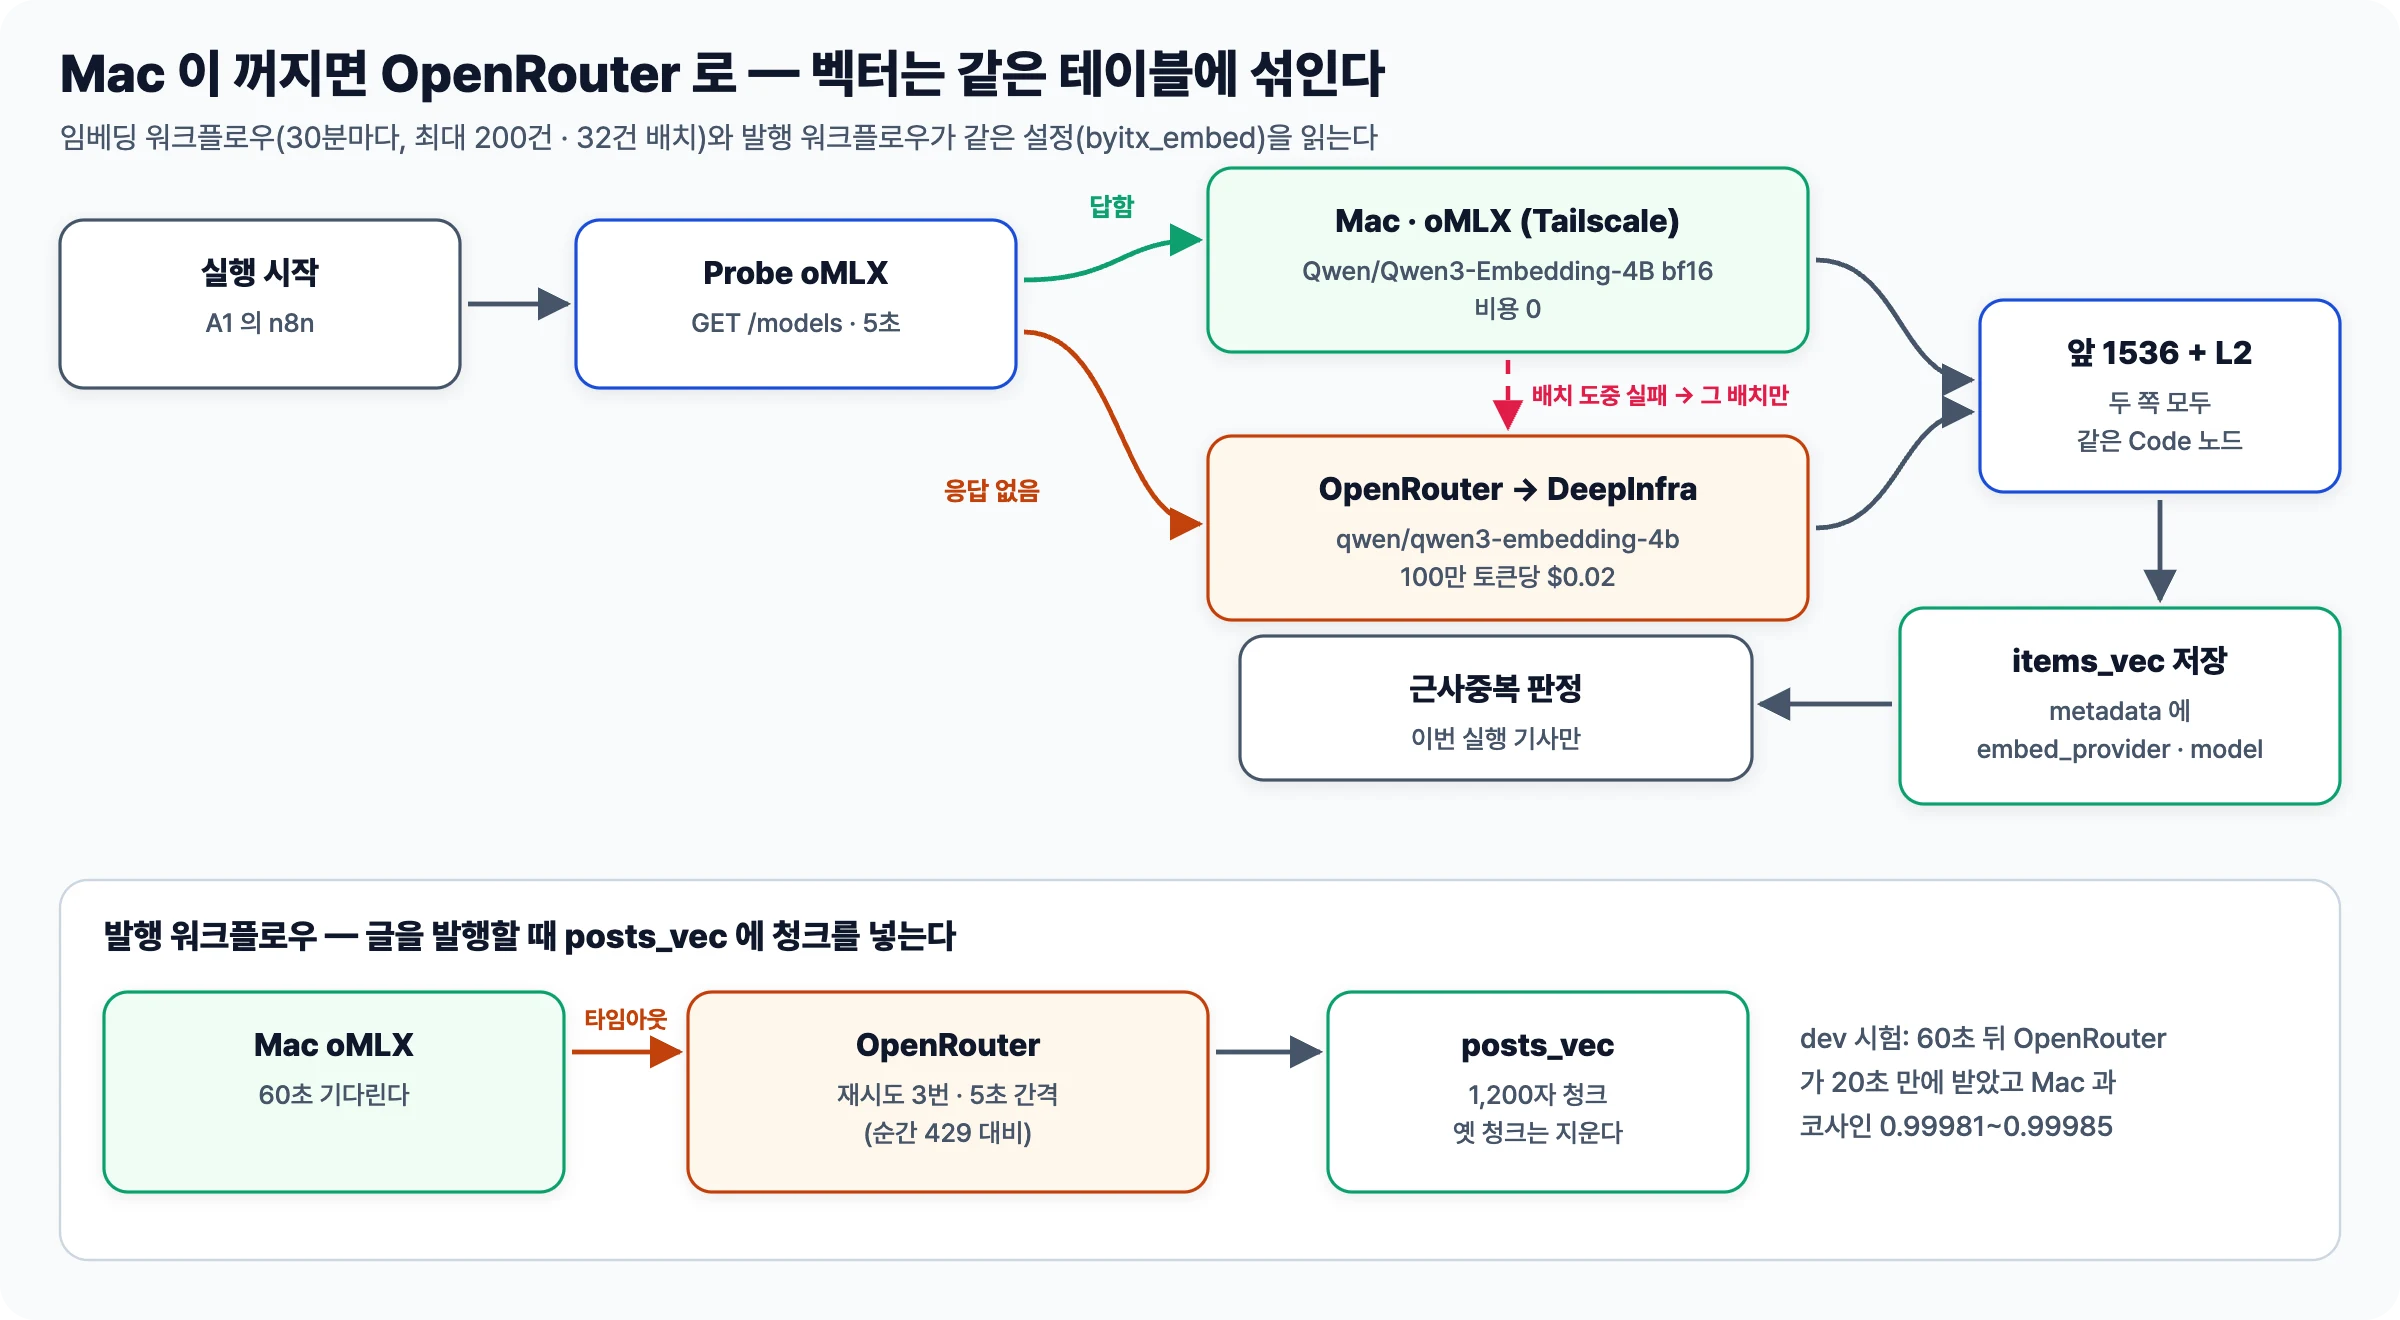
임베딩모델 워크플로우는 폴백을 위해 실행을 시작할 때 Mac에 한 번 묻도록 했다. 5초 안에 답하면 그 실행은 Mac으로, 아니면 OpenRouter로 간다. 배치마다 Mac을 기다리게 하면 Mac이 꺼져 있을 때 배치마다 타임아웃이 될 수 있기 때문이다. 실행 도중에 Mac이 실패하면 그 배치만 OpenRouter로 넘어간다. 어느 쪽이든 같은 Code 노드에서 1536으로 자르고 다시 정규화한다. 벡터 metadata에는 embed_provider·embed_model을 남기도록 했다. 나중에 두 제공자의 벡터가 얼마나 섞였는지 볼 수 있게 하려는 것이다.
n8n의 실제 임베딩 워크플로우는 이렇게 생겼다.
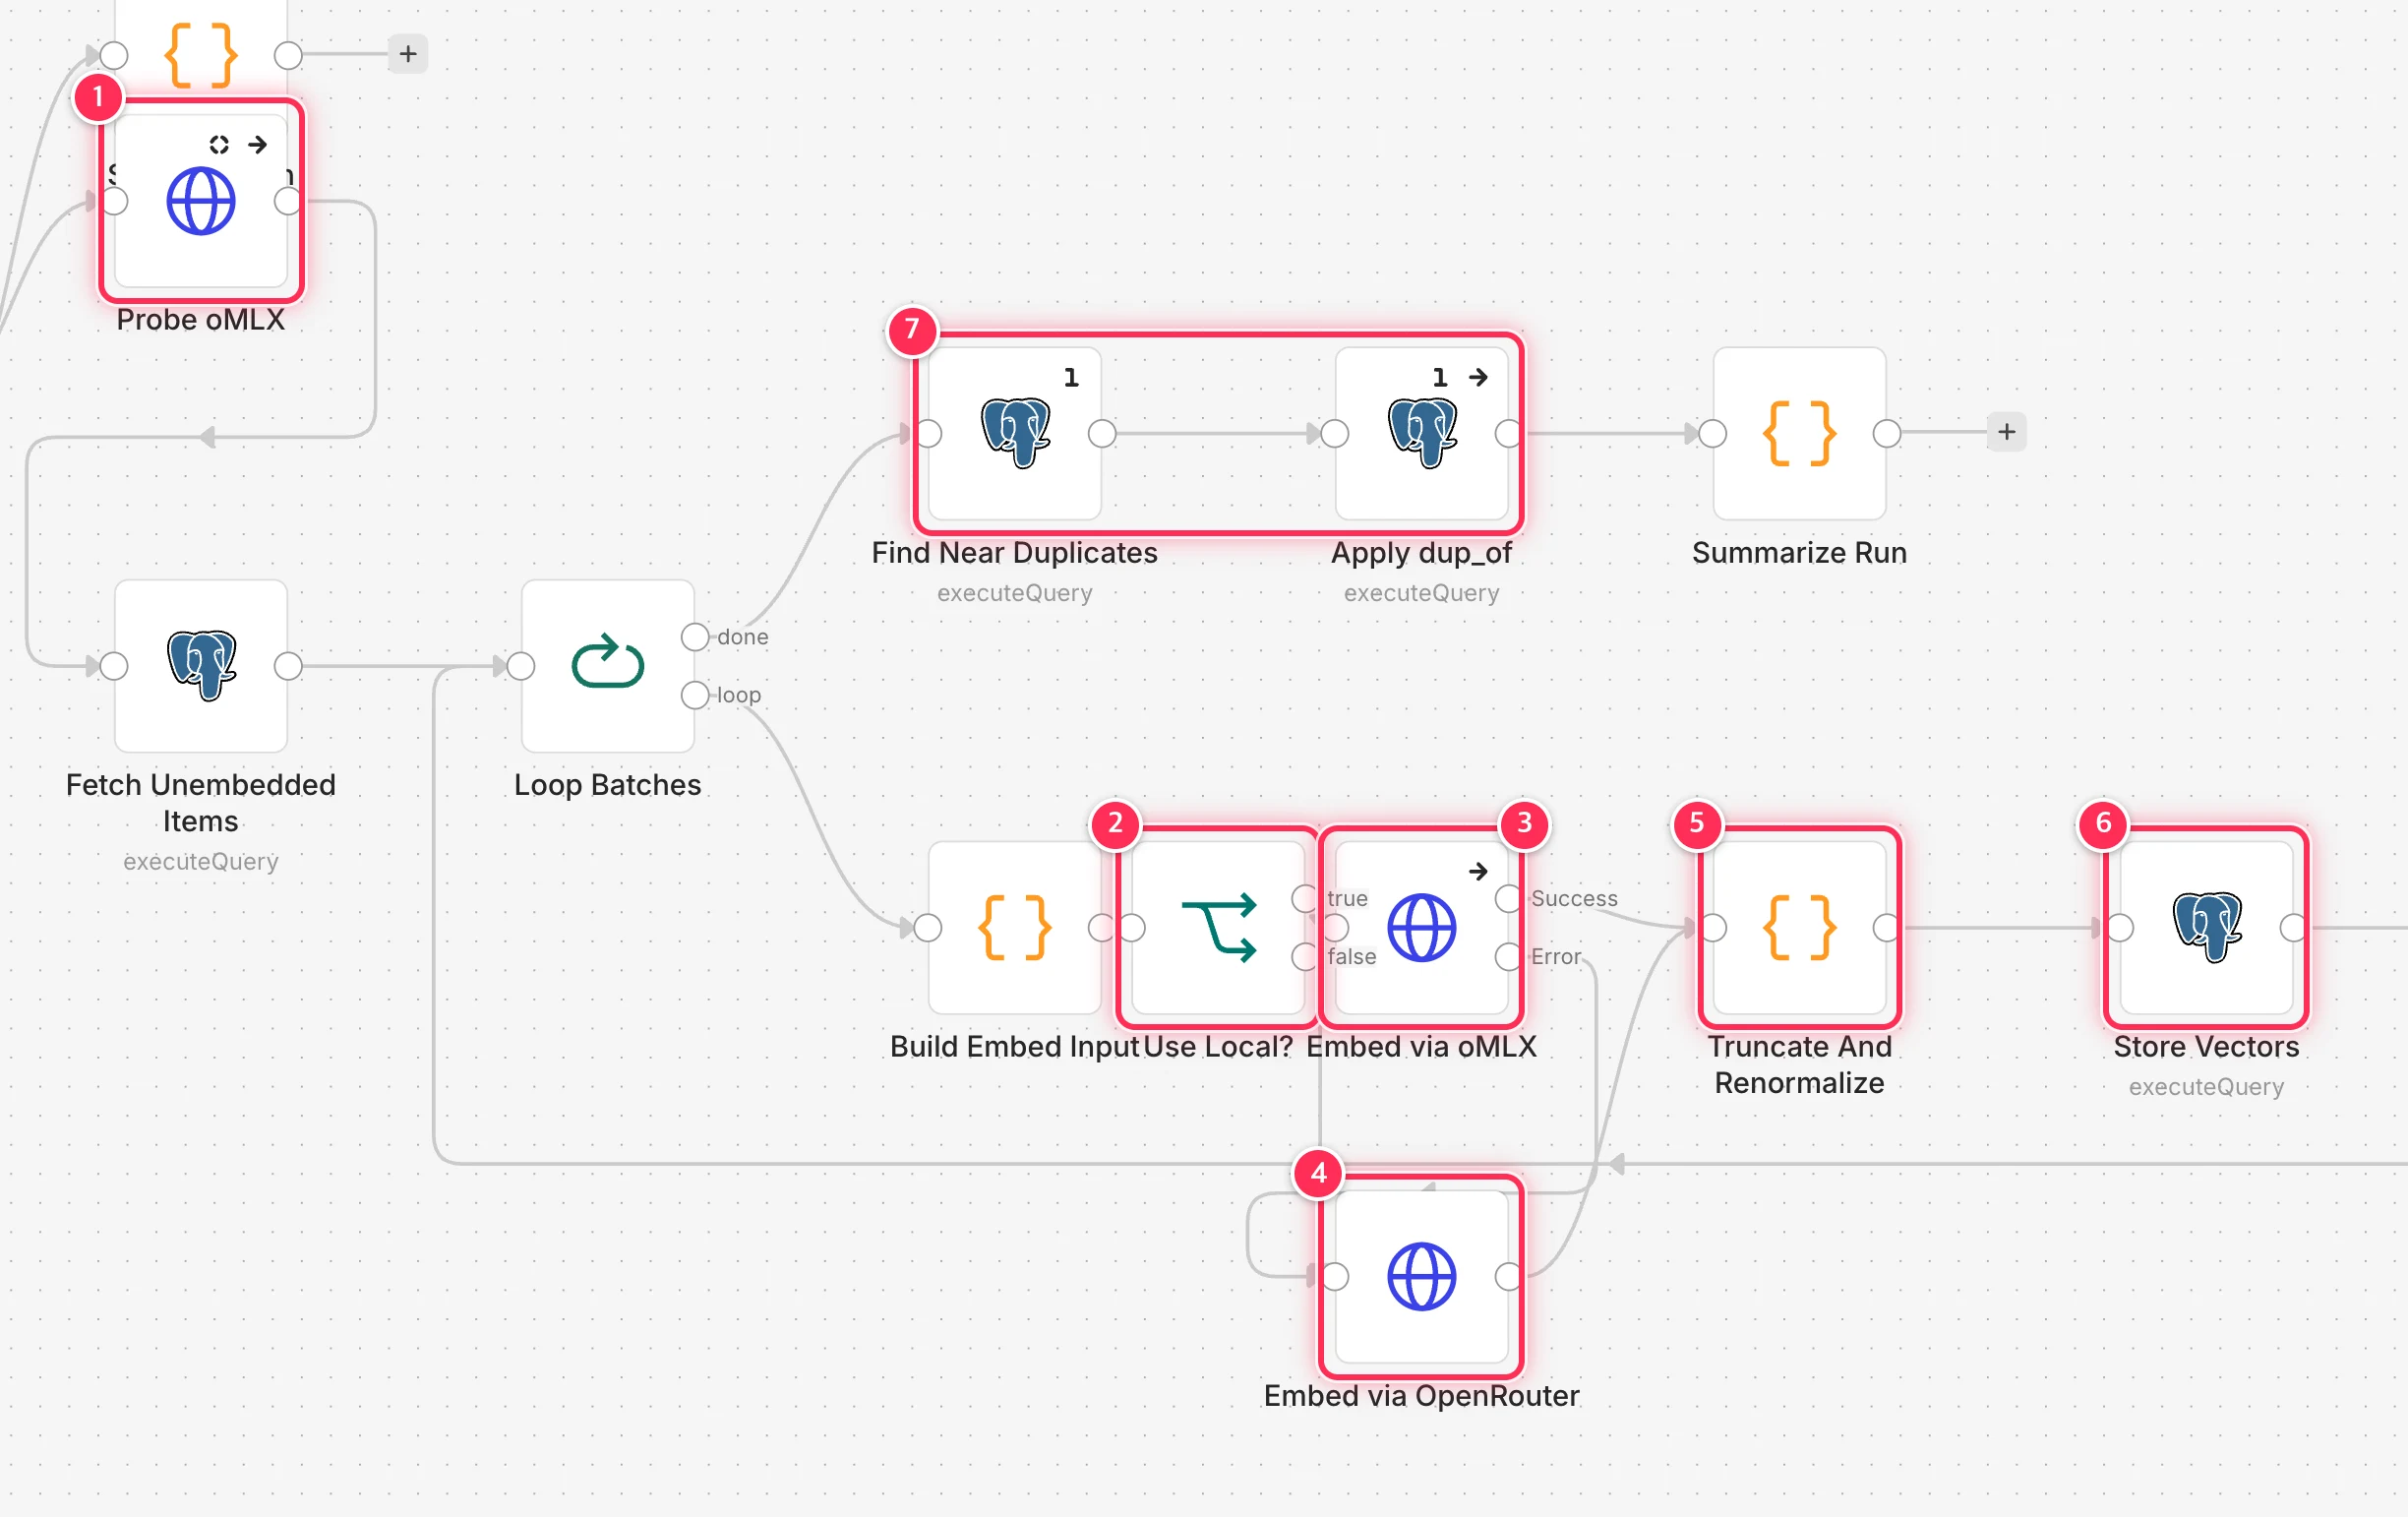
① 실행을 시작할 때 Mac(oMLX)에 묻는다
② 답했으면 Mac, 아니면 OpenRouter로 값을 남긴다
③ Mac 호출 (실패하면 오류 출력이 ④로 이어진다)
④ OpenRouter 호출
⑤ 앞 1536차원 자르기와 L2 정규화
⑥ items_vec 저장
⑦ 이번 실행에서 임베딩한 기사의 근사중복 판정과 dup_of 처리 노드
dev에서 세 가지 경우를 테스트 해봤다. oMLX 주소를 죽은 포트로 돌리면 5초 만에 40건이 OpenRouter로, 모델 이름을 일부러 틀리게 하면 그 배치만 OpenRouter로 갔다. 발행 워크플로우의 초안 글을 임베딩하는 구조도 같은 형태다. Mac을 응답 없는 주소로 돌려 두고 글을 발행했더니 60초 타임아웃 뒤 OpenRouter로 20초 만에 임베딩작업을 완료 했다. Mac bf16 벡터와는 코사인 유사도 0.99981~0.99985 였다. 처음 시험 때는 OpenRouter가 순간적으로 429를 한 번 내서 글은 발행됐는데 임베딩만 빠진 경우도 발생했다. 이후에는 OpenRouter 호출 실패시 5초 간격으로 재시도 3번을 하도록 수정 했다.
임베딩 작업이 Openrouter로 폴백되면 한 달에 얼마나 들까?
OpenRouter의 qwen/qwen3-embedding-4b는 DeepInfra 한 곳이 서비스하고 입력 100만 토큰당 $0.02다. 출력 요금은 없다.
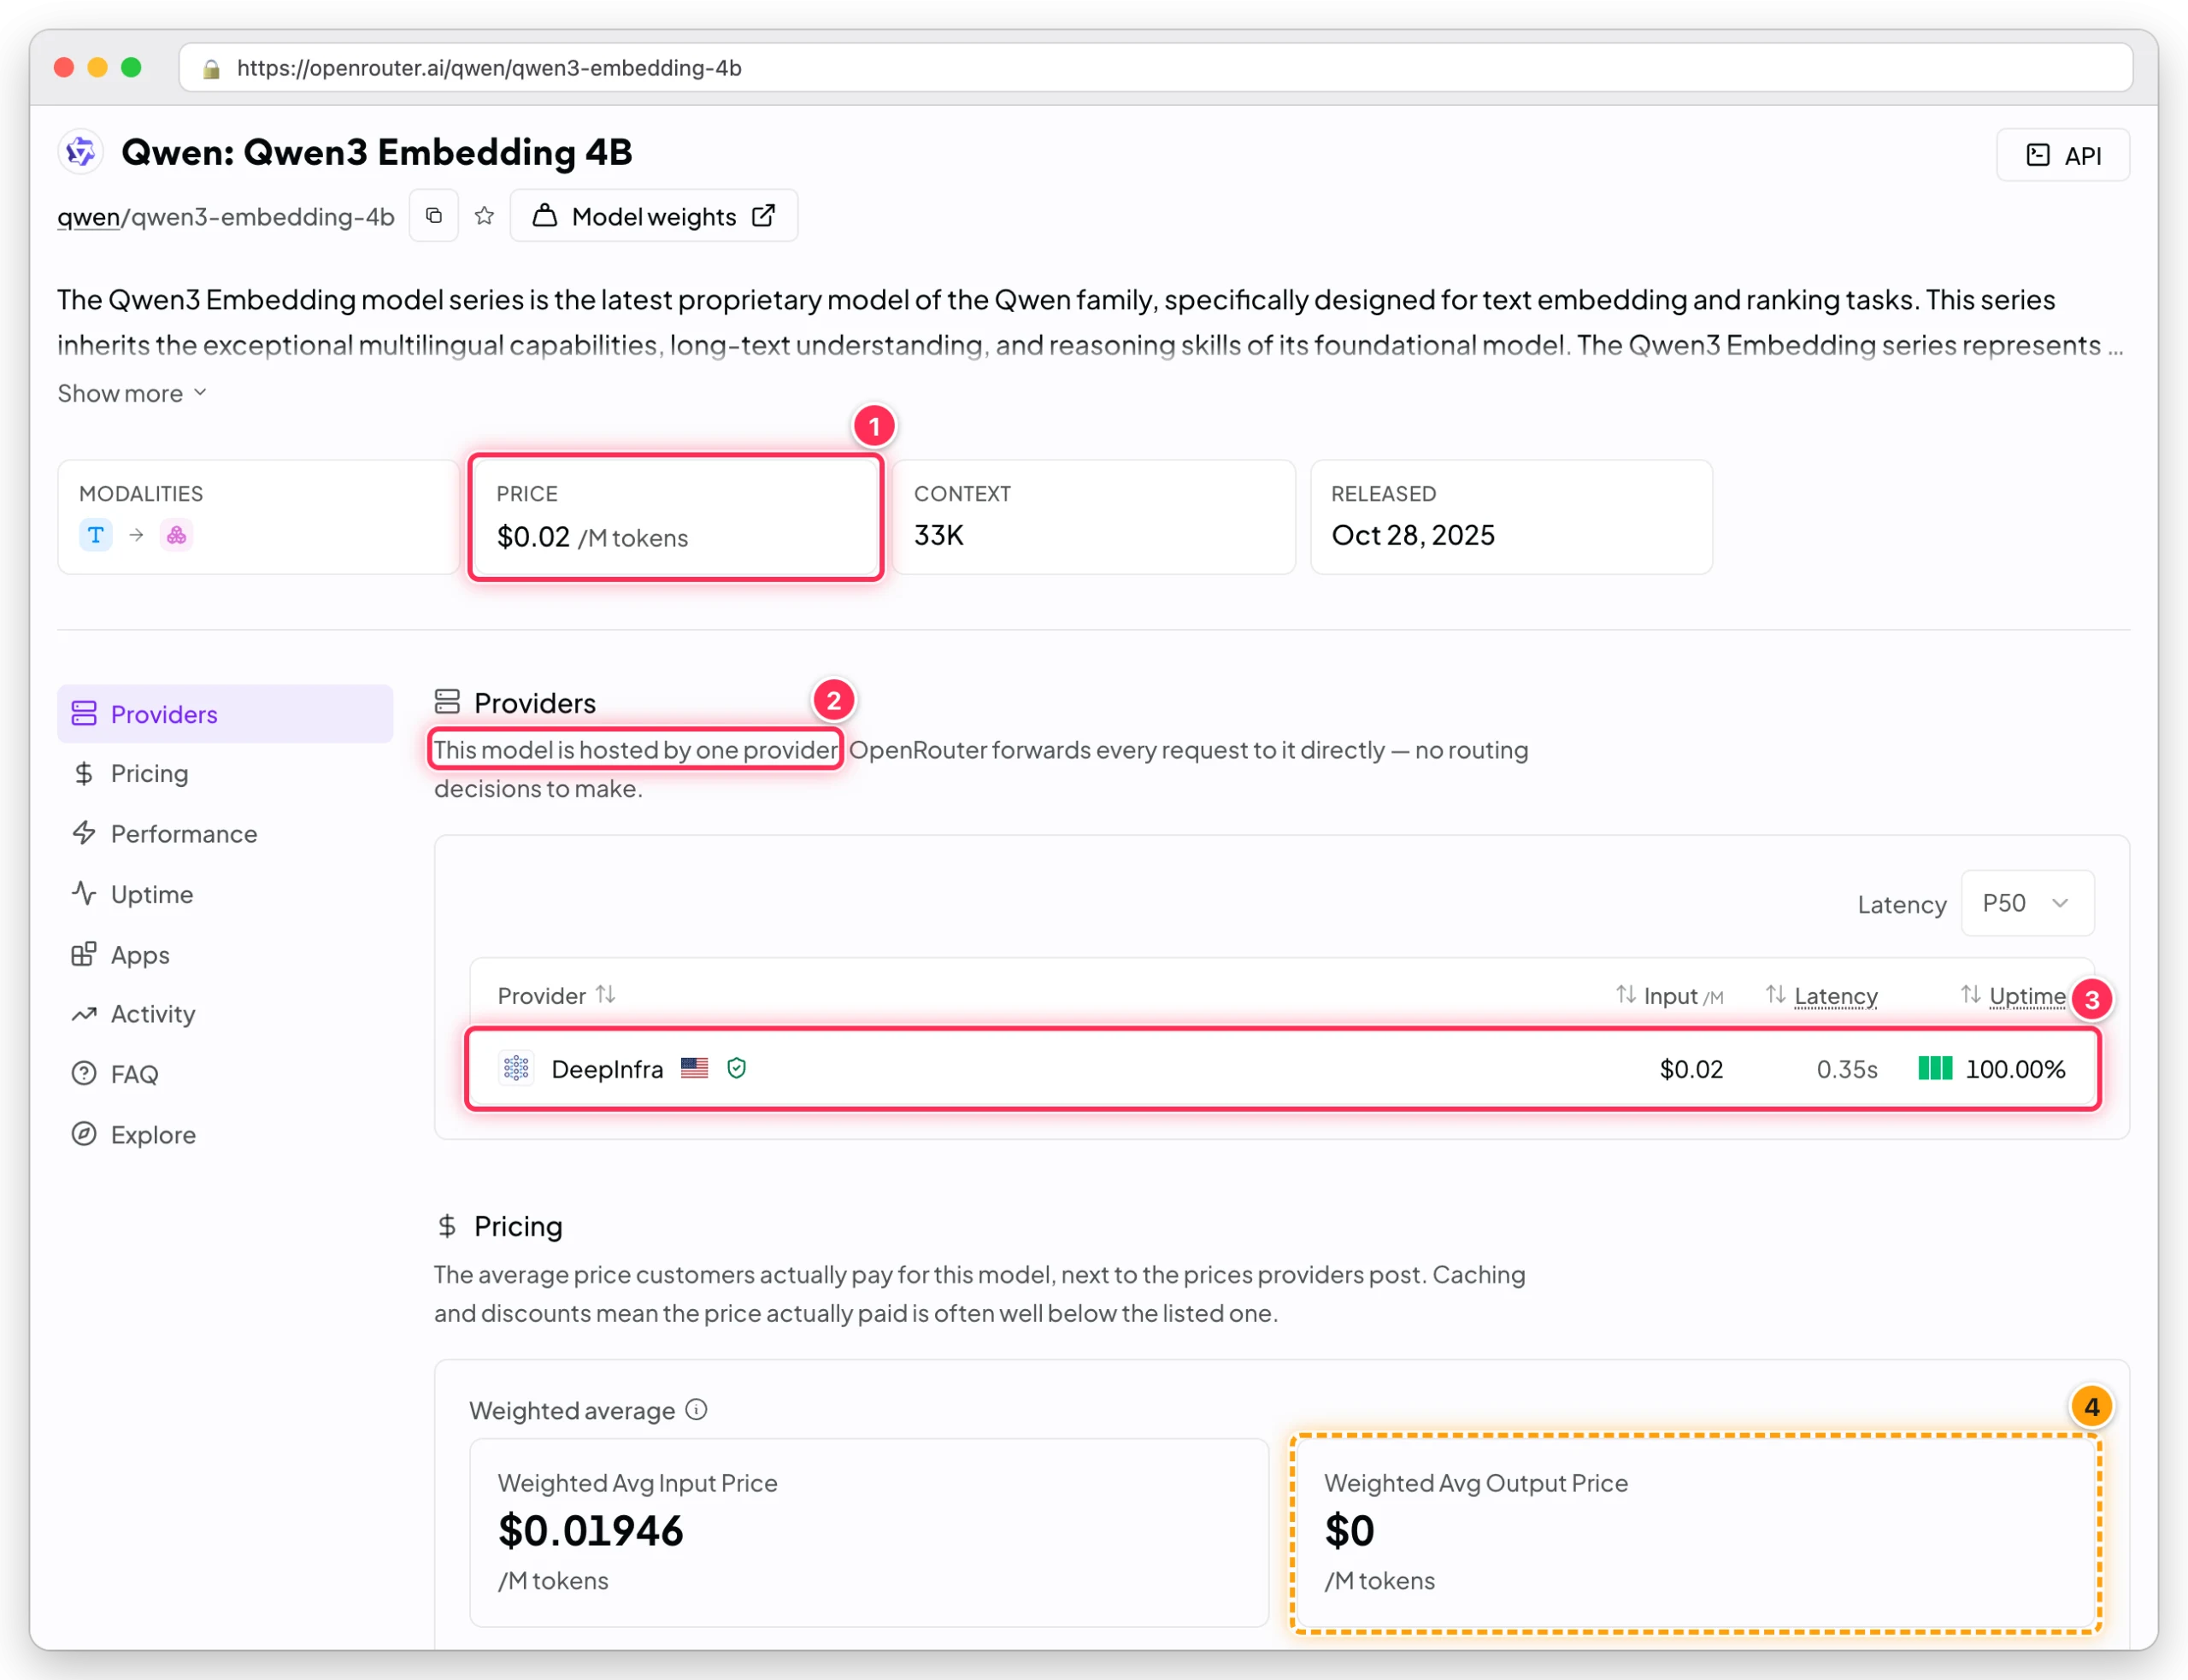
① 100만 토큰당 $0.02
② 제공자가 한 곳뿐이다
③ 제공자는 미쿡의 DeepInfra
④ 출력 가격은 $0
과금 토큰은 Qwen 토크나이저로 카운팅한 토큰과 정확히 같아서(입력 하나마다 끝 토큰 1개가 붙는다) 미리 세어볼 수 있다. dev에 쌓인 기사 6,984건을 세어 보니 제목+요약 300자가 평균 111토큰이었다. 발행 글은 1,200자 청크로 나눠 넣는데 한 편에 평균 2,561토큰이다.
| 항목 | 양 | 한 달 토큰 | 한 달 비용 |
|---|---|---|---|
| 수집 기사 | 하루 1,600건 × 111토큰 | 약 533만 | 약 $0.107 |
| 발행 글 | 하루 3편 × 2,561토큰 | 약 23만 | 약 $0.005 |
| 합계 | 약 557만 | 약 $0.11 (₩ 150원 남짓) |
Mac oMLX가 한 달 내내 꺼져 있다면 150원 정도다. 최근 기사 32건(임베딩 한 배치)을 실제로 OpenRouter에 보내 보면 응답에 과금 토큰과 비용이 같이 온다. 스크린샷의 배치는 영문 기사가 많아 건당 175토큰으로 평균보다 길었다.
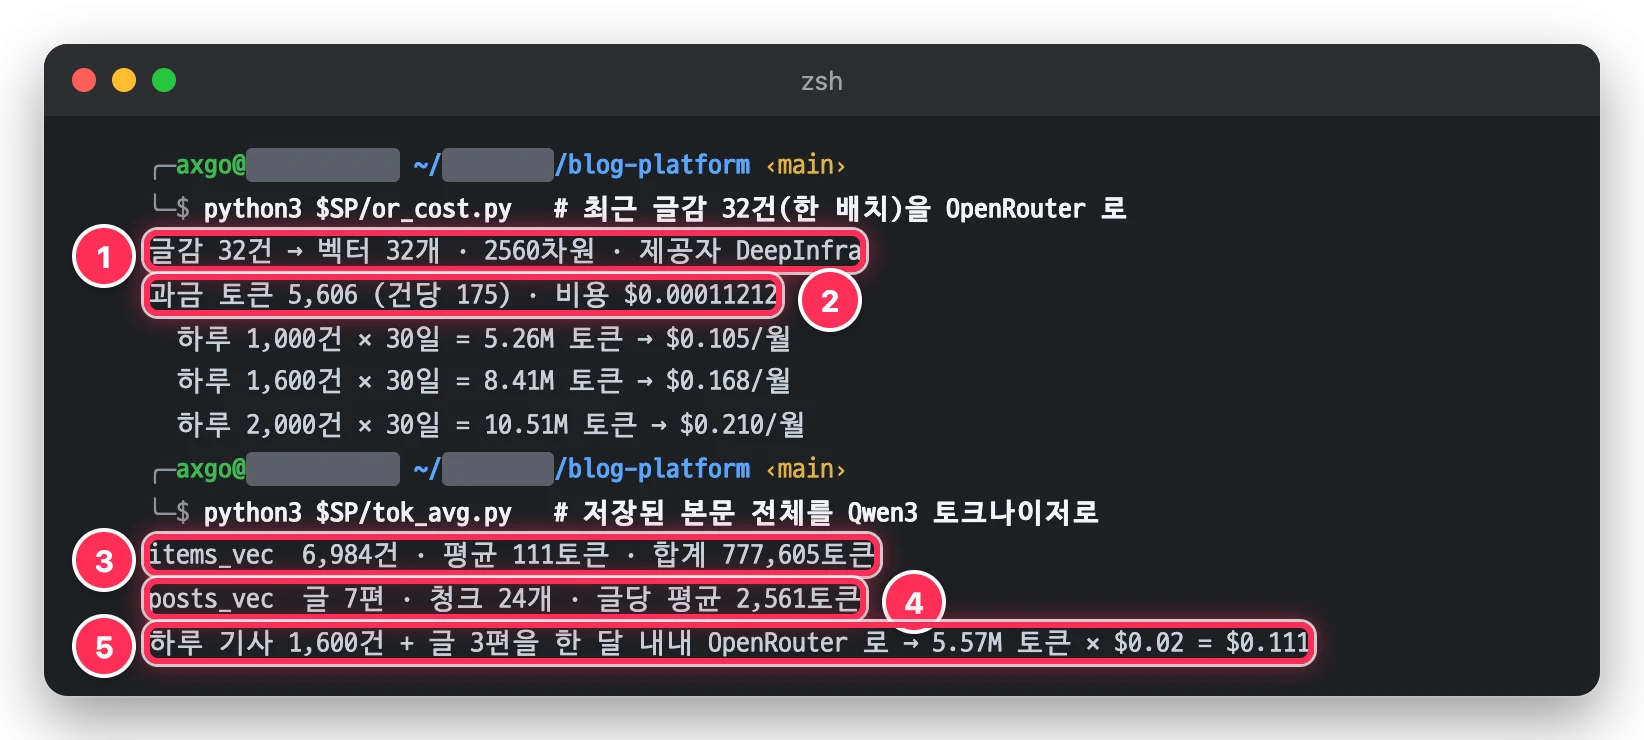
② 과금 토큰 5,606·비용 $0.00011212
③ 저장된 글감 6,984건의 평균 111토큰
④ 발행 글 한 편 평균 2,561토큰
⑤ 하루 1,600건과 3편이면 한 달 $0.111
벡터 전체를 다시 만드는 비용도 작다. 10월 1일 기준 dev·prod 벡터 11,575개를 전부 다시 만들어도 1,118,448토큰, $0.022(약 31원)였다. 이 비용확인후 “벡터는 백업하지 않는다”는 결정을 하게 되었다.
저장한 벡터는 어디에 쓰이나
벡터 테이블은 두 개다. 글감을 위해 수집 기사 한 건이 한 행인 items_vec, 발행 글을 1,200자(150자 겹침) 청크로 나눠 넣은 posts_vec이다. 벡터를 실제로 만드는 곳, 그러니까 임베딩 API를 부르는 곳은 임베딩 워크플로우와 발행 워크플로우 두 곳뿐이다. 나머지는 저장된 벡터를 읽기만 한다.
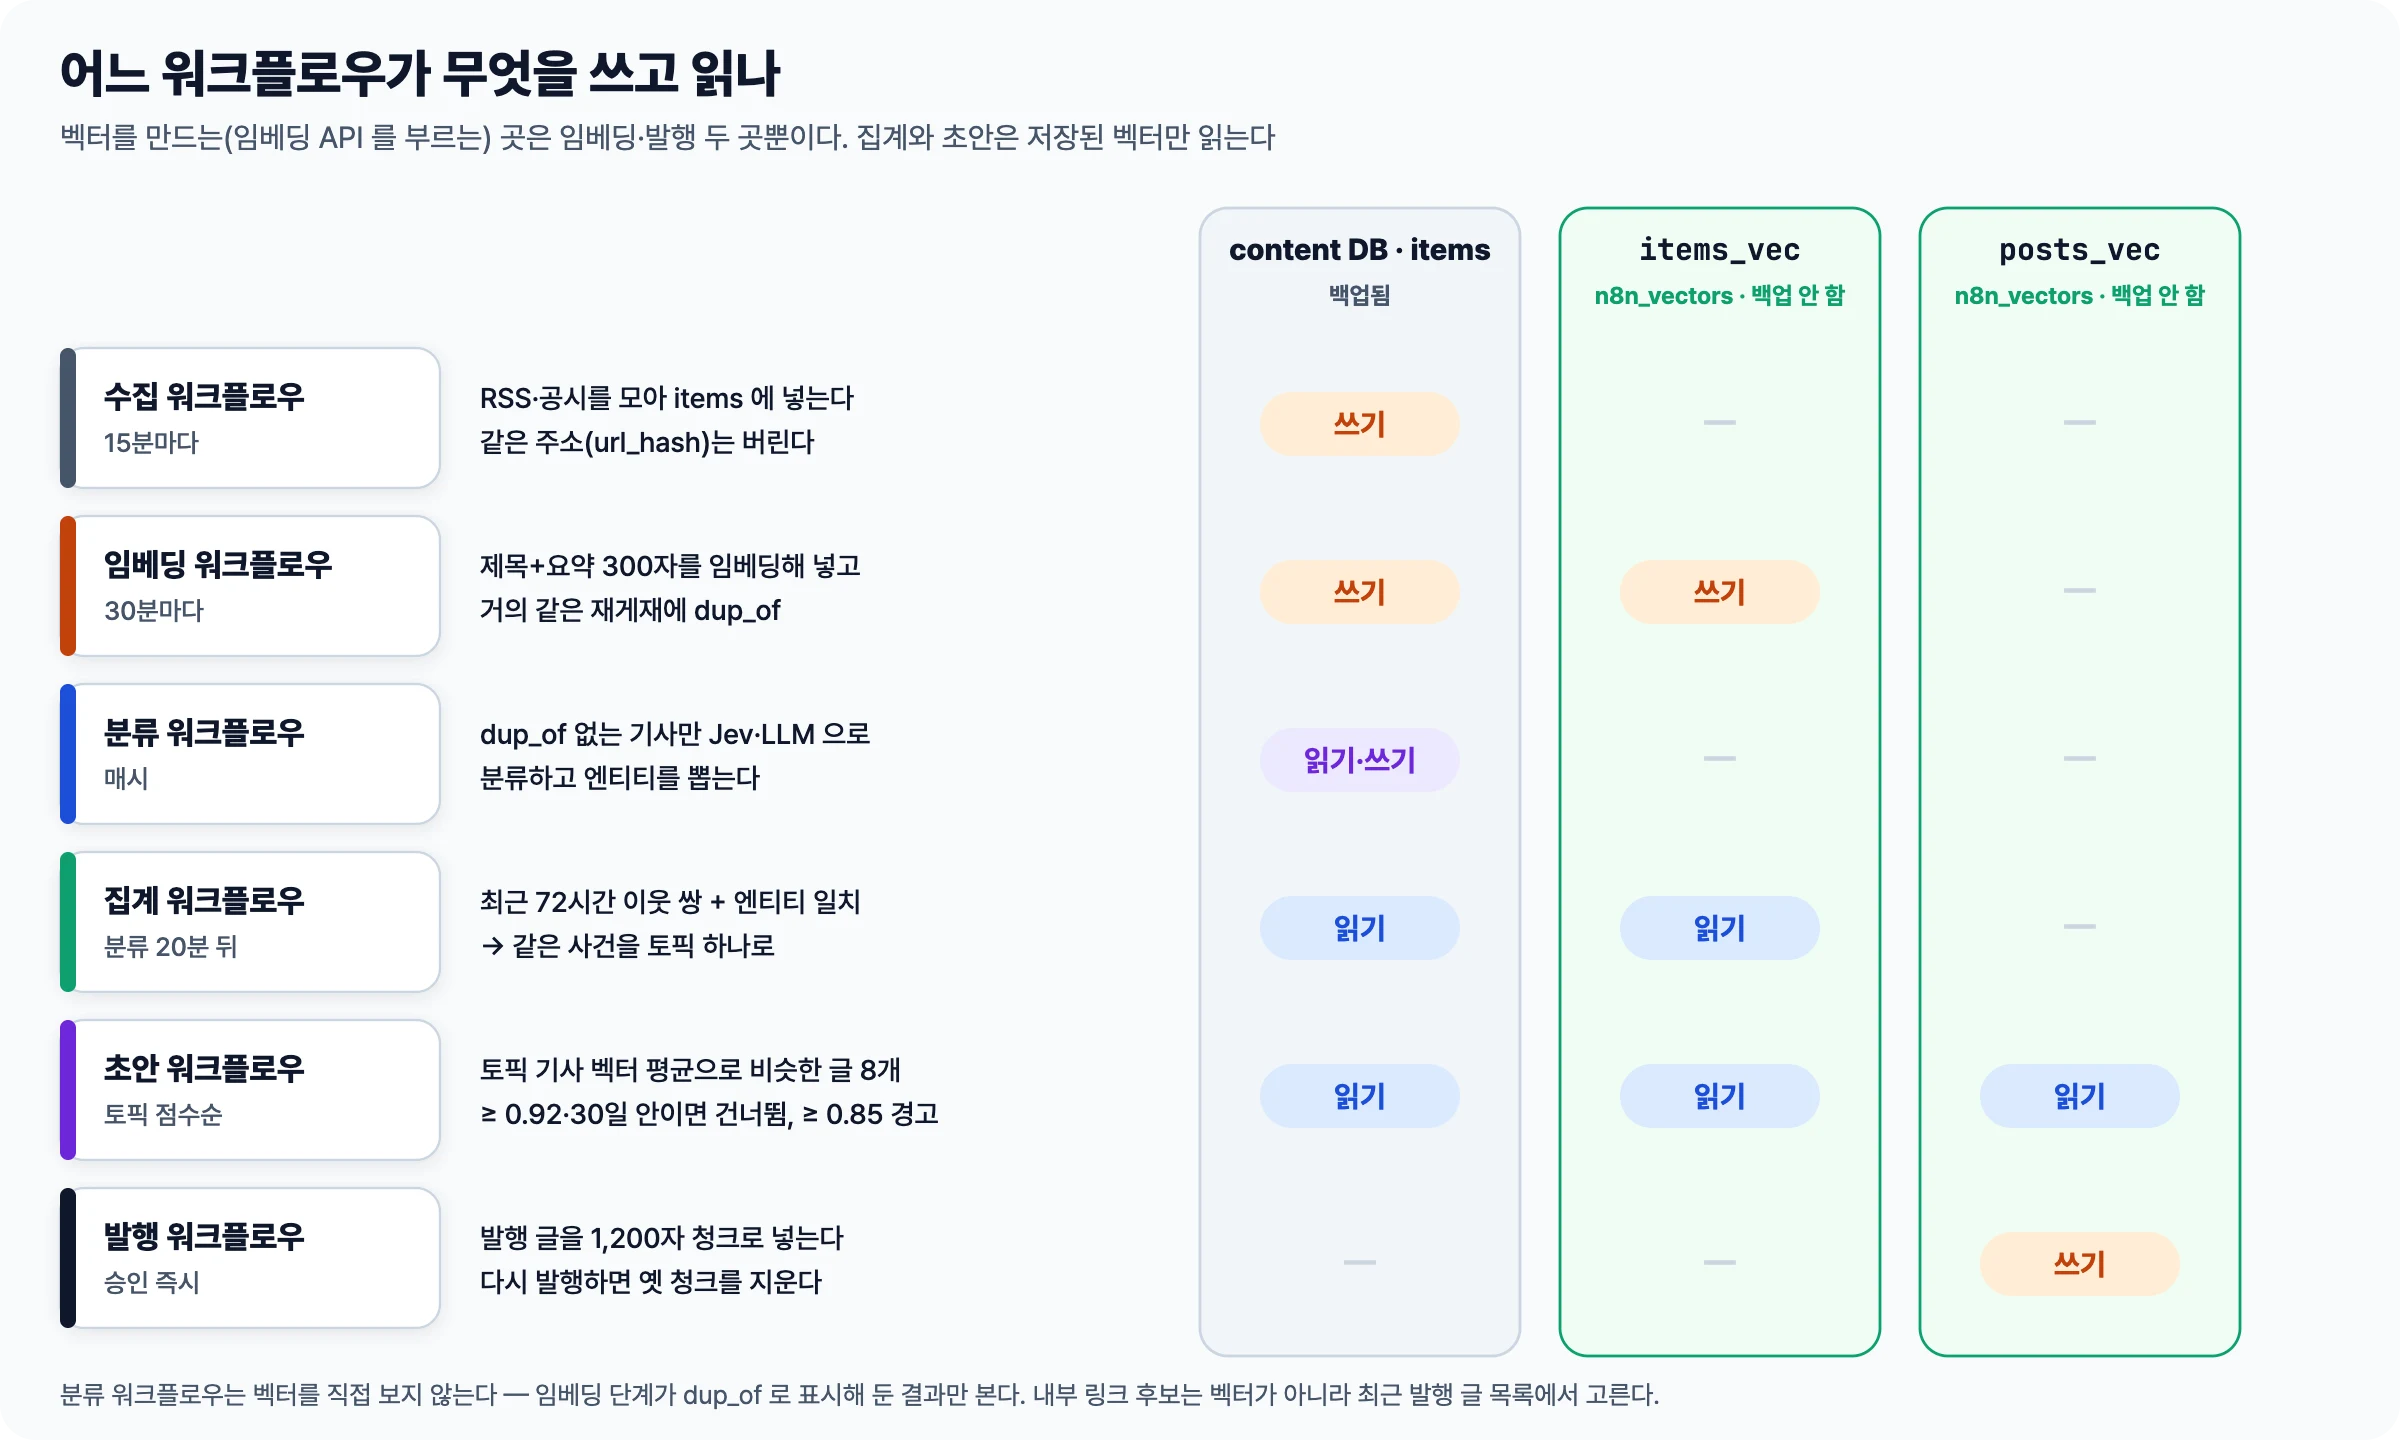
- 임베딩 워크플로우는 30분마다 아직 임베딩하지 않은 기사를 최대 200건씩, 32건 배치로 임베딩해
items_vec에 넣고 거의 같은 재게재에dup_of를 건다. - 분류 워크플로우는
dup_of가 없는 기사만 분류한다. 재게재를 분류하느라 Jev·LLM 호출을 쓰지 않는다. 벡터를 직접 보지는 않는다. - 집계 워크플로우는 최근 72시간 안의 벡터마다 가까운 이웃을 뽑아 쌍을 만든다. 코사인 0.85 이상이면서 엔티티가 하나라도 겹치거나, 0.78~0.85인데 흔하지 않은 엔티티(같은 72시간 안 기사의 3% 미만에 나오는 이름)가 겹치면 같은 사건으로 잇는다. 이렇게 이어진 묶음 하나가 토픽 하나가 되고 출처 수·신선도·가속도 같은 신호로 점수를 매긴다.
- 초안 워크플로우는 토픽에 묶인 기사 벡터의 평균으로
posts_vec에서 가까운 글 8개를 찾는다. 새로 임베딩하지 않는다. 가장 가까운 글이 0.92 이상이고 30일 안에 쓴 글이면 그 토픽은 쓰지 않고 넘어간다. 0.85 이상인 글은 “비슷한 기존 글, 중복을 피할 것”이라는 메모와 함께 개요 프롬프트에 넣고 텔레그램 검토 메시지에도 같이 보여 준다. - 발행 워크플로우는 승인된 글을 발행하면서 본문을 청크로 나눠
posts_vec에 넣는다. 같은 글을 고쳐 다시 발행하면 옛 청크를 먼저 지운다.
n8n 화면으로 보면 집계 워크플로우는 이웃 쌍을 뽑는 SQL 하나와, 그 쌍을 사건으로 잇는 Code 노드가 중심이다.
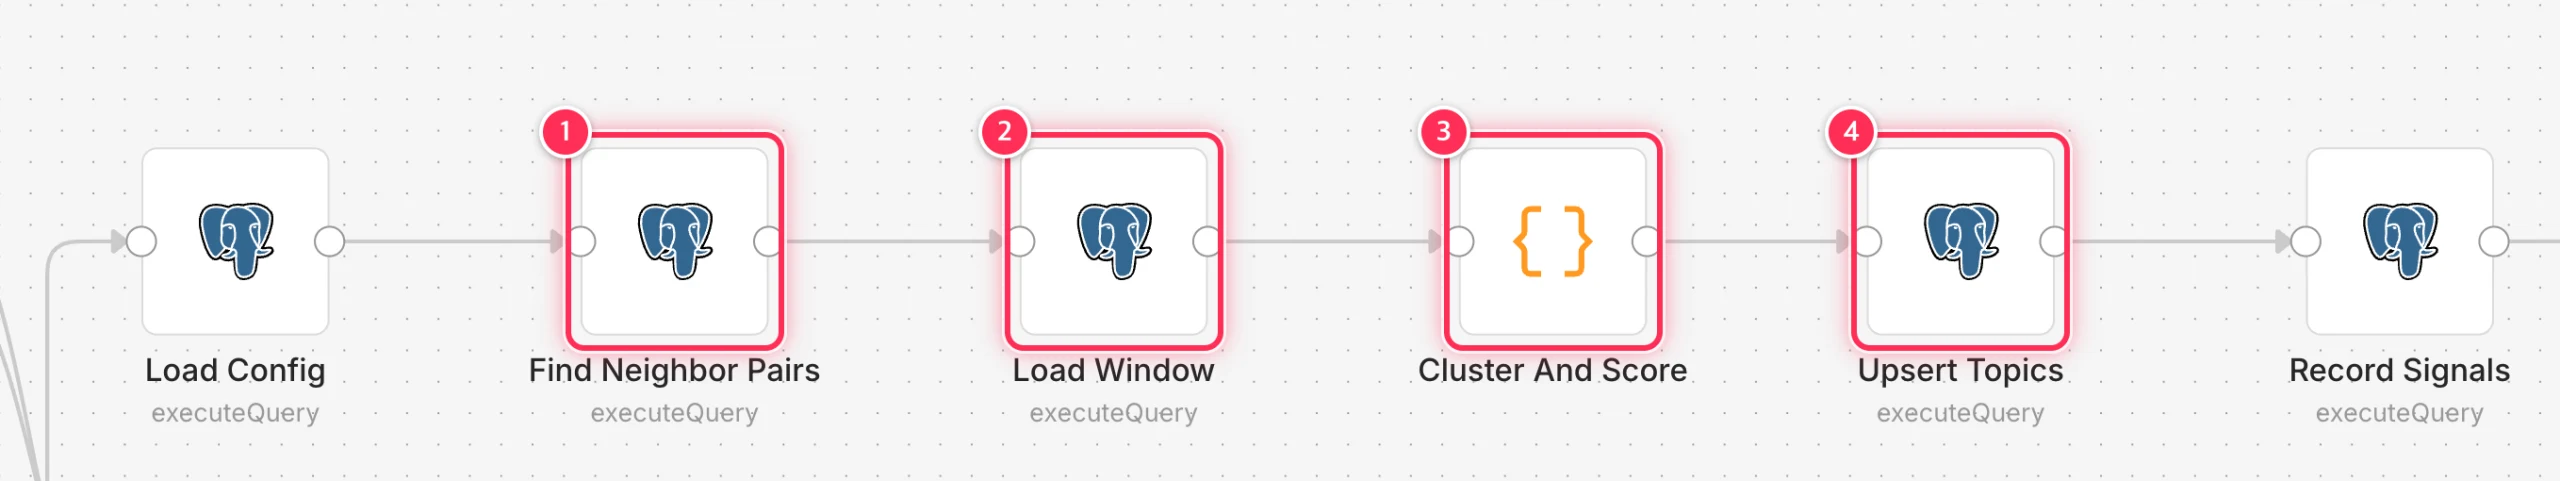
① 최근 72시간 벡터끼리 가까운 이웃 쌍을 뽑는다
② 같은 기간의 기사와 엔티티를 읽는다
③ 엔티티 규칙으로 쌍을 이어 사건으로 클러스터링하고 점수를 매긴다
④ 발행 단위인 토픽으로 저장한다.
초안 워크플로우에서는 비슷한 글을 찾는 SQL 바로 뒤에 중복 판단을 붙였다. 중복이면 토픽을 merged로 변경하고 작업을 끝낸다.
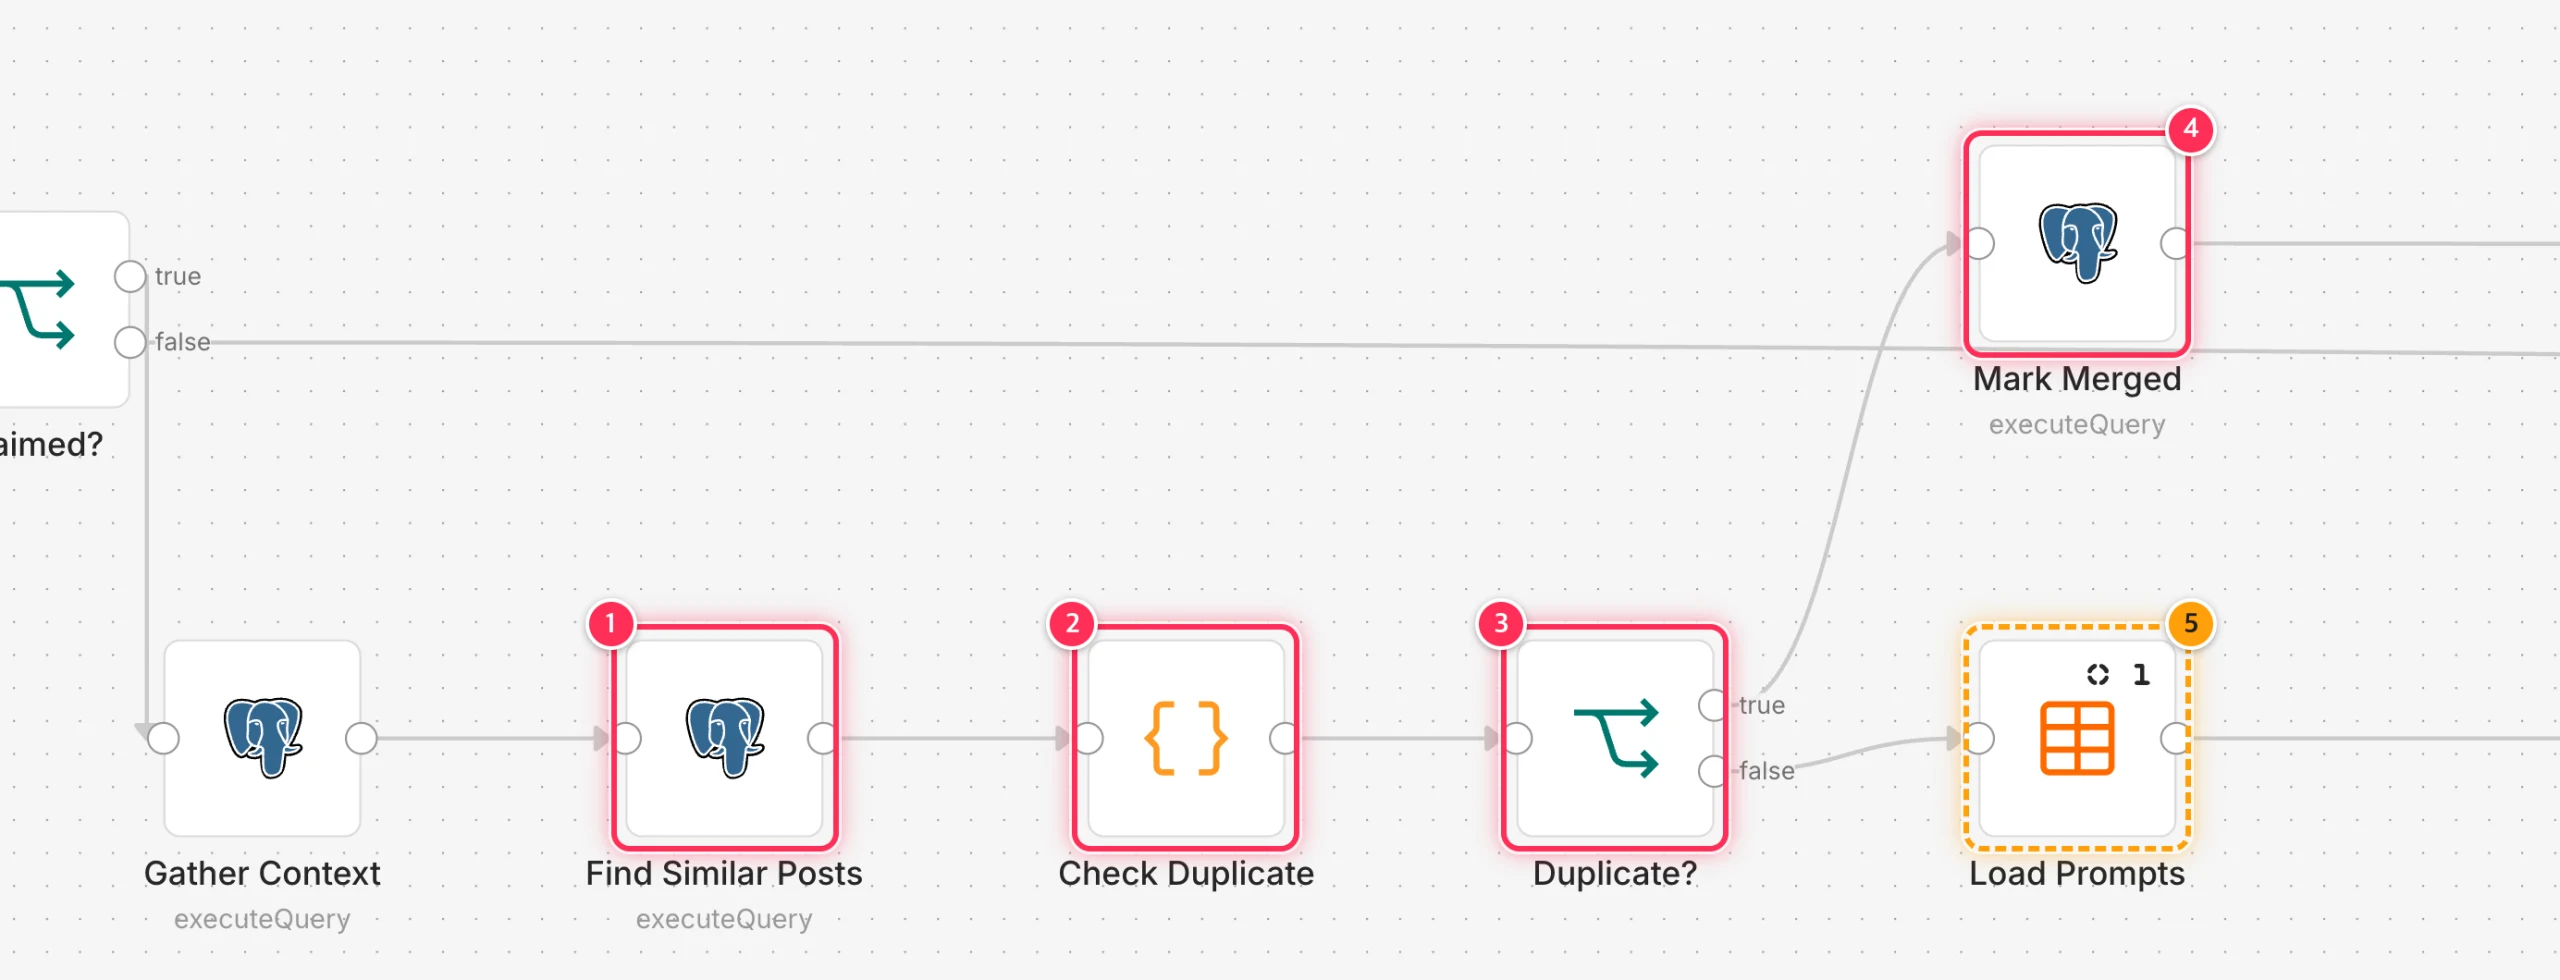
① 토픽 기사 벡터의 평균으로 posts_vec에서 비슷한 글 8개를 찾는다
② 코사인 유사도 0.92·30일 기준으로 중복여부를 확인한다
③ 결과에 따라 경로가 달라진다
④ 중복이면 토픽을 merged로 두고 끝낸다
⑤ 아니면 프롬프트를 읽어 초안 작성이 진행된다
집계 워크플로우가 엔티티 일치를 꼭 요구하는 것도 앞에서 본 첼린저 공시와 같은 이유다. 코사인과 엔티티가 둘 다 있어야 한다. 엔티티 없이 코사인만 보면 다른 회사의 같은 공시 양식이 0.99로 묶인다. 거꾸로 엔티티만 보면 “유동화 기재정정 5개사” 같은 것이 초안 토픽이 될수 있다.
벡터는 백업하지 않는다
백업 컨테이너는 하루 네 번(03·09·15·21시) WordPress DB, 수집 기사·토픽·초안이 든 content DB, n8n DB, wp-content를 restic으로 Cloudflare R2에 백업한다. 같은 PostgreSQL 안에 있지만 n8n_vectors는 빼놓았다.
- 다시 만들 수 있다. 벡터의 원본은 content DB의 기사 제목·요약과 WordPress의 발행글 본문이다. 이미 백업이 있다.
- 싸다. 앞에서 본 것처럼 전부 다시 만들어도 몇십 원이다. (oMLX로 생성하면 전기요금 정도다)
- 크다.
vector(1536)레코드가 저장된 테이블들은 본체 8.2 KB와 HNSW 인덱스 8.0 KB를 합쳐 한 행에 약 16.3 KB다. 덤프에 넣으면 R2 무료 10 GB를 벡터가 야금야금 먹는다.
때문에 서버를 옮기면 벡터DB가 비어 있다. prod는 A1이 서빙하고 A1이 죽으면 Mac이 prod를 이어받을때(반대 방향도 같은 도구를 쓴다). 이어받는 쪽은 scripts/mode.sh prod takeover로 R2에 저장된 백업을 복원한다. 이때 새 데이터 디렉터리의 첫 initdb가 n8n_vectors와 items_vec·posts_vec 테이블을 빈 상태로 만든다. 하지만 content DB에 복원된 기사는 모두 “임베딩 끝남(done)” 상태라 임베딩 워크플로우가 다시 임베딩 작업을 해주지 않는다. 벡터 테이블은 비어 있는데 아무도 채워주지 않으니 중복 판정과 집계가 옛 기사의 유사도 검사가 무조건 통과하는 상태가 발생한다. A1인스턴스가 생성된후 Mac에서 A1으로 prod를 전환하면서 발생하기도 했다.
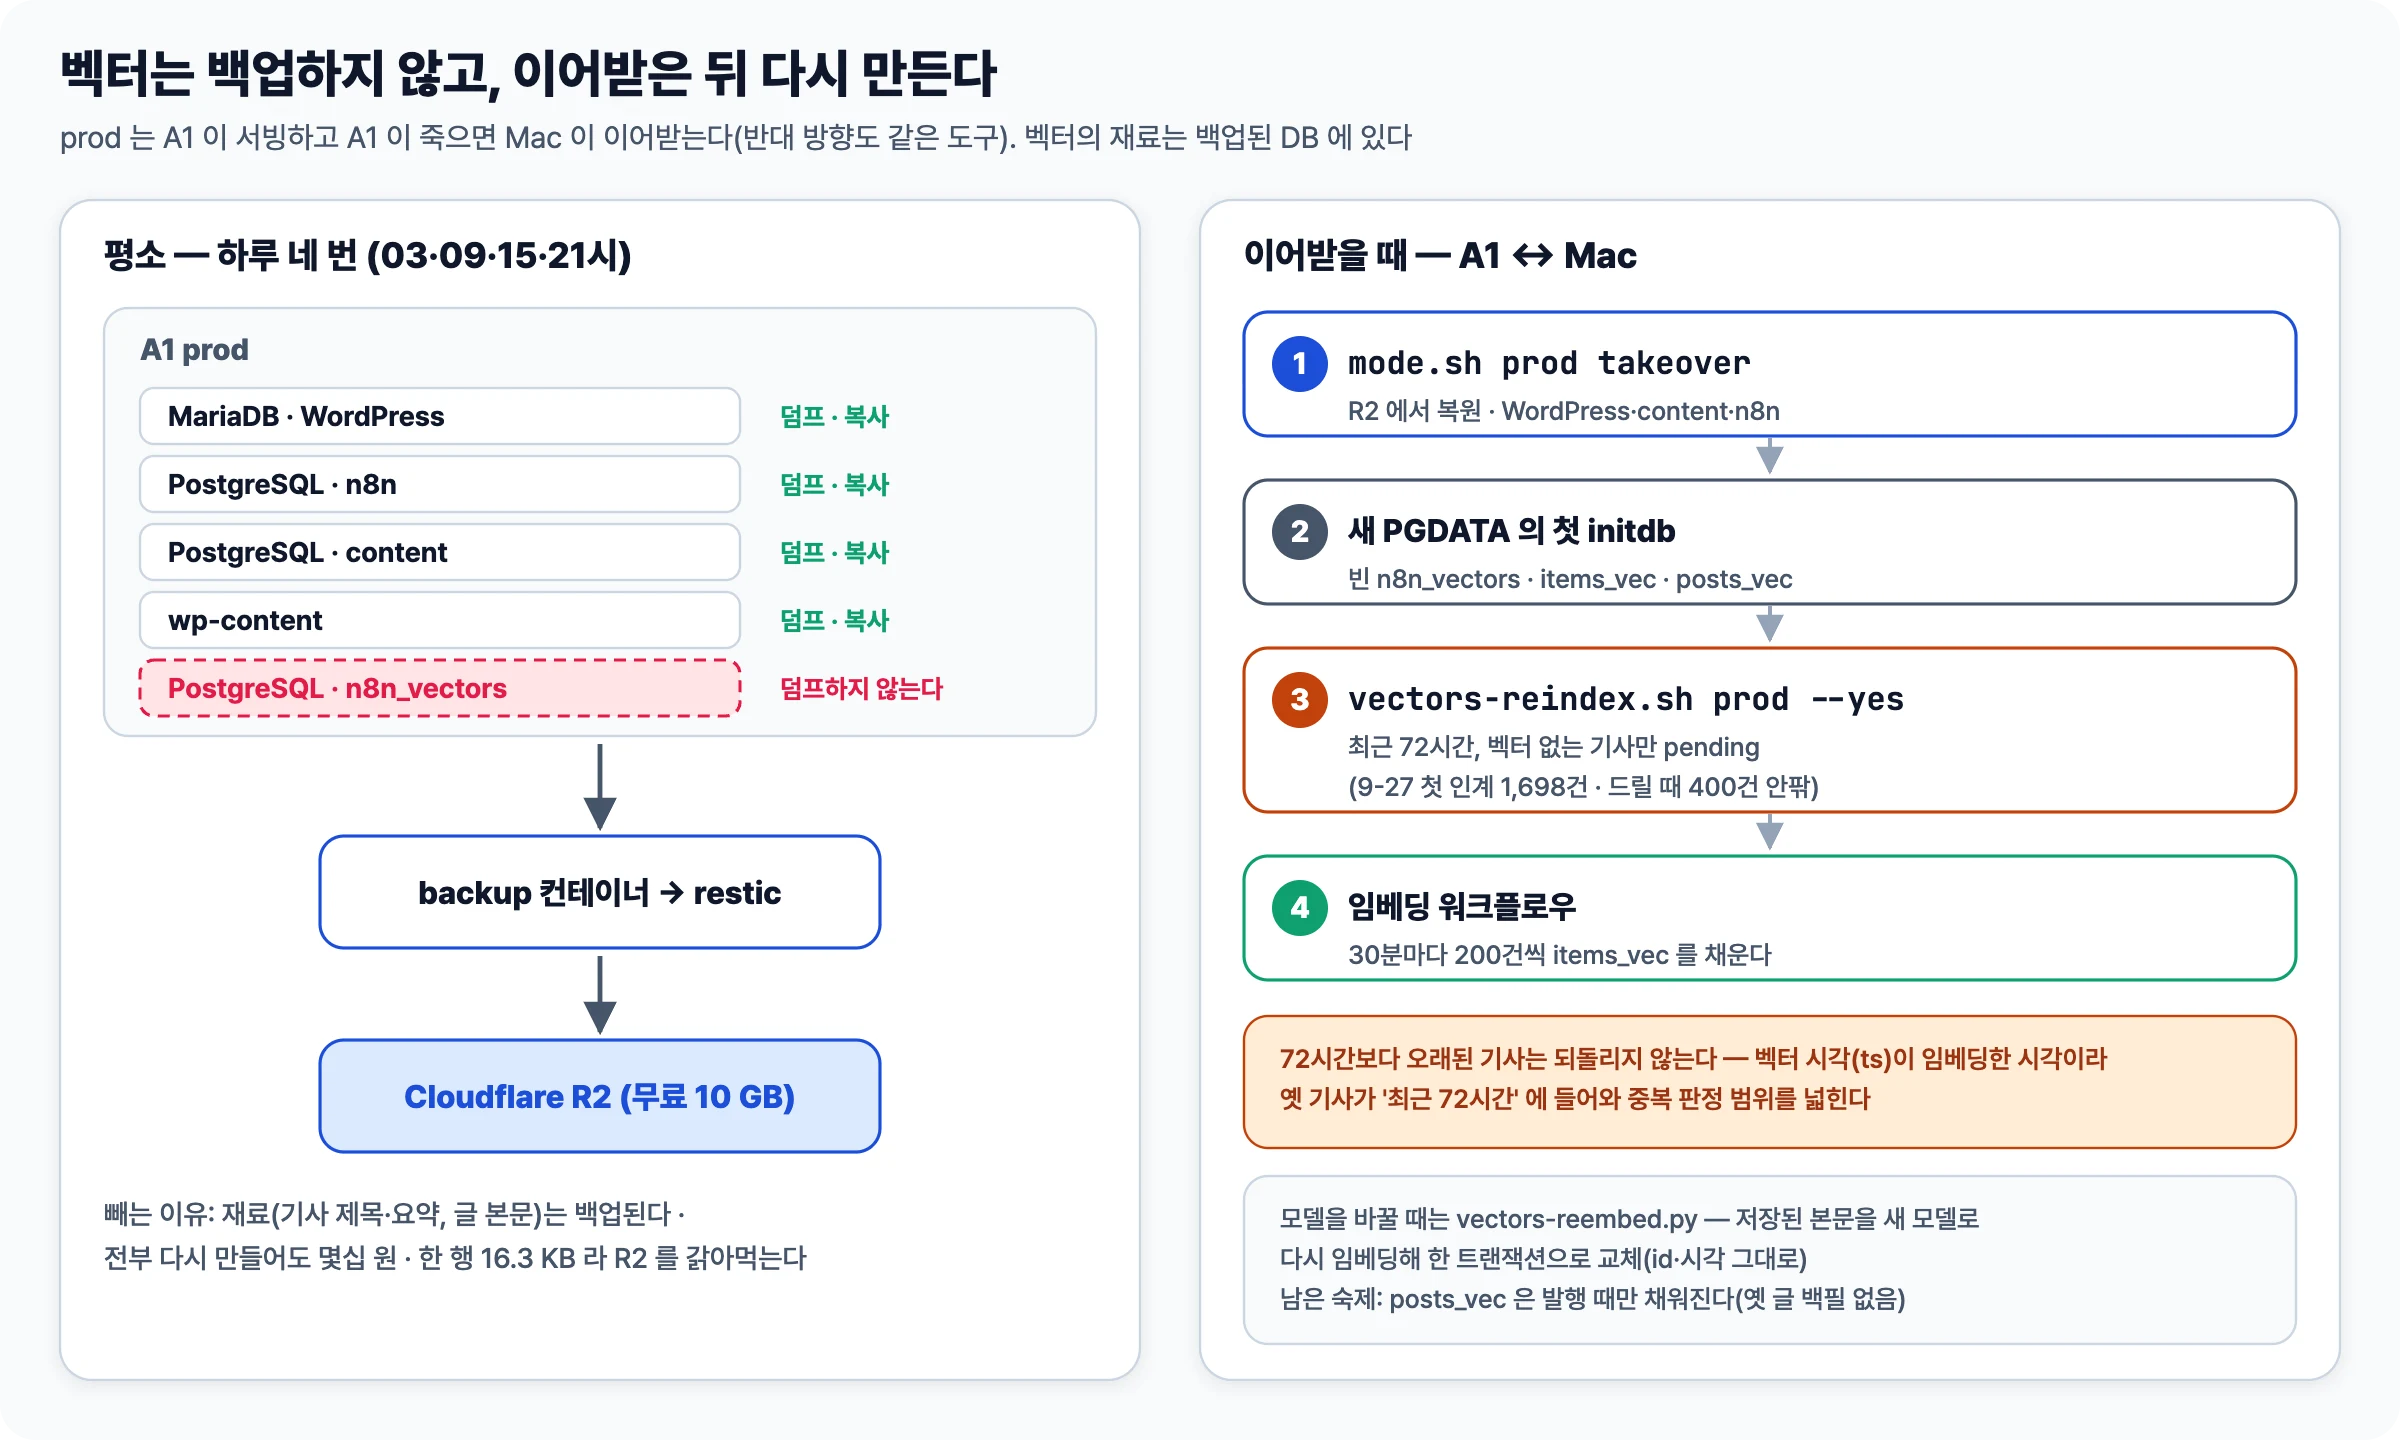
그래서 이어받은 뒤에는 늘 scripts/vectors-reindex.sh <모드> --yes를 돌린다. 이 스크립트는 먼저 벡터 테이블을 만드는 초기화 스크립트를 다시 돌리고(몇 번 돌려도 결과가 같다), 중복 판정 범위인 최근 72시간 안의 기사 중 벡터가 없는 것만 골라 pending으로 되돌린다. 나머지는 임베딩 워크플로우가 30분마다 200건씩 채운다.
72시간보다 오래된 기사까지 되돌리지는 않도록 했다. 임베딩 워크플로우는 벡터의 시각(ts)에 임베딩한 시각을 넣는다. 일주일 전 기사를 지금 다시 임베딩하면 그 기사가 “최근 72시간” 범위에 들어와 새 기사의 중복 판정 범위를 넓혀 버린다. 9월 27일 처음 A1로 넘길 때는 72시간 안의 1,698건이 pending으로 돌아갔고 첫 실행에서 200건이 채워지는 것까지 확인했다. 그 뒤 세 번의 prod 전환 검증 작업에서는 400건 안팎이었다.
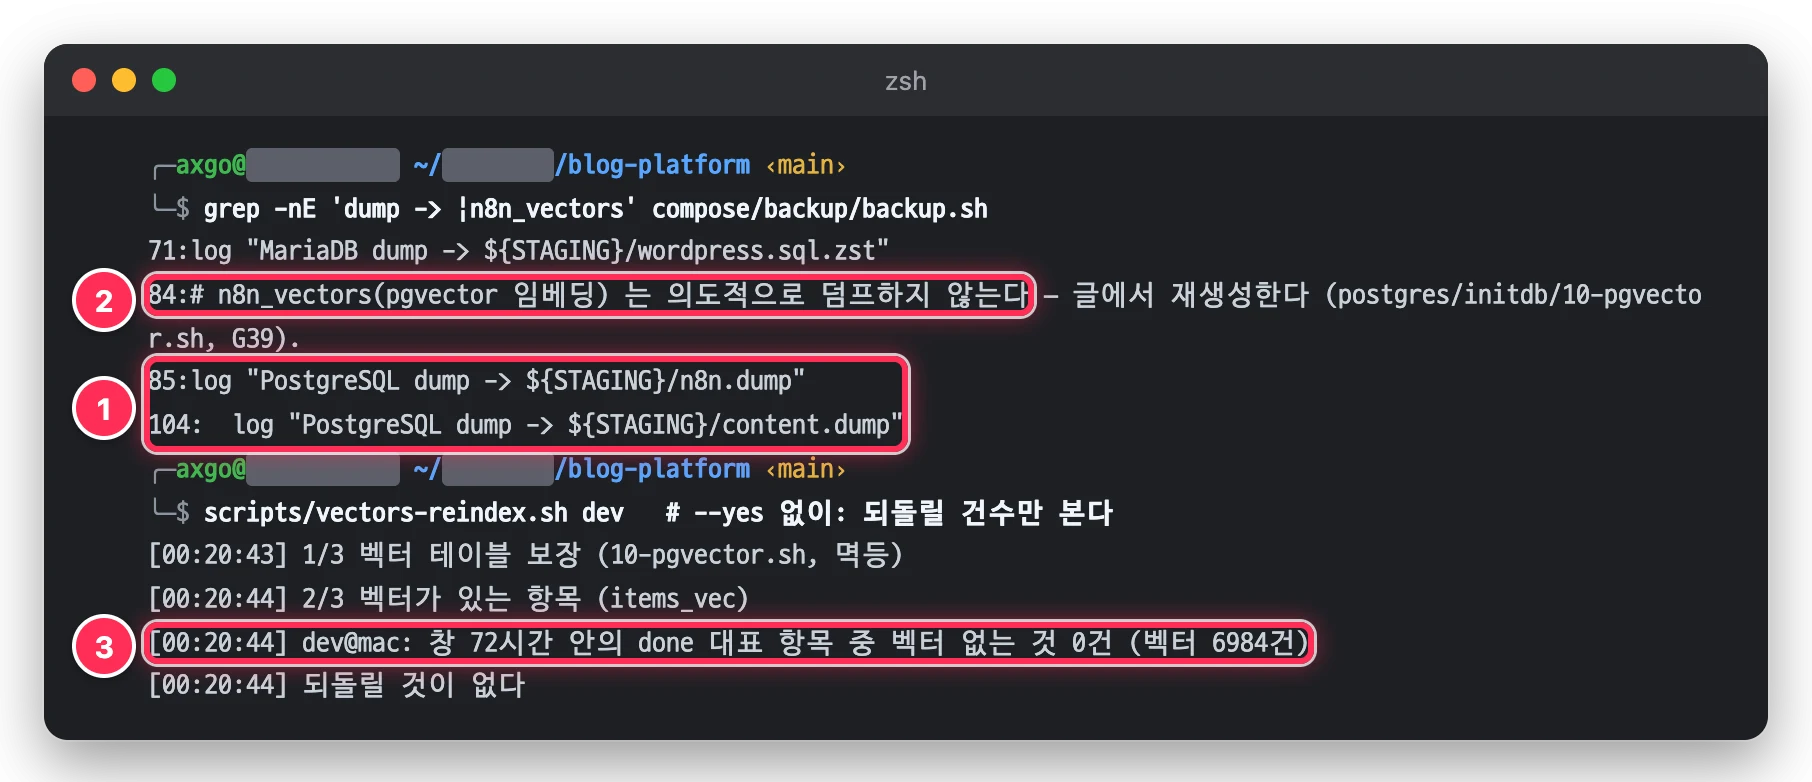
② n8n_vectors를 빼는 주석
③ dev는 지금 서빙 중이라 되돌릴 기사가 0건이다. 이어받은 직후라면 여기에 400~1,698건 같은 숫자가 나온다.
모델을 바꿀 때 vectors-reindex.sh 처럼 비운 뒤 다시 채우면 몇 시간 동안 옛 공간과 새 공간의 벡터가 섞인다. 이때는 scripts/vectors-reembed.py 로 임베딩 작업을 별도 실행하도록 했다. 저장된 본문을 새 모델로 다시 임베딩해 한 트랜잭션으로 바꿔 넣는다. 벡터 id와 시각이 그대로라 집계가 보는 72시간 범위도 흔들리지 않는다. 4비트에서 bf16으로 옮길 때 이 방법을 사용했다.
posts_vec은 발행할 때만 추가되는 방식이라 prod를 A1에서 Mac으로 전환시킨 뒤에 과거 발행된 글의 벡터를 다시 채우는 동작은 아직 구현하지 못했고, 임베딩 작업이 실패한 글을 나중에 채우는 백필도 아직은 없다. 발행 워크플로우의 청크·임베딩 부분을 하위 워크플로우로 빼서 백필이 같은 코드를 쓸 수 있도록 설계를 검토하는 중이다. (벡터 백업은 어떻게든 안할꺼다 ㅎㅎ)
마치며: 믿을 만한 초안은 중복을 걸러 내는 데서 시작한다
- 임베딩과 pgvector를 이용해 1차원적으로 문장을 쓰지 않고 여러 기사와 공시의 클러스터링을 통해 다양한 관점을 AI에 간접적으로 주입할 수 있게 되었다.
- 코사인 유사도만 믿으면 회사가 다른 공시이지만 하나의 토픽으로 그룹핑되어 발행된 글에서 A 회사 이야기에 B 회사에서 봤던 엉뚱한 내용이 주입될 소지가 있다. 엔티티 일치 조건으로 다른 사건의 내용이 억지스럽게 나타나는 것을 방어 해준다.
- 같은 글을 두 번 쓰지 않게 되었다. 초안 워크플로우에서 글을 쓰기 전에 이미 발행한 글과 비교해 30일 안의 같은 글을 건너뛰고 비슷한 글이 있으면 다르게 쓰라는 지시를 넣어 두었다.
- 4비트 모델을 그대로 썼다면 Openrouter 임베딩 폴백이 생길 때마다 판정이 달라졌을 것이다. 지금은 Mac이든 OpenRouter든 거의 오차가 없는 같은 차원의 벡터라 어느 쪽에서 벡터를 만들었느냐에 따라 중복 판정이 바뀌지 않는다.
- 비용은 Mac이 꺼져 있어도 한 달 $0.11, 전부 다시 만들어도 몇십 원이다. 무작위 200건은 모든 모델이 괜찮다고 했지만, 0.95 언저리에 모인 265쌍으로 재자 4비트 모델이 54쌍을 다르게 판정했다. 기준값 하나로 판정이 정해지는 시스템이라면 측정도 그 기준값 가까이에서 해야 한다.