n8n 으로 블로그 자동화를 만들다 보니 n8n 만으로는 안 되는 작업이 생겼다. 초안을 휴대폰에서 읽을 수 있는 한글 PDF 로 만드는 일과 수집한 데이터로 차트를 그리는 일이 그랬다. 이미지 생성 모델이 제대로 못 쓰는 한글을 이미지에 넣는 일도 마찬가지였다. n8n 의 Code 노드는 JavaScript 샌드박스라 이런 라이브러리를 쓸 수 없고 crypto 모듈조차 막혀 있다.
이 작업들은 파이썬 서버 하나로 해결했다. 처음엔 PDF 만 만들어서 컨테이너 이름을 pdf 라고 붙였는데 지금은 엔드포인트가 아홉 개로 늘었다. 표준 라이브러리 http.server 로 HTTP 서버를 만들고 PDF 는 WeasyPrint, 차트는 matplotlib, 이미지는 Pillow 로 처리한다. 이 글에서는 라이브러리별로 어떻게 썼는지, 한글 때문에 어디서 막혔는지를 정리한다.
블로그 전체 구성은 무료 구성 요소 조사 글에, 백업 구조는 restic·sops·R2 백업 구조 글에 따로 정리해 두었다.
목차
왜 파이썬으로 만들었나
HTML→PDF 변환은 한글 출력이 돼야 하고 차트 라벨과 이미지 위 텍스트도 한글이어야 했다. prod 서버는 오라클 무료 A1(2 OCPU, 메모리 12GB)이라 무거운 건 부담스러웠다. 해시값으로 업로드 중복을 막으니 같은 입력이면 같은 바이트가 나와야 했다. n8n 에서는 HTTP 로 호출할 수 있으면 됐다.
| 후보 | 문제 |
|---|---|
| n8n Code 노드(JavaScript) | 샌드박스라 crypto 도 쓸 수 없다. 기본 이미지를 사용하고 PDF·이미지 라이브러리를 설치하는 번거로움은 피하고 싶었다 |
| 워드프레스(PHP) | PDF 는 승인 전에 만들어야 한다. 발행 전인 글 때문에 워드프레스를 호출할 이유가 없고 차트 라이브러리를 별도로 설치해야 한다 |
| Node + 헤드리스 Chromium | HTML→PDF 는 잘 되지만 브라우저를 설치하고 렌더링하려면 리소스가 많이 필요해진다. 무료 서버에 두기엔 무겁다 |
| Python | WeasyPrint·matplotlib·Pillow 를 Alpine 패키지로 바로 설치할 수 있고, Chromium 보다 훨씬 가볍게 처리가 가능하다. |
가벼운 처리를 위해 파이썬으로 구현하는 방향을 잡았다. WeasyPrint 는 브라우저 없이 Pango 로 출력하고 PDF 한 번 렌더링에 쓰는 메모리가 100MB 안쪽이다. Alpine 저장소에 py3-* 패키지로 모두 존재하고 있어서 pip 도 빌드 도구도 없이 apk add 한 줄로 쉽게 설치할 수 있었다. 한글 폰트는 font-noto-cjk 패키지 하나면 된다. matplotlib 을 설치하면 numpy 도 같이 설치가 되는데 나중에 Pillow 로 원근 변환을 할 때 numpy 로 쉽게 처리가 가능해졌다.
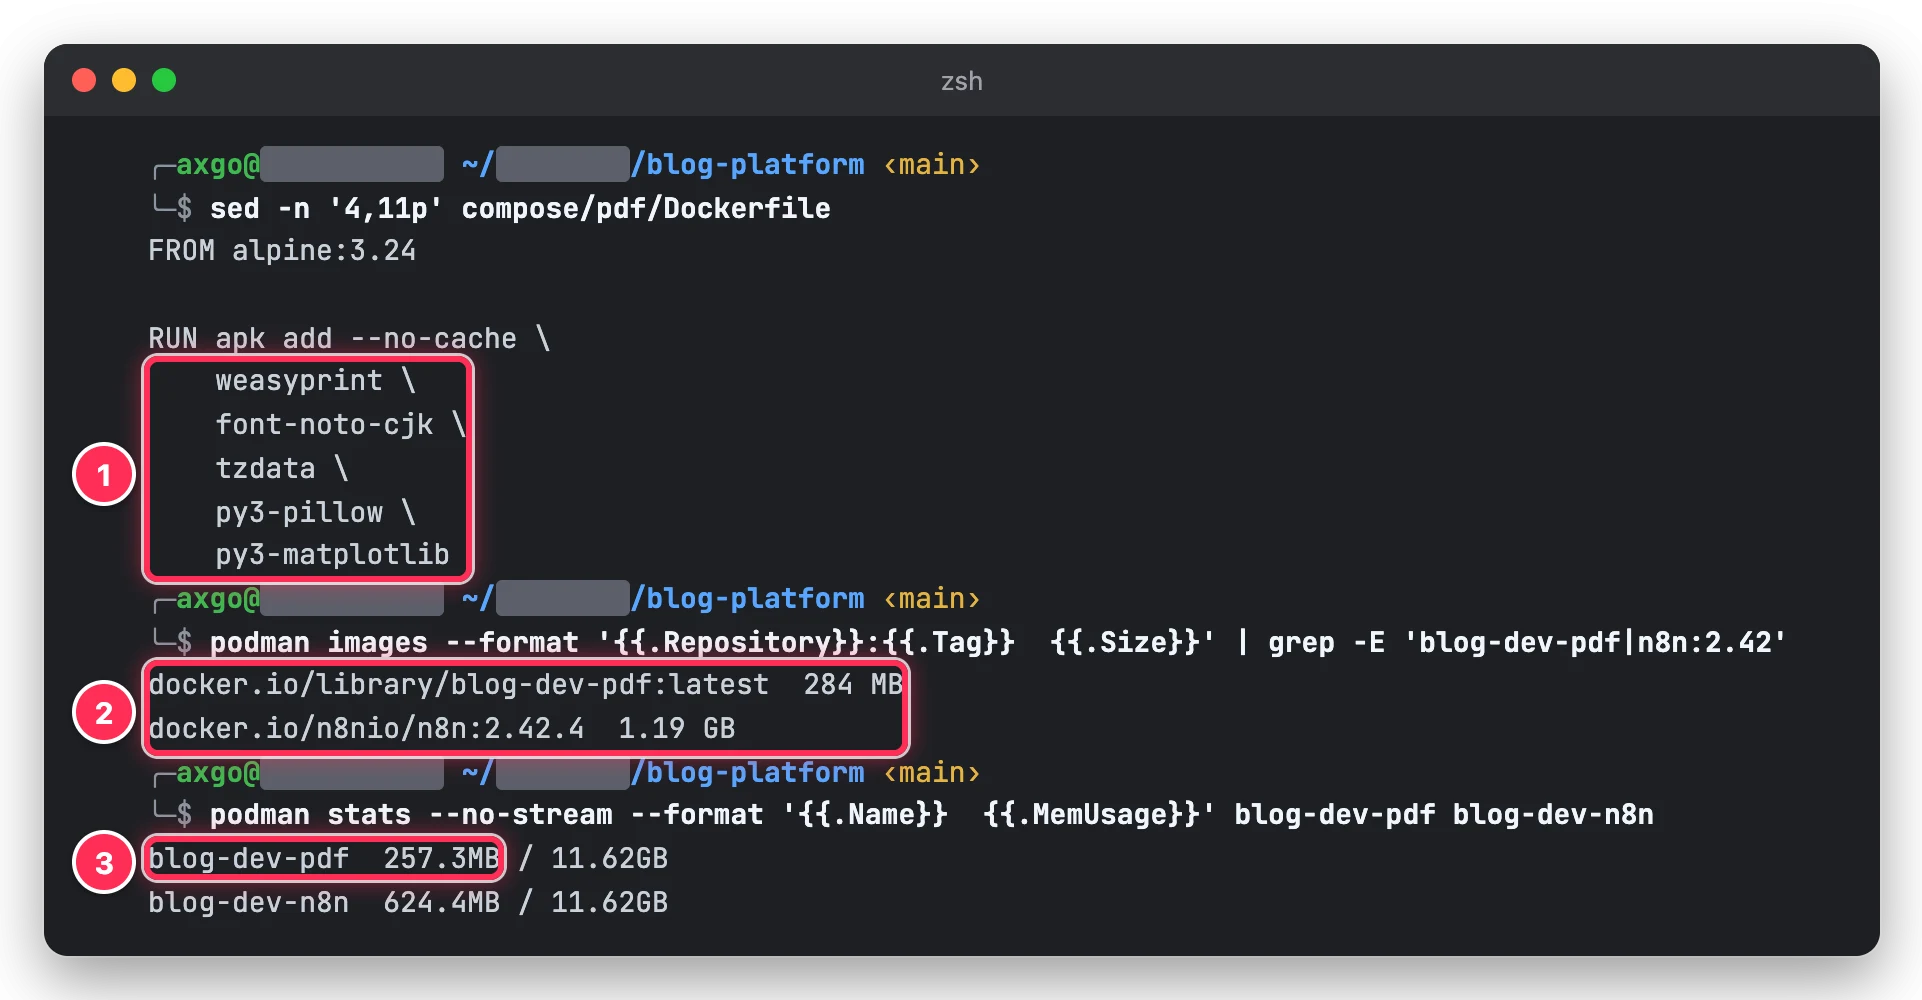
① apk 로 설치하는 패키지 다섯 개
② pdf 이미지 284 MB, 같은 서버의 n8n 이미지 1.19 GB
③ 실행 중인 pdf 컨테이너의 메모리 사용량
이미지 크기는 284MB 로, 같은 서버의 n8n 이미지(1.19GB)의 4분의 1이 안 된다. prod 에서 사흘째 떠 있는 컨테이너의 메모리 사용량은 274MB 였다.
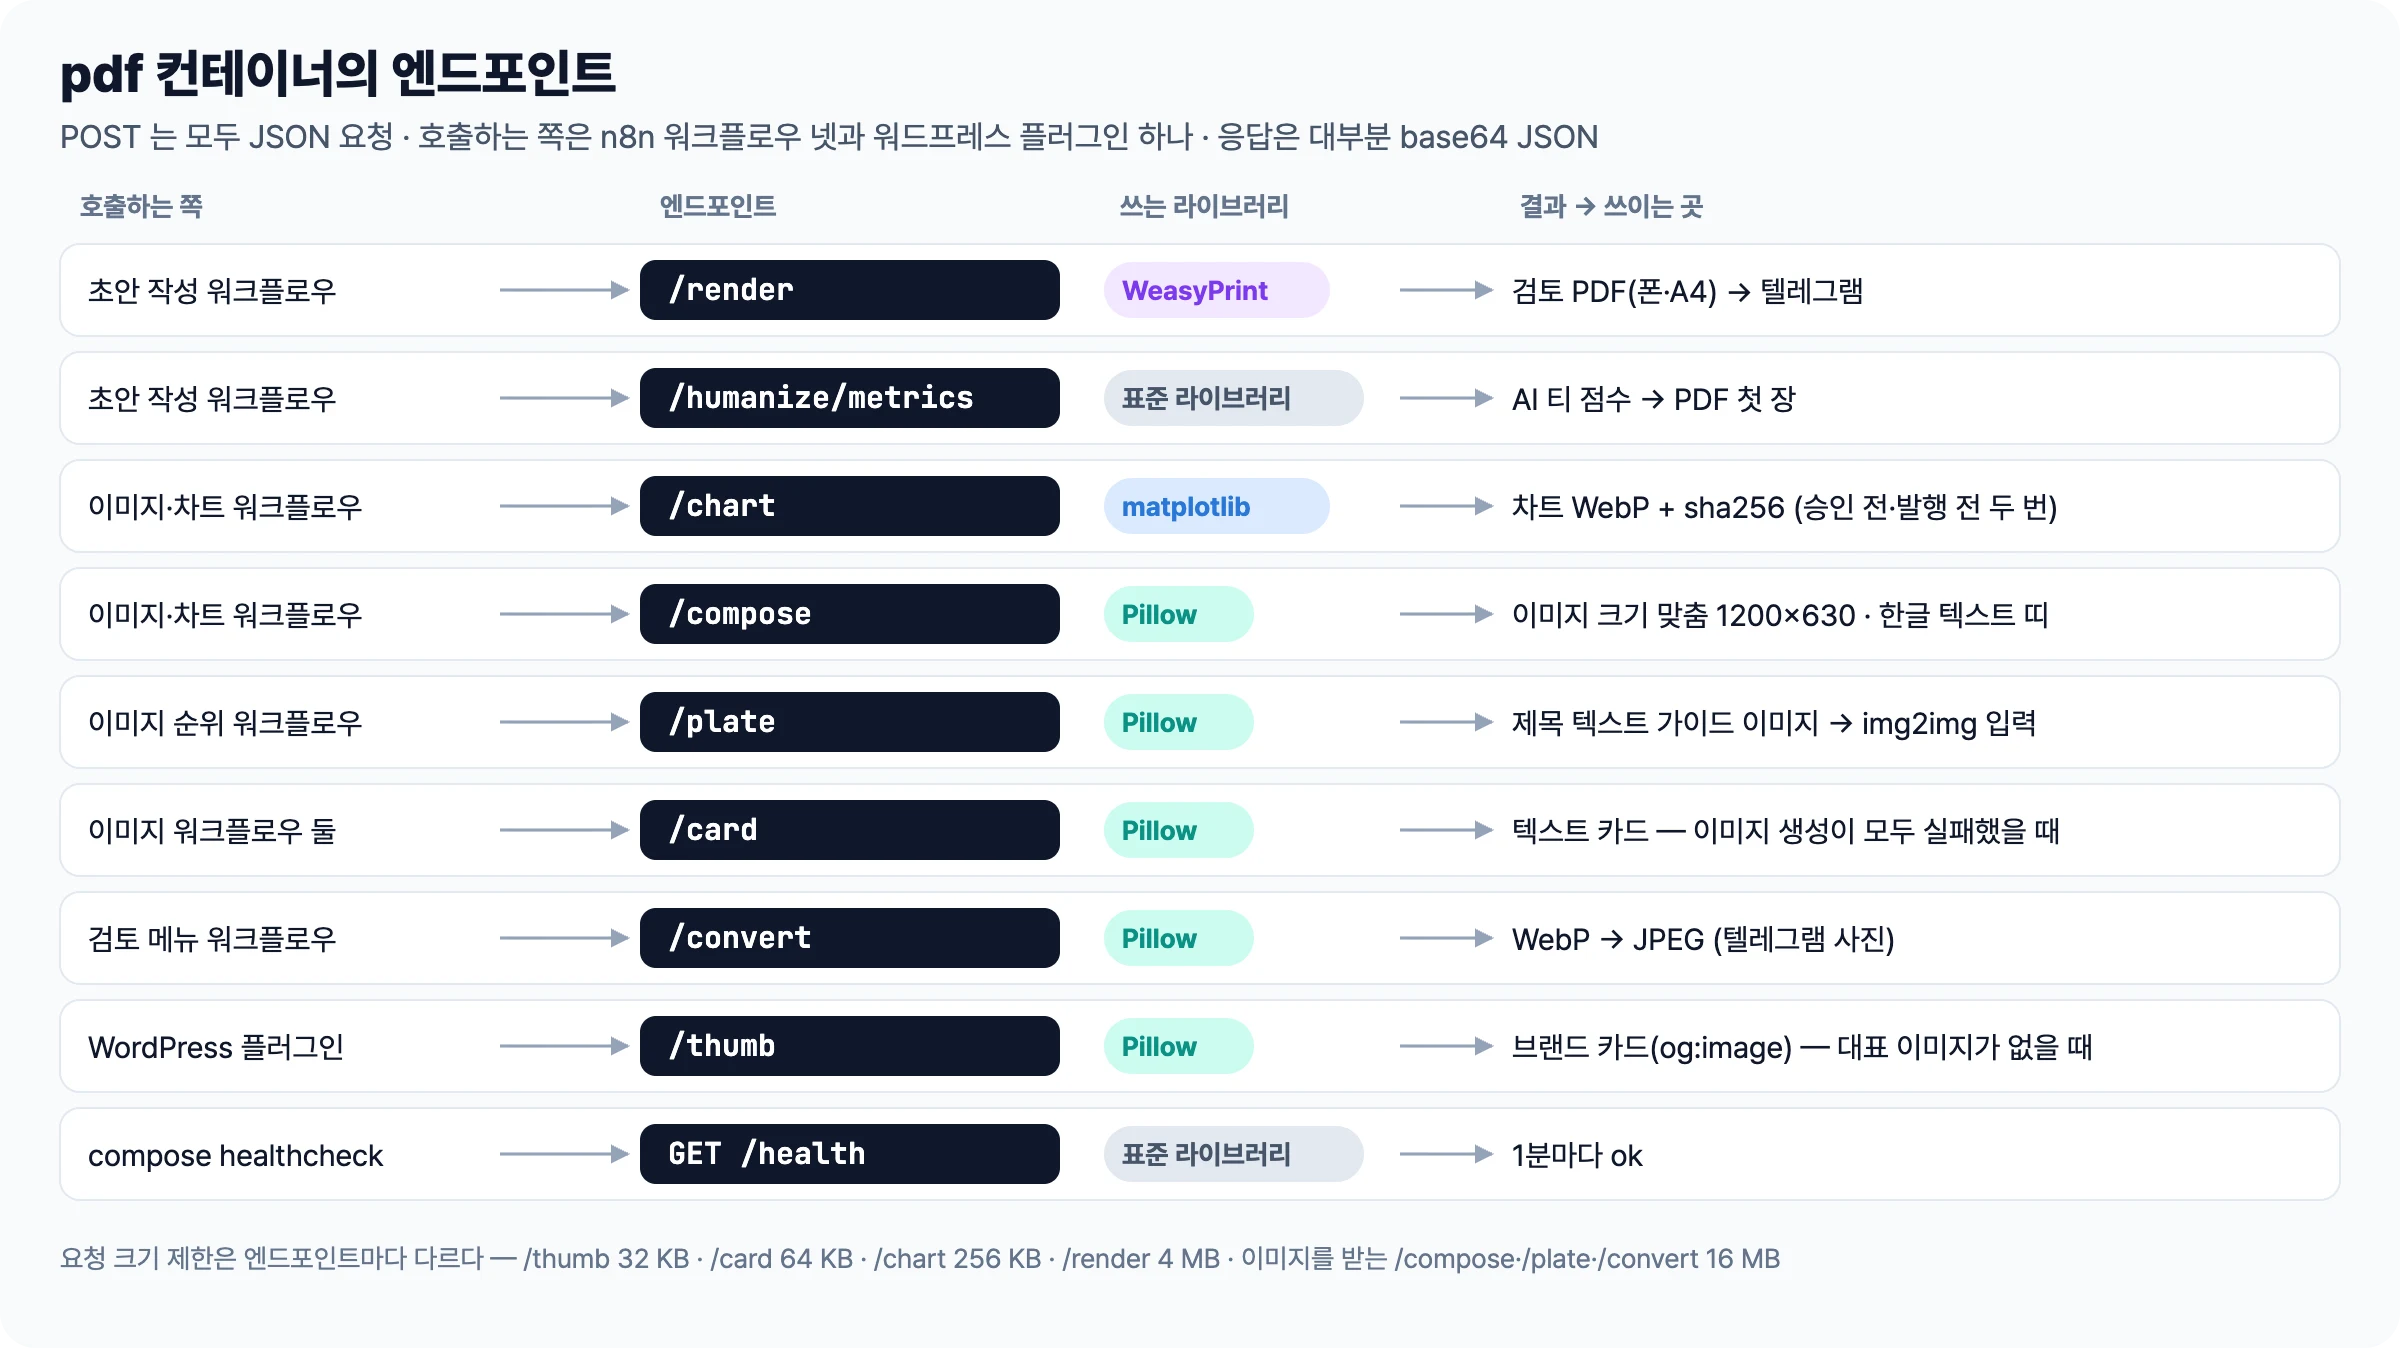
Python 컨테이너의 엔드포인트와 사용하는 라이브러리는 아래와 같다. POST 요청은 모두 JSON 으로 받는다.
표준 라이브러리만으로 만든 HTTP 서버
웹 프레임워크는 쓰지 않았다. 호출은 n8n 과 워드프레스에서만 하고 엔드포인트도 아홉 개라 http.server 의 ThreadingHTTPServer 와 BaseHTTPRequestHandler 로 충분했다. 요청 하나는 아래 순서로 처리된다.
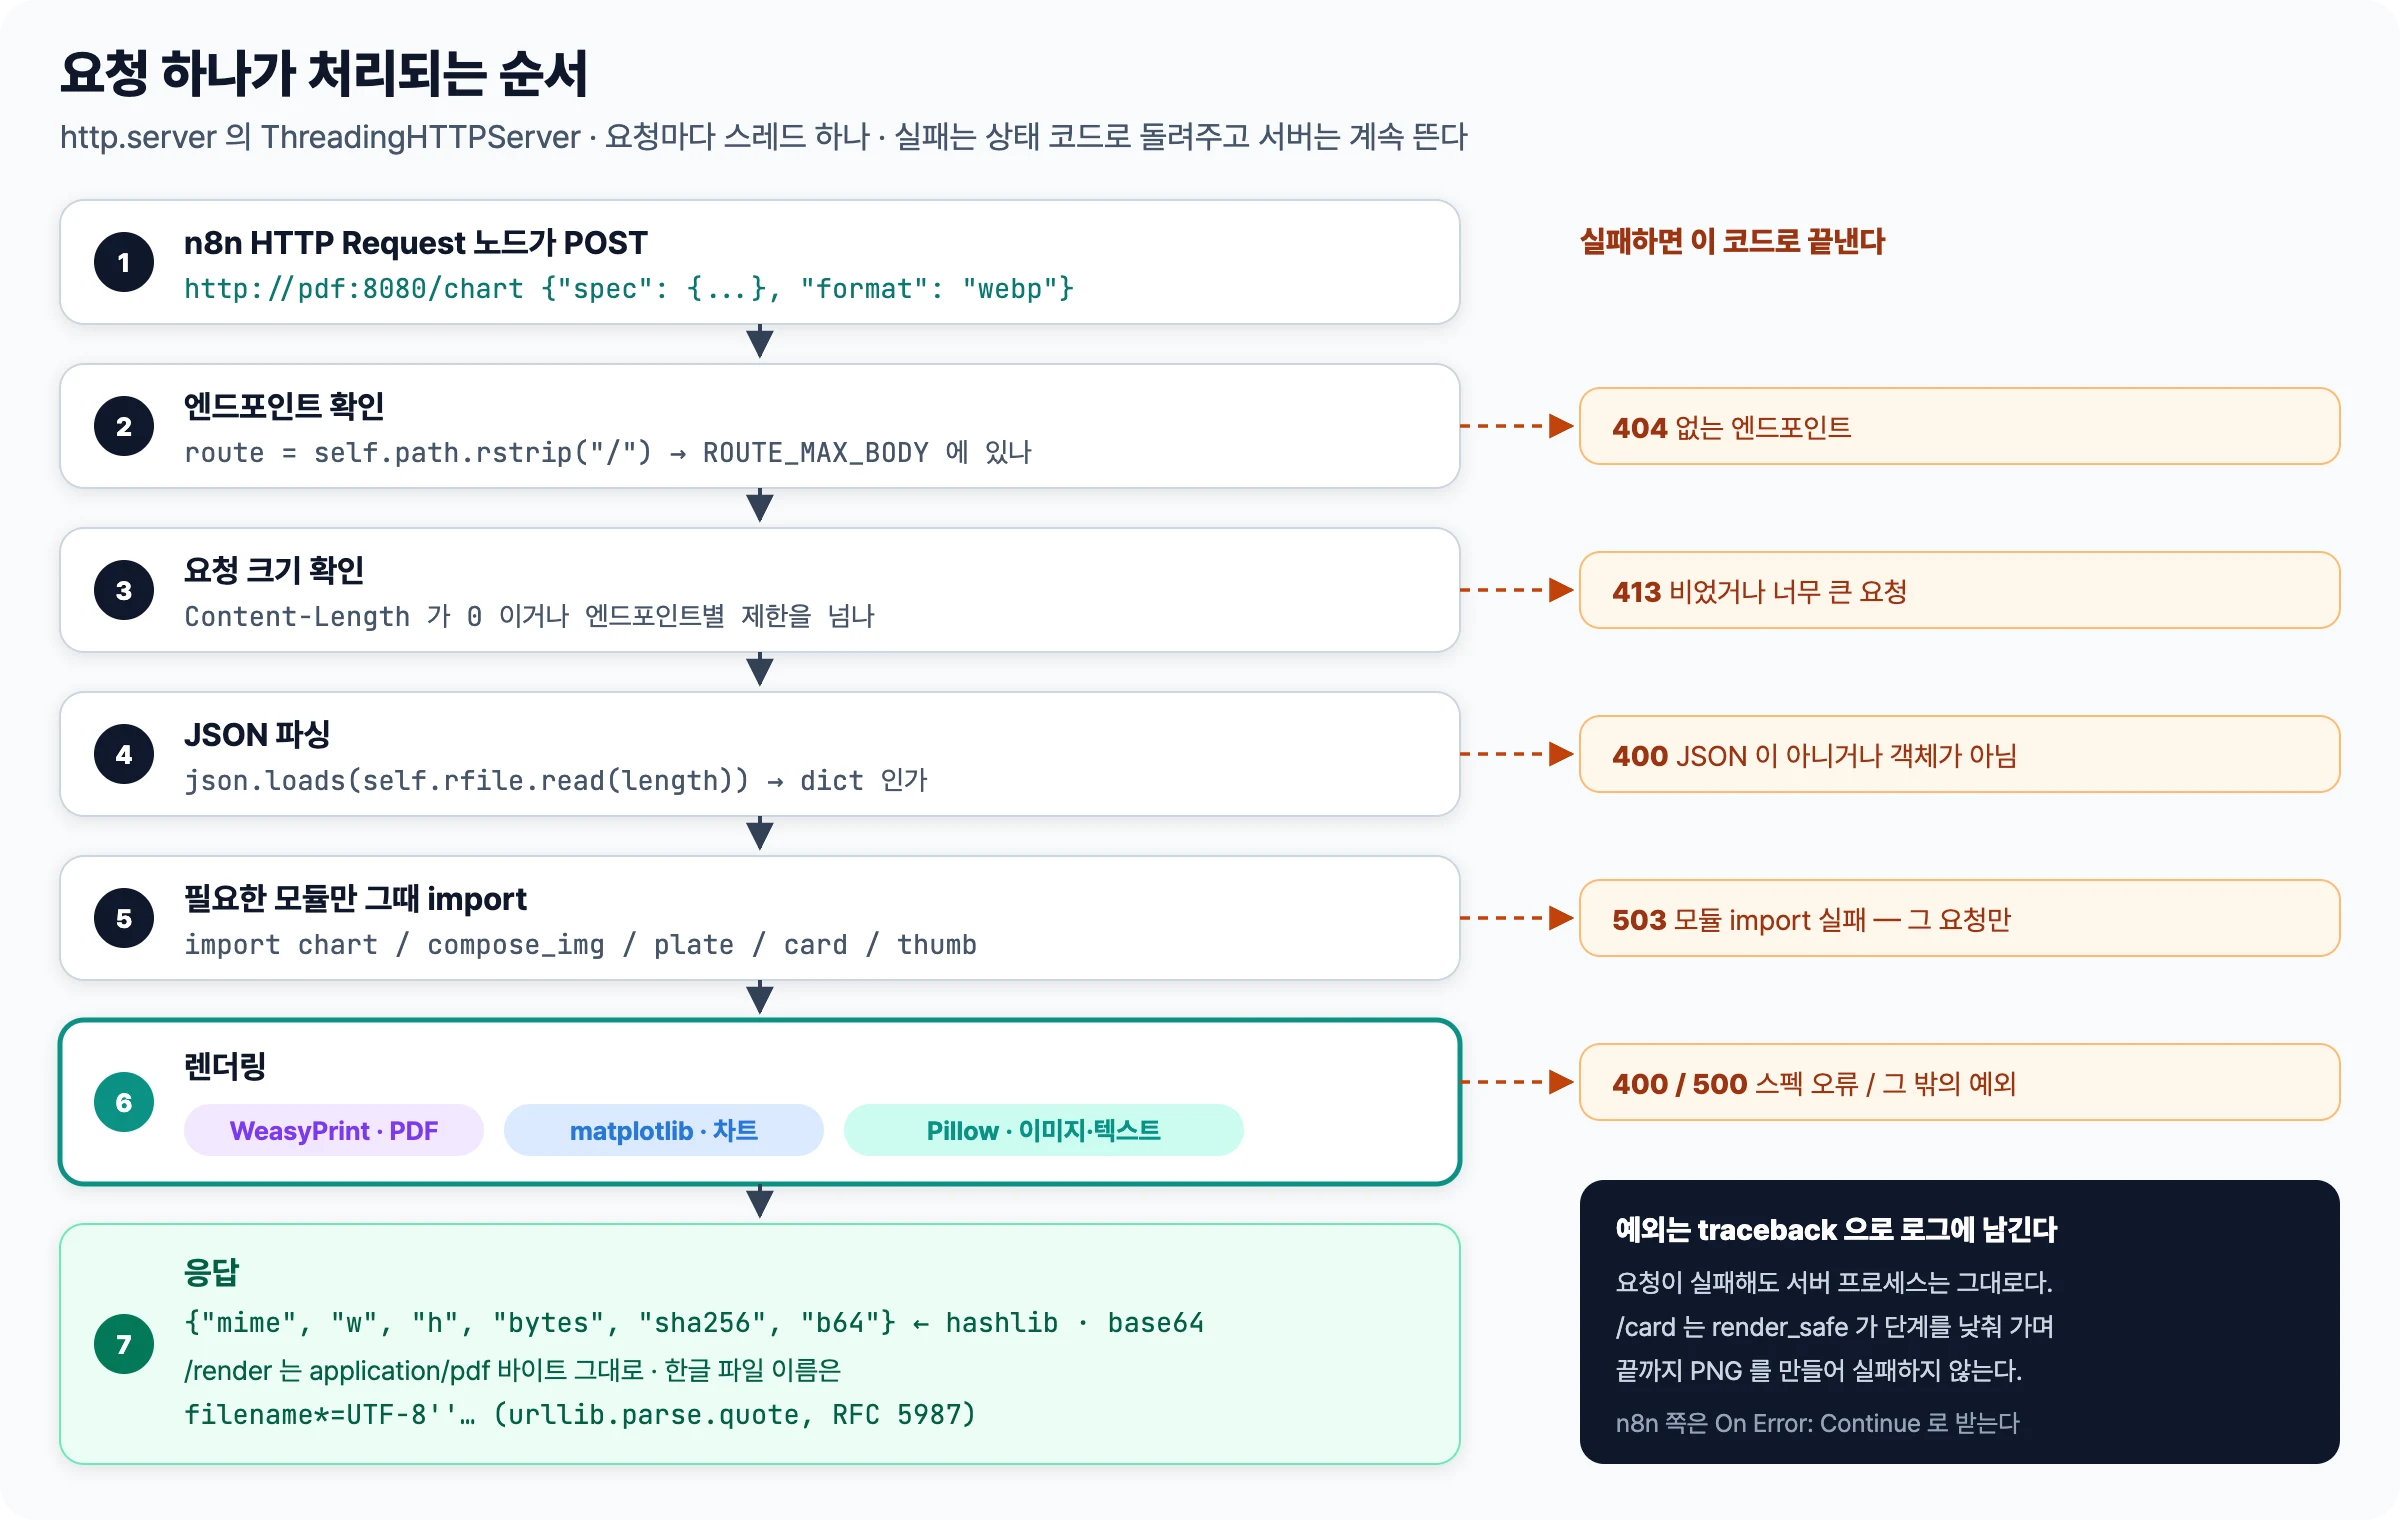
요청 크기 제한은 엔드포인트마다 따로 두는 게 원칙이다. 차트 스펙은 몇 KB 면 되지만 이미지를 base64 로 받는 엔드포인트는 정도가 16MB 가 필요하다.
ROUTE_MAX_BODY = {
    "/render": 4 * 1024 * 1024,
    "/humanize/metrics": 4 * 1024 * 1024,
    "/chart": 256 * 1024,
    "/thumb": 32 * 1024,
    "/compose": 16 * 1024 * 1024,
    "/plate": 16 * 1024 * 1024,
    "/convert": 16 * 1024 * 1024,
    "/card": 64 * 1024,
}

def do_POST(self):
    route = self.path.rstrip("/")
    if route not in ROUTE_MAX_BODY:
        self._send(404, json.dumps({"error": "not found"}))
        return
    length = int(self.headers.get("Content-Length") or 0)
    if length <= 0 or length > ROUTE_MAX_BODY[route]:
        self._send(413, json.dumps({"error": f"본문 크기가 0 이거나 {ROUTE_MAX_BODY[route]} 바이트를 넘는다"}))
        return
    payload = json.loads(self.rfile.read(length).decode("utf-8"))
Code language: Python (python)
라이브러리 모듈은 서버 시작 때가 아니라 요청을 처리할 때 import 한다. import chart 가 실패하면 그 요청만 503 을 돌려준다. matplotlib 을 추가하기 전에 만든 이미지로 컨테이너가 떠도 PDF 렌더링은 그대로 된다.
응답은 PDF 와 브랜드 카드를 빼면 JSON 이다. 이미지는 base64 로 받고 hashlib.sha256 해시값을 같이 보낸다. 검토용 PDF 에 차트를 넣으려면 data: URI 가 필요하고 워드프레스 업로드도 base64 가 다루기 편하다. 무엇보다 n8n Code 노드에서 crypto 를 쓸 수 없어서 업로드 중복을 막는 해시값을 파이썬 쪽에서 만들어 줘야 했다.
블로그 초안 검토용 PDF 를 텔레그램에 보낼 때 파일 이름에 글 제목이 보이면 좋겠다고 생각했다. Content-Disposition 의 filename= 은 ASCII 만 담을 수 있어서 RFC 5987 형식인 filename*=UTF-8'' 에 urllib.parse.quote 로 인코딩한 한글 이름을 같이 넣었다.
운영하면서 고친 것도 있다. 리눅스 커널은 PID 1 에 기본 동작(종료)을 적용하지 않아서 PID 1 로 실행되는 python3 는 SIGTERM 핸들러가 없으면 종료 시그널을 무시한다. 그 바람에 컨테이너를 재시작할 때마다 10초를 기다린 뒤 SIGKILL(종료 코드 137)로 끝났고 렌더링 중이던 요청이 끊겼다. compose 에 init: true 를 넣어 catatonit 이 PID 1 을 맡게 하자 0.1~0.2초 만에 종료됐다. 또 소스 폴더는 컨테이너에 디렉터리째 마운트하고 style.css 는 요청마다 다시 읽는다. CSS 는 고치면 바로 반영되지만 .py 는 파이썬이 처음 import 한 모듈을 계속 써서 컨테이너를 재시작해야 한다.
외부와 격리된 네트워크에 둔다
이 컨테이너는 compose 의 private 네트워크에만 연결돼 있다. internal: true 로 만든 네트워크라 외부로 나갈 수도, 외부에서 들어올 수도 없다. 호출하는 쪽도 같은 네트워크의 n8n 과 워드프레스뿐이라 인증을 따로 두지 않았다. nginx 에는 연결하지 않는다. 연결하면 누구나 쓸 수 있는 이미지 생성 서버가 된다.
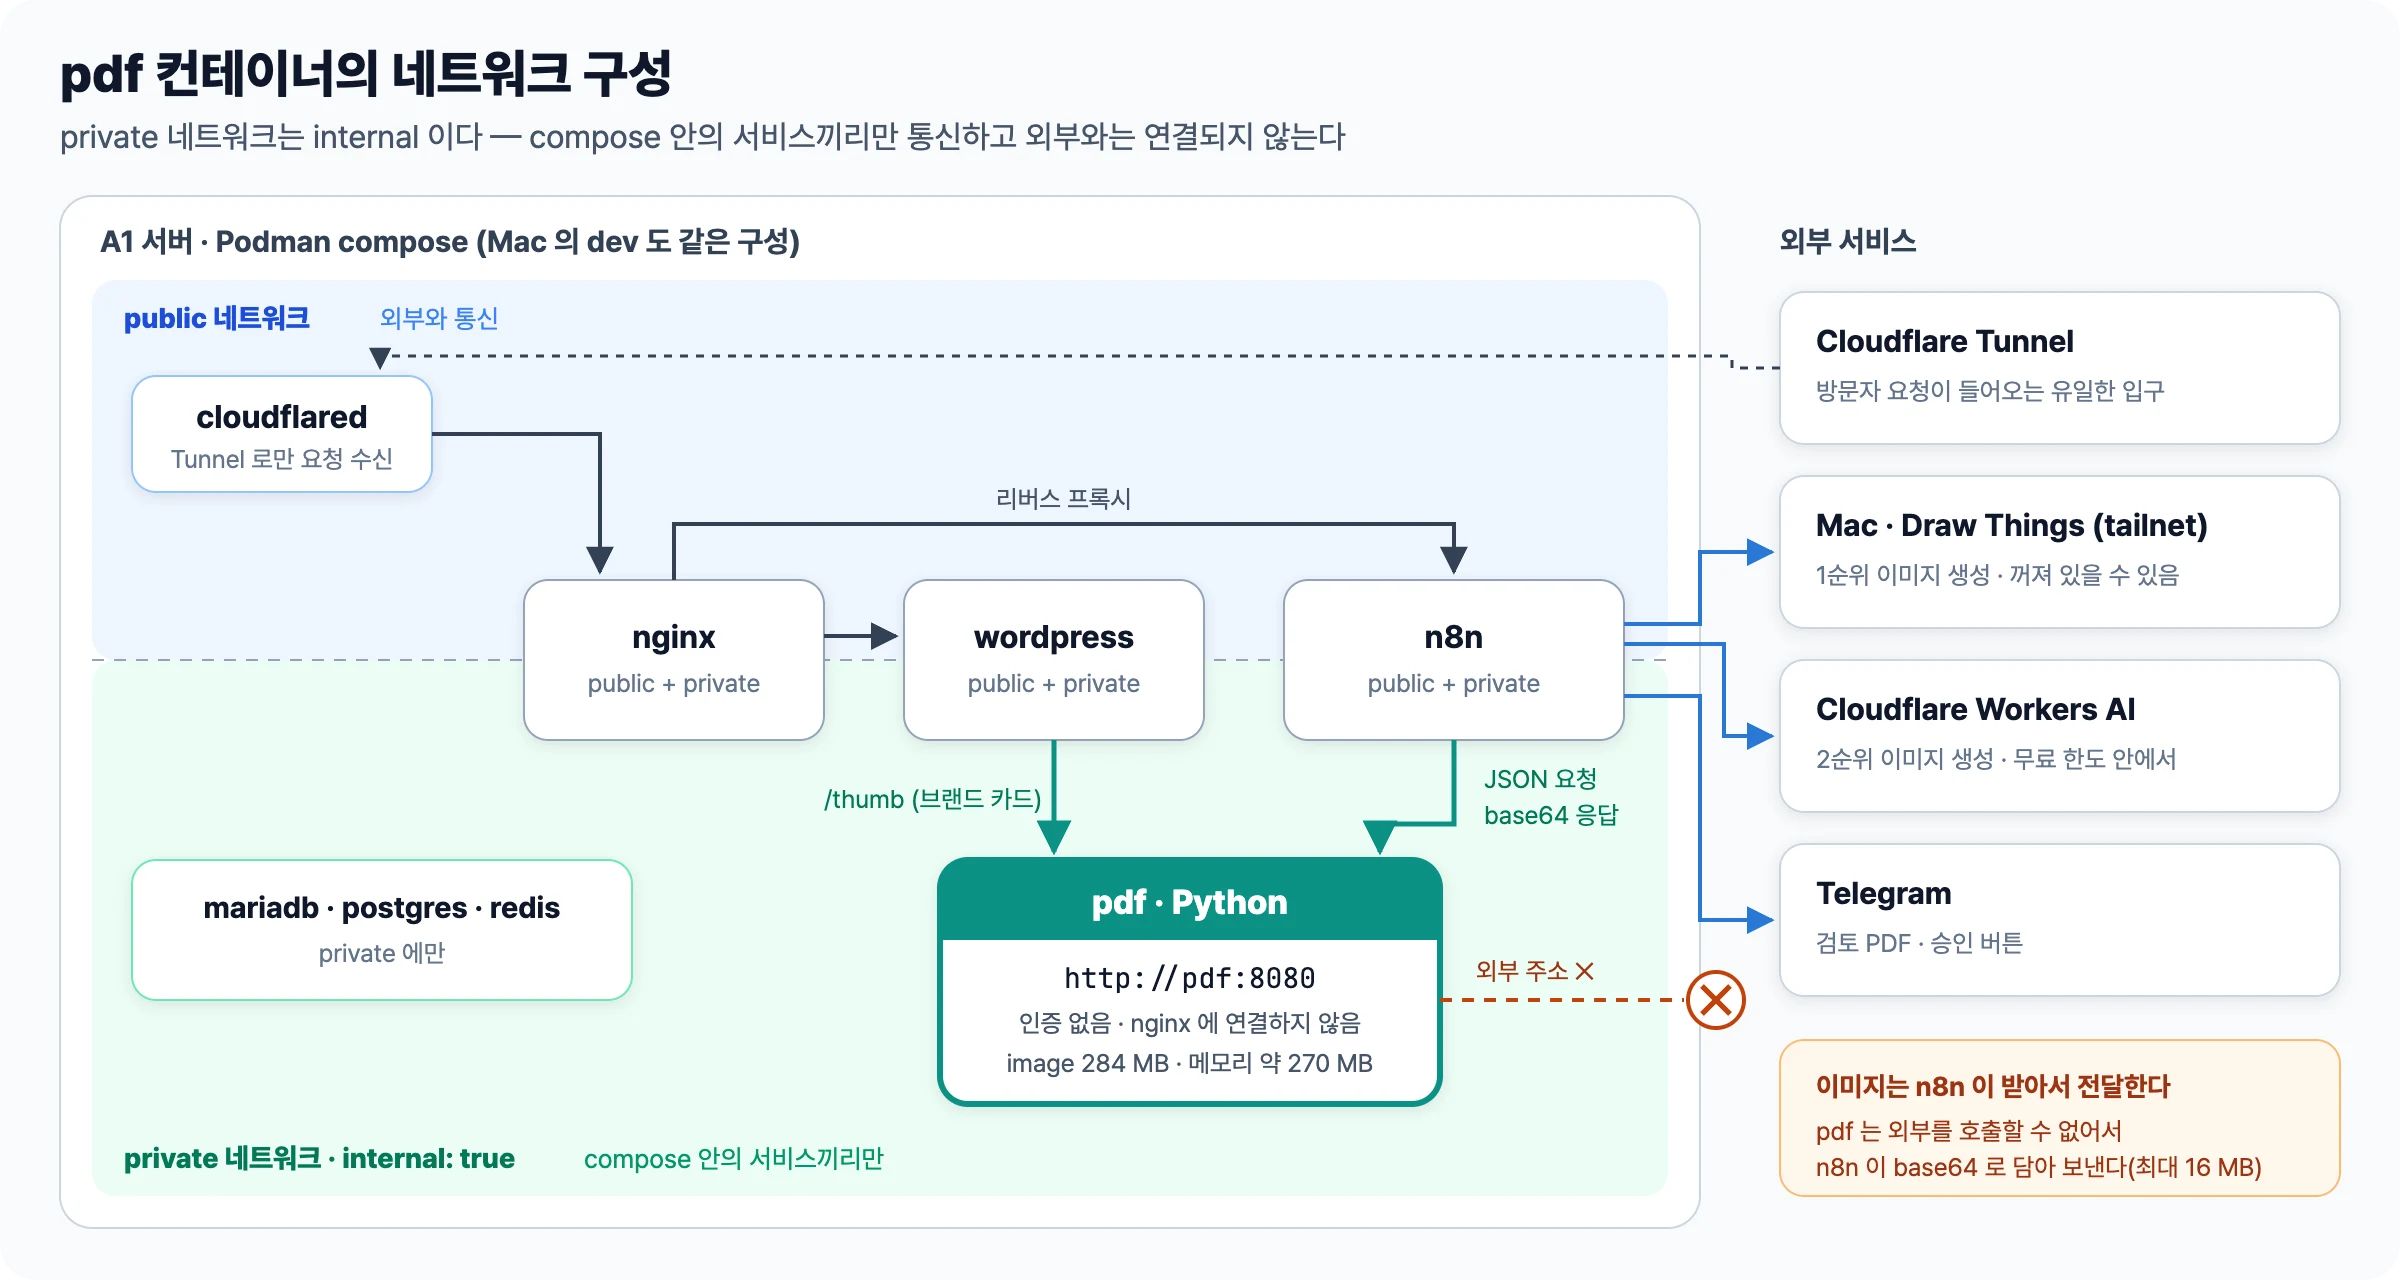
외부 주소를 호출할 수 없으니 이미지도 직접 받아 올 수 없다. Draw Things 나 Cloudflare Workers AI 가 만든 이미지는 n8n 이 받아서 base64 로 전달 해준다.
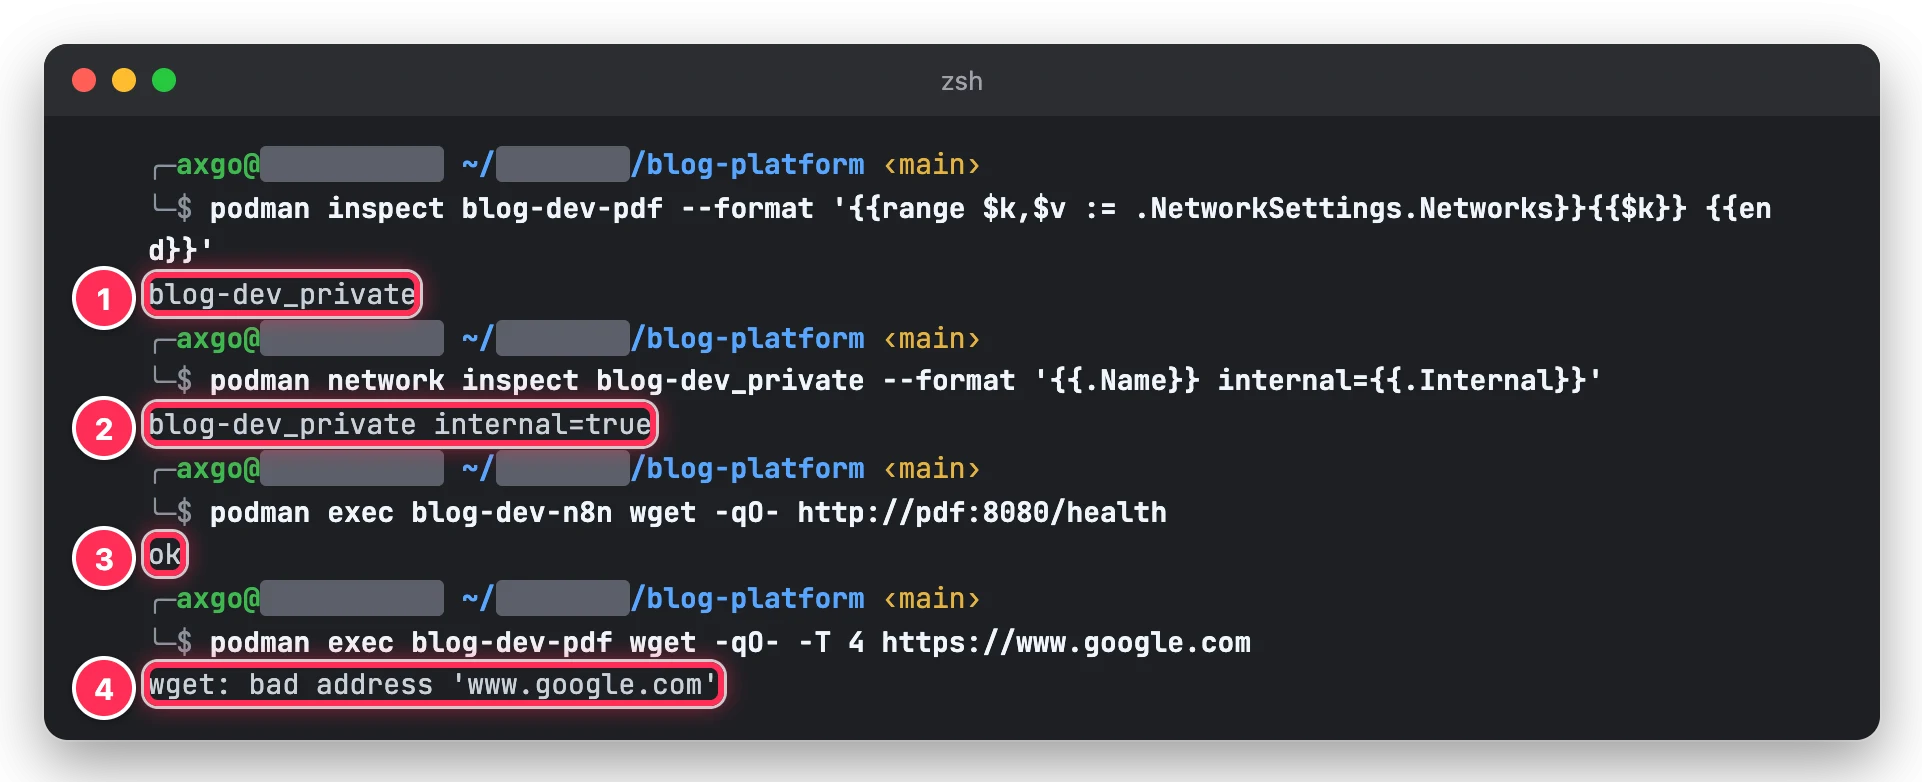
② 이 네트워크는 internal
③ n8n 컨테이너에서는 http://pdf:8080 호출이 된다
④ pdf 컨테이너에서는 외부 도메인 이름조차 조회되지 않는다
WeasyPrint 로 휴대폰용 초안 검토 PDF 만들기
n8n 이 작성한 초안은 텔레그램으로 승인 요청을 받게 해두었다. 승인 버튼을 누르기 전에 글을 끝까지 읽어야 한다. 매번 워드프레스에 로그인해 미리보기를 여는 건 번거로워서 초안을 PDF 로 만들어 같이 보낸다.
처음엔 A4 로만 보내다가 바로 휴대폰용 PDF를 추가했다. PDF 뷰어는 페이지 폭을 화면 폭에 맞춘다. 210mm 짜리 A4 를 폭 71mm 정도인 휴대폰 화면에 띄우면 0.34배로 줄어들어 10.5pt 본문이 3.5pt 처럼 보인다. 폰트를 키워서는 해결이 안 돼서 페이지 크기를 92mm 폭으로 줄였다. 지금은 11.5pt 본문이 8.9pt 정도로 보인다. WeasyPrint 는 CSS 의 @page 로 페이지 크기를 정하므로 프리셋별 값을 딕셔너리에 두고 CSS 를 만들어 붙인다.
PAGE_PRESETS = {
    # 92mm 폭 → 폰에서 배율 0.77, 11.5pt 가 실효 8.9pt 로 보인다.
    "phone": {"size": "92mm 164mm", "margin": "9mm 7mm 8mm 7mm",
              "body": "11.5pt", "line": "1.72", "h1": "15pt", "h2": "12.5pt", "h3": "11.5pt",
              "table": "7.4pt", "grid": "44pt"},
    "a4": {"size": "A4", "margin": "16mm 15mm 14mm 15mm",
           "body": "10.5pt", "line": "1.8", "h1": "17pt", "h2": "13pt", "h3": "11.5pt",
           "table": "9pt", "grid": "52pt"},
}
Code language: Python (python)
본문 HTML 은 LLM 이 쓴 것이라 그대로 믿을 수 없다. WeasyPrint 는 <img> 나 @import 에 적힌 주소를 직접 가져온다. 이 기능을 그대로 두면 내부 주소를 호출하는 데 악용될 수 있어서(SSRF) url_fetcher 를 바꿔 data: URI 말고는 모두 막았다.
def blocked_fetcher(url, *args, **kwargs):
    if url.startswith("data:"):
        from weasyprint.urls import default_url_fetcher
        return default_url_fetcher(url, *args, **kwargs)
    raise URLFetchingError(f"외부 리소스 차단: {url[:80]}")

pdf = HTML(string=build_document(payload), base_url=None,
           url_fetcher=blocked_fetcher).write_pdf()
Code language: Python (python)
한글 폰트는 CSS 에 font-family: "Noto Sans CJK KR" 만 적으면 된다. WeasyPrint 가 fontconfig 로 시스템 폰트를 찾으니 @font-face 를 따로 쓸 필요가 없다. 한글 폰트가 PDF 에 서브셋으로 들어가서 본문이 몇 줄뿐이어도 파일이 264KB 정도 된다.
표를 table-layout: fixed 로 균등하게 나눴더니 6025792 같은 긴 금액이 칸을 넘겨 두 줄로 잘려 보이는 문제가 있었다. 특히 투자 글에서 숫자가 잘리면 안 돼서 table-layout: auto 와 overflow-wrap: break-word 로 바꿨다. 숫자는 한 줄에 그대로 남고 긴 한글 단어만 줄바꿈된다. viewBox 만 있고 width 가 없는 인라인 SVG 도 문제였다. 브라우저에서는 멀쩡한데 WeasyPrint 에서는 기본 크기로 그려져 오른쪽이 잘렸다. max-width: 100%; height: auto 를 넣어 해결했다.
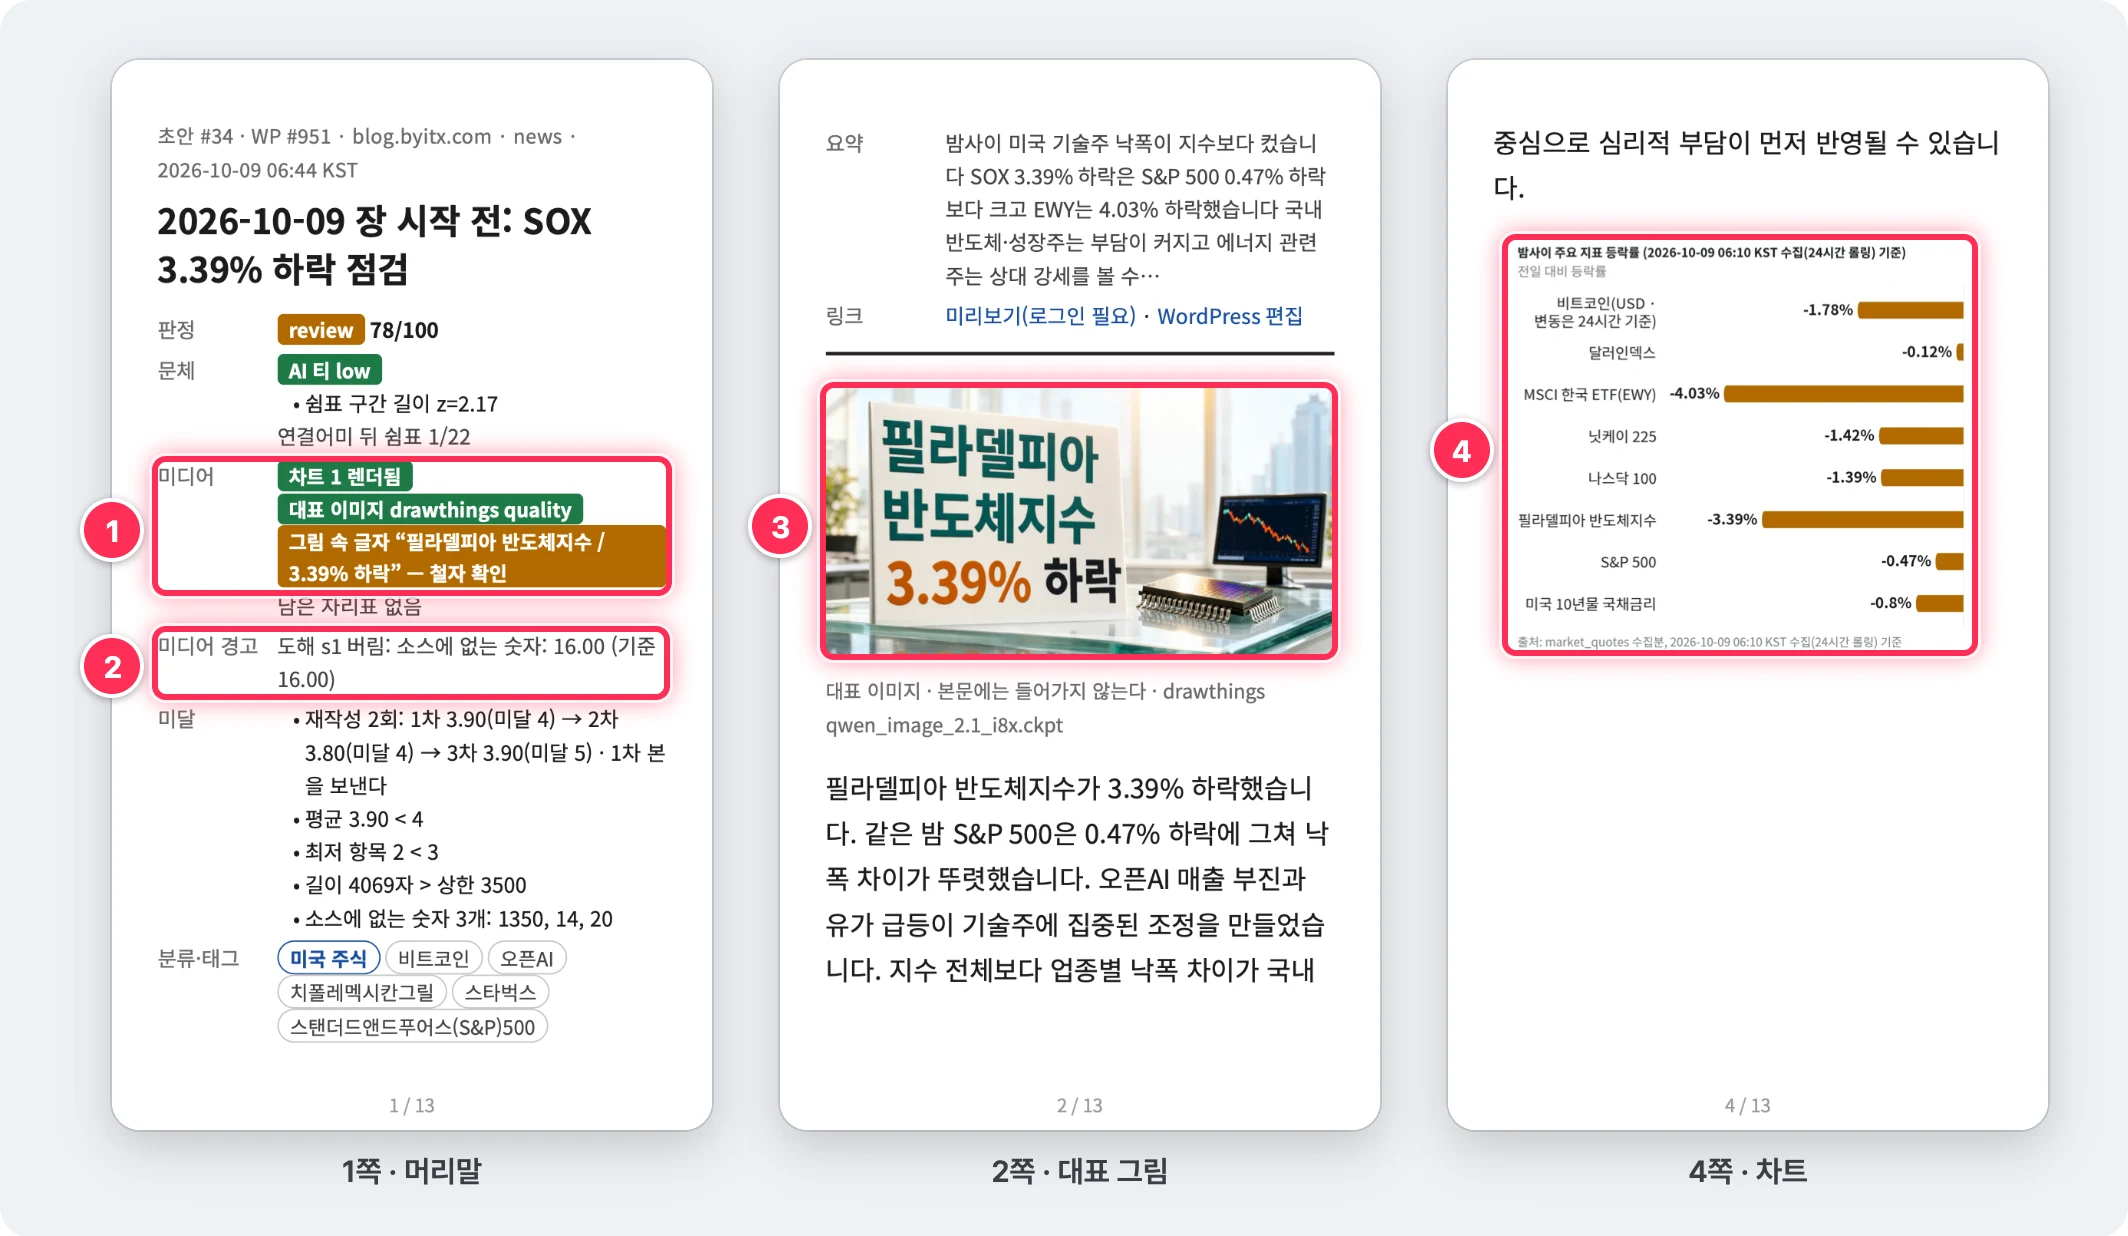
① 미디어 정보 — 차트 1개 렌더링, 대표 이미지를 만든 곳(Draw Things), 이미지 속 텍스트 철자 확인 요청
② 미디어 경고 — 출처 자료에 없는 숫자가 들어간 다이어그램은 뺐다
③ 대표 이미지 — 제목은 Pillow 로 만든 텍스트 가이드 이미지를 바탕으로 Local Draw Things에서 그렸다
④ matplotlib 으로 그린 차트.
로컬에서 짧은 HTML을 PDF로 렌더링하는데 96ms 가 걸렸다. OCI A1(2CPU,12G)에서 차트 1개를 포함해 이미지가 다섯 장을 포함하는 휴대폰용과 PC용(A4) PDF 두 장을 만드는 데 3.28초가 걸렸다. 이미지가 Data URI 로 들어가니 PDF 의 크기가 커져 PDF 하나가 3.5MB 쯤 됐다.
matplotlib 으로 한글 차트 그리기
시장 지표나 공시를 다루는 글은 숫자가 많아서 표보다 막대 차트가 눈에 빨리 들어온다. 차트의 숫자는 LLM 이 만들지 않는다. 수집해 둔 데이터로 코드가 스펙을 만들고 matplotlib 은 받은 값을 그리기만 하도록 했다.
서버 환경이라 백엔드는 Agg 로 고정하고 MPLCONFIGDIR=/tmp/mpl 을 지정했다. matplotlib 은 홈 디렉터리에 폰트 캐시를 만든다. 소스 폴더가 읽기 전용 마운트라 캐시를 저장할 수 없으면 호출할 때마다 경고를 내고 느려진다.
Alpine 의 Noto CJK 는 한(K)·중(C)·일(J) 폰트가 한 파일에 들어 있는 TTC 인데, matplotlib 은 TTC 에서 첫 번째 폰트만 읽어 Noto Sans CJK JP 라는 이름으로 등록한다. 처음엔 KR 폰트를 따로 뽑아야 하나 고민했지만 한글 글리프는 JP·KR·SC·TC 가 모두 같고 다른 건 한자 모양뿐이다. 차트에 들어가는 글자는 한글과 숫자뿐이라 그대로 사용했다.
같은 스펙으로 다시 그린 차트는 바이트 단위로 같아야 했다. matplotlib 은 PNG 메타데이터에 자기 버전 문자열을 기록한다. 이 값을 비우지 않으면 패키지가 업데이트될 때 아무 경고 없이 해시값이 바뀐다. 음수 부호도 유니코드 마이너스(U+2212) 대신 하이픈을 쓰게 했다. 한글 폰트에 이 글자가 없어서 네모 칸으로 나온다.
matplotlib.rcParams.update({
    "font.family": _FAMILY,
    "axes.unicode_minus": False,
    # (색·격자 설정 생략)
})

fig.savefig(buf, format="png", dpi=DPI, metadata={"Software": None})
Code language: Python (python)
PNG 는 Pillow 로 WebP 변환을 해주도록 했다. 이 변환도 매번 같은 결과가 나오도록해 승인 전(검토용 PDF)과 발행 직전에 두 번 렌더링해도 이미지가 달라지지 않는다. 아래는 pdf 컨테이너에 같은 요청을 두 번 보내 본 결과다.
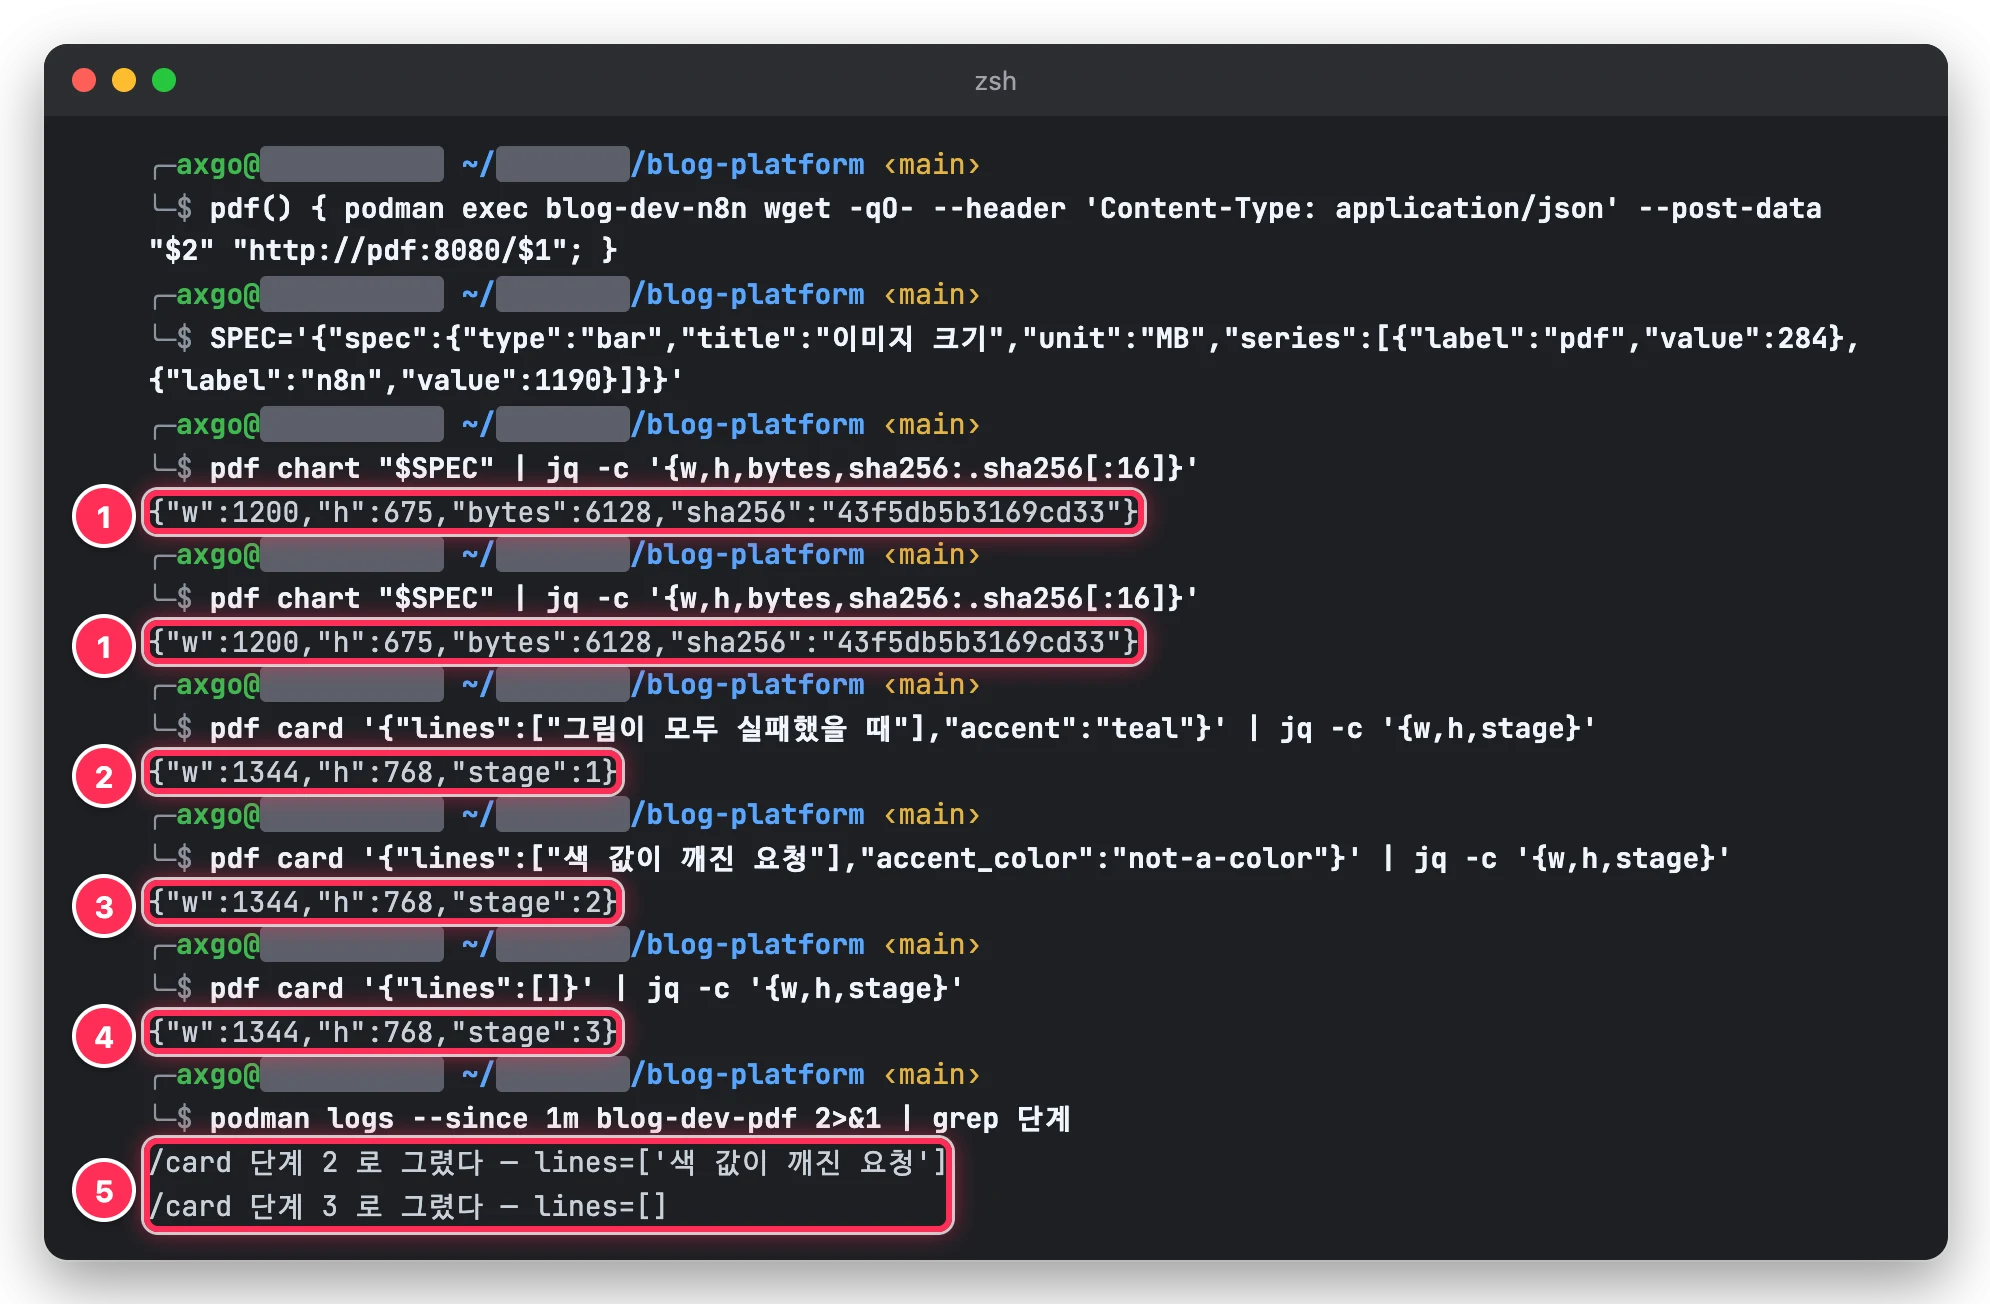
① 같은 차트 생성 요청을 두 번 보내면 sha256 이 같다
② 텍스트 카드 정상 요청은 1단계
③ 색상 값이 잘못된 요청은 2단계
④ 텍스트가 빈 요청은 3단계(byitx)
⑤ 몇 단계에서 그렸는지 pdf 로그에 남는다.
matplotlib 은 이미지 밖으로 나간 텍스트를 잘라 주지도, 경고해 주지도 않는다. 긴 제목은 그냥 밖으로 사라지고 120,050USD 같은 긴 눈금 라벨은 왼쪽이 잘린다. 그래서 텍스트 폭을 미리 계산해서 폰트 크기를 줄이고 그래도 안 들어가면 말줄임표로 자른다. 폭은 한글이 폰트 크기와 거의 같고 영문·숫자는 절반 정도라는 점을 이용해 대략 잡는다.
def _fit(text, pt, max_px):
    size = pt
    while size > pt * 0.7 and _text_px(text, size) > max_px:
        size -= 1
    if _text_px(text, size) <= max_px:
        return text, size
    cut = text
    while len(cut) > 4 and _text_px(cut + "…", size) > max_px:
        cut = cut[:-1]
    return cut + "…", size
Code language: Python (python)
여백처럼 정확해야 하는 곳은 근삿값 대신 get_window_extent() 로 렌더러가 잰 실제 폭을 쓴다. 차트는 휴대폰용 PDF 에서 0.246배로 줄어드니 텍스트는 1200px 기준 34px 아래로 내리지 않고 값은 축 눈금 대신 막대 끝에 직접 적었다.
Python Pillow 로 이미지에 한글 넣기
대표 이미지는 로컬 Mac 의 Draw Things 로 만든다. 영어 텍스트는 잘 쓰는데 한글은 두 글자도 틀린다. Qwen-Image 2512 에 “급등" 을 요청하면 "김동” 이 나왔고 “거래량 급증" 은 “거라왕 굼층” 이 됐다. FLUX.2 Klein 9B 도 “급등" 을 "끅딍" 으로 썼다. 스텝을 다섯 배로 늘려도 "급" 의 받침은 한 번도 “ㅂ” 으로 나오지 않았고 한글 폰트 LoRA 를 붙여도 마찬가지였다. 이미지 생성모델은 자모를 조합하는 규칙을 모르는 거라(낫놓고 기역자도 모른다) 설정와 프롬프트로는 해결할 수 없었다. 멀리서 보면 그럴듯한 한글처럼 보여서 더 문제다.
그래서 이미지 생성 모델에는 텍스트 없는 이미지만 맡기고 한글은 Pillow 가 Noto CJK 폰트로 렌더링한다. matplotlib 과 달리 Pillow 의 ImageFont.truetype() 은 TTC 안의 폰트를 index 로 고를 수 있다. 다만 인덱스 순서가 빌드마다 달라서 이름에 KR 이 들어간 폰트를 찾는다.
def face(path, size):
    for idx in range(0, 10):
        try:
            font = ImageFont.truetype(path, size, index=idx)
        except Exception:
            break
        try:
            name = " ".join(str(part) for part in font.getname())
        except Exception:
            name = ""
        if "KR" in name and "Mono" not in name:
            return font
    return ImageFont.truetype(path, size, index=0)
Code language: Python (python)
텍스트를 강조해서 굵게 보이려고 stroke_width 로 외곽선을 넣었다가 실패한 적도 있다. Noto CJK 의 획이 촘촘한 음절은 74px 에서 1px, 130px 에서 2px 만 줘도 "ㅌ", "ㄹ", "ㅎ"이 들어가는 경우 틀·를·률·흘 의 안쪽이 메워져 네모 덩어리가 됐다. 그 뒤로 Qwen Image 에 넘기는 제목은 외곽선 두께를 0 으로 두도록 했다.
대표 이미지 제목은 Pillow 로 RGBA 이미지(/plate)를 만들어 Draw Things 의 img2img 에 넘긴다. 이 이미지는 제목 부분만 불투명하고 나머지는 투명하다. 모델은 투명한 곳에 장면을 그리면서 이 텍스트를 가이드 삼아 다시 그린다. 제목을 비스듬하게 놓을 때는 Image.transform() 의 PERSPECTIVE 변환을 쓴다. 출력 좌표를 입력 좌표로 바꾸는 계수 8개를 넘겨야 해서 네 모서리 좌표로 방정식을 세우고 numpy 의 linalg.solve 로 계수를 구했다. 어려운 제목 네 개로 비교했을 때 프롬프트만 바꾼 쪽은 48장 중 단 7장, 텍스트 가이드 이미지를 준 쪽은 12장 중 9장이 정확했다.
생성 모델마다 출력 크기가 다르게 올 수 있어서 대표 이미지는 1200×630, 본문 이미지는 1200×675 로 맞춘다. 비율을 맞추려면 확대한 뒤 가운데를 잘라 낸다. 정사각형을 1.91:1 로 자르면 세로의 47% 가 날아간다. 잘리는 비율이 34%를 넘으면 흐리게 확대한 사본을 배경에 깔고 원본을 그 안에 온전히 넣는다.
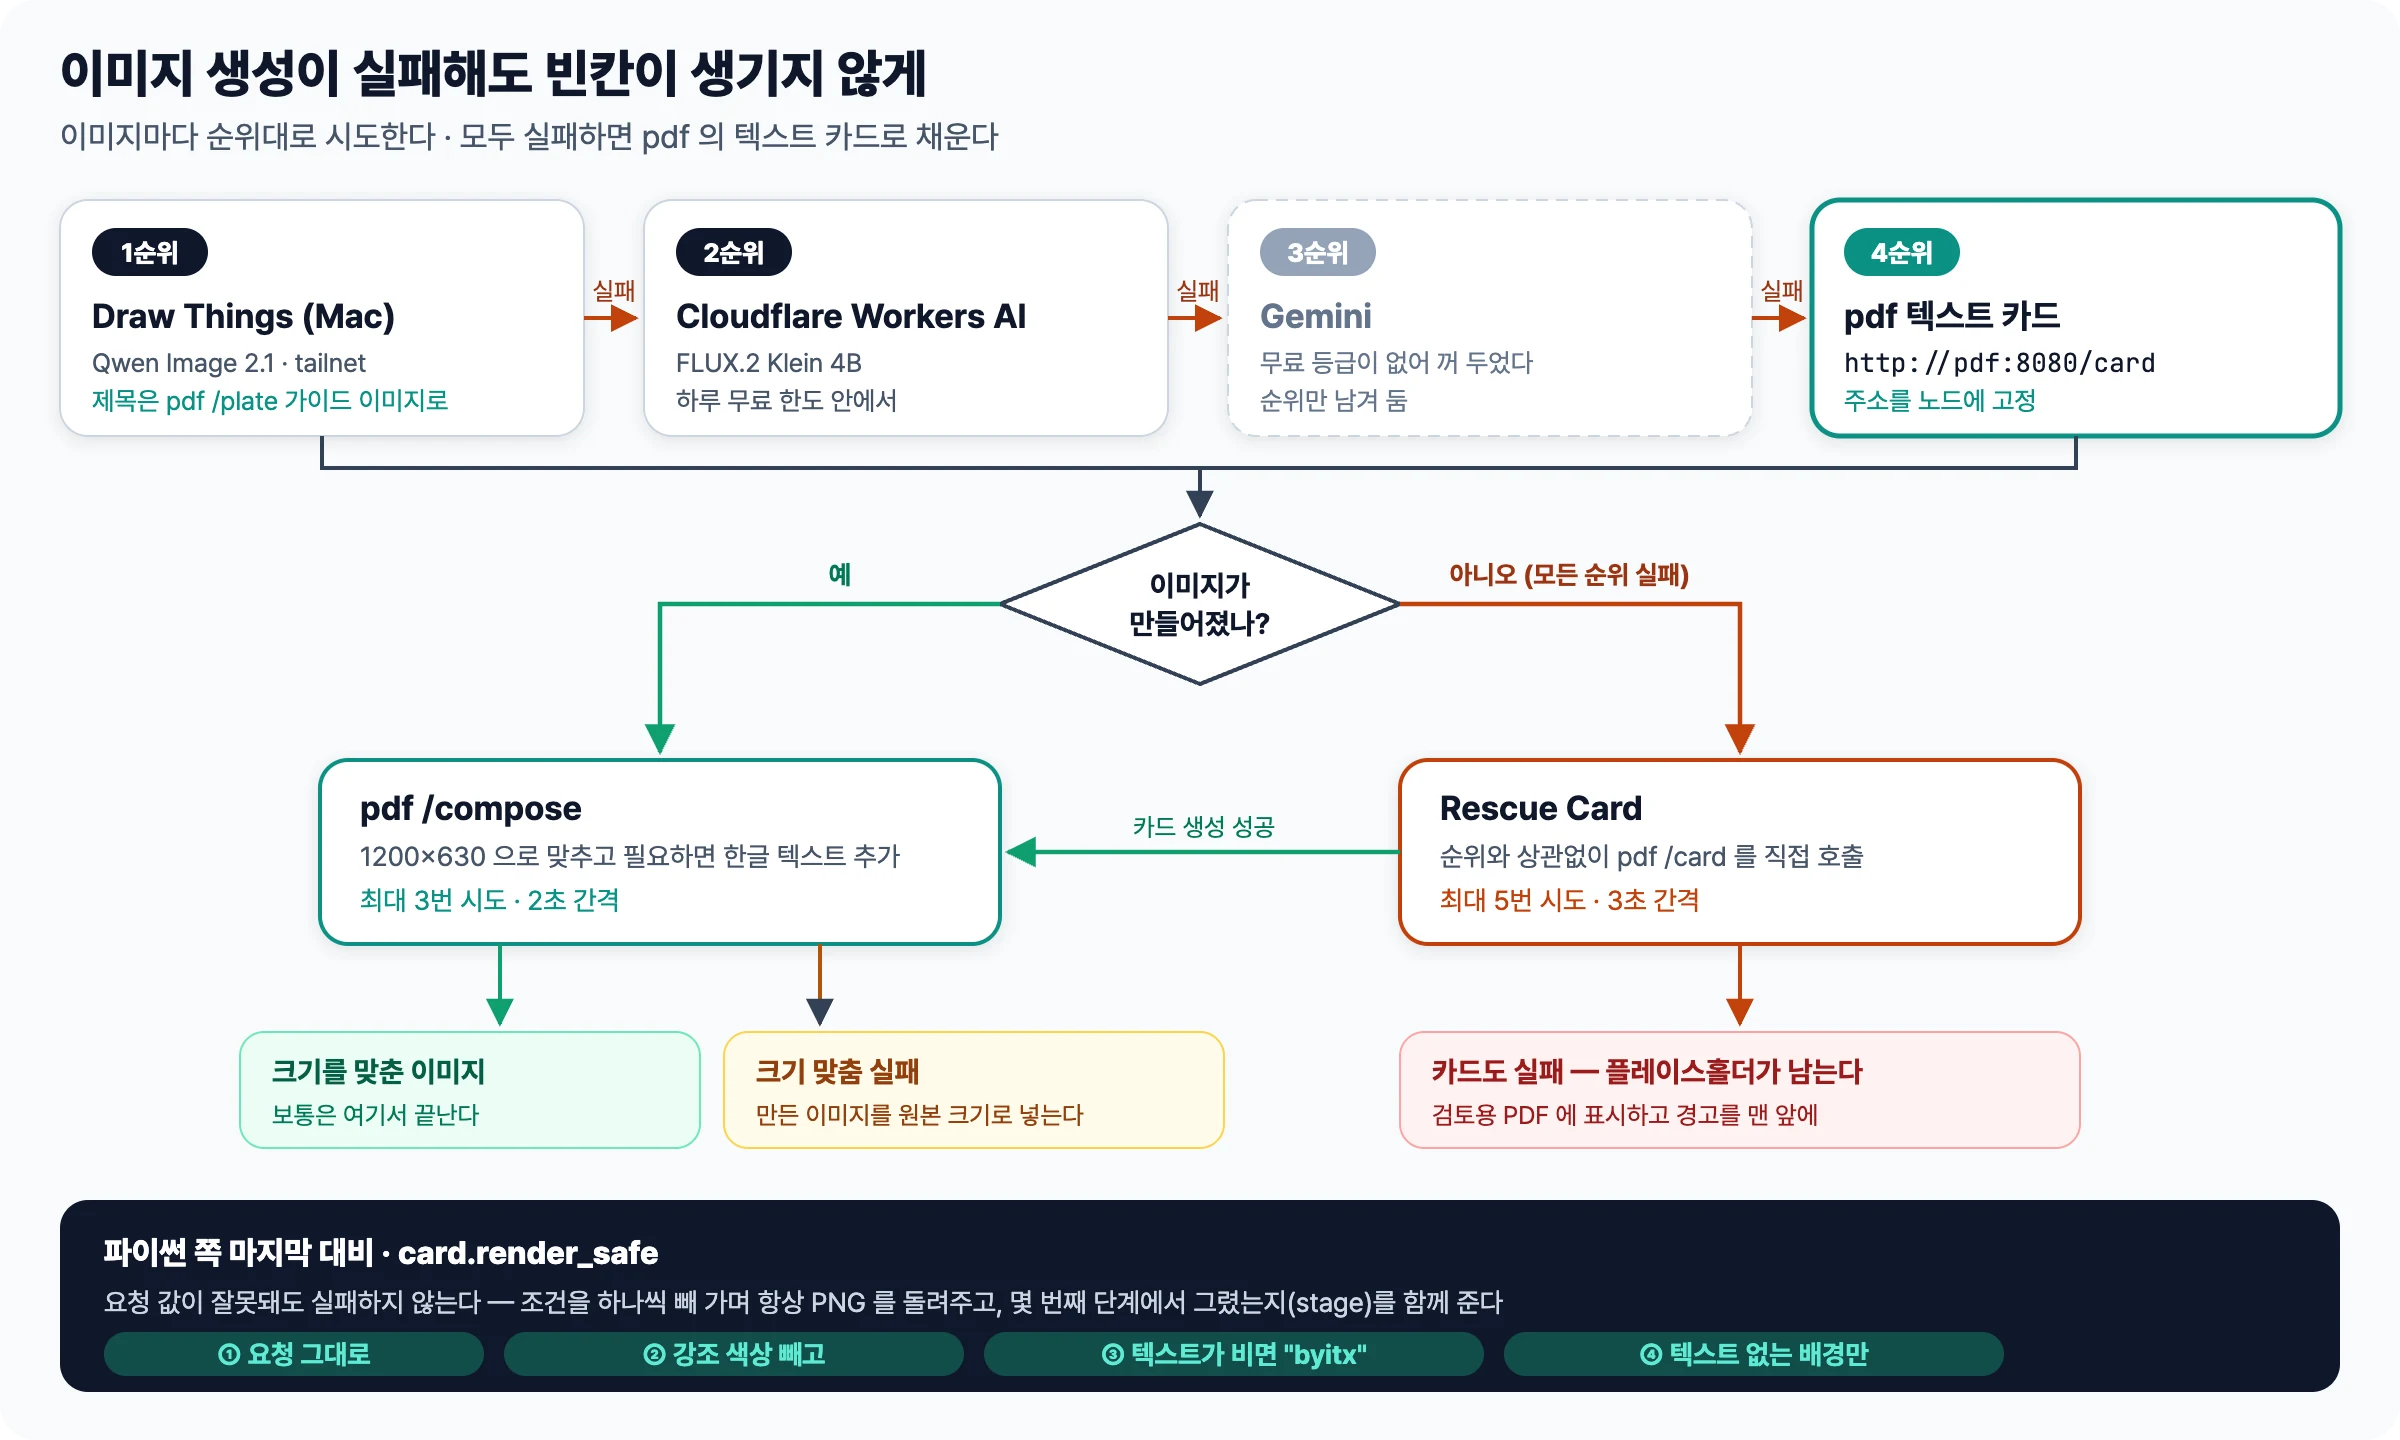
텍스트 카드(/card)는 이미지 생성이 모두 실패했을 때 쓰는 마지막 단계라서 실패하면 안 된다. 요청 값이 잘못돼도 조건을 하나씩 빼 가며 끝까지 PNG 를 만들도록 했다.
def render_safe(lines, accent_word="", accent_color=None, accent="blue", slug="", subject_words=None, subject_color=None):
    clean = [str(x).strip() for x in (lines or []) if str(x).strip()]
    tries = [
        lambda: render(clean, accent_word, accent_color, accent, slug, subject_words, subject_color),
        lambda: render(clean, "", None, accent if accent in ("blue", "amber", "teal", "purple") else "blue", slug),
        lambda: render(["byitx"], "", None, "blue", slug),
    ]
    for i, fn in enumerate(tries):
        try:
            return fn(), i + 1
        except Exception:
            continue
    img = Image.new("RGB", (W, H), (16, 32, 64))
    buf = io.BytesIO()
    img.save(buf, format="PNG")
    return buf.getvalue(), 4
Code language: Python (python)
요청받은 그대로 그려 보고 실패하면 강조 색상을 뺀다. 그래도 안 되면 byitx 한 줄을, 마지막엔 텍스트 없는 배경만 그린다. 몇 단계에서 그렸는지는 응답의 stage 로 알려 준다. 카드 배경의 막대 무늬는 random 대신 slug 를 hashlib.sha256 으로 반복 해시한 바이트로 만드니 글이 같으면 몇 번을 다시 만들어도 카드가 바뀌지 않는다. 이 글의 대표 이미지도 이 엔드포인트로 만들었다.
Python pdf 컨테이너 n8n 호출과 장애 대비
n8n 에서는 HTTP Request 노드로 http://pdf:8080/... 를 호출한다. 초안 작성 워크플로우가 본문을 쓰고 평가를 마치면 이미지·차트를 만드는 하위 워크플로우를 호출한다. 그 결과를 넣어 검토용 PDF 를 렌더링한 뒤 텔레그램으로 보낸다. 승인 버튼을 누르면 미디어 반영 워크플로우가 차트를 다시 렌더링해 워드프레스에 올리고 발행까지 완료한다.
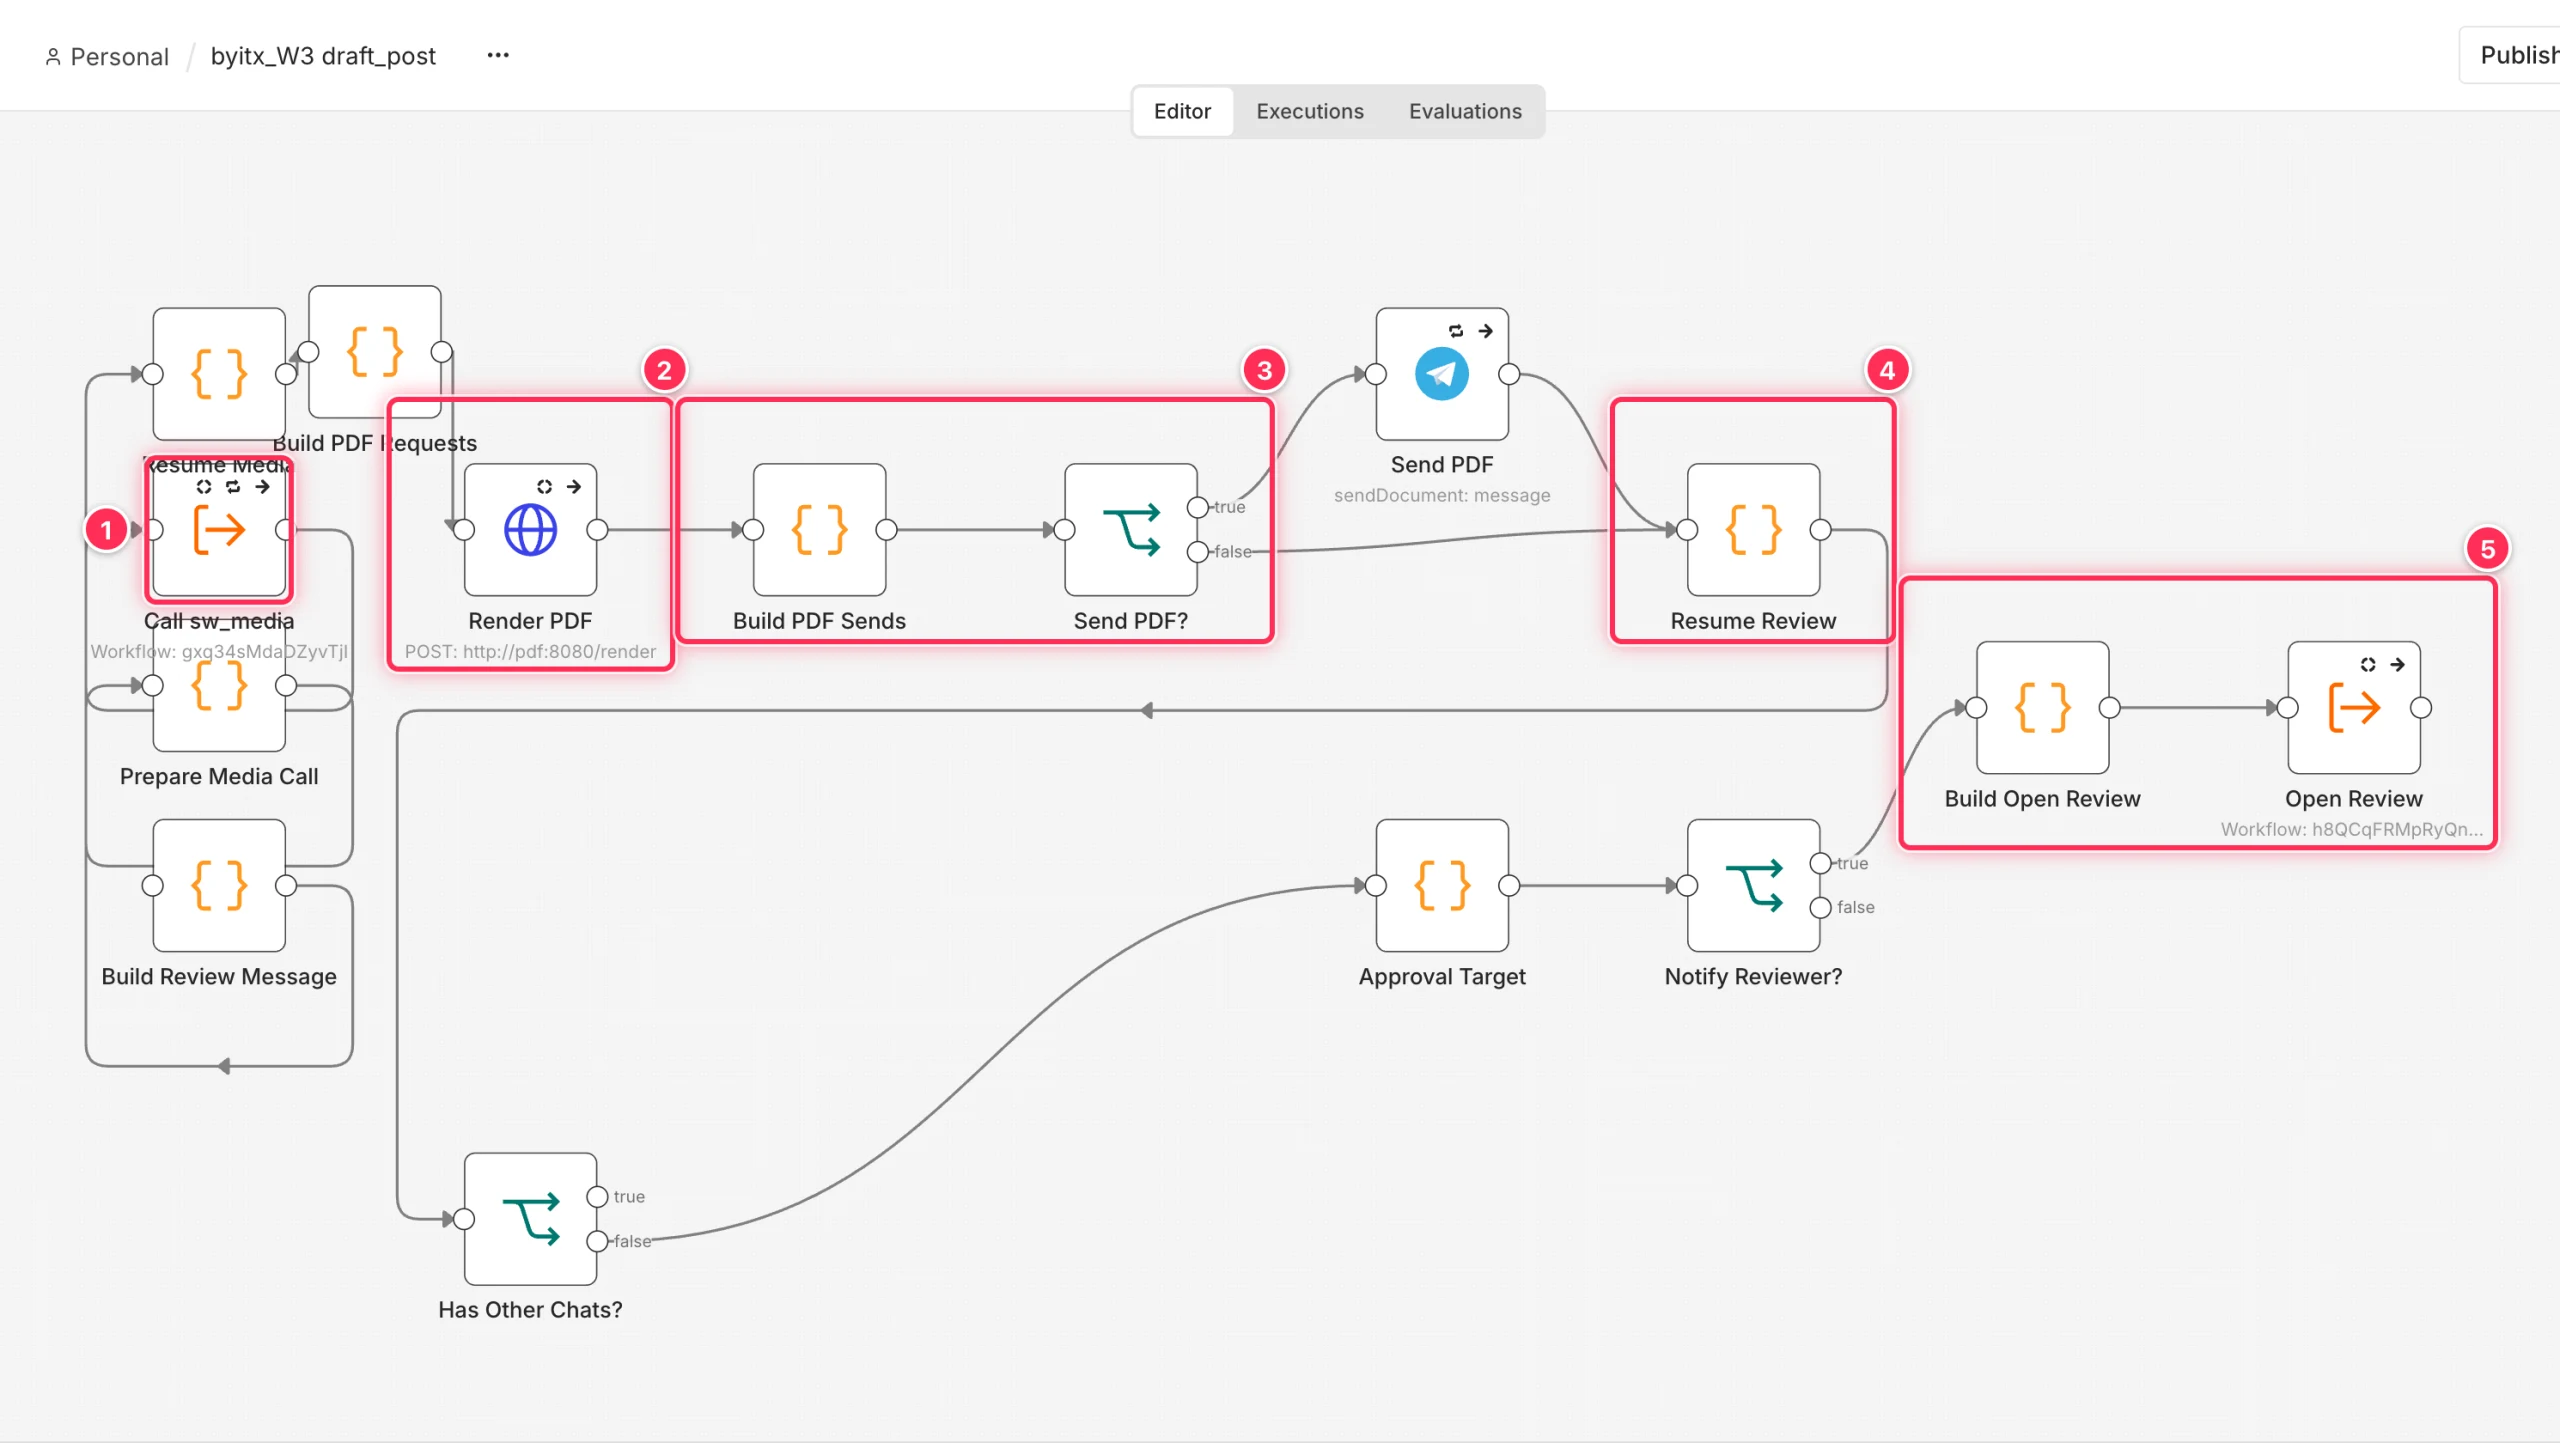
① 이미지·차트 하위 워크플로우 호출
② 검토용 PDF 렌더링
③ 보낼 PDF 선택, 없으면 send:false
④ 원래 검토 메시지로 다시 연결
⑤ 텔레그램 검토 메뉴 열기.
prod 에서 사흘 동안 받은 요청으로 사용량을 세어 보니, 이미지 크기 맞춤(/compose)이 36번, 검토용 PDF 가 18번, 텍스트 가이드 이미지가 9번, 차트가 6번이었다.
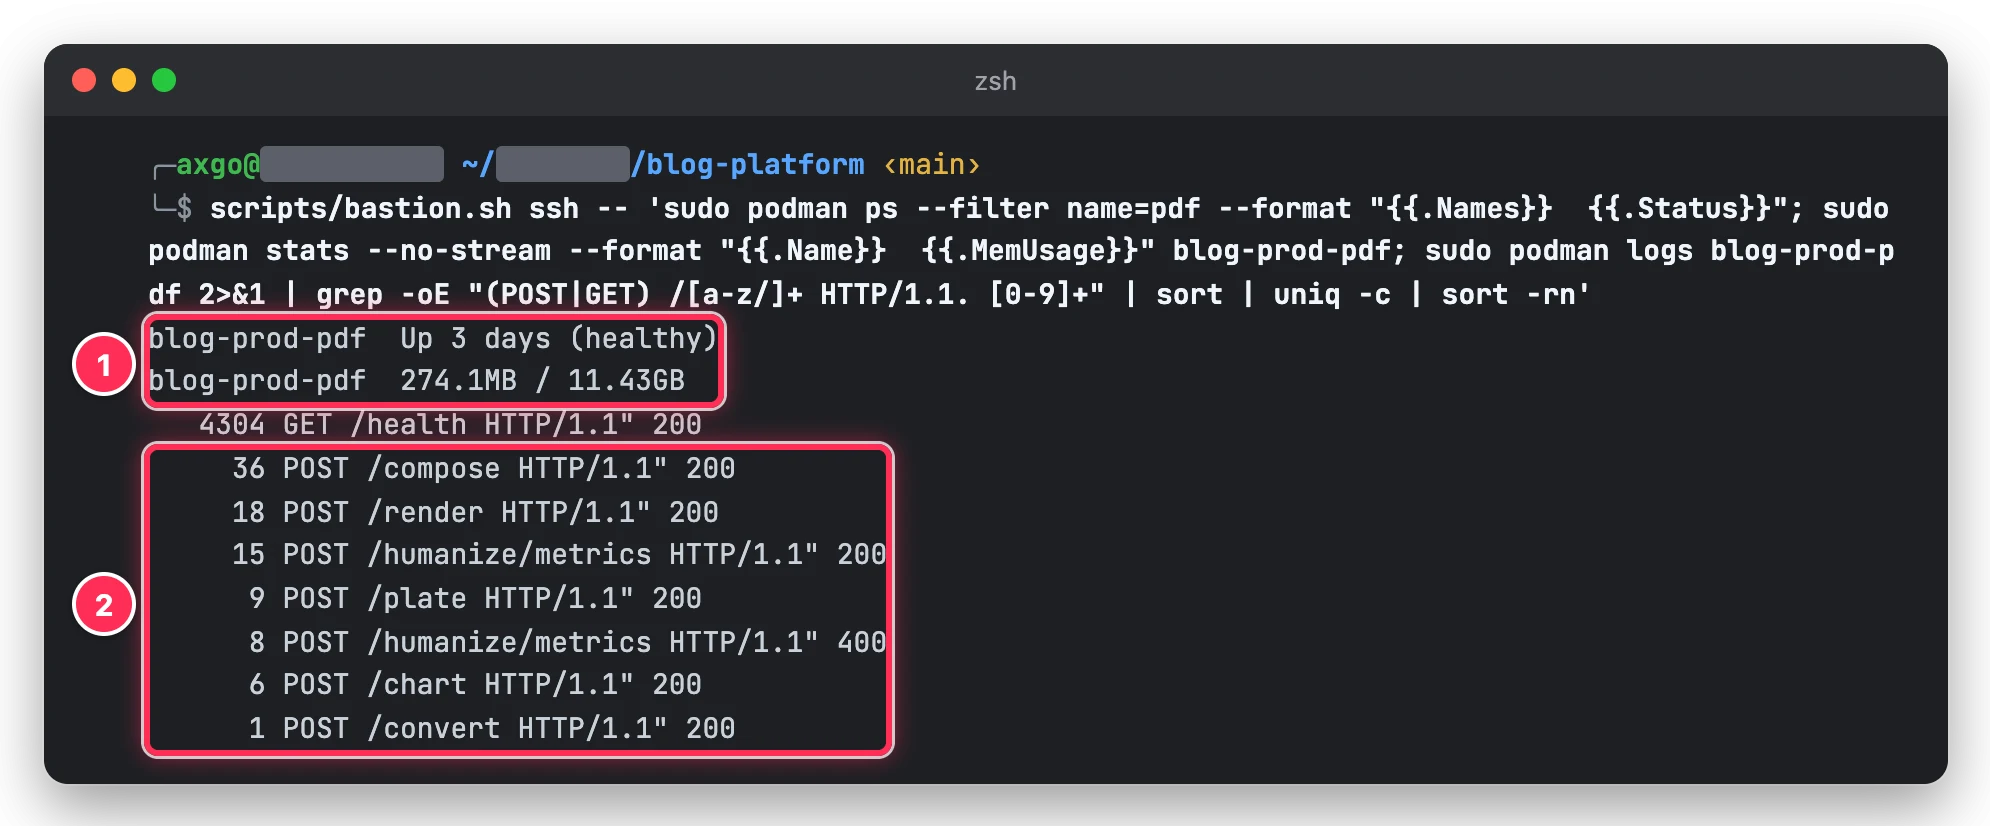
① 사흘째 healthy, 메모리 274 MB
② 사흘 동안 받은 요청 수. 400 은 본문이 비었거나 형식이 맞지 않아 서버가 거절한 요청이다.
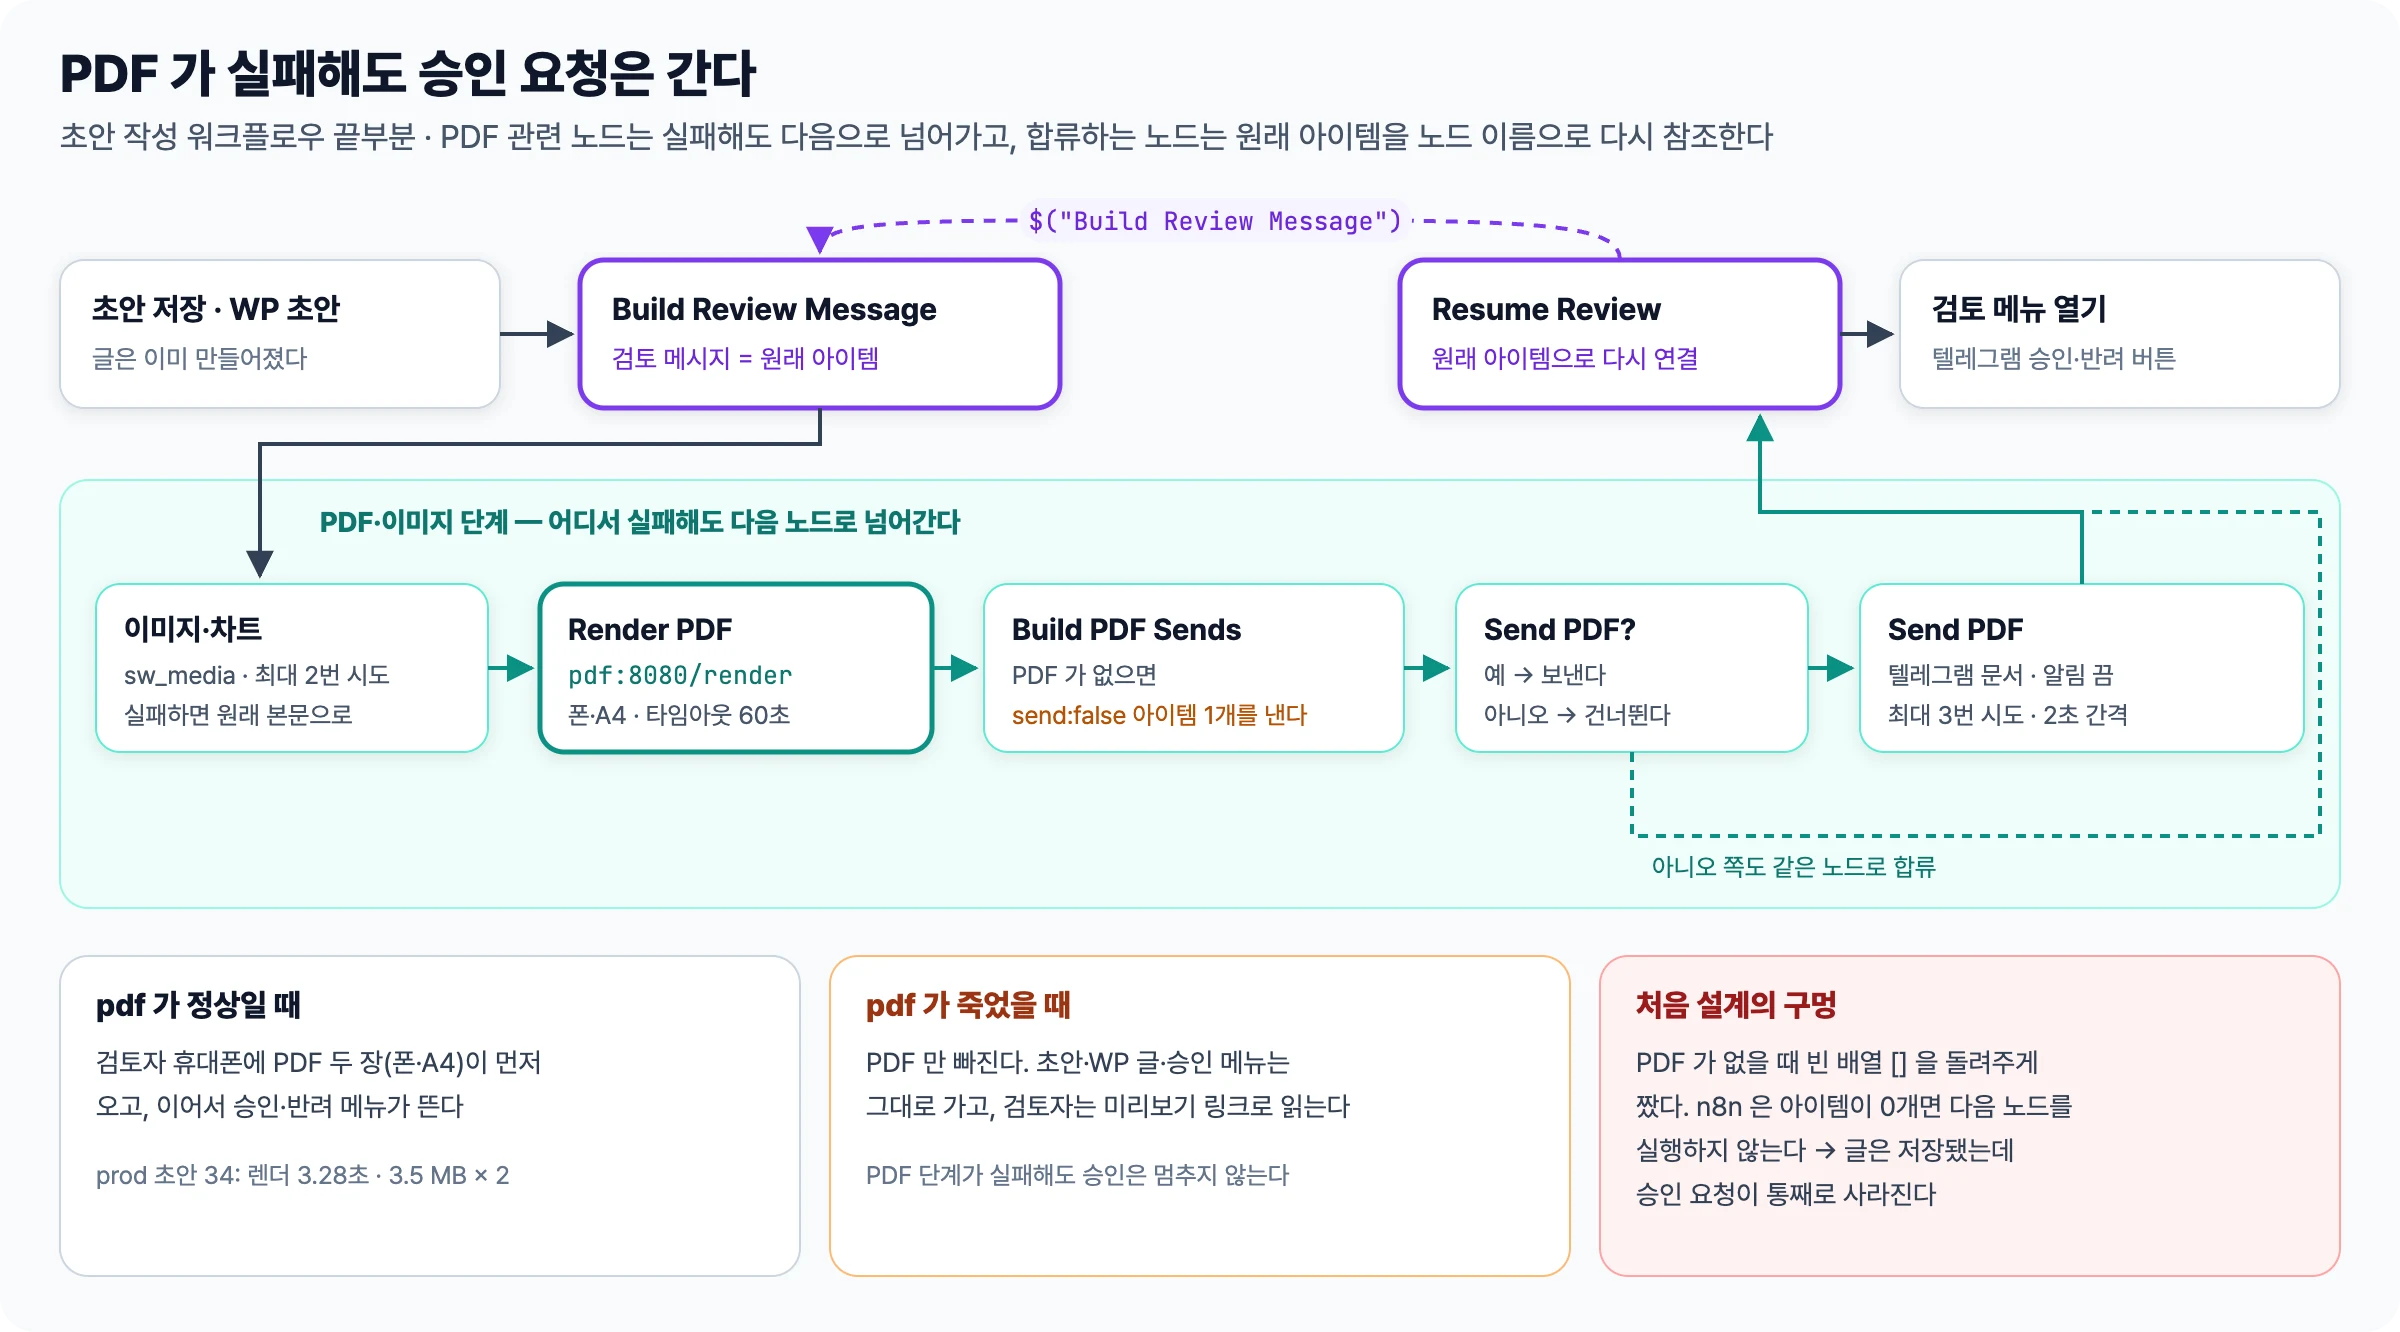
파이썬 서버가 죽거나 느려져도 발행에 문제가 생기면 안 된다. 그래서 pdf 를 호출하는 n8n HTTP Request 노드는 모두 실패해도 다음 노드로 넘어가게(On Error: Continue) 하고 응답이 없어도 아이템 하나는 내보내게(Always Output Data) 했다.
처음 설계에는 구멍이 있었다. PDF 렌더링이 실패하면 보낼 파일이 없으니 Build PDF Sends 가 빈 배열을 돌려주게 짰다. 그런데 n8n 은 아이템이 0개인 노드 뒤를 아예 실행하지 않는다. 초안과 워드프레스 글은 저장됐는데 승인 요청이 통째로 사라지는 구조였다. 지금은 보낼 게 없으면 send:false 아이템을 하나 내보내고 Resume Review 노드가 앞 노드 출력 대신 원래 검토 메시지를 노드 이름으로 다시 참조한다. 파이썬 서버가 죽은 날에도 PDF 만 빠지고 승인 메뉴와 미리보기 링크는 정상적으로 발송되도록 했다.
이미지는 Draw Things, Cloudflare Workers AI, Gemini(무료 등급이 없어 꺼 둠), 텍스트 카드 순으로 시도한다. 우선순위가 처리가 없을때 텍스트 카드 주소를 설정값에서 읽으면서 설정이 틀리자 대표 이미지가 비어 경우가 발생했다. 지금은 주소를 http://pdf:8080/card 로 노드에 고정했다. 네 가지가 모두 실패하면 Rescue Card 노드가 텍스트 카드를 직접 호출하고 최대 다섯 번까지 3초 간격으로 재시도한다.
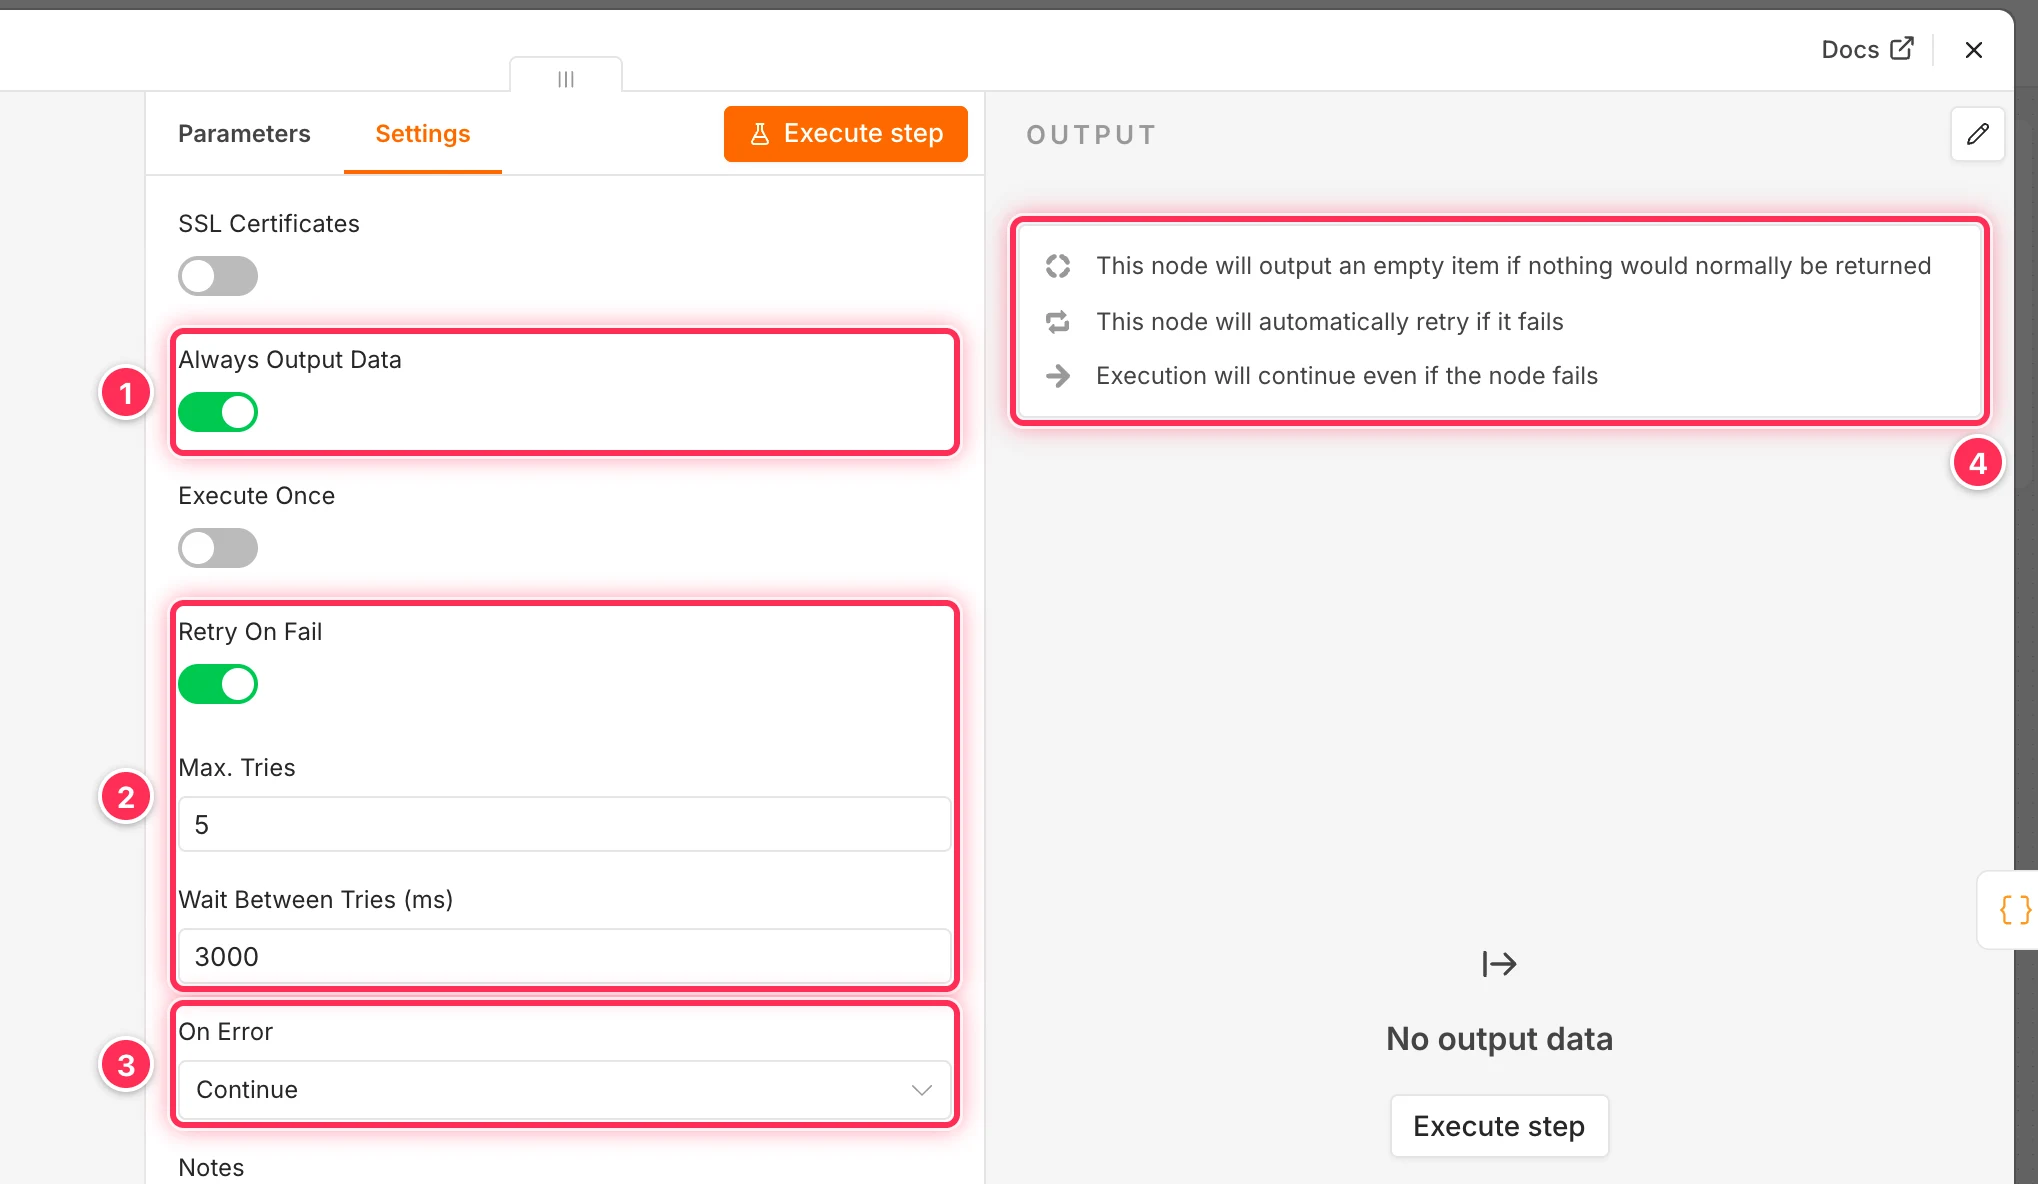
① Always Output Data
② 최대 5번, 3초 간격으로 재시도
③ On Error: Continue
④ 오른쪽에 같은 설정이 요약돼 있다.
차트는 바이트를 저장하지 않고 발행 직전에 다시 렌더링한다. 같은 스펙 = 같은 바이트가 나오니 가능한 방식이다. 반려된 초안이 워드프레스에 첨부 파일을 남기지 않는 장점도 있다. 다만 발행 직전에 파이썬 서버가 응답하지 않으면 차트가 비게 된다. 이때는 5분 뒤 다음 실행에서 다시 시도하고 세 번째에도 비면 차트 플레이스홀더를 지우고 글을 발행한다. 이미지 생성 모델이 만든 이미지는 다시 만들 수 없어서 승인 때 만든 이미지를 보관했다가 워드프레스 업로드가 확인된 뒤에만 지운다.
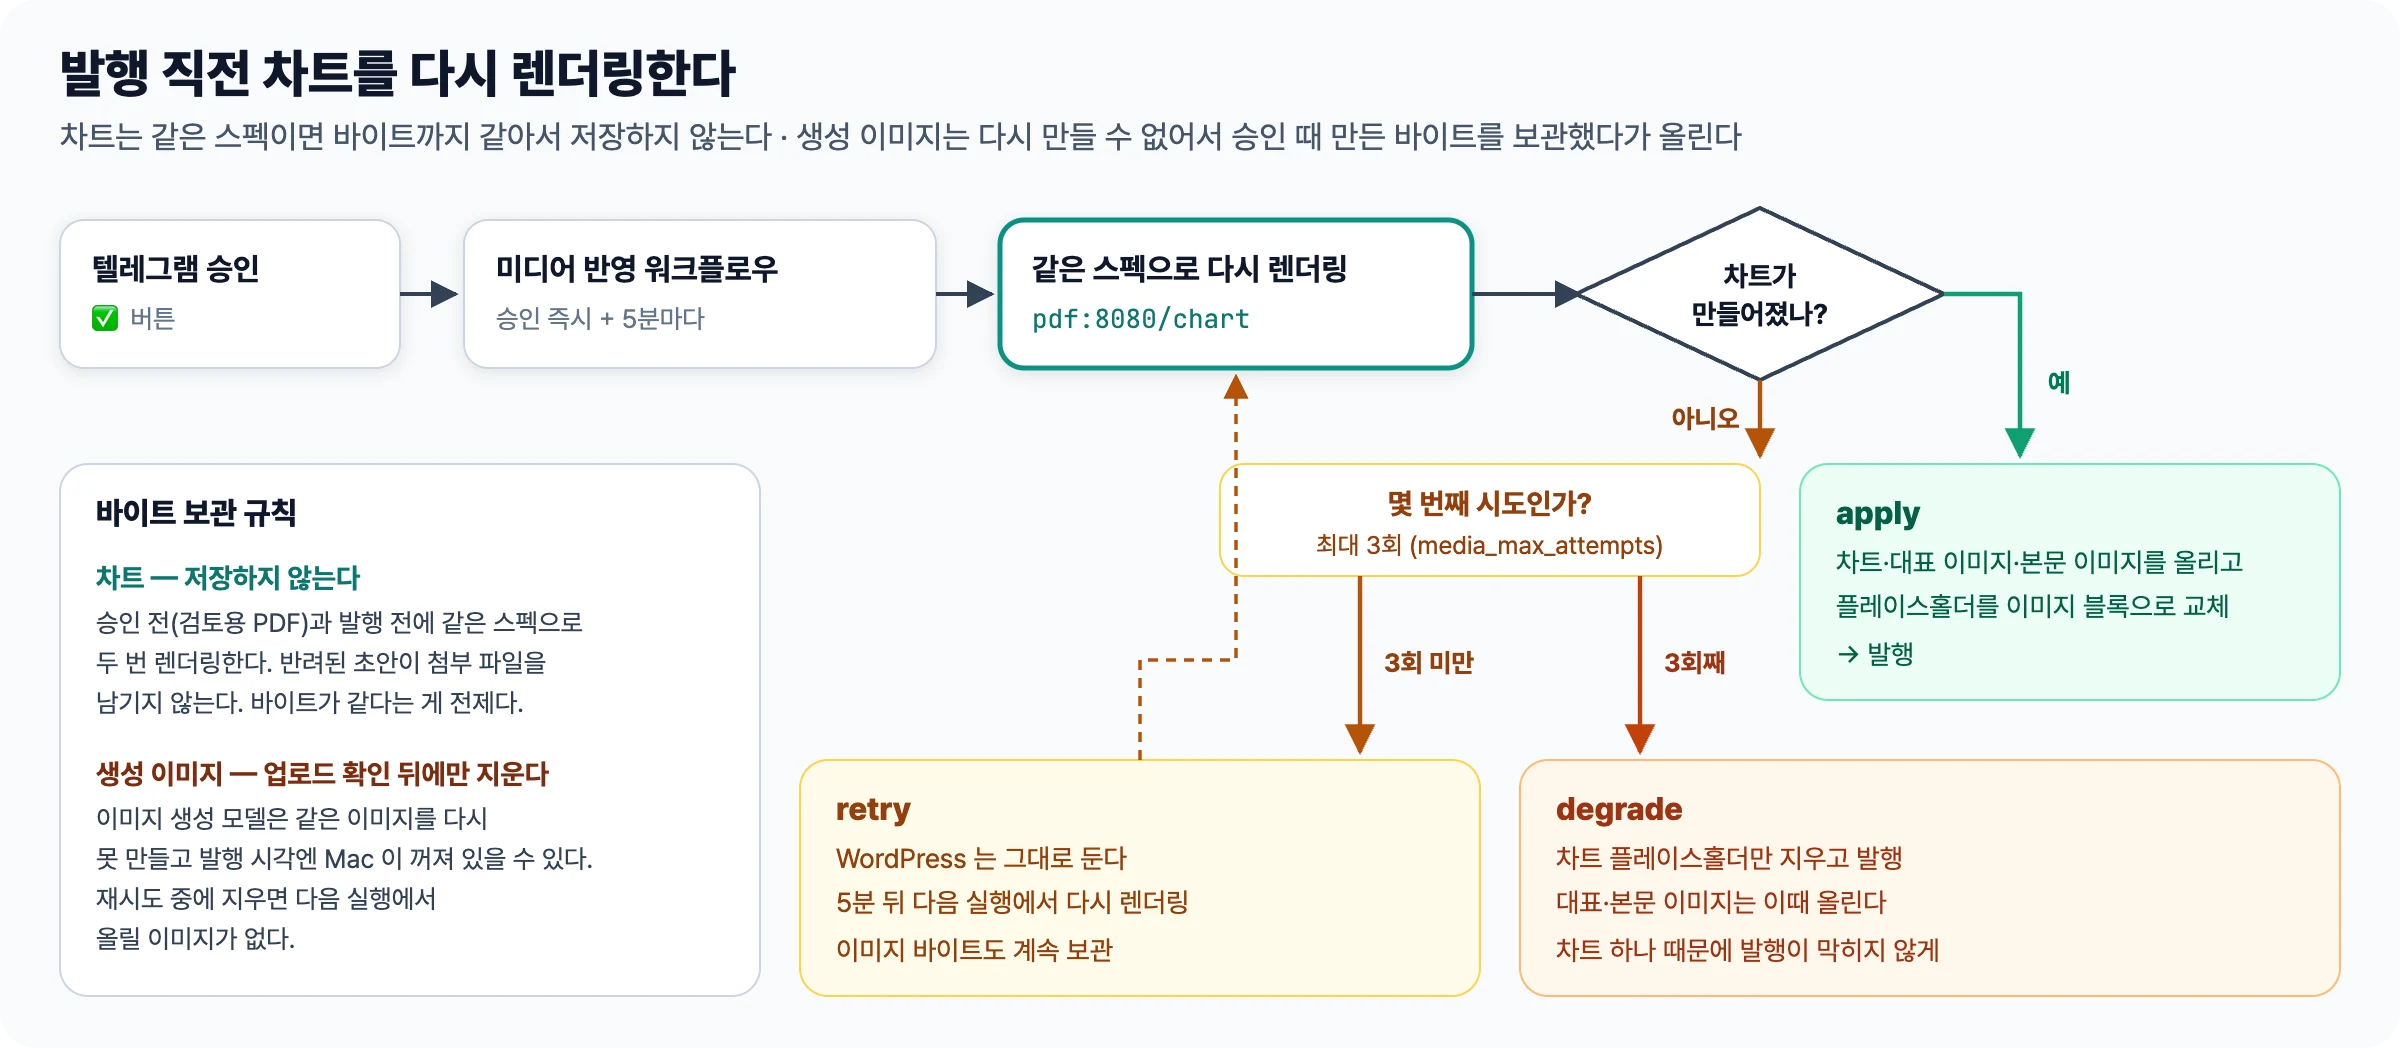
WeasyPrint, matplotlib, Pillow 에서 한글 폰트를 찾는 방법이 모두 다르다
PDF 본문과 차트 라벨, 이미지 속 제목, 텍스트 카드까지 이 Python 서버가 하는 작업은 크게 보면 한글을 정확하게 렌더링하는 일이다. 한 서버에 모아 둔 덕분에 폰트와 색상 팔레트, 텍스트 배치 코드를 한 곳에서 고친다. 카테고리별 색상은 draw_kit.py 한 파일에 있어서 차트와 텍스트 카드, 브랜드 카드가 늘 같은 색을 쓸수 있도록 했다.
비슷한 서버를 다시 만든다면 라이브러리마다 한글 폰트를 어떻게 찾는지부터 확인해야겠다. WeasyPrint 는 fontconfig 이름으로 찾는다. matplotlib 은 TTC 의 첫 번째 폰트만 쓰고 Pillow 는 TTC 인덱스로 고른다. 같은 폰트 파일을 세 라이브러리가 모두 다르게 다루는 부분이 다소 까다롭게 느껴졌다.
- Python pdf 컨테이너를 호출하면서 Podman 네트워크에서 겪은 문제는 forwarding=0 글에
- n8n 뉴스 분류를 바꾼 이야기는 Jev 글에 있다.