블로그를 자동으로 운영하는 시스템(blog-platform)을 Podman 위에 만들고 있다. WordPress, n8n, MariaDB·PostgreSQL, nginx, 백업(restic), Cloudflare Tunnel 같은 컨테이너 아홉 개를 compose 파일 한 벌로 띄운다. 개발은 MacBook의 Podman machine에서 하고, 운영은 Oracle Cloud의 무료 Arm 서버(Ampere A1, 이하 A1)에 올린 Oracle Linux 10까지 양쪽 모두 Podman으로 구성했다.
9월 한 달 동안 Mac과 A1에서 같은 증상을 여러 번 만났다. 컨테이너 안에서 DNS 조회는 되는데, 바깥 서버로 나가는 TCP 연결만 응답 없이 멈춘다. 오류가 나지 않으니 백업은 몇 분씩 멈춰 있는 증상이 발생. 원인은 컨테이너 브리지 인터페이스의 net.ipv4.conf.<브리지>.forwarding 값이 “0” 이어서 생기는 증상이었다. 이 값이 1이어야 컨테이너가 바깥과 통신할 수 있다.
원인을 찾아 헤매다가 netavark 소스를 확인하고 Mac과 A1에서 재현하면서 확실한 원인을 찾을 수 있었다. netavark가 internal 네트워크를 지워도 sysctl 설정 파일이 해당 값을 잡아 “0”으로 생성되는 것이 원인이었다.
목차
증상: DNS는 동작하는데 Outbound TCP만 멈춘다
처음 증상을 확인한 것은 Mac의 dev 환경이었다. 백업 컨테이너가 restic으로 Cloudflare R2 저장소를 접근하려는데 멈추는 증상이 발생했다. 컨테이너 안에서 nc 1.1.1.1 443 포트도 멈추는 상태가 발생하고 있는데 포트 53을 이용하는 DNS Resolve는 정상이었다. 같은 VM에 떠 있는 다른 compose 프로젝트의 Podman 컨테이너들에서는 Outbound에 문제가 없었다.
아래는 같은 상태를 Mac에서 다시 만들어 찍은 화면이다.
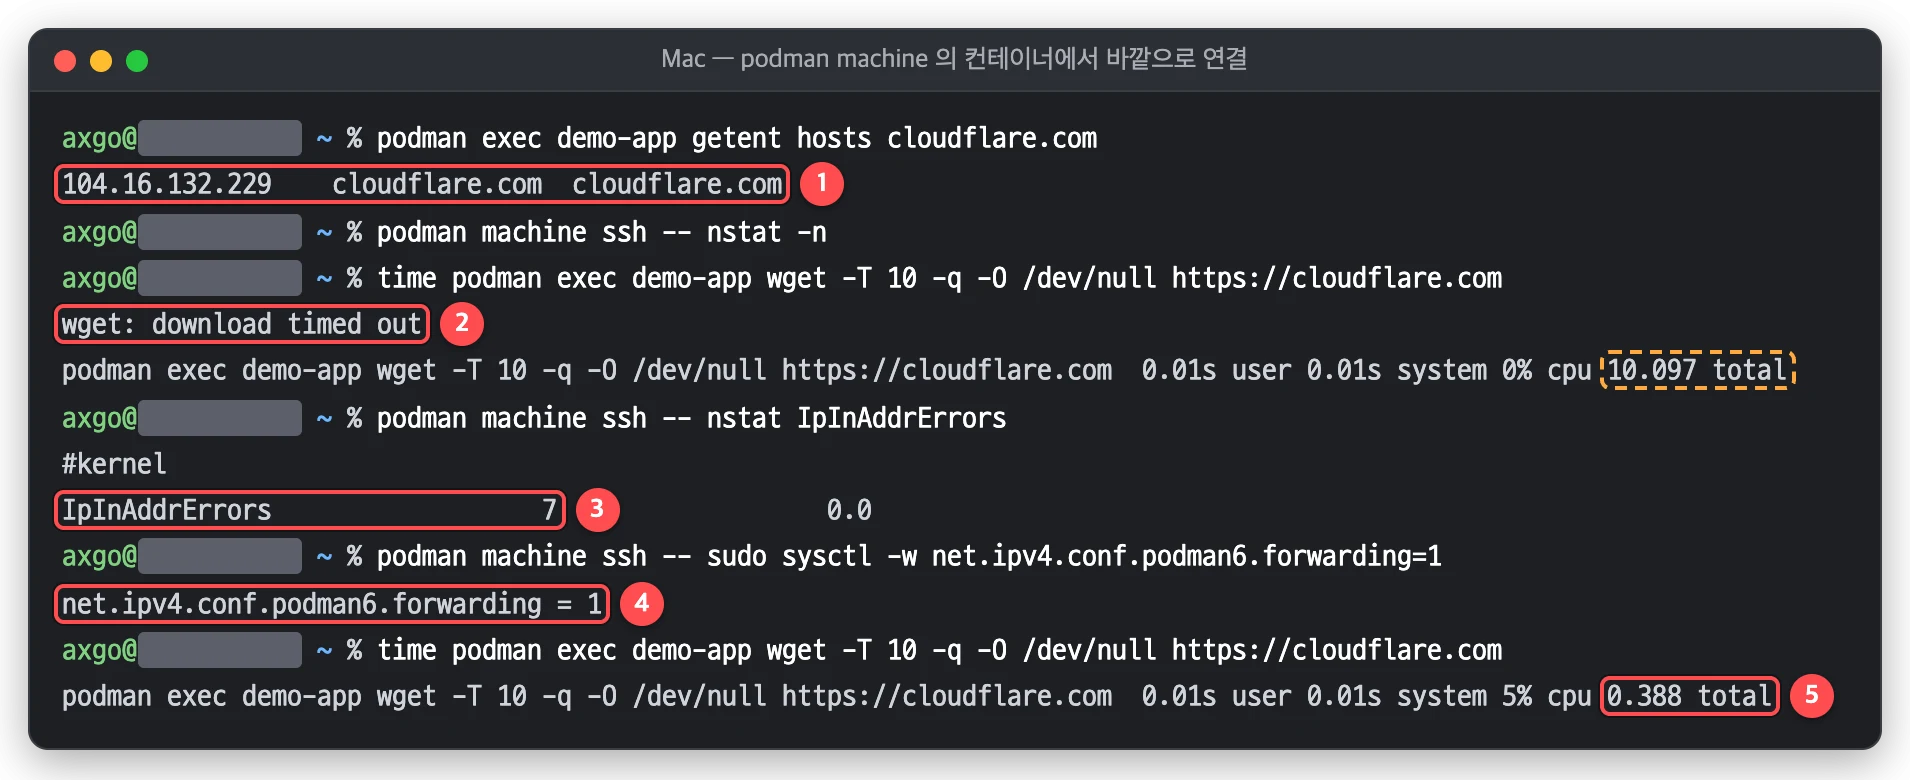
이름 조회가 되는 이유는 Podman의 DNS 서버(aardvark-dns)가 브리지의 게이트웨이 주소, 즉 호스트 자신에서 답하기 때문이다. 바깥 도메인도 aardvark-dns가 호스트에서 대신 물어 와서 답한다. 컨테이너가 호스트와 이야기하는 것이라 포워딩이 필요 없다.
바깥 서버로 가는 패킷은 다르다. 호스트가 브리지에서 받은 패킷을 바깥 인터페이스로 넘겨야 하고, 이것이 IP 포워딩이다. 리눅스 커널은 패킷이 들어온 인터페이스의 forwarding 값이 0이면 그 패킷을 버린다. 이때 ICMP 오류도 보내지 않고 IpInAddrErrors 카운터만 올린다(커널 net/ipv4/route.c의 ip_error()). 컨테이너는 ‘연결 거부’도 ‘도달 불가’도 받지 못하니 SYN을 다시 보내며 기다릴 뿐이다. restic처럼 재시도를 오래 하는 프로그램은 그대로 멈춘 것처럼 보인다.
응급 처치는 한 줄이다. Mac에서는 브리지가 Podman machine VM 안에 있으므로 VM 안의 값을 바꿔야 한다. macOS에서 sysctl을 봐서는 찾을 수 없다.
# 브리지 이름 확인
podman network inspect <네트워크> --format '{{.NetworkInterface}}'

# Mac(podman machine)
podman machine ssh -- sudo sysctl -w net.ipv4.conf.<브리지>.forwarding=1

# 리눅스 호스트(rootful Podman)
sudo sysctl -w net.ipv4.conf.<브리지>.forwarding=1Code language: Bash (bash)
Mac과 A1에서 겪은 일
그 뒤로도 같은 증상이 운영 환경을 옮기는 시험과 A1 배포에서 다시 나왔다. 그때마다 원인을 다르게 봤다.
| 발생 / 위치 | 증상 | 원인분석 | 조치 |
|---|---|---|---|
| 09-07 / Mac | 백업 컨테이너가 R2로 나가지 못함 | internal 네트워크와 일반 네트워크에 함께 붙는 컨테이너 때문인 netavark 결함으로 추정 | 손으로 forwarding=1 |
| 09-15 / Mac | 운영을 Mac으로 옮기는 리허설에서 복원 단계가 restic에서 11분 멈춤 | down으로 지운 네트워크를 다시 만들 때 생긴 브리지 | 검사를 restic 앞으로 옮기고, 0이면 자동으로 1로 |
| 09-28 / Mac | A1 장애를 가정한 비상 인수 과정에서 10분 멈춤 | 새 브리지가 VM의 default 값 0을 물려받았다고 봄 | forwarding default를 1로 맞추는 코드 추가 |
| 09-28 / OCI A1 | 새로 만든 서버의 첫 배포에서 public 브리지가 0 | nginx가 포트를 127.0.0.1에 공개해서라고 봄 | 컨테이너를 띄우는 모든 명령 뒤에 검사·보정 |
9월 27일부터는 A1에서 10분마다 도는 점검 스크립트(healthcheck)도 이 값을 확인하게 했다. 0이면 1로 고치고 경고 메일을 보낸다.
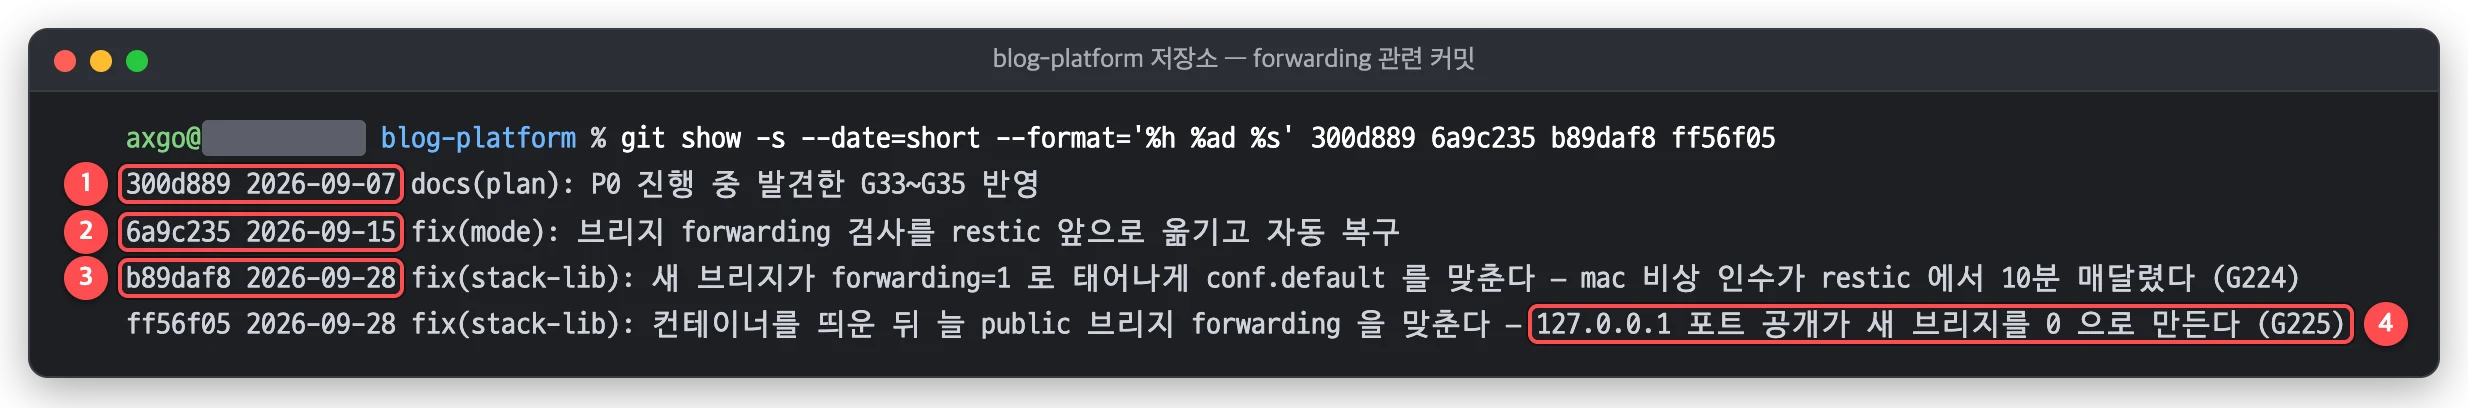
고칠 때마다 증상은 사라졌지만 원인은 매번 달라 보였다. 처음 만든 브리지는 멀쩡하고, down 한 뒤 다시 만든 브리지만 0이 된다는 것까지는 알았다. 그 이상은 재현이 들쭉날쭉해서 좁히지 못했다.
진짜 원인: internal 네트워크가 남긴 sysctl 파일
Podman의 네트워크 도구 netavark 1.17.2의 src/network/bridge.rs를 읽고 답을 찾았다. netavark는 브리지를 새로 만들 때 sysctl 값을 두 군데에 쓴다. 하나는 /proc/sys이고, 다른 하나는 systemd용 설정 파일 /run/sysctl.d/10-netavark-<브리지>.conf이다. 새 인터페이스가 생기면 udev가 systemd-sysctl을 불러 그 인터페이스에 해당하는 설정을 적용하는데, 이때 netavark가 쓴 값이 예전 값으로 덮이지 않게 하려고 같은 값을 파일로도 남긴다.
파일에 들어가는 값은 네트워크 종류에 따라 다르다.
- internal 네트워크:
net/ipv4/conf/<브리지>/forwarding = 0,rp_filter = 2. 바깥으로 못 나가게 막는 의도된 값이다. - 일반 네트워크:
net/ipv4/ip_forward = 1(전역),route_localnet = 1,rp_filter = 2. 브리지별 forwarding은 쓰지 않는다.
문제는 세 가지가 겹칠 때 생긴다.
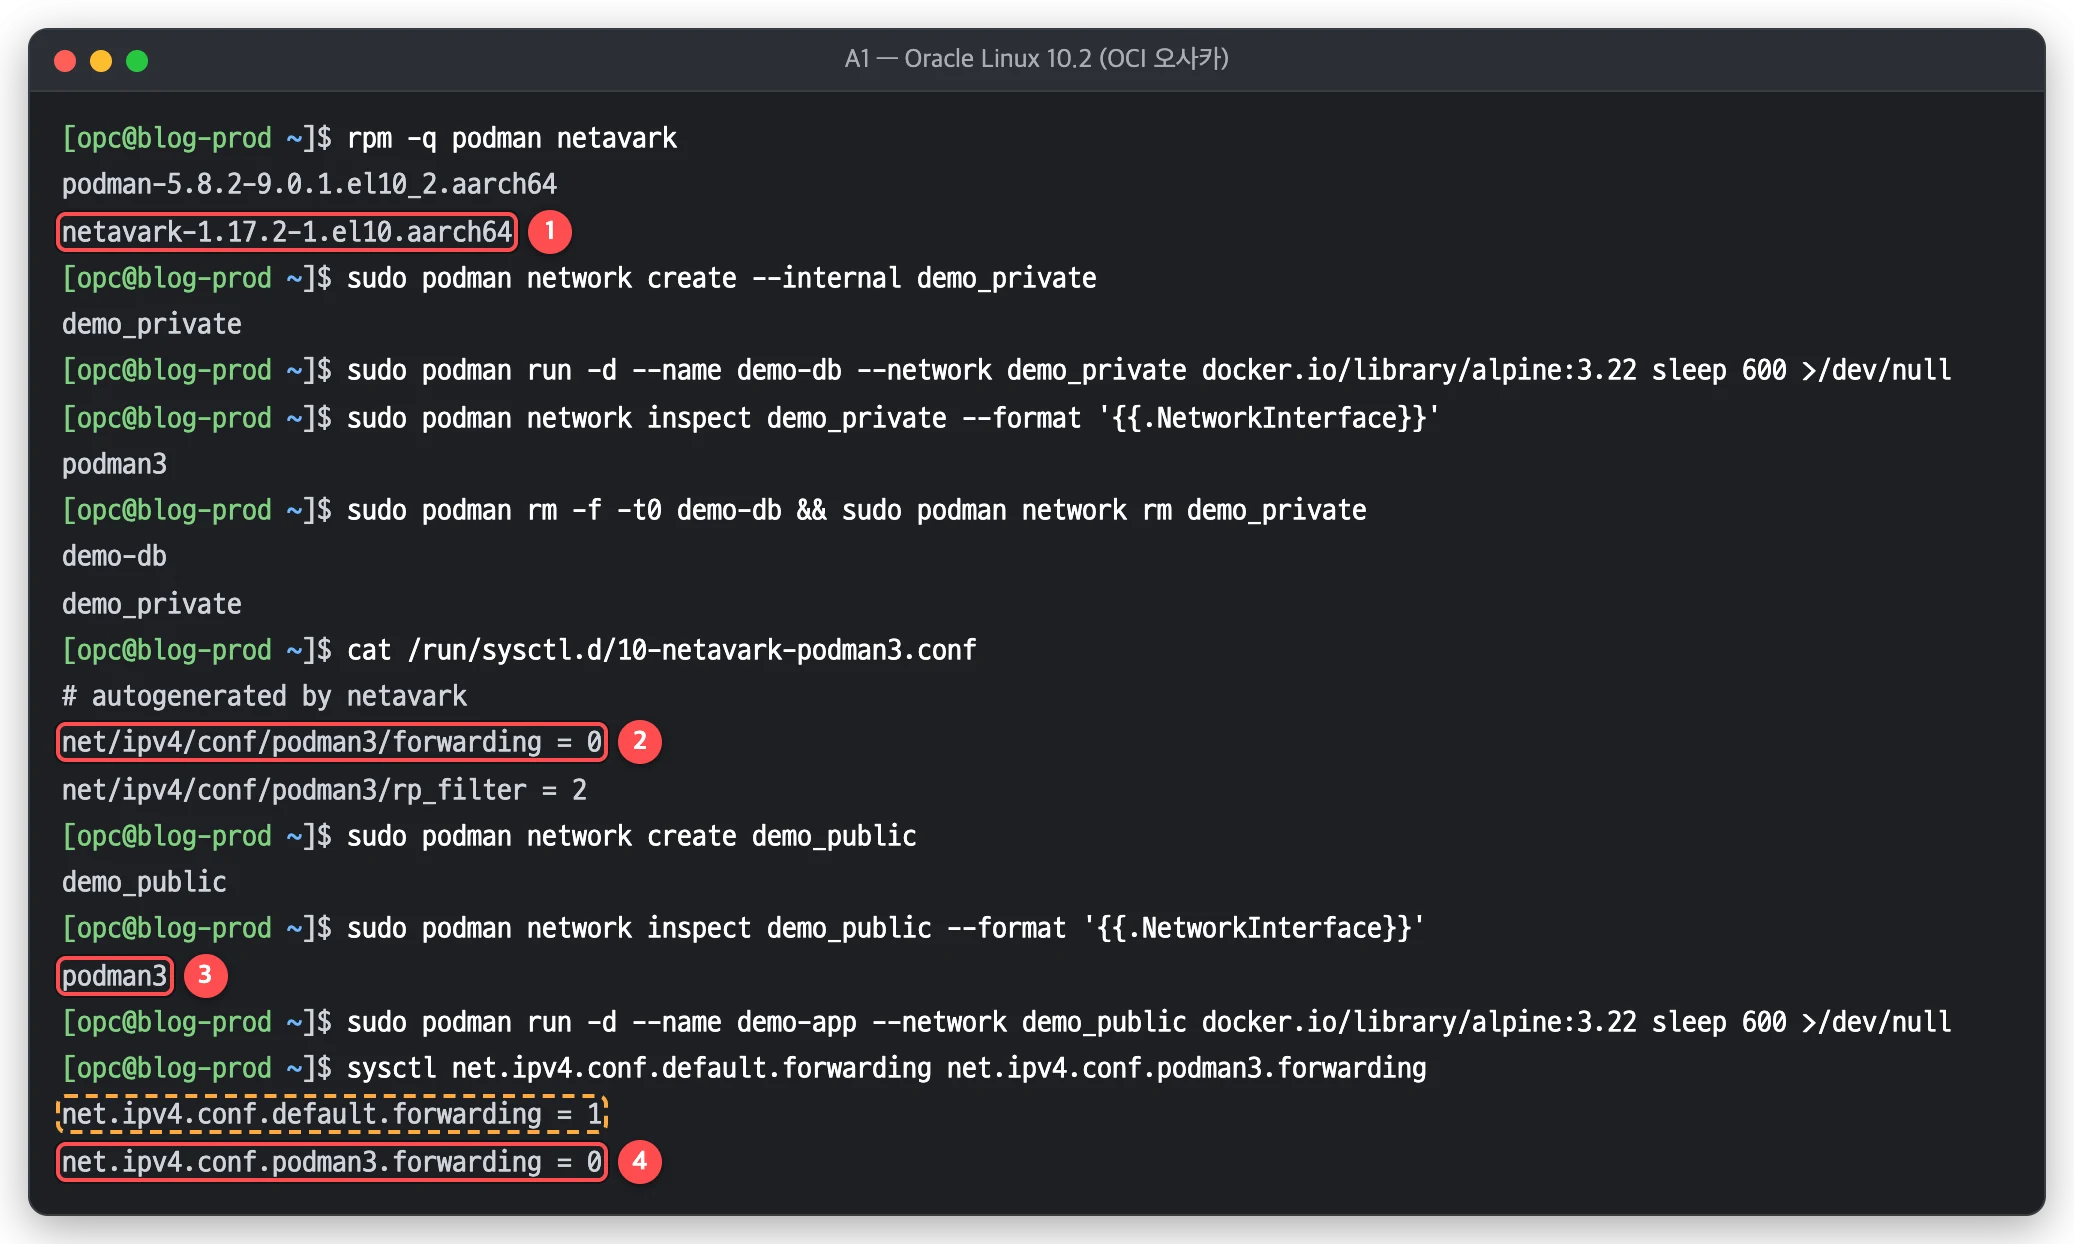
- 네트워크를 지울 때 이 파일을 함께 지우는 코드는 internal이 아닌 네트워크에서만 돈다. internal 네트워크의 forwarding = 0 파일은 브리지가 사라진 뒤에도 남는다.
- 브리지 이름(
podman1,podman2…)은 비어 있는 번호부터 다시 쓴다. 지운 internal 네트워크의 이름을 다음에 만드는 일반 네트워크가 받을 수 있다. - netavark는 이 파일을 만들 때 같은 이름의 파일이 이미 있으면 덮어쓰지 않는다(
File::create_new). 남은 파일의 내용이 그대로 쓰인다.
그래서 일반 네트워크의 브리지가 생기는 순간 systemd가 남은 파일의 forwarding = 0을 적용한다. netavark는 전역 ip_forward=1만 쓰는데, 커널은 이미 1인 값을 다시 1로 쓰면 아무 일도 하지 않는다(devinet_sysctl_forward()는 값이 바뀔 때만 모든 인터페이스에 새 값을 퍼뜨린다). 브리지의 0을 1로 되돌리는 코드가 어디에도 없는 셈이다.
// netavark v1.17.2 src/network/bridge.rs — 네트워크를 지울 때(teardown)
if !self.info.network.internal && mode == BridgeMode::Managed {
    if complete_teardown {
        // delete sysctl file as well
        let path = sysctl::get_bridge_sysctl_d_path(&bridge_name);
        if let Err(e) = fs::remove_file(&path) {
            ...Code language: Rust (rust)
Mac에서 그대로 재현된다. internal 네트워크를 만들고 지운 뒤 일반 네트워크를 만들기만 하면 된다.
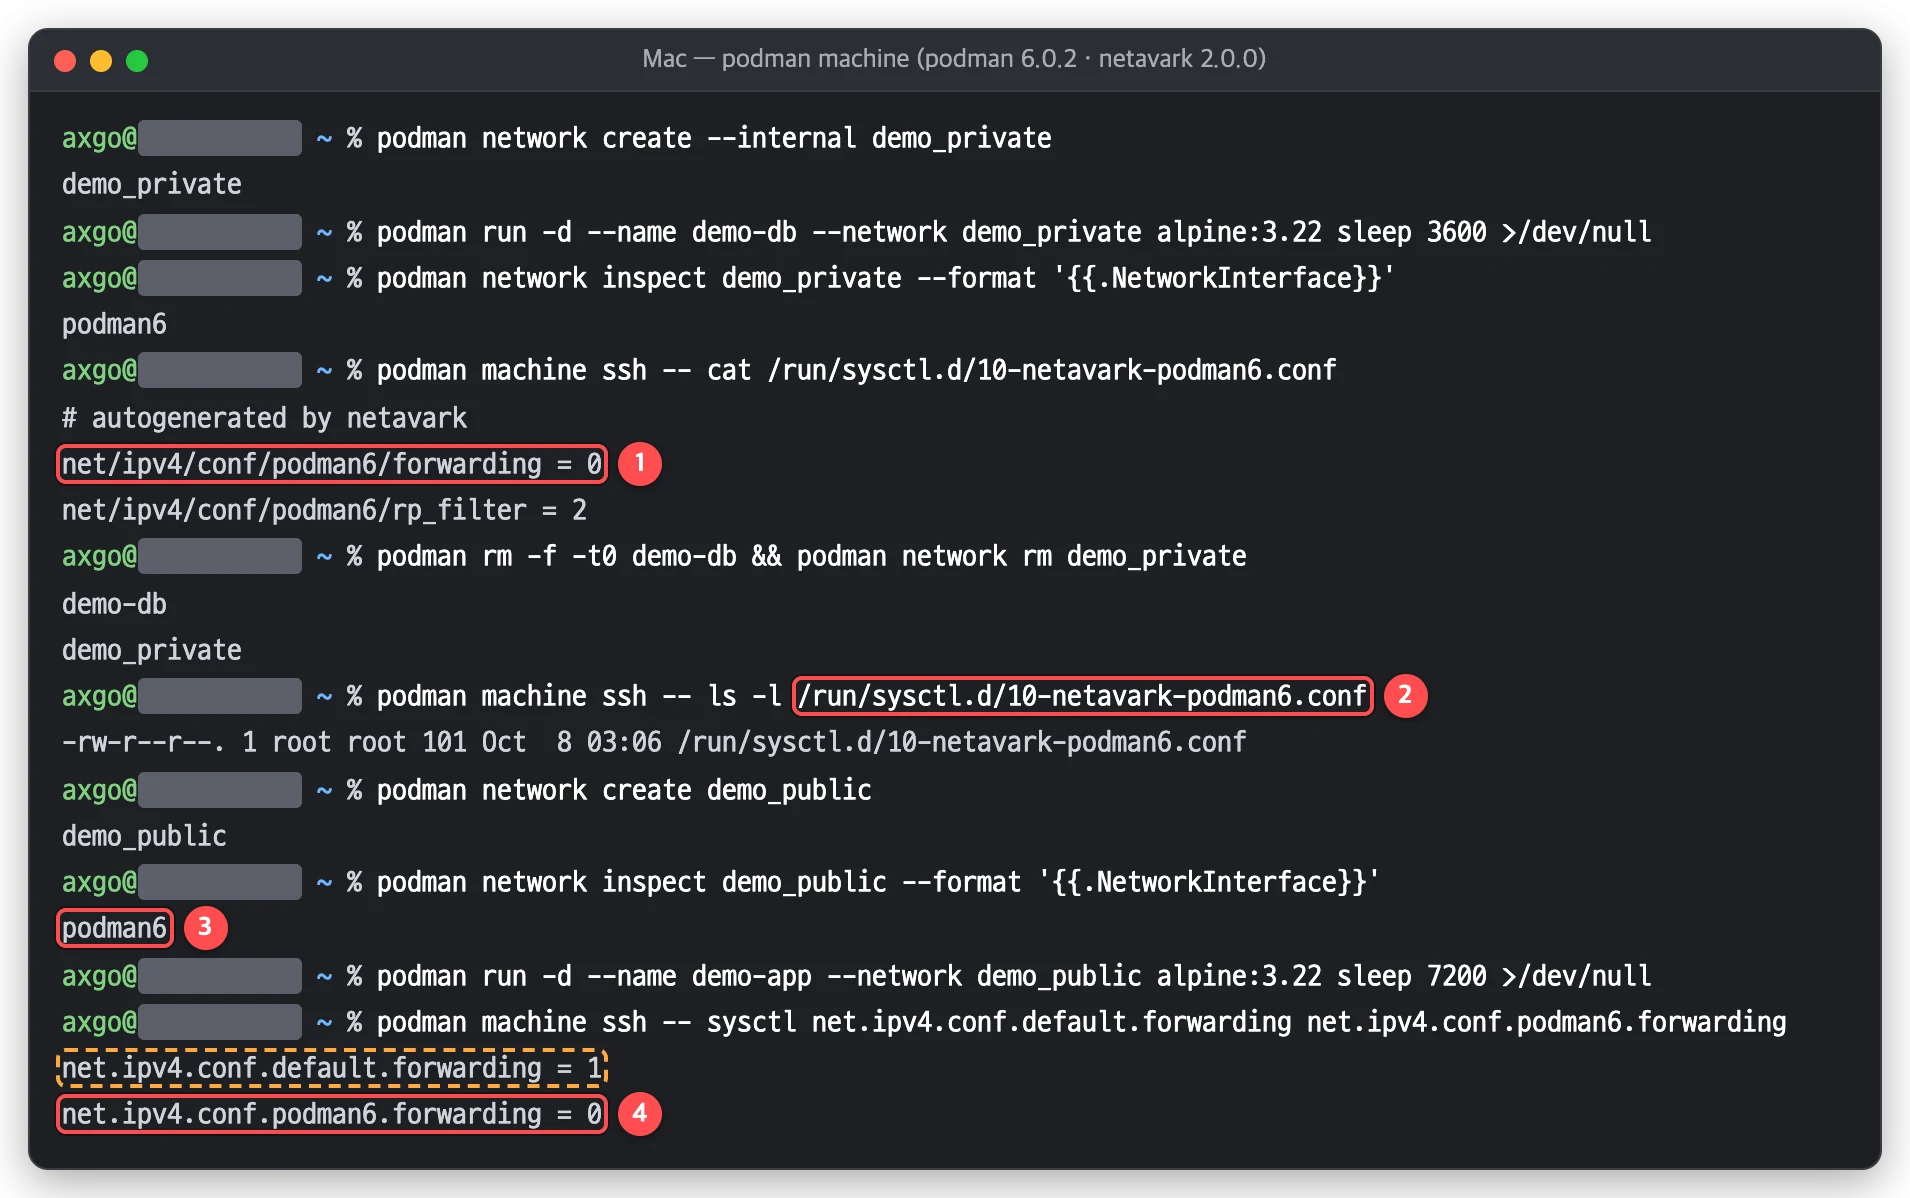
A1의 Oracle Linux에서도 똑같다.
이제 증상에 대해 설명 가능하다
나는 compose 파일은 public(일반)과 private(internal: true) 두 네트워크를 쓴다. 데이터베이스는 private에만 붙어 바깥과 끊겨 있다. down으로 둘을 지우면 private의 파일이 남고, 다음 up에서 public이 그 이름을 받으면 0이 된다. 어느 네트워크가 몇 번을 받는지는 그때 비어 있는 번호와 만드는 순서에 따라 달라서 재현이 들쭉날쭉했다. 처음 만든 브리지가 늘 멀쩡했던 것은 그때 남은 파일이 없었기 때문이다.
/run은 메모리 파일 시스템이라 재부팅하면 남은 파일도 사라진다. 재부팅 직후에는 잘 되다가 네트워크를 몇 번 지우고 만든 뒤에야 나타나니, 가끔 생기는 문제처럼 보일 수밖에 없었다.
A1의 첫 배포도 같은 이야기였다. 서버를 처음 만들 때 도는 cloud-init 점검 스크립트가 internal 네트워크의 DNS를 시험하려고 blog-smoke-int 네트워크를 만들었다 지운다. 새 서버에서 기본 네트워크(podman0) 다음으로 처음 만드는 네트워크라 브리지 이름은 podman1이 되고, forwarding = 0 파일을 남긴다. 곧이어 첫 배포가 만든 public 네트워크가 podman1을 받는다. 9월 28일 기록의 ‘podman1이 0으로 생겼다’와 맞아 떨어진다.
# terraform/oci/modules/compute/templates/bootstrap.sh — internal 네트워크 DNS 점검
podman network create --internal blog-smoke-int >/dev/null
podman run -d --name blog-smoke-a --network blog-smoke-int docker.io/library/alpine:3.22 sleep 120 >/dev/null
podman run --rm --network blog-smoke-int docker.io/library/alpine:3.22 getent hosts blog-smoke-a >/dev/null || smoke_rc=$?
podman rm -f blog-smoke-a >/dev/null
podman network rm blog-smoke-int >/dev/null   # 브리지는 사라지지만 /run/sysctl.d/10-netavark-podman1.conf 는 남는다Code language: Bash (bash)
nginx가 127.0.0.1에 포트를 공개한 것은 원인이 아니었다. 오늘 A1에서 남은 파일이 없는 상태로 127.0.0.1 공개와 공개 없음을 두 번씩 시험했는데 네 번 모두 1이었다. Mac VM의 default 값을 물려받는다는 앞선 추정은 커널 동작으로는 맞다(default를 0으로 두면 재현된다). 하지만 9월 28일의 10분 멈춤이 그 때문이었는지는 그날 VM 상태를 남겨 두지 않아 확인할 수 없다.
같은 문제가 netavark 저장소에 이슈 #1497로 올라와 있다. 2026-08-09에 macOS의 Podman machine에서 compose로 internal·일반 네트워크를 함께 쓰다 발견한 사례로, 우리와 상황이 같다. 고치는 PR #1498이 열려 있지만 2026-10-08 현재 병합되지 않았고, 최신 릴리스 v2.1.0에도 같은 조건이 남아 있다.
해결 우선: 원인이 어찌되었든 forwarding 값을 수정하자
원인을 몰랐던 동안에도 서비스가 오래 멈추지 않은 것은 증상이 되는 값을 직접 확인하는 코드 덕분이었다. scripts/stack.sh는 compose 명령을 감싼 스크립트인데, 컨테이너를 띄우는 명령(up·start·restart·run) 뒤에는 늘 public 브리지의 forwarding을 읽고 0이면 1로 바꾼다. 배포·인수·복구가 모두 이 함수를 사용하도록 했다.
# scripts/lib/stack-lib.sh (줄임)
bridge_forwarding_check() {
  local net="$1" iface val
  iface="$(rt network inspect "${net}" --format '{{.NetworkInterface}}' 2>/dev/null || true)"
  [[ -n "${iface}" ]] || return 0
  if [[ "${LOCATION}" == "mac" ]]; then
    val="$(podman machine ssh -- "cat /proc/sys/net/ipv4/conf/${iface}/forwarding" | tr -d '\r\n')"
  else
    val="$(cat "/proc/sys/net/ipv4/conf/${iface}/forwarding")"
  fi
  [[ -z "${val}" || "${val}" == "1" ]] && return 0
  warn "브리지 ${net}(${iface}) 의 forwarding 이 ${val} 입니다 — 컨테이너 아웃바운드가 막힙니다 (G35). 켭니다"
  if [[ "${LOCATION}" == "mac" ]]; then
    podman machine ssh -- "sudo sysctl -w net.ipv4.conf.${iface}.forwarding=1"
  else
    sudo sysctl -w "net.ipv4.conf.${iface}.forwarding=1"
  fi
}Code language: Bash (bash)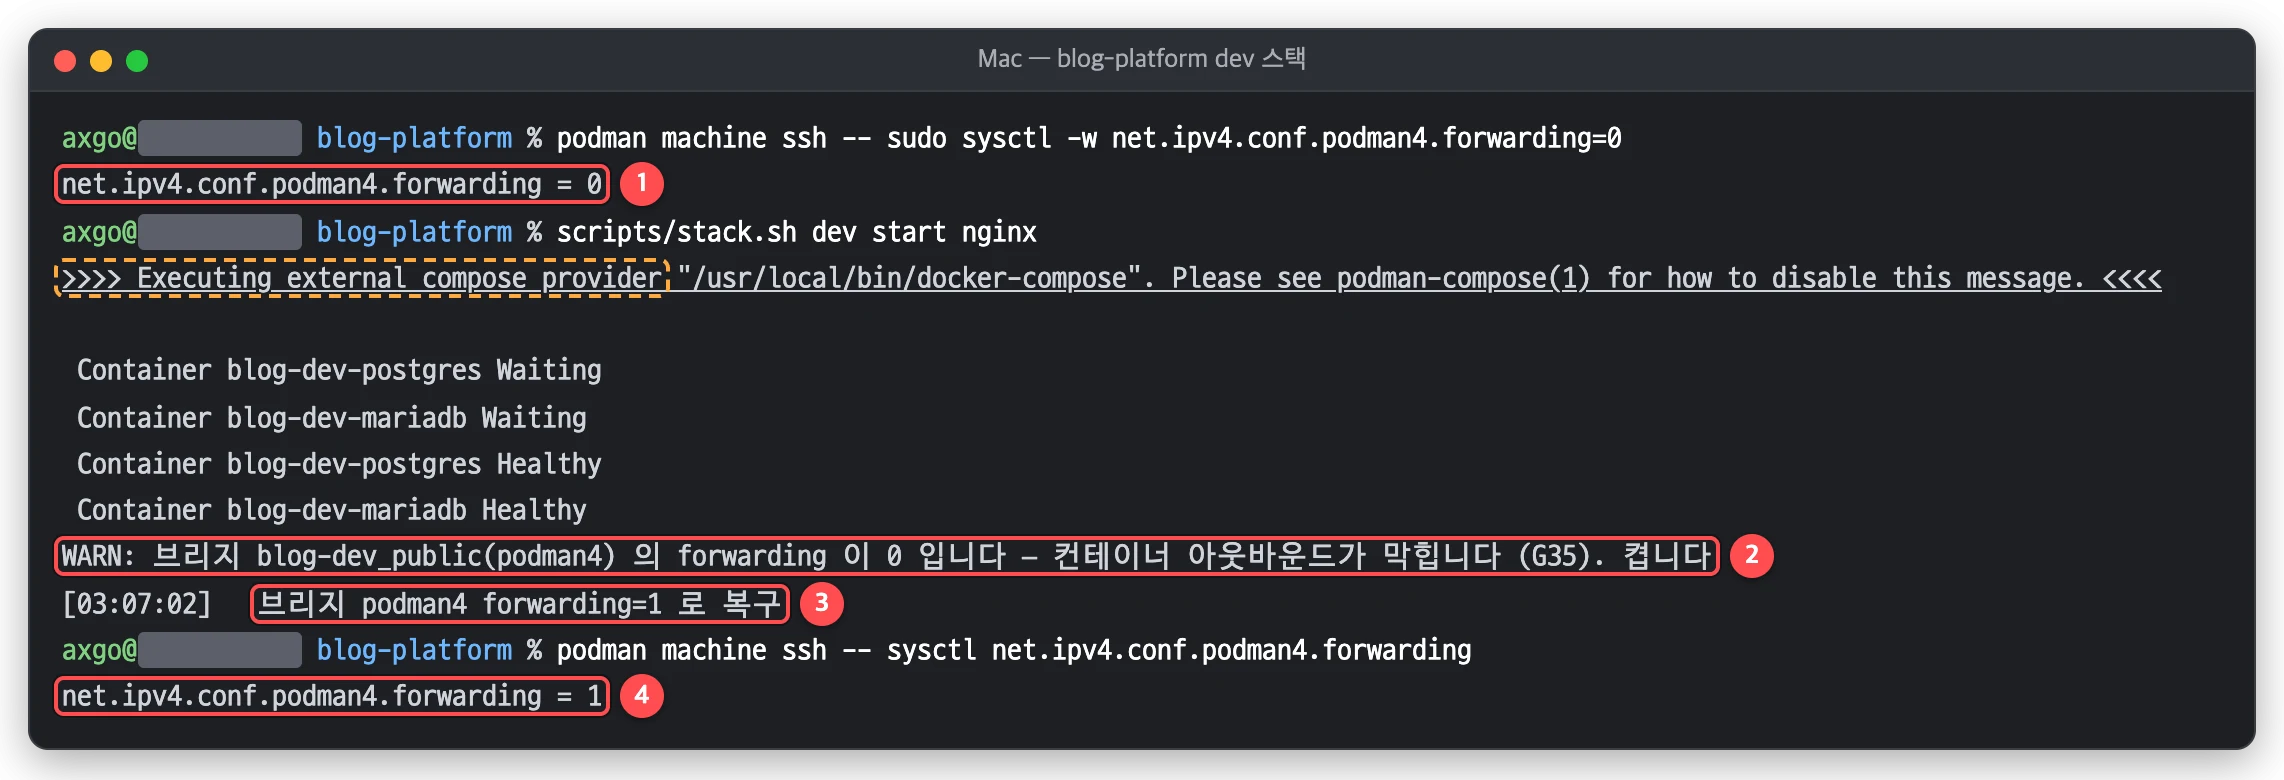
A1에서는 10분마다 도는 healthcheck.sh가 같은 값을 확인하도록 했다. 0이면 수정하고 경고 메일을 보내며, 고치지 못하면 위험 등급으로 이메일 알림을 보내도록 했다.
근본 대책은 남은 파일을 지우는 것이다. 브리지는 없는데 파일만 남은 것을 아래처럼 찾을 수 있다. Mac에서는 podman machine ssh로 VM에 들어가서 작업하고, 리눅스 서버에서는 호스트에서 작업해야 한다.
for f in /run/sysctl.d/10-netavark-*.conf; do
  br=${f##*/10-netavark-}; br=${br%.conf}
  [ -e "/sys/class/net/$br" ] || echo "남은 파일: $f"
doneCode language: Bash (bash)
이 파일을 지우면 다음에 같은 이름을 받는 브리지는 정상 값으로 생긴다. 지금은 보정 코드가 컨테이너를 띄울 때마다 돌고 있어 그대로 두었고, netavark 수정판이 나오면 보정 없이도 되는지 다시 확인할 생각이다.
그래도 Docker 대신 Podman을 쓰는 이유
이 문제는 Podman(netavark) 쪽 결함이다. 그래도 Docker로 돌아갈 생각은 없다. 오히려 이번 일을 겪으면서 Podman을 고른 이유가 더 분명해졌다.
| Mac (개발) | A1 (운영) | |
|---|---|---|
| OS | Fedora CoreOS 44 (Podman machine, libkrun) | Oracle Linux 10.2 aarch64 |
| Podman | 6.0.2 | 5.8.2 |
| netavark | 2.0.0 | 1.17.2 |
| compose | Docker Compose v5.6.0 | Docker Compose v5.6.0 |
Mac과 서버(A1)에서 같은 문제 = 같은 해결방법을 적용할 수 있다
처음 운영 서버 계획은 Ubuntu에 Docker Engine이었다. 하지만 OS를 Oracle Linux 10으로 바꾸면서 런타임도 Podman으로 바꿨는데, 그 이유는 dev(macOS podman machine)와 prod(OL10)에서 Podman 운영문제 해결방법을 공유하기 위한 것이 한몫 한다. 이번이 정확히 그런 경우였다. Mac에서 먼저 겪고 만든 검사 코드가 A1에서 고치지 않고도 같은 문제를 해결할 수 있고, 원인도 Mac에서 재현한 순서를 A1에서 그대로 재현할 수 있었다. 컨테이너 관리차원에서도 compose 파일 하나로 양쪽의 차이점을 최소화해 운영 편의성을 높일 수 있었다.
컨테이너 데몬이 돌지 않는다
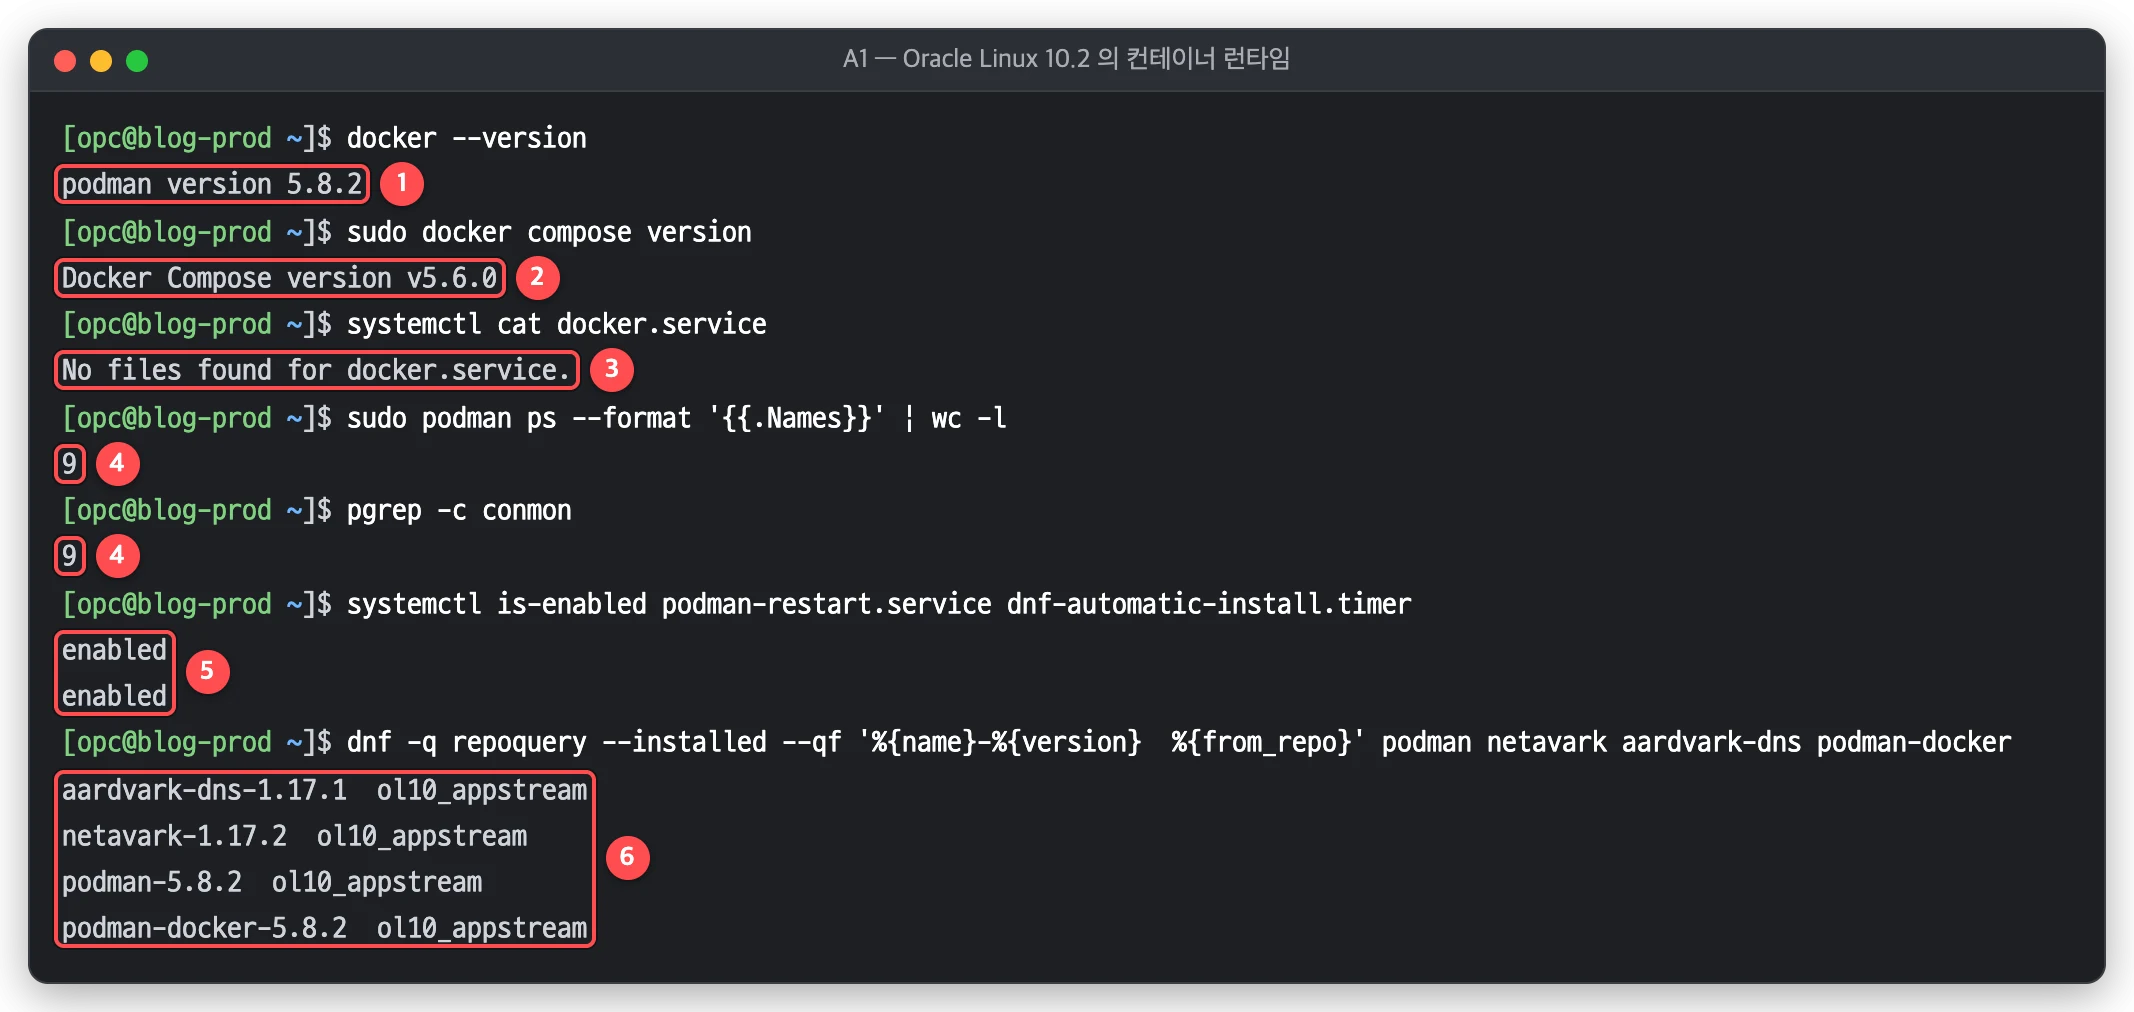
OCI A1에는 Docker 데몬(dockerd)이 없다. 컨테이너마다 conmon 프로세스가 하나씩 붙어 있고, 재부팅 뒤 컨테이너를 다시 띄우는 일은 systemd의 podman-restart.service가 한다. 데몬 하나에 모든 컨테이너가 매달린 구조가 아니어서, 런타임 패키지를 업데이트해도 떠 있는 컨테이너가 같이 내려가지 않는다.
podman-restart.service는 사람이 멈춰 둔 컨테이너는 다시 띄우지 않는다. 운영을 Mac으로 넘기고 A1에서 멈춰 둔 컨테이너가 재부팅 때 저절로 살아나면 같은 Cloudflare Tunnel에 커넥터가 둘 붙는데, 이 동작 덕분에 그런 일이 생기지 않는다.
OS(OL10) 패키지 저장소로 관리 가능하며, Docker 명령을 그대로 사용할 수 있다
Podman·netavark·aardvark-dns·podman-docker 모두 Oracle Linux 10의 기본 패키지 저장소(ol10_appstream)를 사용한다. 따로 저장소를 붙이지 않아도 되고, dnf-automatic이 OS 보안 업데이트와 함께 올려 준다. podman-docker를 깔면 docker 명령이 Podman으로 연결되고, docker compose는 Docker Compose를 그대로 부른다. Docker 기준으로 쓴 스크립트와 compose 파일을 고치지 않고 그대로 쓸 수 있다. (신경쓸 일이 줄어든다!)
결정적으로 라이선스 걱정이 없고, 들여다보기 쉽다
Docker Desktop은 직원 250명 초과 또는 연매출 1천만 달러 초과 조직이면 유료 구독이 필요하다(Docker FAQ). Podman과 Podman Desktop은 Apache 2.0 오픈 소스라 그런 조건이 없다. Mac에서 Docker Desktop을 Podman Desktop으로 바꾼 이야기는 예전 글에 적었다.
이번 원인을 찾을 때도 Podman 쪽 구조가 도움이 됐다. netavark가 쓴 값이 /run/sysctl.d에 파일로 남아 있었고, 그 파일 내용이 곧 단서였다. 브리지를 만들고 지우는 코드가 bridge.rs 파일 하나에 모여 있어서 원인을 추적해 나가며 따라가기 쉬웠다.
정리
- 컨테이너가 DNS는 되는데 TCP만 멈추면 브리지의 forwarding 값부터 본다. Mac에서는
podman machine ssh로 VM 안의 값을 본다. - Podman에서 internal 네트워크를 쓴다면
/run/sysctl.d/10-netavark-*.conf중 브리지 없이 남은 파일이 있는지 확인한다. 재부팅하면 사라지는 파일이라 가끔 생기는 문제처럼 보인다. - 원인이 확실하지 않을 때는 증상이 되는 값을 직접 확인하고 고치는 코드를 먼저 넣는다. 우리는 원인을 세 번 다르게 봤지만, 그 코드가 들어간 뒤로는 사람이 손대지 않아도 복구됐다.
- Mac과 서버의 런타임을 맞춰 두면 개발 환경에서 문제를 재현하고 고친 코드를 운영에 그대로 쓸 수 있다. Podman을 고른 가장 큰 이유가 이것이었다.