Cloudflare 대시보드에서도 봇 요청을 필터로 볼 수 있다. 하지만 최근 31일 동안 어떤 봇이 언제 와서 어떤 주소를 받아 갔는지 한 시간 단위로 나눠 세려면 API 가 낫다. Cloudflare 는 Free 요금제에서도 GraphQL Analytics API 를 쓸 수 있게 해 두었다. 이 API 를 파이썬 표준 라이브러리만으로 다루는 CLI trace.py 를 만들었다. 처음에는 구글 광고 크롤러가 언제 와서 무엇을 가져가는지 보려고 만들어서 명령 이름과 예시가 그 크롤러를 기준으로 되어 있다. 필터 글자만 바꾸면 Googlebot 이나 다른 검증 봇에도 그대로 쓸 수 있다.
구글 크롤러를 로그로 구분하는 방법과 이 도구로 본 방문 기록은 구글 크롤러 로그 구분하기 글에 정리했고 여기서는 코드를 다룬다. 외부 패키지는 쓰지 않았다. urllib.request 로 GraphQL 을 부르고 concurrent.futures 로 31일치를 동시에 받는다. 구글 IP 대역과 대조할 때는 ipaddress 를 쓴다. 처음 버전은 한 번 실행하는 데 46초가 걸렸는데 고친 뒤에는 3~5초로 줄었다. 무엇을 바꿨는지도 숫자와 함께 적어 둔다.
목차
대시보드 대신 GraphQL API 로 받은 이유
대시보드의 Analytics 화면은 필터 하나를 걸고 숫자를 보기에 좋다. 그런데 “어떤 봇이 어느 날 몇 시에 몰려 와서 어떤 주소를 받아 갔나” 처럼 시간·주소·상태 코드·IP 를 한꺼번에 나눠 세는 질문은 필터를 바꿔 가며 답하기 어렵다. 예를 들어 이 사이트에서는 사이트 확인을 맡는 Google-Display-Ads-Bot 이 하루 한 번씩 오는 기간이 있었고, 광고 크롤러 Mediapartners-Google 은 몇 시간씩 몰아서 페이지를 가져가는 때가 있었다. 특정 봇의 이런 방문 패턴을 확인하려면 31일치 요청을 한 시간 단위로 나눠 User-Agent·호스트·주소·상태 코드·IP 별로 세어야 한다. 같은 질문을 다시 하게 될 테니 코드로 만들어 두기로 했다.
Cloudflare 는 Free 요금제에서도 GraphQL Analytics API 를 쓸 수 있다. 다만 데이터셋마다 한도가 있고, 한도 값은 settings 노드로 조회한다. 내 존의 httpRequestsAdaptiveGroups 는 이랬다.
| 항목 | 값 | 뜻 |
|---|---|---|
notOlderThan | 2,678,400초 | 31일 전까지만 읽을 수 있다 |
maxDuration | 2,592,000초 | 쿼리 하나의 시간 범위는 30일까지 |
maxPageSize | 10,000 | 쿼리 하나가 돌려주는 행은 10,000개까지 |
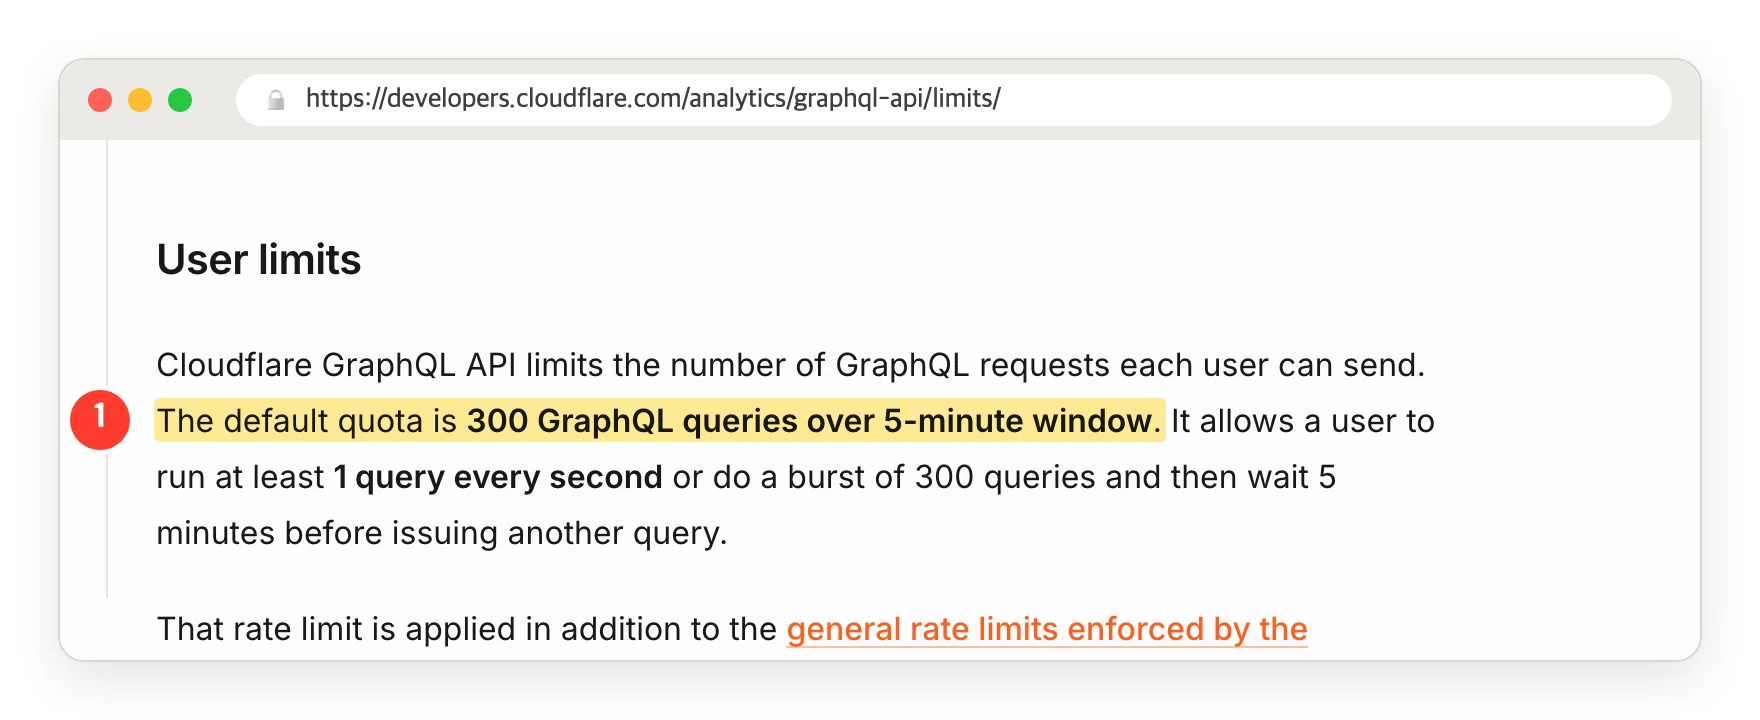
여기에 사용자당 5분에 300 쿼리라는 호출 한도가 있고 이름이 Adaptive 로 끝나는 데이터셋은 표본 추출(adaptive sampling)된 값이 섞여 나온다. 한도와 표본 추출을 놓고 이렇게 정했다.
- 외부 패키지 없이 파이썬 3.9 이상에서 돈다. 이 맥(macOS 26.6.2)의
/usr/bin/python3가 3.9.6 이라 거기서도 돌려 봤다. - 토큰은 환경 변수
CLOUDFLARE_API_TOKEN으로만 받는다. - 하루 단위로 나눠 받고 행 한도에 걸리거나 표본이 섞인 구간은 다시 받는다.
- User-Agent 는 그대로 믿지 않고 구글이 공개한 IP 대역과 대조한다.
- 그래도 남는 추정값은
~·×N으로 표시한다.
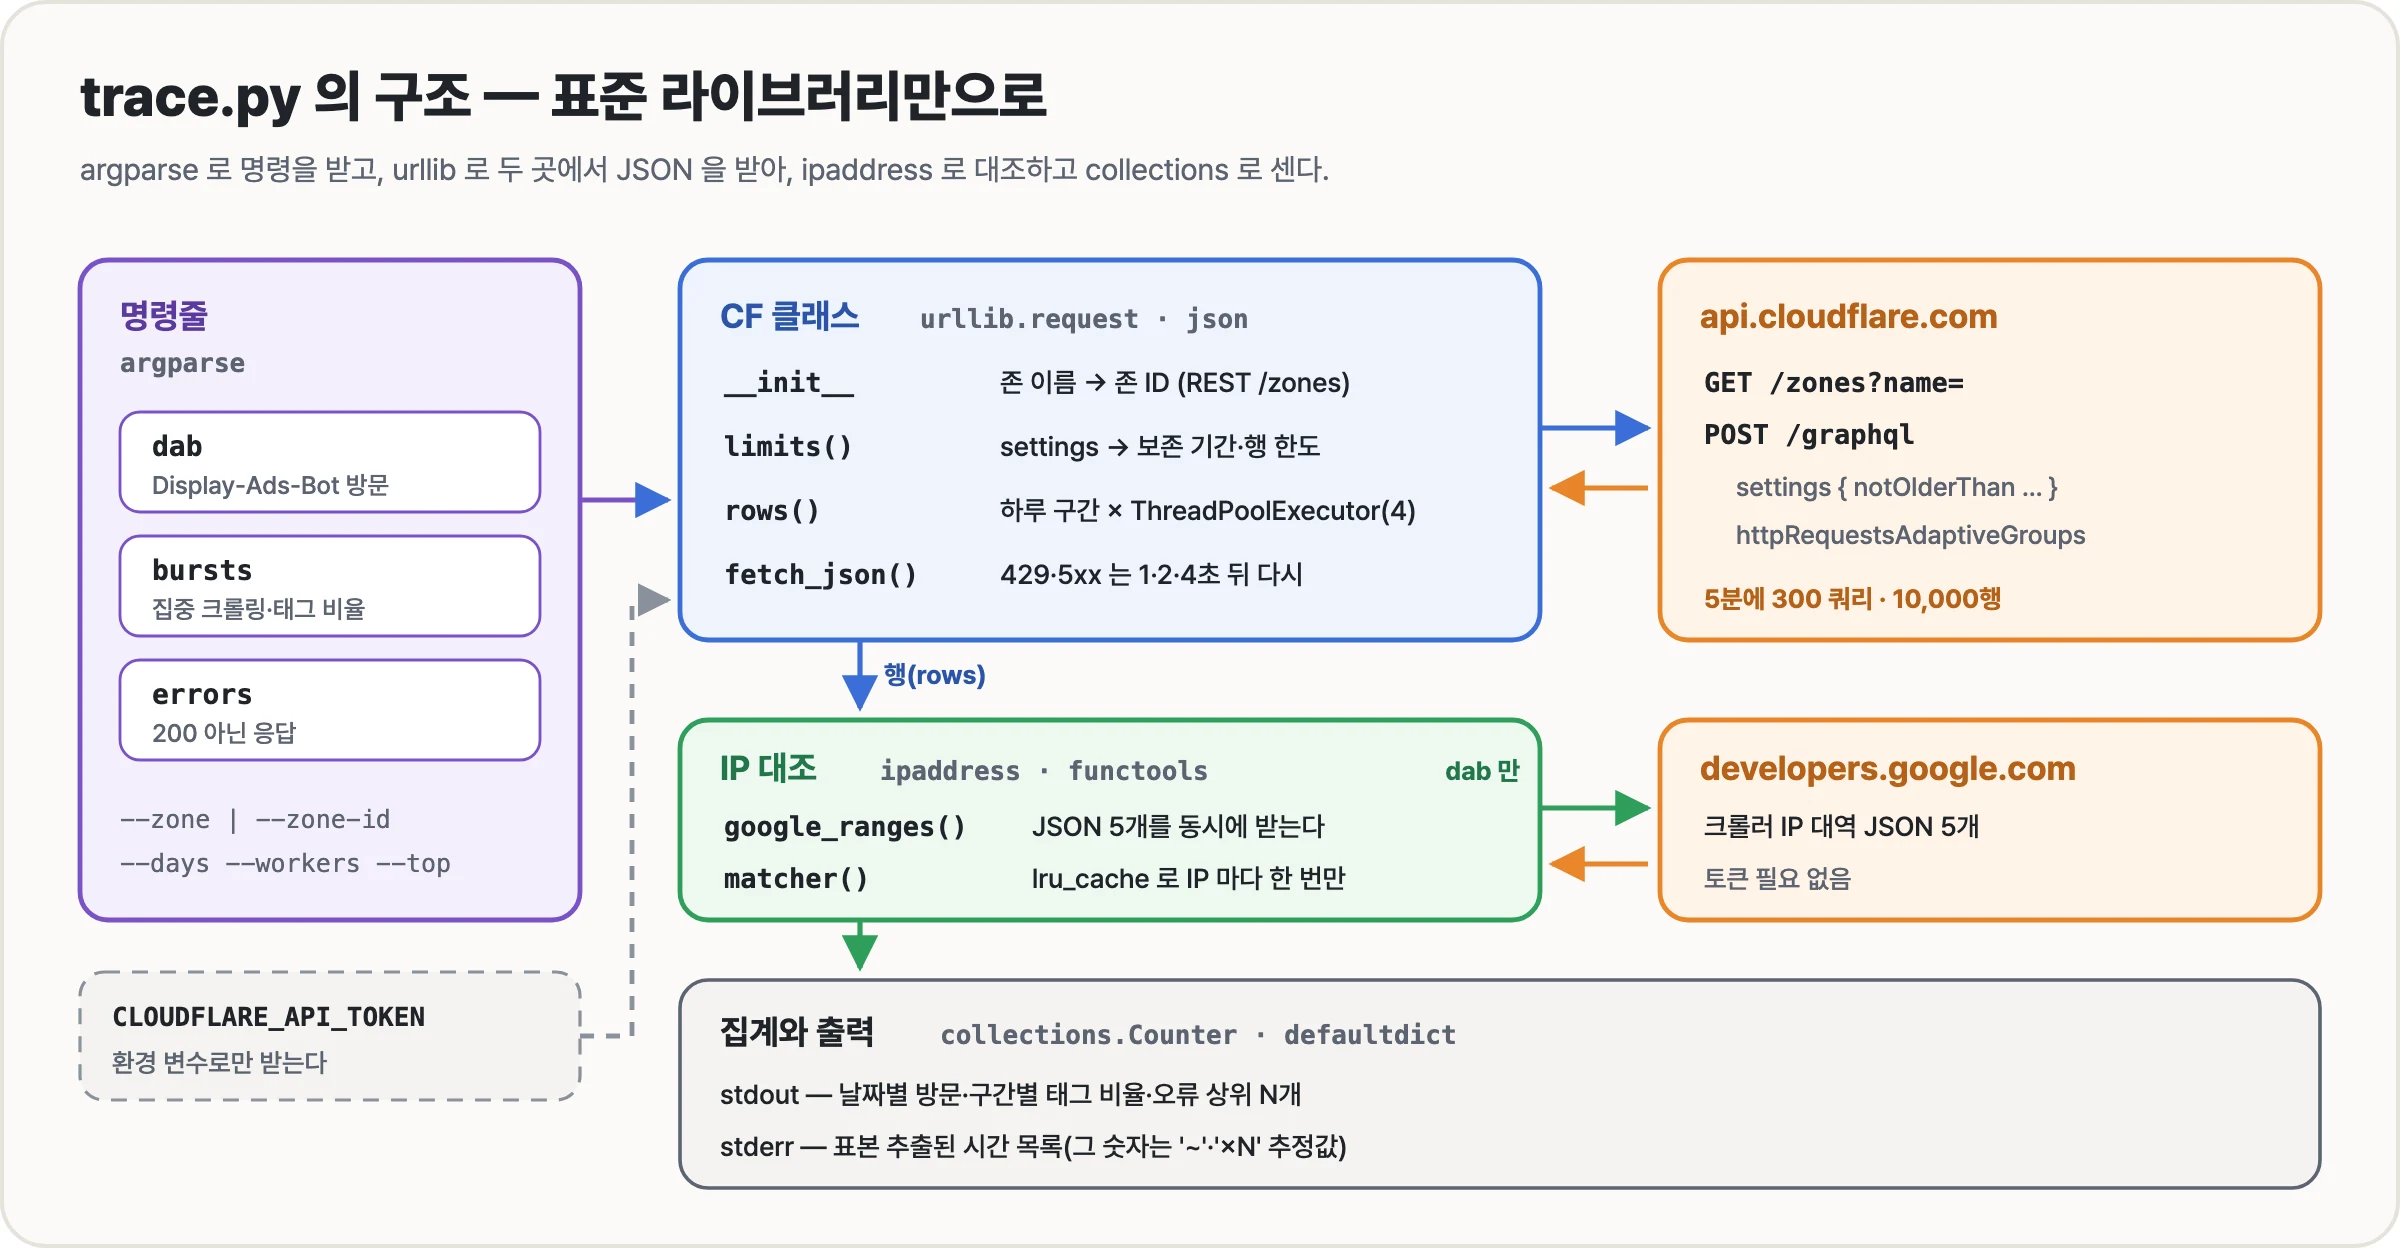
아래는 자기 존의 한도를 확인하는 최소 예제다. 토큰에는 Zone → Analytics → Read 권한이 있어야 하고 존 이름으로 존 ID 를 찾으려면 Zone → Zone → Read 도 필요하다.
# cf_limits.py — 사용법: CLOUDFLARE_API_TOKEN=... python3 cf_limits.py example.com
import json, os, sys, urllib.request

API = 'https://api.cloudflare.com/client/v4'
TOKEN = os.environ['CLOUDFLARE_API_TOKEN']


def call(url, body=None):
    req = urllib.request.Request(
        url, data=json.dumps(body).encode() if body else None,
        headers={'Authorization': f'Bearer {TOKEN}', 'Content-Type': 'application/json'})
    with urllib.request.urlopen(req, timeout=60) as r:
        return json.load(r)


zone = call(f'{API}/zones?name={sys.argv[1]}')['result'][0]['id']
q = '''query($z: String!) { viewer { zones(filter: {zoneTag: $z}) {
  settings { httpRequestsAdaptiveGroups { enabled notOlderThan maxDuration maxPageSize } } } } }'''
r = call(f'{API}/graphql', {'query': q, 'variables': {'z': zone}})
if r.get('errors'):                      # GraphQL 오류는 HTTP 200 으로 온다
    sys.exit(r['errors'][0]['message'])
s = r['data']['viewer']['zones'][0]['settings']['httpRequestsAdaptiveGroups']
print(json.dumps(s, indent=2))
print(f"보존 {s['notOlderThan'] / 86400:.0f}일 · 한 번에 {s['maxDuration'] / 86400:.0f}일 · {s['maxPageSize']:,}행")
Code language: Python (python)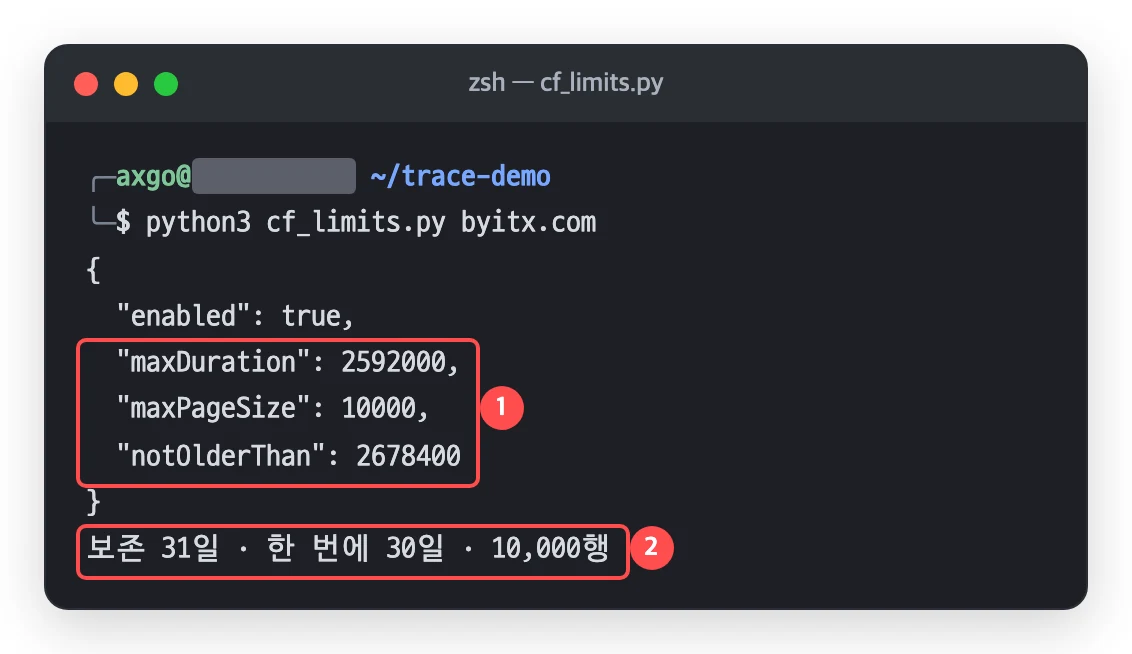
urllib.request 로 GraphQL 부르기
GraphQL 을 쓴다고 클라이언트 라이브러리가 따로 필요하지는 않다. 엔드포인트 하나에 {"query": …, "variables": …} JSON 을 POST 하면 된다. trace.py 는 HTTP 호출을 함수 하나에 모았다.
def fetch_json(url, body=None, headers=None, tries=4):
    """GET(body 가 있으면 POST) 뒤 JSON 을 돌려준다. 429·5xx·네트워크 오류는 1·2·4초 쉬고 다시 보낸다."""
    data = json.dumps(body).encode() if body is not None else None
    req = urllib.request.Request(url, data=data, headers={'User-Agent': UA, **(headers or {})})
    for i in range(tries):
        try:
            with urllib.request.urlopen(req, timeout=90) as r:
                return json.load(r)
        except urllib.error.HTTPError as e:         # URLError 의 하위 클래스라 먼저 잡는다
            if e.code not in RETRY or i == tries - 1:
                raise
        except OSError:                             # URLError·타임아웃·연결 끊김
            if i == tries - 1:
                raise
        time.sleep(2 ** i)
Code language: Python (python)Request에data를 넘기면 POST 로 나간다. 응답 객체는 파일처럼 읽을 수 있어서json.load(r)로 바로 풀었다.HTTPError는URLError의 하위 클래스이고URLError는OSError의 하위 클래스다. 그래서except순서가 중요하다.HTTPError를 먼저 잡아 429·5xx 만 다시 보내고 연결 끊김이나 타임아웃은 그 아래OSError에서 잡는다.socket.timeout은 3.10 부터TimeoutError의 별칭이 됐고 그 전에도OSError의 하위 클래스였다. 이렇게 잡으면 3.9 에서도 같이 걸린다.- 다시 보낼 때는 1초, 2초, 4초씩 쉬고 네 번째에도 실패하면 예외를 그대로 올린다.
GraphQL 은 쿼리가 잘못돼도 HTTP 200 에 errors 배열을 담아 돌려준다. 상태 코드만 보면 이걸 놓치기 때문에 gql() 이 따로 확인한다.
def gql(self, query, variables):
    r = self.call(f'{API}/graphql', {'query': query, 'variables': dict(variables, z=self.zone)})
    if r.get('errors'):
        raise APIError(r['errors'][0]['message'])
    return r['data']['viewer']['zones'][0]
Code language: Python (python)
존 ID 와 시작·끝 시각처럼 실행마다 바뀌는 값은 variables 로 넘기고 코드에 고정된 필터 문자열만 쿼리 문자열에 넣었다. 토큰을 명령줄 인자로 받지 않은 건 셸 히스토리와 ps 출력에 남기 때문이다.
sampleInterval 이 1보다 크면 그 시간만 다시 받는다
httpRequestsAdaptiveGroups 가 돌려주는 count 가 늘 정확한 값은 아니다. 데이터가 많으면 Cloudflare 가 일부만 읽고 비율을 곱한 추정값을 준다. 곱하는 비율은 avg { sampleInterval } 이다. 1이면 다 센 값이고 10이면 10건 중 1건만 읽고 10을 곱한 값이다.
Cloudflare 문서는 한 달을 한 번에 조회하지 말고 하루나 일주일 단위로 나눠 받은 뒤 클라이언트에서 합치라고 권한다. 같은 쿼리라도 실행할 때마다 표본 비율이 달라질 수 있다는 설명도 있다.
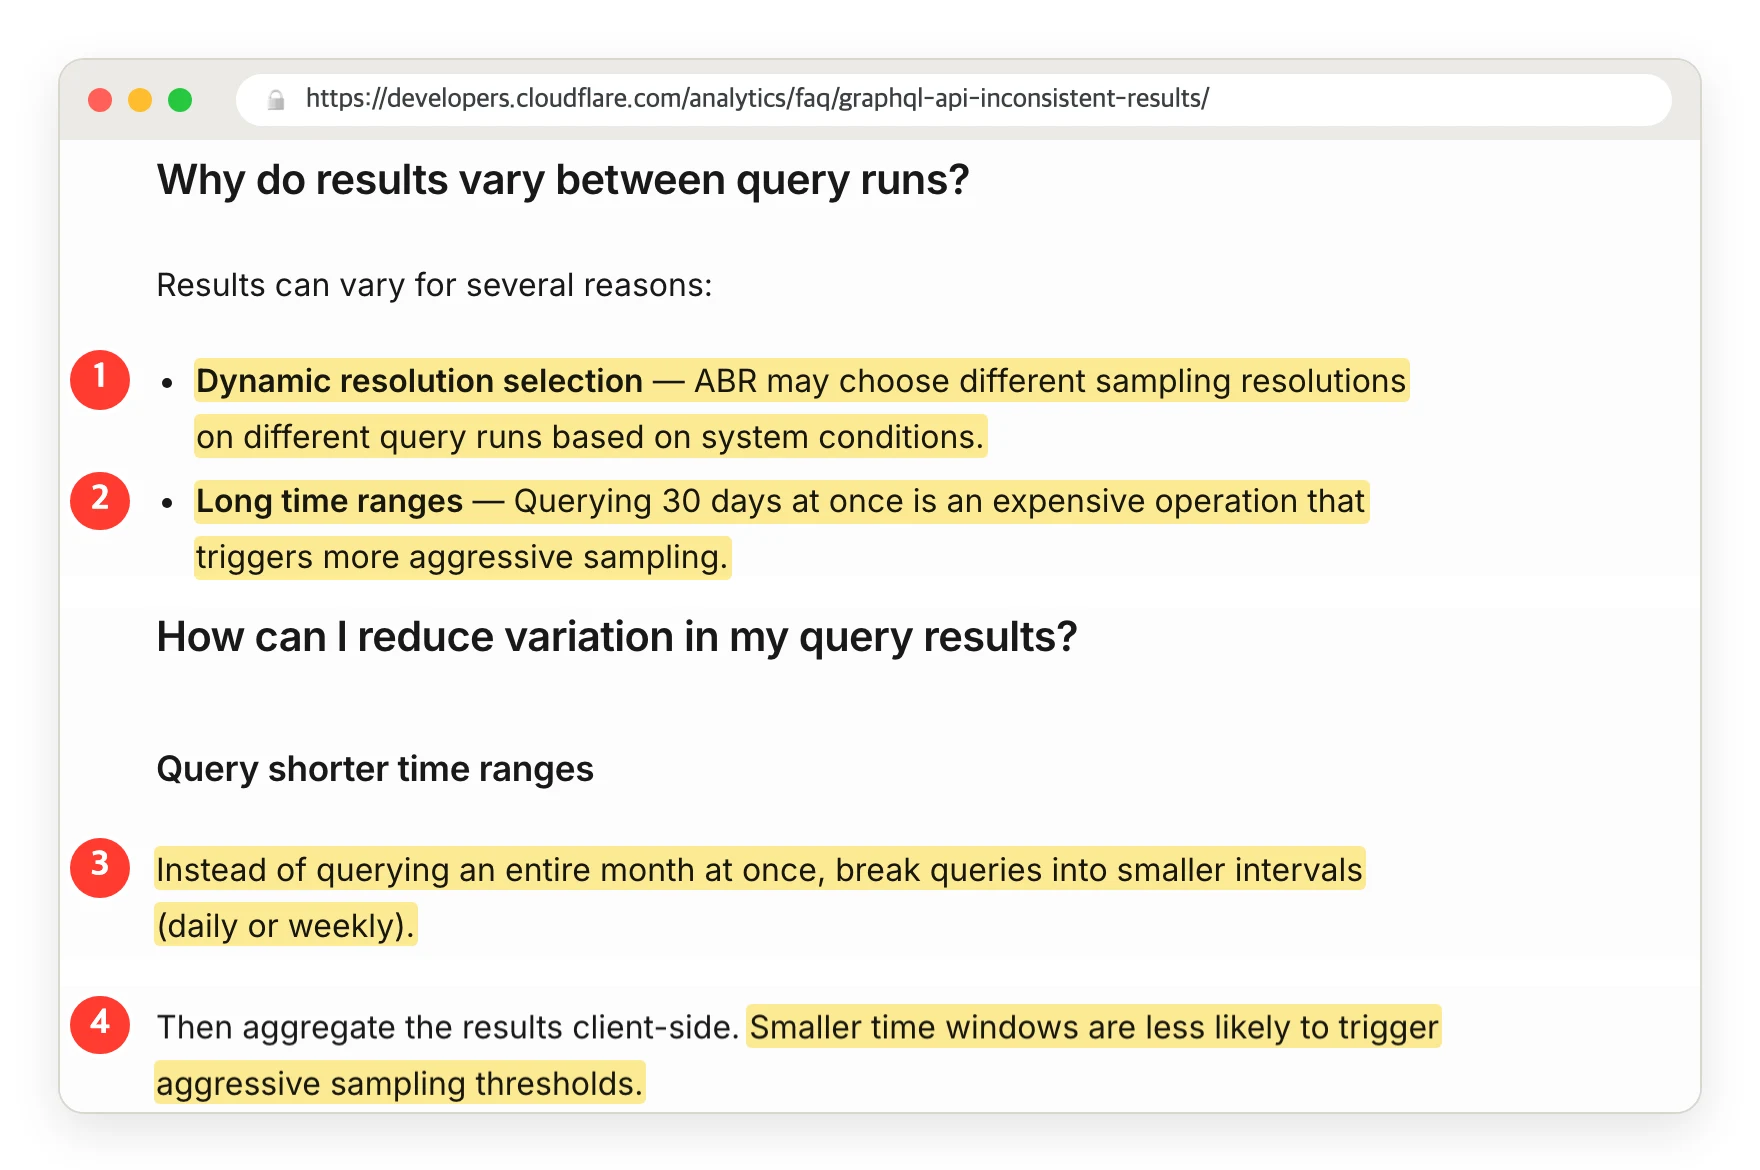
내 존에서 재 보니 결과는 조금 달랐다. 트래픽이 몰린 시간은 30일로 받든 하루로 받든 한 시간으로 받든 sampleInterval 이 같았다. Mediapartners-Google 의 30일 count 합은 한 번에 받아도 6,647, 하루씩 30번 받아 더해도 6,647 이었다. 10월 1일 16시는 어떤 실행에서는 ×6, 다른 실행에서는 ×1.33 으로 나왔다. 실행마다 다르다는 문서 설명과 맞는다.
구간을 나눈 효과는 보존 기한 쪽에서 분명했다. 31일 경계에서 몇 시간 안쪽으로 시작하는 쿼리는 그날 행이 통째로 ×10 이 됐다. 시작 시각을 옮겨 가며 재 보니 경계에서 4시간 뒤까지 시작한 쿼리는 ×10, 8시간 뒤에 시작한 쿼리는 정확한 값이었다. 30일을 한 번에 받으면 Display-Ads-Bot 방문이 70건(다른 실행에서는 73건)으로 나왔지만 실제로는 69건이었다.
rows() 는 이 결과를 반영해 구간을 다룬다.
아래 예제로 자기 존의 보존 기한 쪽 하루를 확인할 수 있다. 두 번째 인자는 User-Agent 에 들어 있는 글자다.
# edge_check.py — 사용법: CLOUDFLARE_API_TOKEN=... python3 edge_check.py example.com Googlebot
import datetime as dt, json, os, sys, urllib.request

API = 'https://api.cloudflare.com/client/v4'
TOKEN = os.environ['CLOUDFLARE_API_TOKEN']
KST = dt.timezone(dt.timedelta(hours=9))
HOUR = dt.timedelta(hours=1)
Q = '''query($z: String!, $since: Time!, $until: Time!, $ua: String!) { viewer { zones(filter: {zoneTag: $z}) {
  r: httpRequestsAdaptiveGroups(limit: 10000, filter: {datetime_geq: $since, datetime_lt: $until, userAgent_like: $ua})
  { count avg { sampleInterval } dimensions { datetimeHour } } } } }'''


def call(url, body=None):
    req = urllib.request.Request(
        url, data=json.dumps(body).encode() if body else None,
        headers={'Authorization': f'Bearer {TOKEN}', 'Content-Type': 'application/json'})
    with urllib.request.urlopen(req, timeout=60) as r:
        return json.load(r)


def hours(s, e):
    v = {'z': zone, 'ua': f'%{sys.argv[2]}%', 'since': f'{s:%Y-%m-%dT%H:%M:%SZ}', 'until': f'{e:%Y-%m-%dT%H:%M:%SZ}'}
    rows = call(f'{API}/graphql', {'query': Q, 'variables': v})['data']['viewer']['zones'][0]['r']
    return {dt.datetime.fromisoformat(r['dimensions']['datetimeHour'].replace('Z', '+00:00')): (r['count'], r['avg']['sampleInterval'])
            for r in rows}


zone = call(f'{API}/zones?name={sys.argv[1]}')['result'][0]['id']
now = dt.datetime.now(dt.timezone.utc).replace(second=0, microsecond=0)
since = now - dt.timedelta(days=31) + dt.timedelta(minutes=10)     # 보존 기한(31일) 바로 안쪽
day = hours(since, since + dt.timedelta(days=1))
print(f'{since.astimezone(KST):%m-%d %H:%M} 부터 하루를 한 번에 받은 결과 중 표본이 섞인 시간과, 그 시간만 다시 받은 결과')
hot = [(h, n, iv) for h, (n, iv) in sorted(day.items()) if iv > 1]
if not hot:
    print('  표본이 섞인 시간 없음')
for h, n, iv in hot:
    n2, iv2 = hours(max(since, h), h + HOUR).get(h, (0, 1))
    print(f'  {h.astimezone(KST):%m-%d %H}시   하루 쿼리 {n:>5} (×{iv:g})   →   한 시간 쿼리 {n2:>5} (×{iv2:g})')
Code language: Python (python)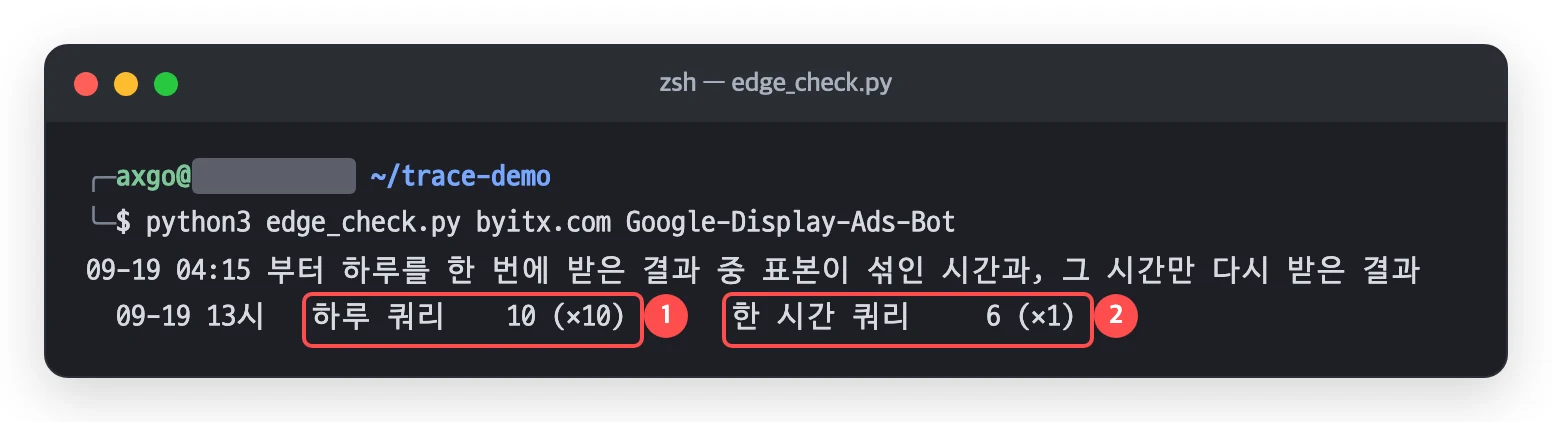
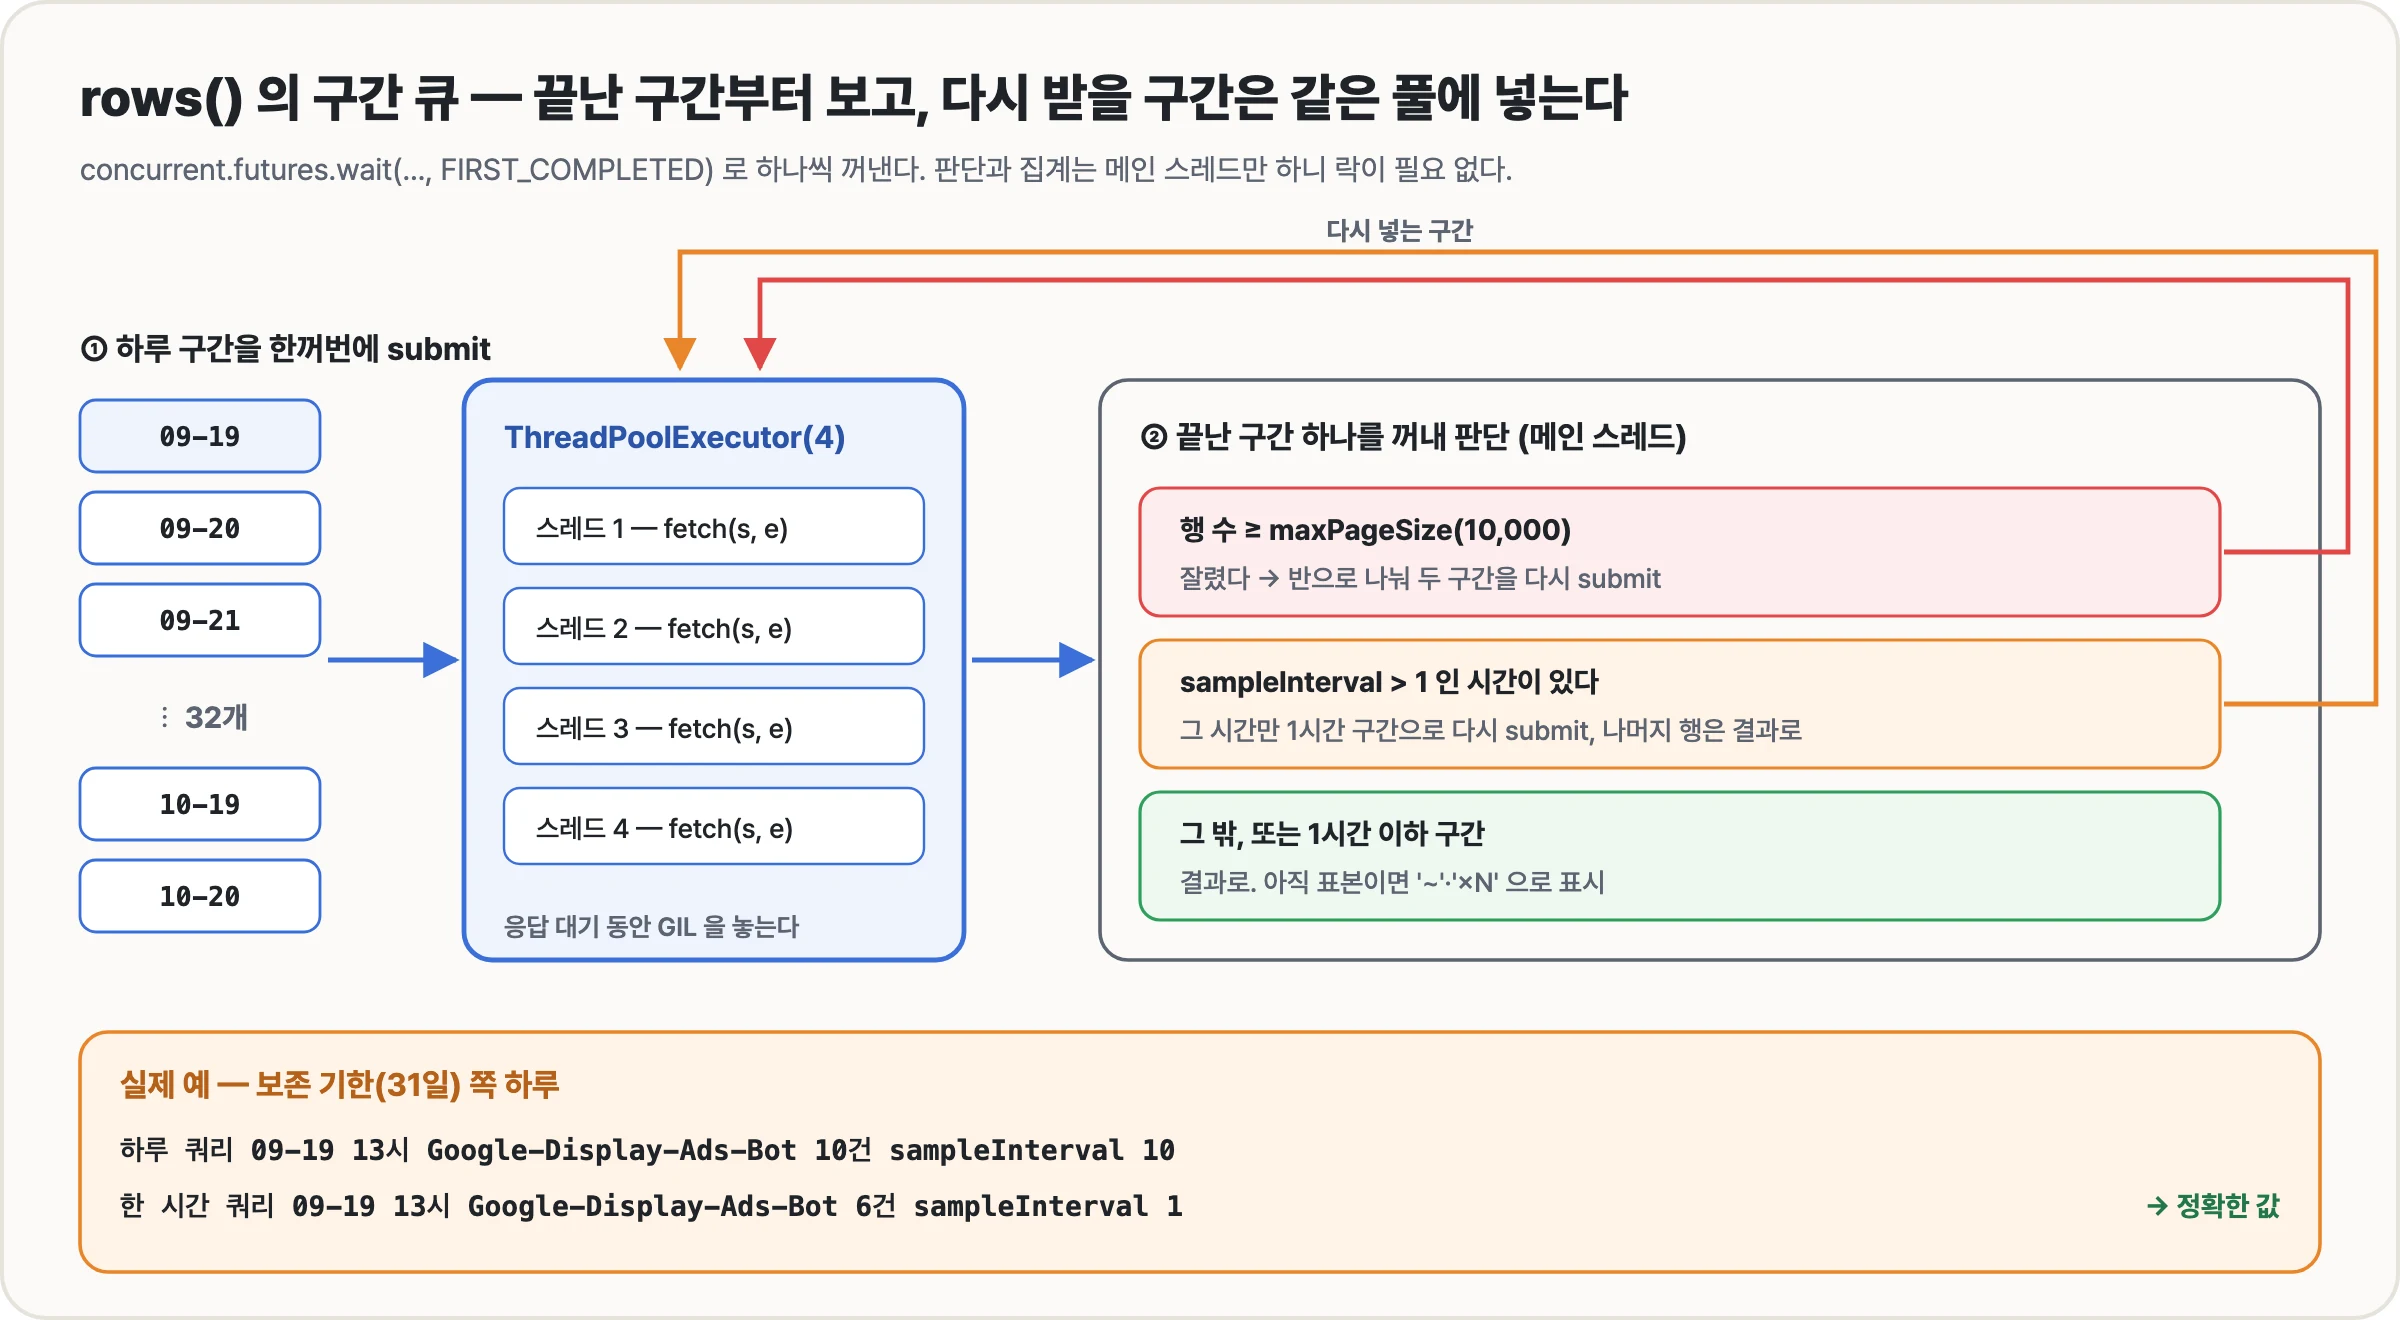
rows() 는 아래 루프에서 하루 구간을 모두 submit() 한 뒤 끝난 구간부터 꺼내 처리한다.
out, sampled = [], []
edge = start == now - keep + dt.timedelta(minutes=10)    # 보존 기한에서 시작하는가
with cfut.ThreadPoolExecutor(self.workers) as ex:
    todo, t = {}, start
    while t < now:
        # 보존 기한 쪽 첫날은 한 시간씩 받는다. 기한에서 몇 시간 안쪽으로 시작한 쿼리는 그날 행이 표본(×10)이
        # 되거나 아예 빠진다 — 행이 없으면 다시 받을 단서도 없다
        e = min(t + (HOUR if edge and t < start + DAY else DAY), now)
        todo[ex.submit(fetch, t, e)] = (t, e)
        t = e
    while todo:                             # 끝난 구간부터 꺼내고, 다시 받을 구간은 큐에 넣는다
        done, _ = cfut.wait(todo, return_when=cfut.FIRST_COMPLETED)
        for f in done:
            s, e = todo.pop(f)
            got = f.result()
            for r in got:
                r['utc'] = utc(r['dimensions']['datetimeHour'])
            if e - s > HOUR:
                if len(got) >= page:        # 잘렸다 — 어느 시간이 빠졌는지 모르니 반으로 나눈다
                    m = s + (e - s) / 2
                    for w in ((s, m), (m, e)):
                        todo[ex.submit(fetch, *w)] = w
                    continue
                hot = {r['utc'] for r in got if r['avg']['sampleInterval'] > 1}
                for h in sorted(hot):       # 표본이 섞인 시간만 한 시간짜리 구간으로 다시 받는다
                    w = (max(s, h), min(e, h + HOUR))
                    todo[ex.submit(fetch, *w)] = w
                got = [r for r in got if r['utc'] not in hot]
            else:
                if len(got) >= page:
                    print(f'경고: {s.astimezone(KST):%m-%d %H:%M} 부터 한 시간 안에서도 {page}행을 넘는다 — 잘렸다', file=sys.stderr)
                iv = max((r['avg']['sampleInterval'] for r in got), default=1)
                if iv > 1:
                    sampled.append((s, iv))
            for r in got:
                r['t'] = r['utc'].astimezone(KST)
            out.extend(got)
Code language: Python (python)- 행이
maxPageSize만큼 왔으면 결과가 잘린 것이다. 어느 시간이 빠졌는지 알 수 없으니 구간을 반으로 나눠 다시 넣는다. - sampleInterval 이 1보다 큰 행이 있으면 그 행의 시각(
datetimeHour)만 모아 한 시간짜리 구간으로 다시 넣고 나머지 행은 결과로 쓴다. - 한 시간 이하 구간인데도 표본이면 더 나눠 봐야 소용이 없으니 결과로 쓰고 그 시각을 모아 마지막에 stderr 로 알린다.
보존 기한 쪽에는 놓치기 쉬운 문제가 하나 더 있었다. 같은 날 밤에 다시 돌려 보니 dab 이 69건이 아니라 66건이었다. 31일 경계에서 8시간 안쪽으로 시작한 쿼리가 경계에서 17시간 뒤인 09-20 16시 방문 3건을 아예 돌려주지 않았다. 시작을 12시간 뒤로 옮기거나 그 한 시간만 받으면 3건이 정확히 나왔다. 표본에 걸리지 않은 행은 sampleInterval 같은 흔적도 없이 빠지니, 표본이 섞인 시간만 다시 받는 방식으로는 찾을 수 없다. 보존 기한부터 조회할 때 첫날을 처음부터 한 시간 단위로 받게 고친 이유다(edge 가 그 판정이다). 쿼리는 20개 남짓 늘었지만(dab 33번 → 55번) 시간은 5초 안팎이다.
ThreadPoolExecutor 로 46초를 3초대로
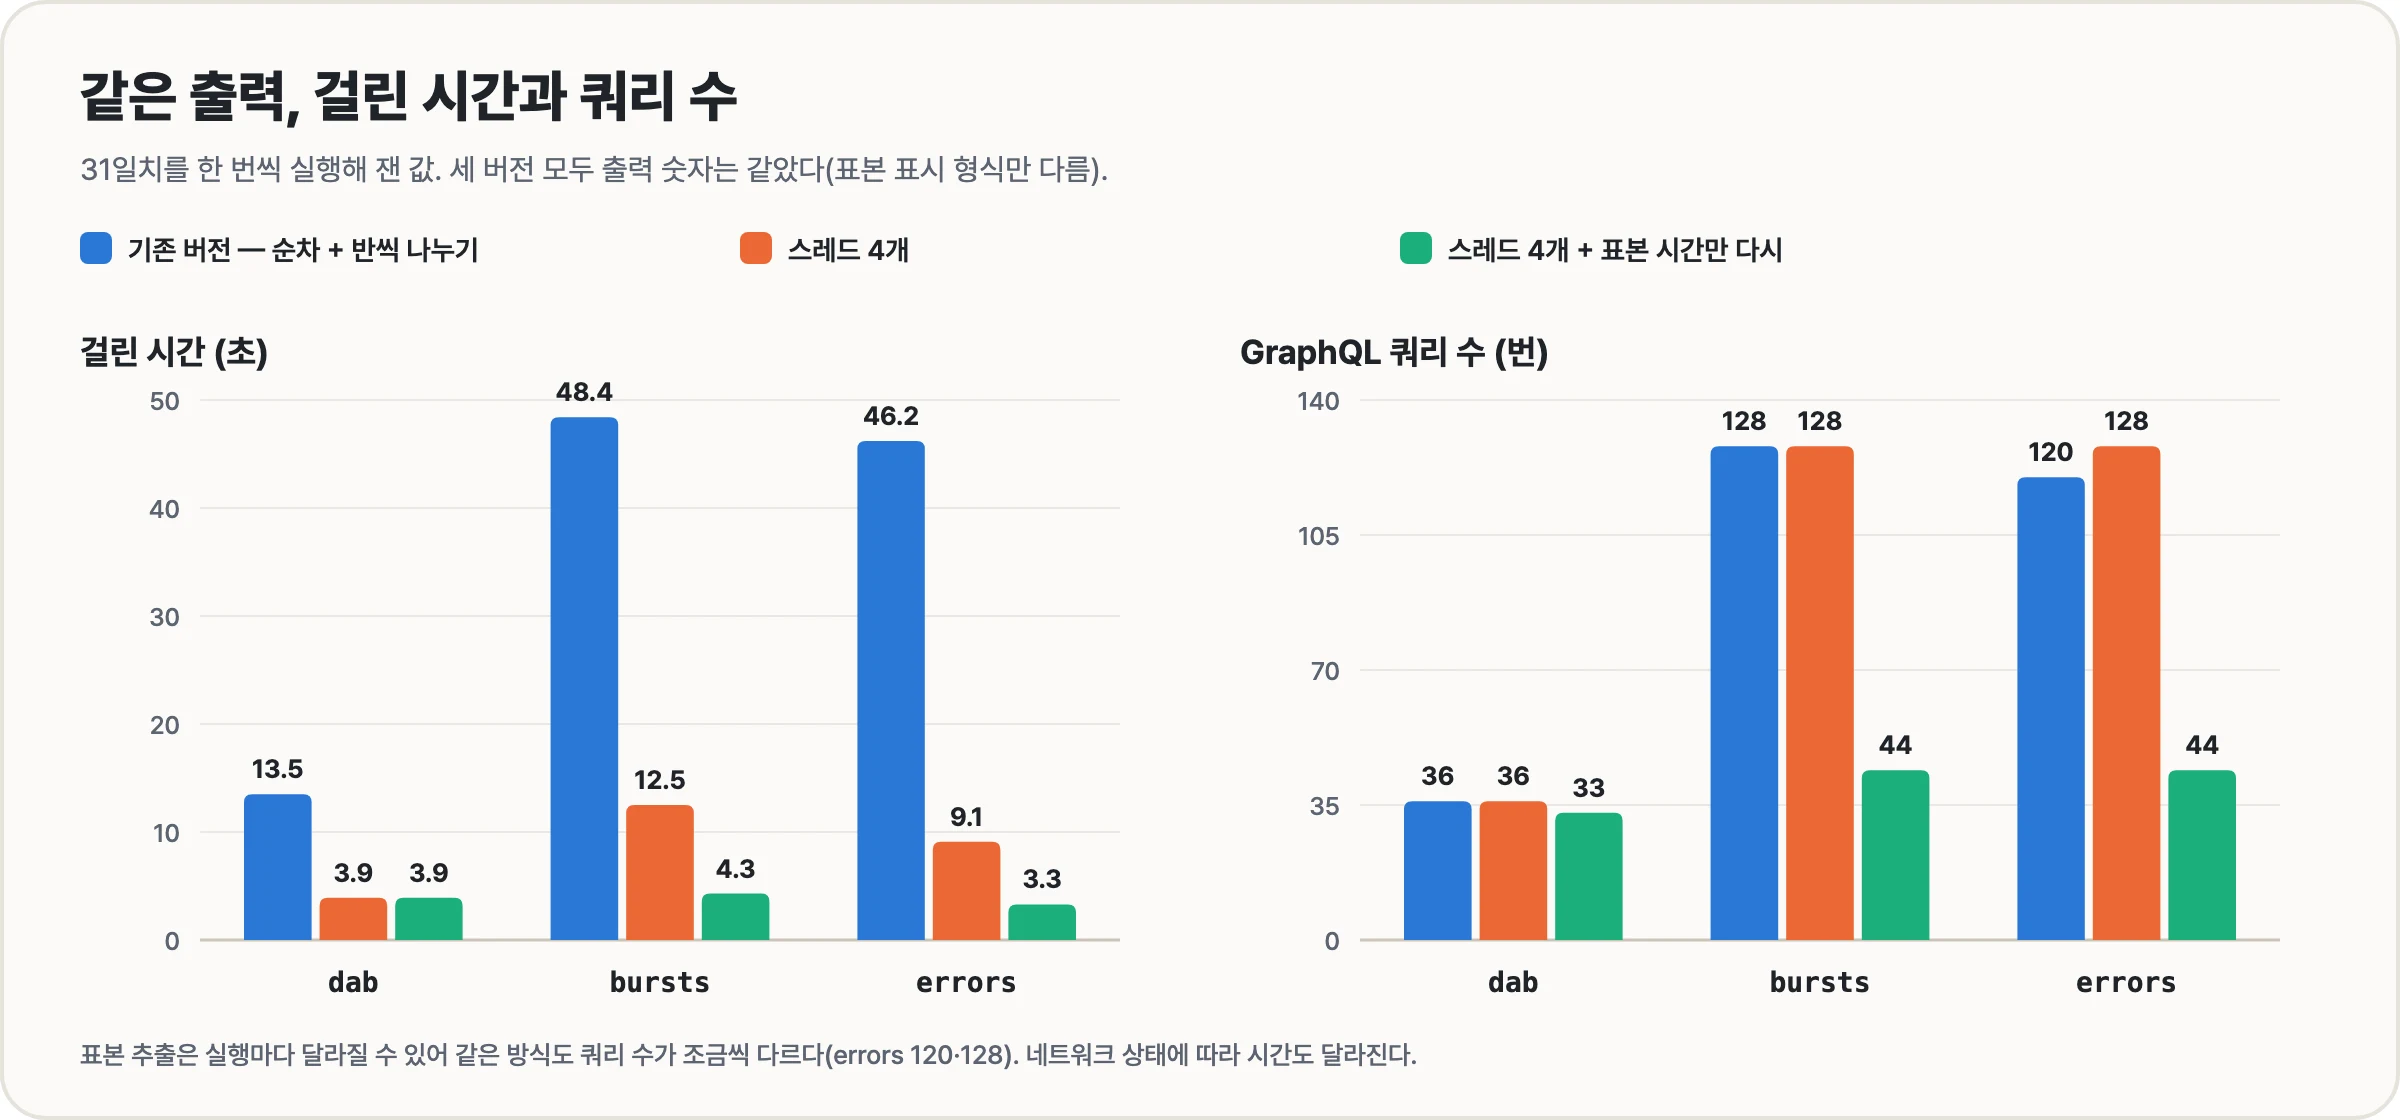
처음 버전은 구간을 하나씩 순서대로 받았다. list.pop(0) 으로 꺼내고 표본이면 구간을 반으로 나눠 todo[:0] = [...] 로 앞에 다시 넣었다. 이 방식은 표본이 섞인 시간이 하나만 있어도 하루를 12시간, 6시간, 3시간, 1.5시간, 45분 순으로 계속 나눈다. 31일치 bursts 는 128번, errors 는 120번 쿼리를 보냈고 46~48초가 걸렸다.
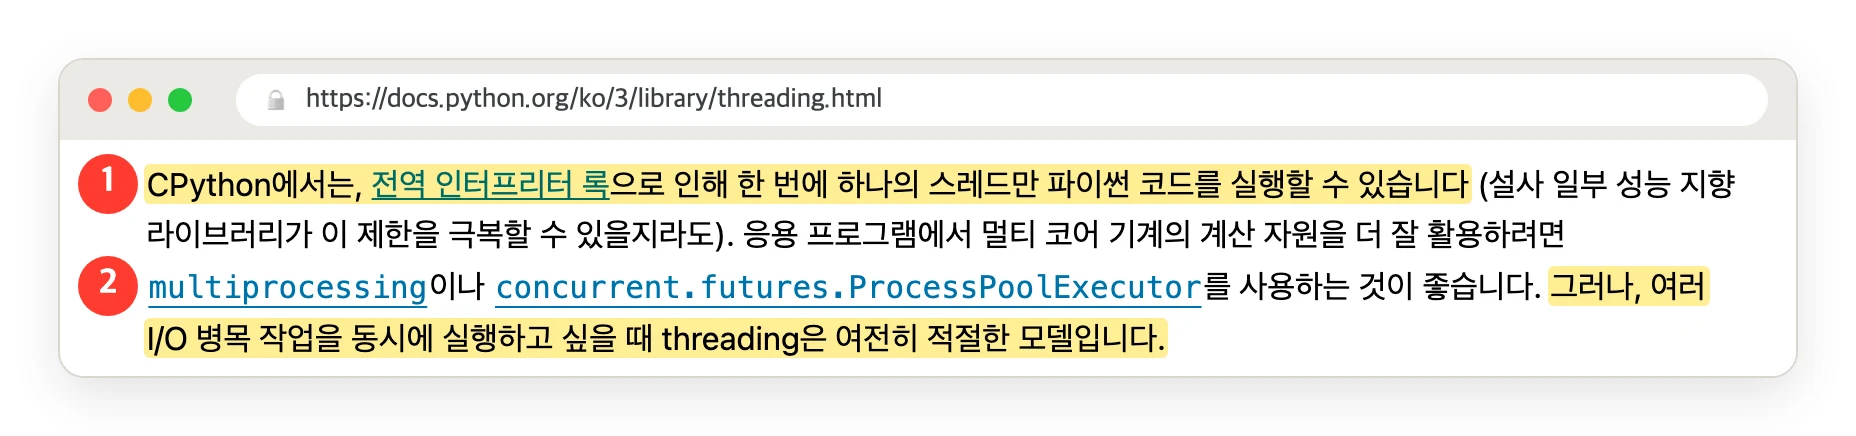
스크립트는 걸린 시간 대부분을 응답을 기다리는 데 썼다. CPython 은 GIL 때문에 한 번에 한 스레드만 파이썬 코드를 실행하지만 파이썬 문서도 I/O 대기가 많은 작업에는 threading 이 여전히 적절하다고 적고 있다.
ThreadPoolExecutor.map() 은 입력을 처음부터 다 알아야 한다. trace.py 는 받은 결과를 보고 구간을 더 만들기 때문에 submit() 으로 넣고 concurrent.futures.wait(…, return_when=FIRST_COMPLETED) 로 끝난 것부터 꺼낸다. 스레드는 fetch() 만 하고 판단과 집계는 메인 스레드가 한다. 여러 스레드가 함께 고치는 변수가 없으니 락도 필요 없다. 스레드에서 난 예외는 메인 스레드가 f.result() 를 부를 때 다시 올라온다.
나누는 방식도 바꿨다. 반씩 나누는 대신 sampleInterval 이 1보다 큰 시간만 한 시간짜리 구간으로 다시 받는다. 행 한도에 걸린 구간만 지금도 반으로 나눈다. 두 가지를 따로 재면 효과가 나뉘어 보인다. errors 기준으로 나누는 방식만 바꾸면(스레드 1개) 쿼리 44번에 28.1초, 스레드 4개만 쓰면 쿼리 128번에 9.1초, 둘 다 바꾸면 쿼리 44번에 3.3초였다.
| 명령 | 기존 버전 | 스레드 4개 | 스레드 4개 + 표본 시간만 다시 |
|---|---|---|---|
| dab | 13.5초 · 36번 | 3.9초 · 36번 | 3.9초 · 33번 |
| bursts | 48.4초 · 128번 | 12.5초 · 128번 | 4.3초 · 44번 |
| errors | 46.2초 · 120번 | 9.1초 · 128번 | 3.3초 · 44번 |
ThreadPoolExecutor 의 기본 스레드 수는 3.8 부터 min(32, os.cpu_count() + 4) 이고 3.13 부터는 os.process_cpu_count() 를 기준으로 한다. 코어가 16개인 이 맥에서는 20개가 된다. --workers 8 로 돌리면 errors 가 3.0초까지 줄었지만 같은 토큰으로 다른 작업도 Cloudflare API 를 부르기 때문에 기본값은 여유 있게 4로 뒀다. 첫날을 한 시간씩 받는 지금 코드로 실행 한 번에 쿼리가 55~69번이라 세 명령을 연달아 돌려도 5분 300 쿼리 안에 든다.
나누는 방식의 차이는 네트워크 없이도 확인할 수 있다. 아래 예제는 0.3초 걸리는 가짜 API 로 사흘치를 받는다. 이틀째 07시와 08시는 하루 쿼리로 받으면 표본, 한 시간 쿼리로 받으면 정확하다고 가정했다.
# queue_demo.py — 사용법: python3 queue_demo.py
# 네트워크 없이 trace.py 의 구간 큐를 흉내 낸다. 가짜 API 는 0.3초 걸리고, 시간마다 (시각, 건수, sampleInterval) 를 준다.
# 건수는 1분에 1건, SAMPLED 의 두 시간은 하루 쿼리로 받으면 표본(×6), 한 시간 이하 쿼리로 받으면 정확(×1)하다고 친다.
import concurrent.futures as cf, datetime as dt, threading, time

DAY, HOUR = dt.timedelta(days=1), dt.timedelta(hours=1)
SAMPLED = {dt.datetime(2026, 10, 1, 7), dt.datetime(2026, 10, 1, 8)}
calls, lock = 0, threading.Lock()


def fetch(s, e):
    global calls
    with lock:
        calls += 1
    time.sleep(0.3)
    out, h = [], s.replace(minute=0)
    while h < e:
        n = (min(e, h + HOUR) - max(s, h)) // dt.timedelta(minutes=1)
        out.append((h, n, 6 if h in SAMPLED and e - s > HOUR else 1))
        h += HOUR
    return out


def run(workers, mode):
    global calls
    calls, rows, t0 = 0, [], time.perf_counter()
    start = dt.datetime(2026, 9, 30)
    with cf.ThreadPoolExecutor(workers) as ex:
        todo = {ex.submit(fetch, start + i * DAY, start + (i + 1) * DAY): (start + i * DAY, start + (i + 1) * DAY) for i in range(3)}
        while todo:
            done, _ = cf.wait(todo, return_when=cf.FIRST_COMPLETED)
            for f in done:
                s, e = todo.pop(f)
                got = f.result()
                hot = {h for h, n, iv in got if iv > 1} if e - s > HOUR else set()
                if hot and mode == 'half':                  # 구간을 반씩 나눠 통째로 다시
                    m = s + (e - s) / 2
                    for w in ((s, m), (m, e)):
                        todo[ex.submit(fetch, *w)] = w
                    continue
                for h in sorted(hot):                       # 표본이 섞인 시간만 다시
                    todo[ex.submit(fetch, h, h + HOUR)] = (h, h + HOUR)
                rows += [r for r in got if r[0] not in hot]
    print(f'{mode:<4} workers={workers}  쿼리 {calls:>2}번  건수 합 {sum(n for _, n, _ in rows):,}  표본 행 {sum(iv > 1 for *_, iv in rows)}개  {time.perf_counter() - t0:.1f}초')


for mode in ('half', 'hour'):
    for workers in (1, 4):
        run(workers, mode)
Code language: Python (python)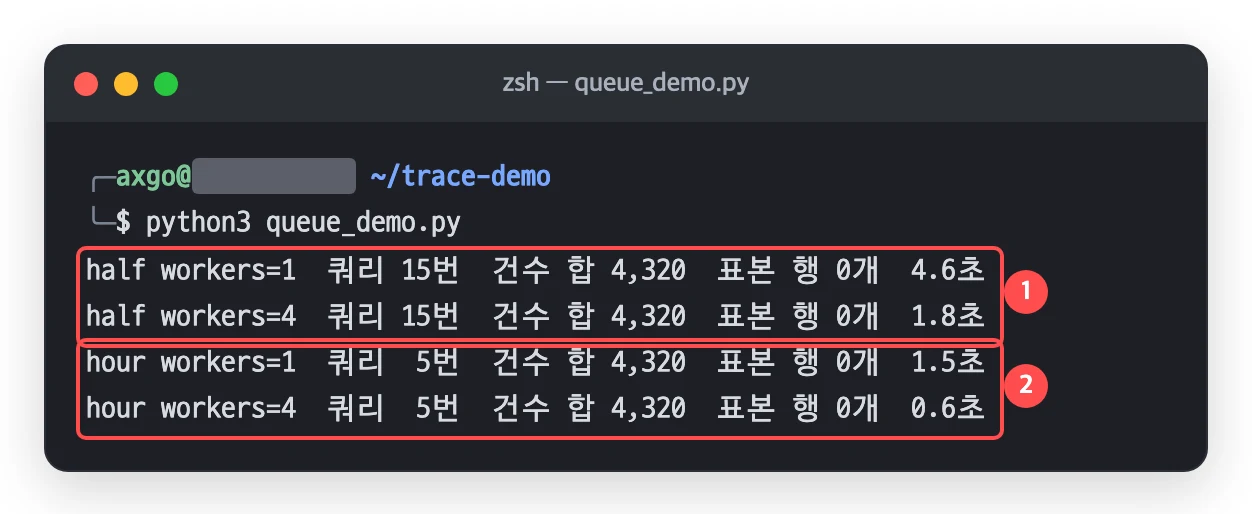
스크립트를 고치지 않고 실제 API 호출 수를 세려면 importlib 로 모듈을 불러와 CF.gql 을 감싸면 된다. 스레드가 동시에 부르니 카운터는 락으로 보호했다.
# bench.py — 사용법: CLOUDFLARE_API_TOKEN=... python3 bench.py trace.py errors --zone example.com
# trace 스크립트를 불러와 GraphQL 호출 수와 걸린 시간을 잰다. usage: python3 bench.py <스크립트> <인자…>
import importlib.util, sys, threading, time

path, args = sys.argv[1], sys.argv[2:]
spec = importlib.util.spec_from_file_location('trace_mod', path)
m = importlib.util.module_from_spec(spec); spec.loader.exec_module(m)
n, lock, orig = [0], threading.Lock(), m.CF.gql


def gql(self, q, v):
    with lock:
        n[0] += 1
    return orig(self, q, v)


m.CF.gql = gql
sys.argv = [path] + args
t = time.perf_counter()
m.main()
print(f'BENCH queries={n[0]} seconds={time.perf_counter() - t:.1f}', file=sys.stderr)
Code language: Python (python)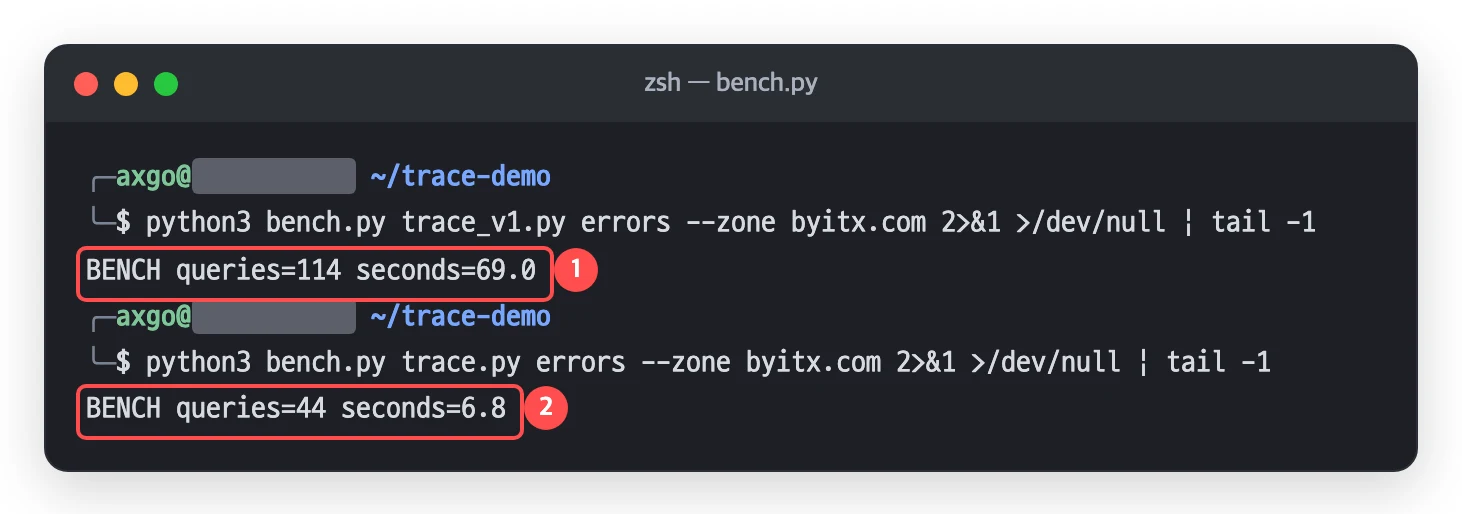
User-Agent 는 흉내 낼 수 있다 — ipaddress 로 구글 IP 대조
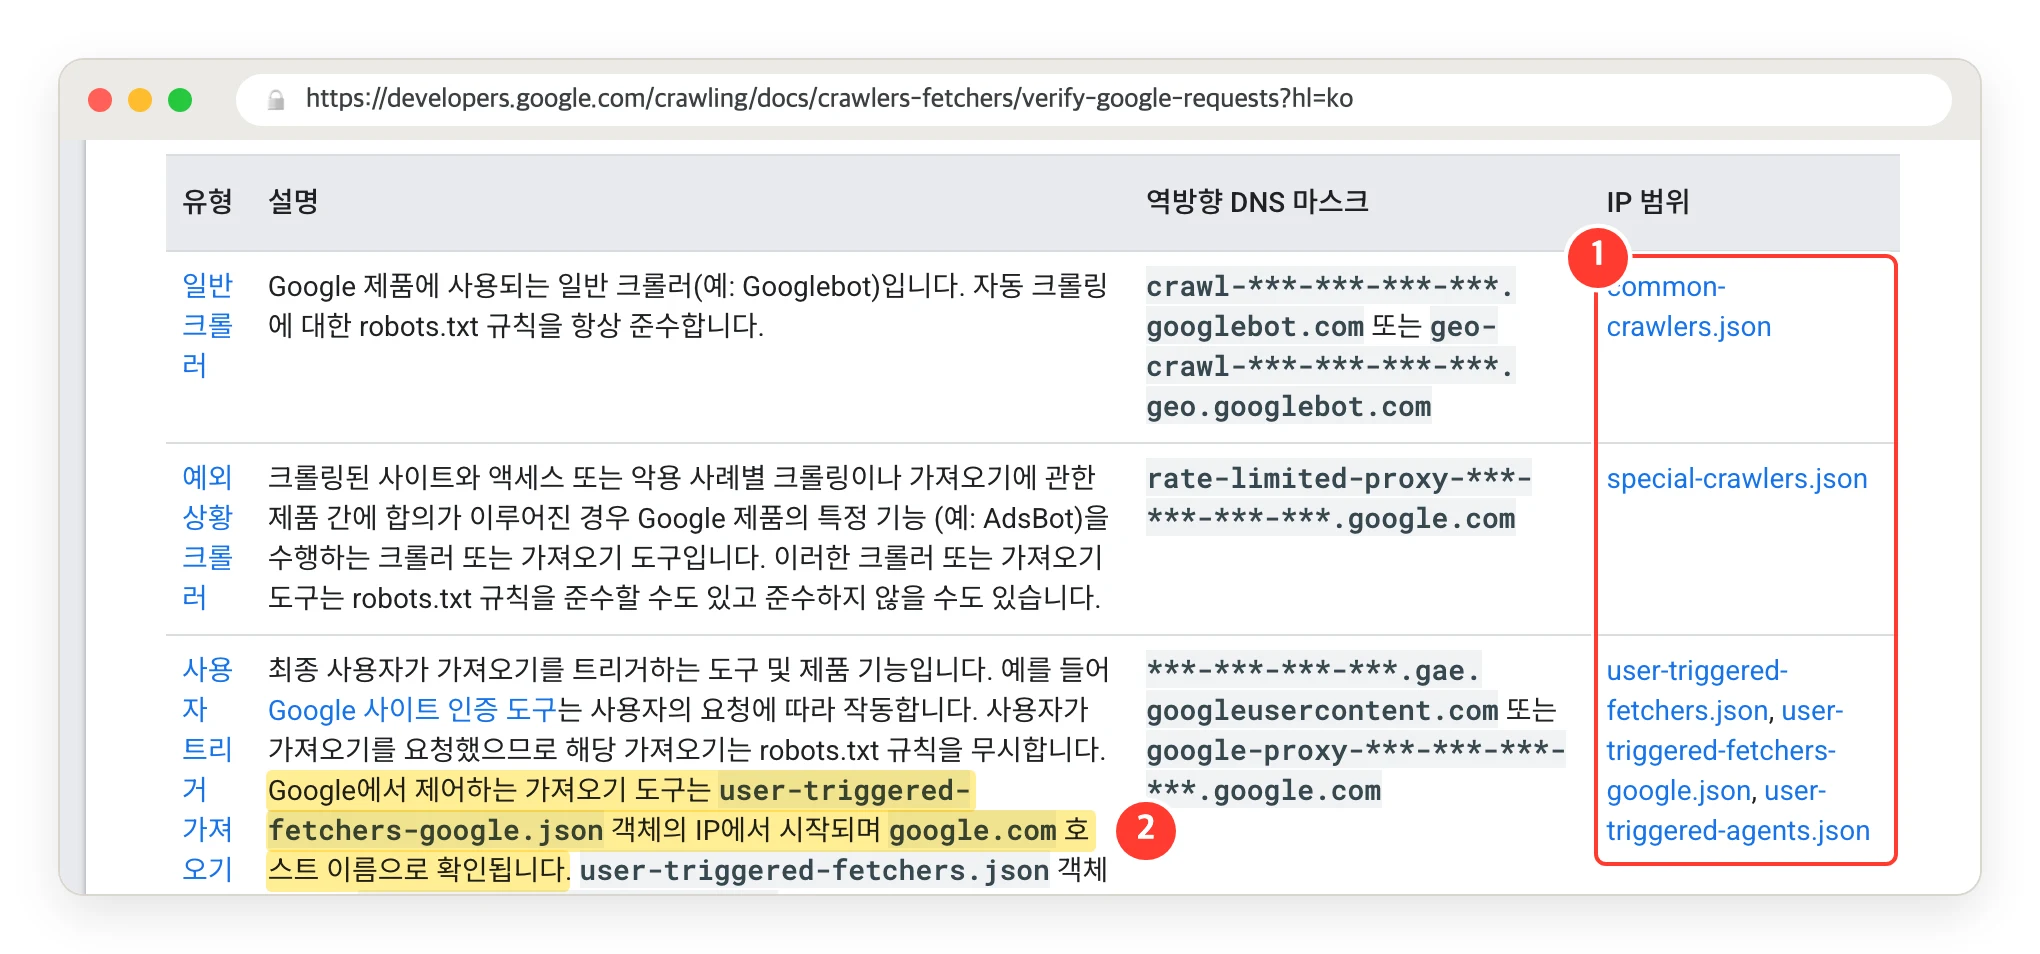
User-Agent 는 요청을 보내는 쪽이 마음대로 정한다. 구글은 크롤러가 쓰는 IP 대역을 JSON 파일로 공개하고 역방향 DNS 대신 이 목록과 대조하는 방법도 안내한다. 지금은 파일이 다섯 개다.
def google_ranges():
    """구글 크롤러 IP 대역 JSON 을 동시에 받아 {파일 이름: [네트워크…]} 로 돌려준다(순서는 RANGE_FILES)."""
    def one(name):
        prefixes = fetch_json(IPRANGES.format(name))['prefixes']
        return name, [ipaddress.ip_network(p.get('ipv4Prefix') or p.get('ipv6Prefix')) for p in prefixes]
    with cfut.ThreadPoolExecutor(len(RANGE_FILES)) as ex:
        return dict(ex.map(one, RANGE_FILES))


def matcher(nets):
    @functools.lru_cache(maxsize=None)              # 같은 IP 는 한 번만 대조한다
    def which(ip):
        a = ipaddress.ip_address(ip)                # IPv4 주소와 IPv6 대역의 in 은 오류 없이 False
        return next((name for name, ns in nets.items() if any(a in n for n in ns)), 'NOT-GOOGLE')
    return which
Code language: Python (python)ipaddress.ip_network()는'66.249.64.0/27'같은 문자열을 네트워크 객체로 만들고ip_address() in network로 포함 여부를 본다. IPv4 주소를 IPv6 대역과 비교해도 오류 없이False가 나오기 때문에 두 종류를 한 목록에 섞어 둬도 된다.- 다섯 파일을 합치면 대역이 2,181개다. 같은 IP 가 수십 번 나오니
functools.lru_cache로 IP 마다 한 번만 대조한다. 대역 사전은 해시할 수 없어 캐시 키로 쓸 수 없으니, 클로저로 감싸고 IP 문자열만 인자로 받게 했다. ex.map()은 결과를 입력 순서대로 돌려준다.dict(ex.map(...))의 순서가RANGE_FILES순서와 같아서 앞에 둔 대역부터 대조한다.
dab 은 GraphQL 을 받는 동안 IP 대역 JSON 도 받아 둔다. 스레드 하나짜리 풀에 google_ranges() 를 넣어 두고 결과는 필요할 때 result() 로 꺼낸다.
def cmd_dab(cf, days):
    with cfut.ThreadPoolExecutor(1) as ex:
        ranges = ex.submit(google_ranges)           # GraphQL 을 받는 동안 IP 대역 JSON 도 받는다
        rows = cf.rows('userAgent_like: "%Google-Display-Ads-Bot%"', 'datetimeHour clientRequestHTTPHost edgeResponseStatus clientIP', days)
        which = matcher(ranges.result())
Code language: Python (python)
실제로 대조가 필요했던 요청도 있었다. 최근 이틀 동안 Googlebot 을 User-Agent 에 넣고 온 IP 가운데 둘은 Cloudflare 의 검증 봇 분류(verifiedBotCategory)가 비어 있었고 구글 대역에도 없었다. 하나는 브라질에서 왔다. 아래 예제는 토큰 없이 돌아간다.
# is_google.py — 사용법: python3 is_google.py 66.249.66.1 1.1.1.1
import concurrent.futures as cf, ipaddress, json, sys, urllib.request

URL = 'https://developers.google.com/static/crawling/ipranges/{}.json'
FILES = ['common-crawlers', 'special-crawlers', 'user-triggered-fetchers',
         'user-triggered-fetchers-google', 'user-triggered-agents']


def load(name):
    with urllib.request.urlopen(URL.format(name), timeout=30) as r:
        return [ipaddress.ip_network(p.get('ipv4Prefix') or p.get('ipv6Prefix')) for p in json.load(r)['prefixes']]


with cf.ThreadPoolExecutor() as ex:                 # 파일 다섯 개를 동시에 받는다
    nets = dict(zip(FILES, ex.map(load, FILES)))
print(f'구글 IP 대역 {sum(map(len, nets.values())):,}개 (파일 {len(nets)}개)')
for ip in sys.argv[1:]:
    a = ipaddress.ip_address(ip)
    hit = next((name for name, ns in nets.items() if any(a in n for n in ns)), '구글 대역 아님')
    print(f'{ip:<26} {hit}')
Code language: Python (python)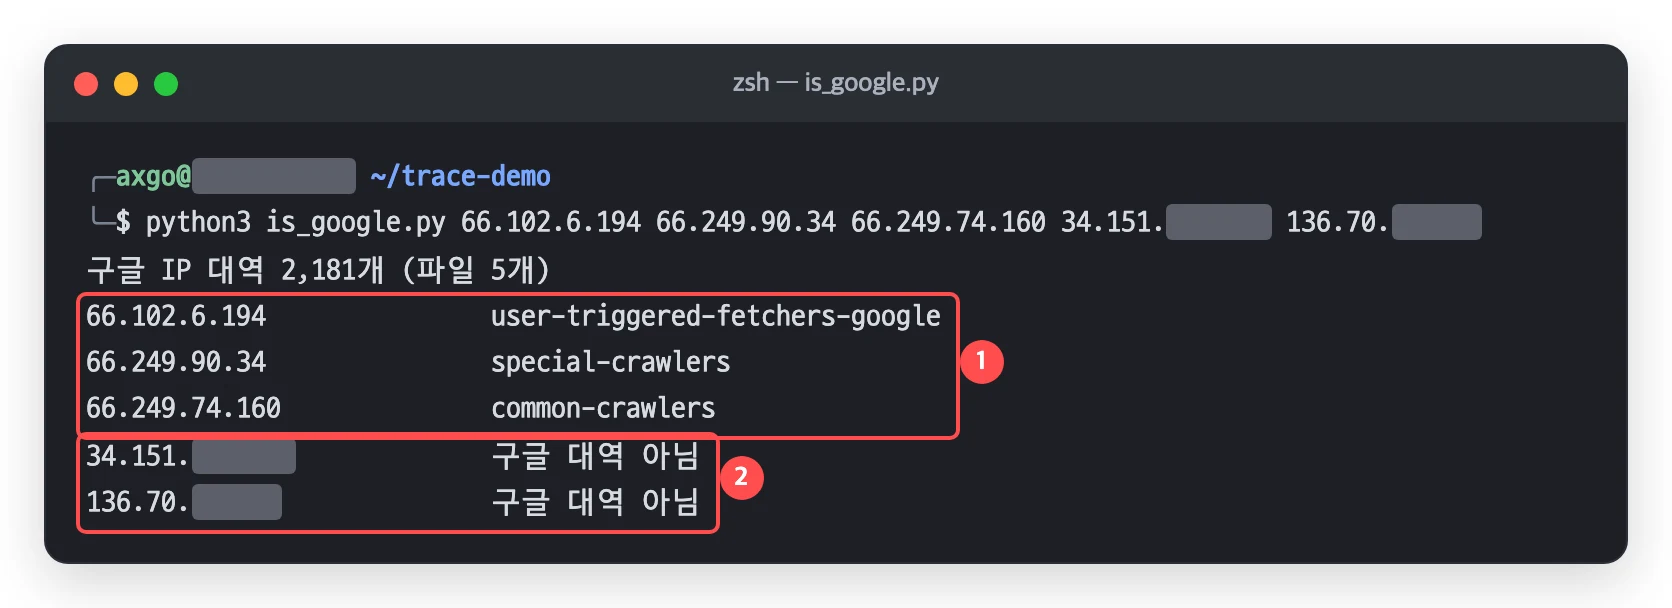
실행하고 출력 읽기
명령은 dab·bursts·errors 다. argparse 의 choices 로 명령을 받고 --zone 과 --zone-id 는 둘 중 하나를 꼭 주도록 add_mutually_exclusive_group(required=True) 로 묶었다. --zone-id 를 주면 존 조회 권한(Zone → Zone → Read)이 없어도 된다.
export CLOUDFLARE_API_TOKEN=...          # Zone → Analytics → Read
python3 trace.py dab    --zone example.com
python3 trace.py bursts --zone example.com --days 14
python3 trace.py errors --zone-id <존 ID> --top 20 --workers 8
Code language: Bash (bash)
시각은 KST 로 바꿔 보여 준다. 한국은 일광 절약 시간이 없어서 zoneinfo 대신 고정 오프셋 timezone(timedelta(hours=9)) 를 썼다. zoneinfo 는 3.9 부터 표준 라이브러리에 있지만 Windows 처럼 IANA 시간대 데이터가 없는 시스템에서는 tzdata 패키지를 따로 설치해야 한다. Cloudflare 가 주는 datetimeHour 는 2026-10-01T06:00:00Z 처럼 끝에 Z 가 붙는다. datetime.fromisoformat() 은 3.11 부터 이 형식을 받는다. 3.9 에서는 ValueError 가 나서 Z 를 +00:00 으로 바꿔 넘긴다.
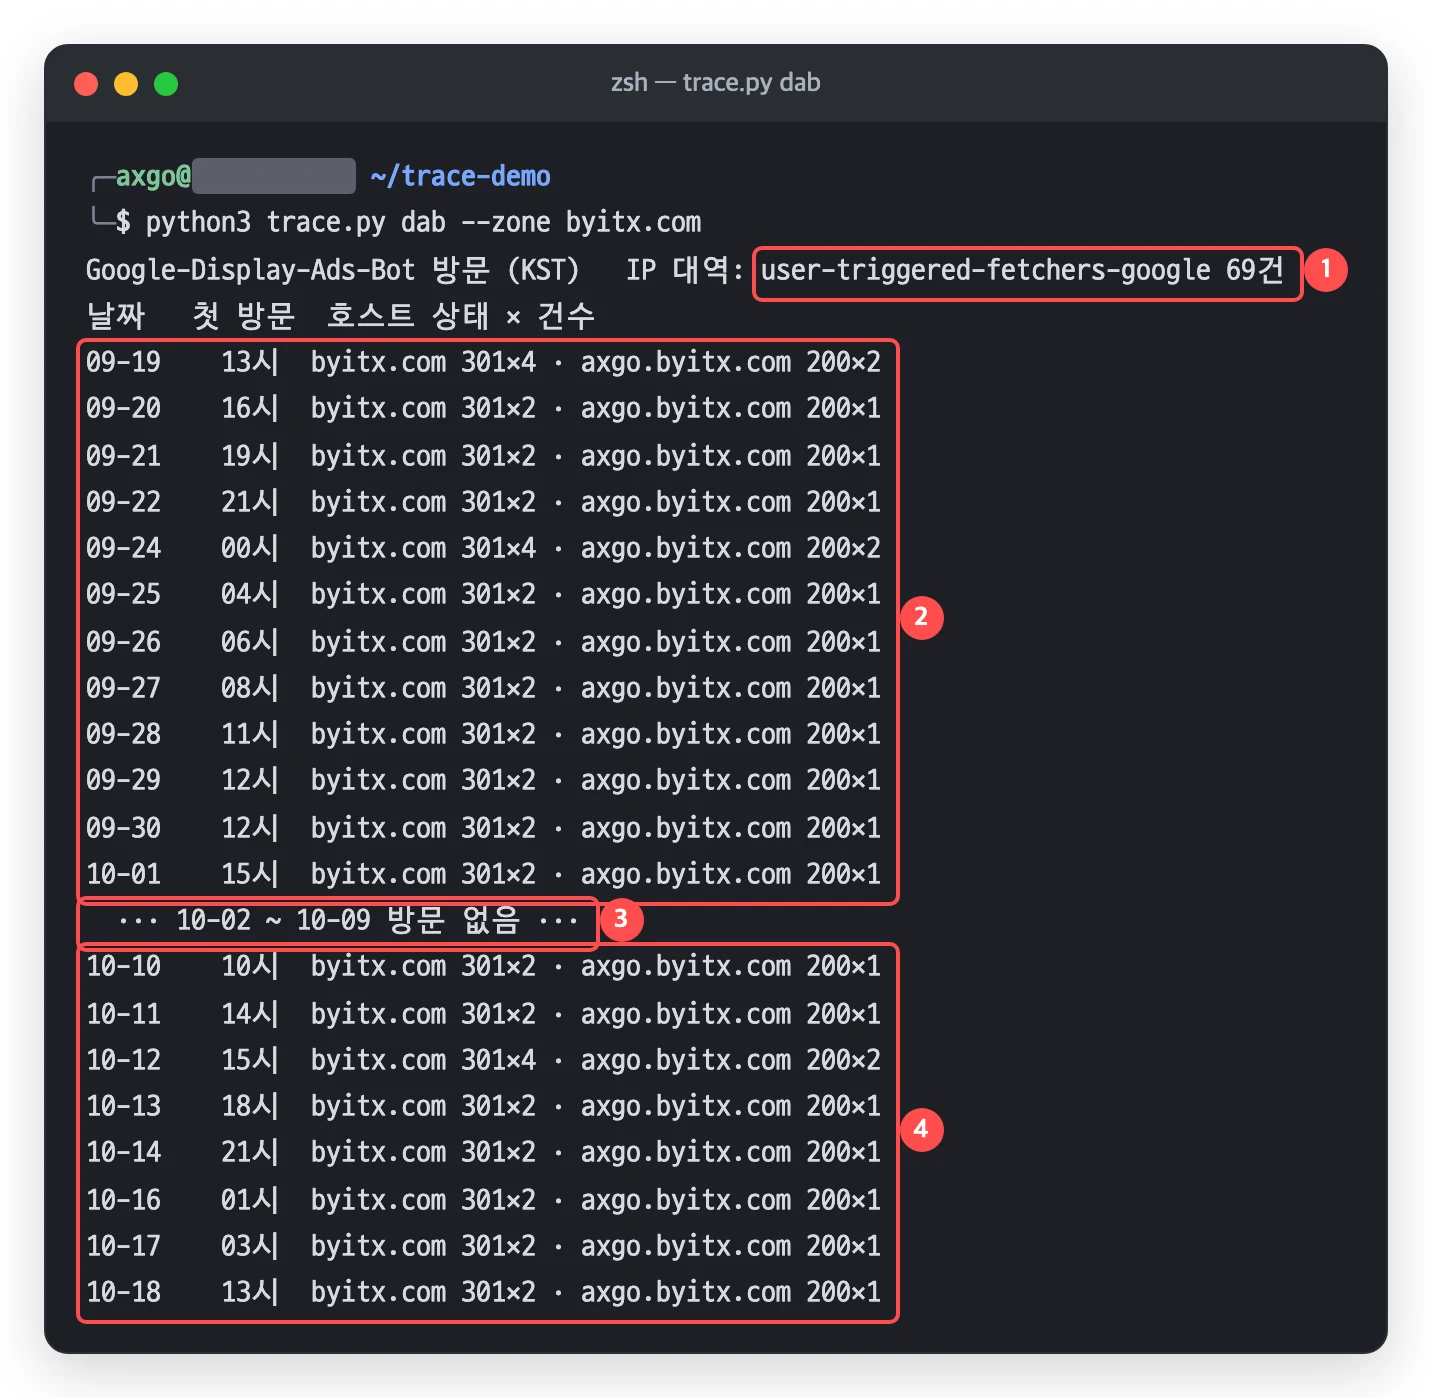
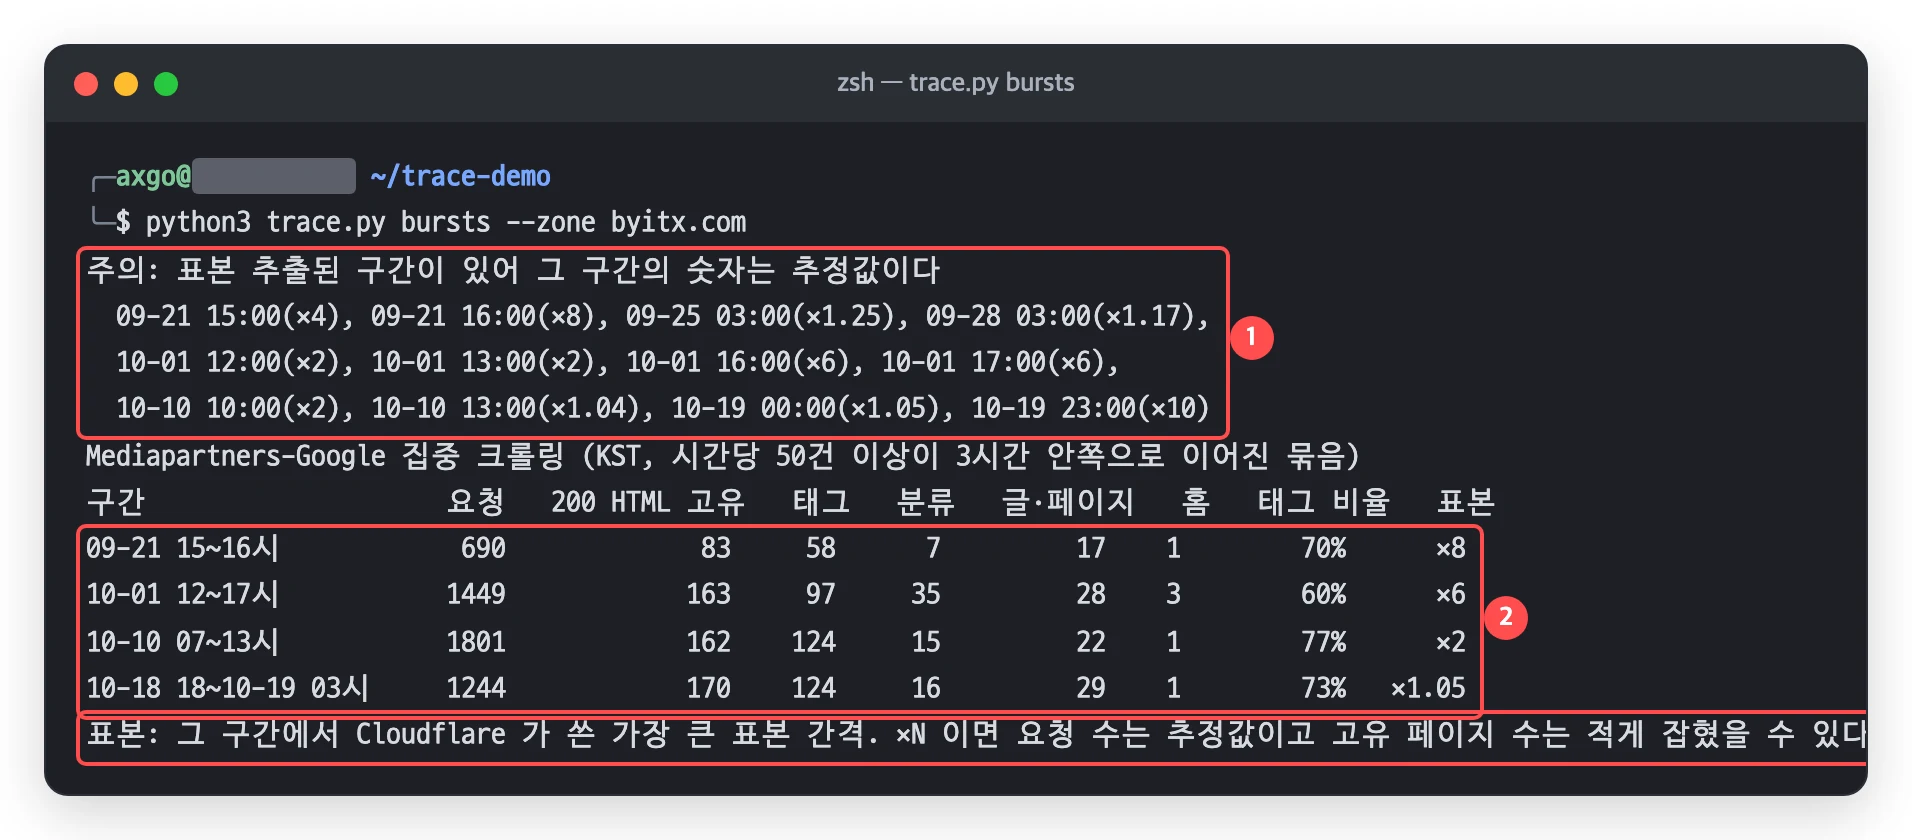
bursts 는 Mediapartners-Google 이 시간당 50건 넘게 온 시간을 3시간 간격 안쪽으로 묶는다. 합이 600건 이상인 묶음에서는 200 으로 받아 간 HTML 페이지를 주소로 나눠 센다. 주소 분류는 워드프레스 기본 구조(/tag/, /category/)를 기준으로 했으니 다른 CMS 라면 page_kind() 만 바꾸면 된다.
errors 는 Mediapartners-Google 이 받은 200 이 아닌 응답을 많은 순으로 보여 준다. 표본 추출된 시간이 섞인 합계에는 ~ 를 붙인다.
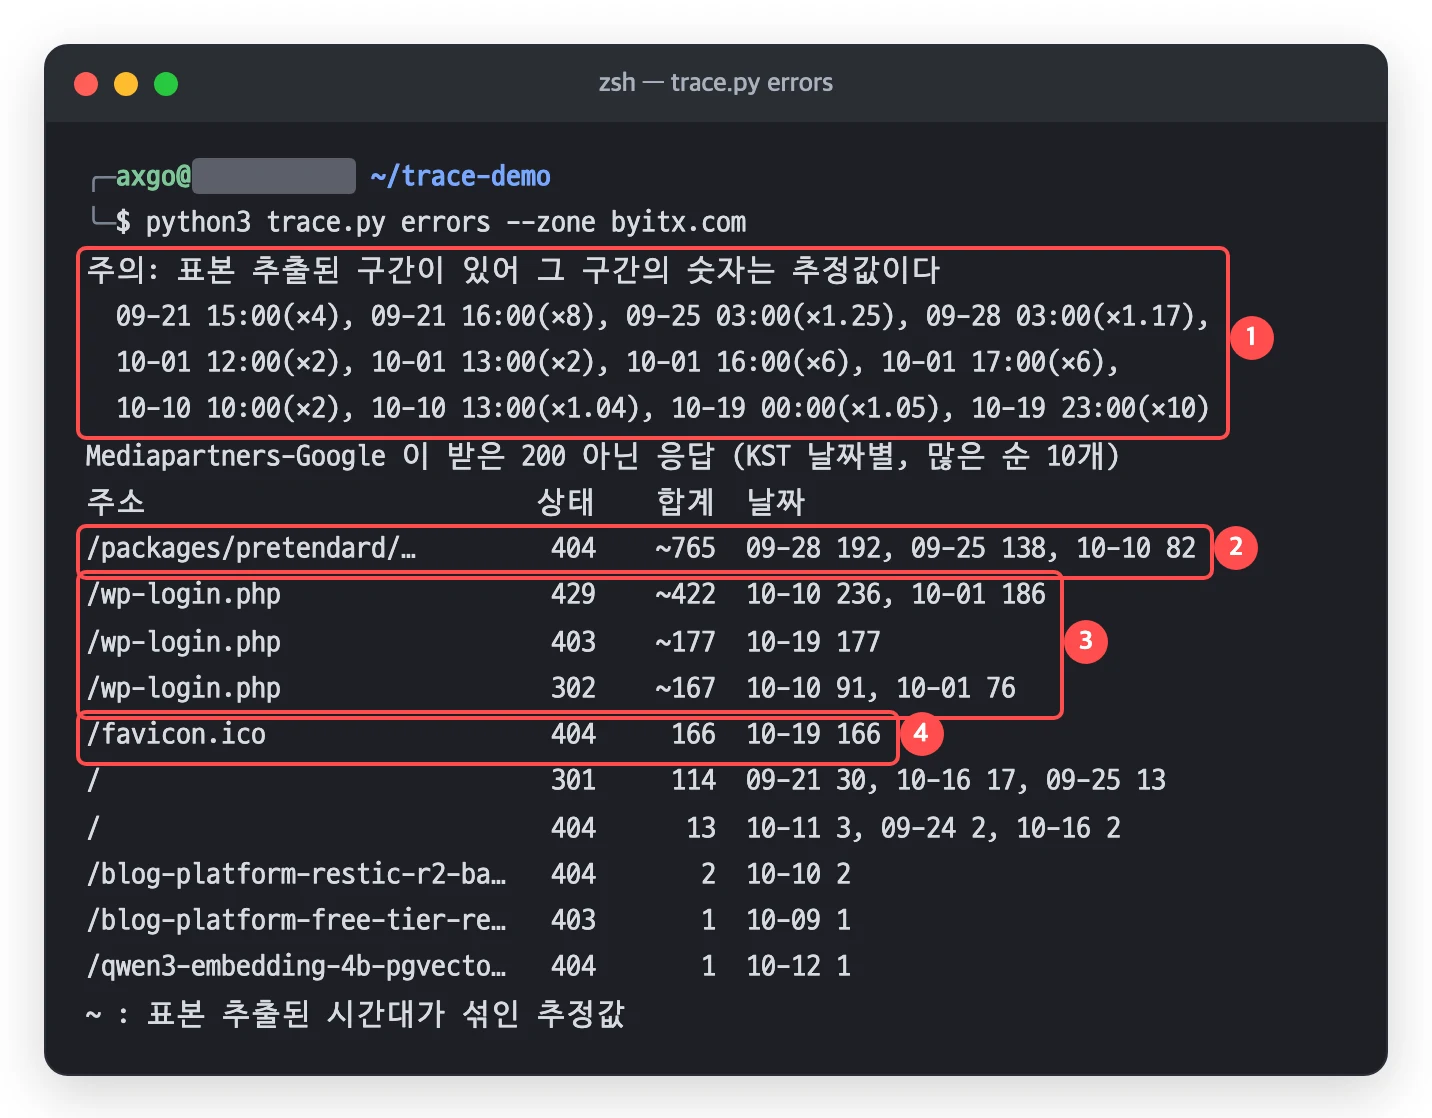
표본 안내는 stderr, 표는 stdout 으로 나눠 출력한다. python3 trace.py errors --zone example.com > errors.txt 처럼 표만 파일로 저장해도 경고는 터미널에 남는다. 각 출력을 어떻게 해석했고 그 결과로 무엇을 고쳤는지는 구글 크롤러 로그 구분하기 글에 있다.
다른 봇에 쓰려면
trace.py 에서 특정 크롤러에 묶인 부분은 GraphQL 필터 문자열과 주소 분류 함수다. cmd_dab() 의 userAgent_like: "%Google-Display-Ads-Bot%", mp_rows() 의 userAgent_like·verifiedBotCategory: "Advertising & Marketing", bursts 가 쓰는 page_kind() 가 그렇다. 구간을 나눠 받는 CF.rows() 는 필터 문자열과 dimension 목록만 받으니 모듈로 불러와 다른 필터를 넘기면 된다. dimension 에는 datetimeHour 가 꼭 있어야 한다.
아래 예제는 user-agent 에 들어 있는 글자를 인자로 받아 날짜별로 Cloudflare 검증 봇 분류와 구글 IP 대역을 함께 센다. trace.py 와 같은 디렉터리에 두고 실행한다.
# bot_daily.py — 사용법: CLOUDFLARE_API_TOKEN=... python3 bot_daily.py example.com Googlebot 7
import collections, importlib.util, os, sys

spec = importlib.util.spec_from_file_location('trace', os.path.join(os.path.dirname(os.path.abspath(__file__)), 'trace.py'))
trace = importlib.util.module_from_spec(spec)
spec.loader.exec_module(trace)              # main() 은 __name__ 이 달라 돌지 않는다

zone, ua, days = sys.argv[1], sys.argv[2], int(sys.argv[3]) if len(sys.argv) > 3 else 7
cf = trace.CF(zone, None, 4)
rows = cf.rows(f'userAgent_like: "%{ua}%"', 'datetimeHour clientIP verifiedBotCategory', days)
which = trace.matcher(trace.google_ranges())

per_day = collections.defaultdict(collections.Counter)
for r in rows:
    x = r['dimensions']
    cat = x['verifiedBotCategory'] or '검증 안 됨'
    per_day[r['t'].date()][f"{cat} / {which(x['clientIP'])}"] += r['count']

print(f'User-Agent 에 "{ua}" 가 든 요청 (KST 날짜별, Cloudflare 검증 분류 / 구글 IP 대역)')
for day in sorted(per_day):
    print(f'{day:%m-%d}  ' + ' · '.join(f'{k} {v}' for k, v in per_day[day].most_common()))
Code language: Python (python)
$ python3 bot_daily.py example.com Googlebot 7
User-Agent 에 "Googlebot" 가 든 요청 (KST 날짜별, Cloudflare 검증 분류 / 구글 IP 대역)
10-23 검증 안 됨 / NOT-GOOGLE 68 · Search Engine Crawler / common-crawlers 32
10-24 검증 안 됨 / NOT-GOOGLE 77 · Search Engine Crawler / common-crawlers 50
10-25 Search Engine Crawler / common-crawlers 43 · 검증 안 됨 / NOT-GOOGLE 27
10-26 검증 안 됨 / NOT-GOOGLE 45 · Search Engine Crawler / common-crawlers 41
10-27 검증 안 됨 / NOT-GOOGLE 204 · Search Engine Crawler / common-crawlers 195
10-28 Search Engine Crawler / common-crawlers 172
10-29 Search Engine Crawler / common-crawlers 178 · 검증 안 됨 / NOT-GOOGLE 97
10-30 Search Engine Crawler / common-crawlers 22
$ python3 bot_daily.py example.com bingbot 3
User-Agent 에 "bingbot" 가 든 요청 (KST 날짜별, Cloudflare 검증 분류 / 구글 IP 대역)
10-27 Search Engine Crawler / NOT-GOOGLE 21 · 검증 안 됨 / NOT-GOOGLE 6
10-28 Search Engine Crawler / NOT-GOOGLE 31
10-29 Search Engine Crawler / NOT-GOOGLE 53 · 검증 안 됨 / NOT-GOOGLE 40
10-30 Search Engine Crawler / NOT-GOOGLE 25
Code language: plaintext (plaintext)verifiedBotCategory는 Cloudflare 가 확인한 봇에만 붙는다. 값은Search Engine Crawler,Advertising & Marketing,AI Crawler같은 Cloudflare 의 검증 봇 분류 이름이다. 비어 있으면 user-agent 만 흉내 낸 요청일 가능성이 높다.- 이 사이트에서는 Googlebot 을 단 요청 가운데 구글 대역도 아니고 검증 봇도 아닌 요청이 날마다 수십~200건 섞여 있었다. 몇몇 시간은 표본 추정값이다(표본 안내는 stderr 로 나온다).
- IP 대역 대조는 구글만 된다. bingbot 처럼 다른 회사 봇은 두 번째 칸이 늘
NOT-GOOGLE이니 Cloudflare 검증 분류를 보거나 그 회사가 안내하는 확인 방법을 따로 쓴다. matcher()는RANGE_FILES순서대로 대조해 처음 맞는 파일 이름을 돌려준다. 이 사이트 기록에서는 Mediapartners-Google 요청 일부가special-crawlers가 아니라common-crawlers대역에서 왔다. 어느 파일이든 구글 대역이면 진짜 구글 요청으로 본다.
전체 코드
trace.py 289줄 전체다. 파이썬 3.9 이상이면 따로 설치할 것이 없다. 3.9.6(macOS 기본), 3.12, 3.14 에서 같은 출력이 나오는 것을 확인했다.
#!/usr/bin/env python3
"""애드센스 심사 흔적을 Cloudflare GraphQL Analytics API 로 본다.

  export CLOUDFLARE_API_TOKEN=...
  python3 trace.py dab    --zone example.com   # Google-Display-Ads-Bot 날짜별 방문 — 이 봇이 하루 한 번 오는 기간이 심사 기간이었다
  python3 trace.py bursts --zone example.com   # Mediapartners-Google 집중 크롤링과 그때 가져간 HTML 의 종류(태그 비율)
  python3 trace.py errors --zone example.com   # Mediapartners-Google 이 받은 200 아닌 응답(많은 순)
  옵션: --days N(기본 31) · --zone-id <ID>(존 이름 조회를 건너뛴다) · --workers N(동시 조회 수, 기본 4) · --top N(errors 줄 수)

토큰 권한: Zone → Analytics → Read. 존을 이름으로 찾으려면 Zone → Zone → Read 도 필요하다(--zone-id 를 주면 필요 없다).
파이썬 3.9 이상, 표준 라이브러리만 쓴다.

- User-Agent 는 누구나 흉내 낼 수 있어서 dab 은 요청 IP 를 구글이 공개한 크롤러 IP 대역과 대조한다
  (https://developers.google.com/crawling/docs/crawlers-fetchers/verify-google-requests).
  bursts·errors 는 Cloudflare 가 검증한 봇(verifiedBotCategory)만 센다.
- 조회 기간과 행 한도는 존 설정(settings)에서 읽는다(Free 요금제 존에서는 최근 31일, 한 번에 30일, 10,000행이었다).
- adaptive 데이터는 표본 추출될 수 있다. 하루 단위로 받고, 행 한도에 걸린 구간은 반으로 나누고,
  표본(sampleInterval > 1)이 섞인 시간은 그 한 시간만 다시 받는다. 트래픽이 많은 시간대는 한 시간으로 줄여도
  표본으로 남는다 — 그런 숫자는 '~'·'×N' 으로 표시한 추정값이고, 고유 페이지 수는 실제보다 적게 잡힐 수 있다.
- 보존 기한(31일)에서 몇 시간 안쪽으로 시작한 쿼리는 그날 행이 ×10 이 되거나 아예 빠졌다(표본에 걸리지 않은 행은
  돌아오지 않는다). 그래서 보존 기한부터 볼 때는 첫날을 한 시간 단위로 받는다. 맨 앞 몇 시간은 그래도 빠질 수 있다.
- 구간 조회는 스레드 몇 개로 동시에 보낸다. 시간 대부분이 응답 대기라 GIL 이 걸림돌이 되지 않는다.
  Cloudflare GraphQL 의 기본 한도가 5분에 300 쿼리라 동시 조회는 기본 4개로 둔다.
"""
import argparse, collections, concurrent.futures as cfut, datetime as dt, functools, ipaddress, json, os, sys, textwrap, time
import urllib.error, urllib.parse, urllib.request

API = 'https://api.cloudflare.com/client/v4'
UA = 'adsense-traces/2'
KST = dt.timezone(dt.timedelta(hours=9))
DAY, HOUR = dt.timedelta(days=1), dt.timedelta(hours=1)
IPRANGES = 'https://developers.google.com/static/crawling/ipranges/{}.json'
RANGE_FILES = ['special-crawlers', 'user-triggered-fetchers-google', 'user-triggered-fetchers', 'user-triggered-agents', 'common-crawlers']
RETRY = {429, 500, 502, 503, 504}


class APIError(Exception):
    pass


def fetch_json(url, body=None, headers=None, tries=4):
    """GET(body 가 있으면 POST) 뒤 JSON 을 돌려준다. 429·5xx·네트워크 오류는 1·2·4초 쉬고 다시 보낸다."""
    data = json.dumps(body).encode() if body is not None else None
    req = urllib.request.Request(url, data=data, headers={'User-Agent': UA, **(headers or {})})
    for i in range(tries):
        try:
            with urllib.request.urlopen(req, timeout=90) as r:
                return json.load(r)
        except urllib.error.HTTPError as e:         # URLError 의 하위 클래스라 먼저 잡는다
            if e.code not in RETRY or i == tries - 1:
                raise
        except OSError:                             # URLError·타임아웃·연결 끊김
            if i == tries - 1:
                raise
        time.sleep(2 ** i)


def utc(hour):
    # 3.11 부터는 fromisoformat 이 'Z' 를 받지만 3.9·3.10 을 위해 바꿔 넣는다
    return dt.datetime.fromisoformat(hour.replace('Z', '+00:00'))


def iso(t):
    return t.strftime('%Y-%m-%dT%H:%M:%SZ')


def times(iv):
    return f'×{iv:.0f}' if iv >= 2 else f'×{iv:.2f}'


class CF:
    def __init__(self, zone_name, zone_id, workers):
        self.tok = os.environ.get('CLOUDFLARE_API_TOKEN', '').strip()
        if not self.tok:
            sys.exit('환경 변수 CLOUDFLARE_API_TOKEN 이 필요하다')
        self.workers = workers
        if zone_id:
            self.zone = zone_id
        else:
            z = self.call(f'{API}/zones?name={urllib.parse.quote(zone_name)}')['result']
            if not z:
                sys.exit(f'존을 찾지 못했다: {zone_name}')
            self.zone = z[0]['id']

    def call(self, url, body=None):
        return fetch_json(url, body, {'Authorization': f'Bearer {self.tok}', 'Content-Type': 'application/json'})

    def gql(self, query, variables):
        r = self.call(f'{API}/graphql', {'query': query, 'variables': dict(variables, z=self.zone)})
        if r.get('errors'):
            raise APIError(r['errors'][0]['message'])
        return r['data']['viewer']['zones'][0]

    def limits(self):
        q = ('query($z: String!) { viewer { zones(filter: {zoneTag: $z}) {'
             ' settings { httpRequestsAdaptiveGroups { notOlderThan maxPageSize } } } } }')
        s = self.gql(q, {})['settings']['httpRequestsAdaptiveGroups']
        return dt.timedelta(seconds=s['notOlderThan']), s['maxPageSize']

    def rows(self, groups_filter, dims, days):
        """httpRequestsAdaptiveGroups 를 하루 단위 구간으로 동시에 받는다.
        행 한도에 걸린 구간은 반으로 나누고, 표본이 섞인 시간은 한 시간짜리 구간으로 다시 받는다.
        dims 에는 datetimeHour 가 있어야 한다. 행마다 KST 시각을 r['t'] 로 붙인다."""
        keep, page = self.limits()
        now = dt.datetime.now(dt.timezone.utc).replace(second=0, microsecond=0)
        start = max(now - dt.timedelta(days=days), now - keep + dt.timedelta(minutes=10))
        q = ('query($z: String!, $since: Time!, $until: Time!) { viewer { zones(filter: {zoneTag: $z}) {'
             f' r: httpRequestsAdaptiveGroups(limit: {page}, filter: {{datetime_geq: $since, datetime_lt: $until, {groups_filter}}})'
             f' {{ count avg {{ sampleInterval }} dimensions {{ {dims} }} }} }} }} }}')

        def fetch(s, e):
            return self.gql(q, {'since': iso(s), 'until': iso(e)})['r']

        out, sampled = [], []
        edge = start == now - keep + dt.timedelta(minutes=10)    # 보존 기한에서 시작하는가
        with cfut.ThreadPoolExecutor(self.workers) as ex:
            todo, t = {}, start
            while t < now:
                # 보존 기한 쪽 첫날은 한 시간씩 받는다. 기한에서 몇 시간 안쪽으로 시작한 쿼리는 그날 행이 표본(×10)이
                # 되거나 아예 빠진다 — 행이 없으면 다시 받을 단서도 없다
                e = min(t + (HOUR if edge and t < start + DAY else DAY), now)
                todo[ex.submit(fetch, t, e)] = (t, e)
                t = e
            while todo:                             # 끝난 구간부터 꺼내고, 다시 받을 구간은 큐에 넣는다
                done, _ = cfut.wait(todo, return_when=cfut.FIRST_COMPLETED)
                for f in done:
                    s, e = todo.pop(f)
                    got = f.result()
                    for r in got:
                        r['utc'] = utc(r['dimensions']['datetimeHour'])
                    if e - s > HOUR:
                        if len(got) >= page:        # 잘렸다 — 어느 시간이 빠졌는지 모르니 반으로 나눈다
                            m = s + (e - s) / 2
                            for w in ((s, m), (m, e)):
                                todo[ex.submit(fetch, *w)] = w
                            continue
                        hot = {r['utc'] for r in got if r['avg']['sampleInterval'] > 1}
                        for h in sorted(hot):       # 표본이 섞인 시간만 한 시간짜리 구간으로 다시 받는다
                            w = (max(s, h), min(e, h + HOUR))
                            todo[ex.submit(fetch, *w)] = w
                        got = [r for r in got if r['utc'] not in hot]
                    else:
                        if len(got) >= page:
                            print(f'경고: {s.astimezone(KST):%m-%d %H:%M} 부터 한 시간 안에서도 {page}행을 넘는다 — 잘렸다', file=sys.stderr)
                        iv = max((r['avg']['sampleInterval'] for r in got), default=1)
                        if iv > 1:
                            sampled.append((s, iv))
                    for r in got:
                        r['t'] = r['utc'].astimezone(KST)
                    out.extend(got)
        if sampled:
            hrs = ', '.join(f'{s.astimezone(KST):%m-%d\u00a0%H:%M}({times(iv)})' for s, iv in sorted(sampled))  # 날짜와 시각 사이에서는 줄을 바꾸지 않는다
            print('주의: 표본 추출된 구간이 있어 그 구간의 숫자는 추정값이다', file=sys.stderr)
            print(textwrap.fill(hrs, 80, initial_indent='  ', subsequent_indent='  '), file=sys.stderr)
        return out


def google_ranges():
    """구글 크롤러 IP 대역 JSON 을 동시에 받아 {파일 이름: [네트워크…]} 로 돌려준다(순서는 RANGE_FILES)."""
    def one(name):
        prefixes = fetch_json(IPRANGES.format(name))['prefixes']
        return name, [ipaddress.ip_network(p.get('ipv4Prefix') or p.get('ipv6Prefix')) for p in prefixes]
    with cfut.ThreadPoolExecutor(len(RANGE_FILES)) as ex:
        return dict(ex.map(one, RANGE_FILES))


def matcher(nets):
    @functools.lru_cache(maxsize=None)              # 같은 IP 는 한 번만 대조한다
    def which(ip):
        a = ipaddress.ip_address(ip)                # IPv4 주소와 IPv6 대역의 in 은 오류 없이 False
        return next((name for name, ns in nets.items() if any(a in n for n in ns)), 'NOT-GOOGLE')
    return which


def cmd_dab(cf, days):
    with cfut.ThreadPoolExecutor(1) as ex:
        ranges = ex.submit(google_ranges)           # GraphQL 을 받는 동안 IP 대역 JSON 도 받는다
        rows = cf.rows('userAgent_like: "%Google-Display-Ads-Bot%"', 'datetimeHour clientRequestHTTPHost edgeResponseStatus clientIP', days)
        which = matcher(ranges.result())
    seen, srcs = {}, collections.Counter()
    for r in sorted(rows, key=lambda r: r['t']):
        x, t = r['dimensions'], r['t']
        d = seen.setdefault(t.date(), {'first': t.strftime('%H시'), 'hits': collections.Counter(), 'est': False})
        d['hits'][f"{x['clientRequestHTTPHost']} {x['edgeResponseStatus']}"] += r['count']
        d['est'] |= r['avg']['sampleInterval'] > 1
        srcs[which(x['clientIP'])] += r['count']
    print('Google-Display-Ads-Bot 방문 (KST)   IP 대역: ' + (', '.join(f'{k} {v}건' for k, v in srcs.items()) or '없음'))
    print('날짜   첫 방문  호스트 상태 × 건수')
    prev = None
    for day, d in seen.items():
        if prev and (day - prev).days > 2:
            print(f'  ··· {(prev + dt.timedelta(days=1)):%m-%d} ~ {(day - dt.timedelta(days=1)):%m-%d} 방문 없음 ···')
        hits = ' · '.join(f'{k}×{v}' for k, v in d['hits'].most_common())
        print(f"{day:%m-%d}  {d['first']:>5}  {hits}{'  ~ 추정' if d['est'] else ''}")
        prev = day


def mp_rows(cf, days):
    return cf.rows('userAgent_like: "%Mediapartners-Google%", verifiedBotCategory: "Advertising & Marketing"',
                   'datetimeHour clientRequestHTTPHost clientRequestPath edgeResponseStatus', days)


def page_kind(p):
    # 워드프레스 기본 주소 구조 기준
    if p == '/': return '홈'
    if p.startswith('/tag/'): return '태그'
    if p.startswith('/category/'): return '분류'
    return '글·페이지'


def cmd_bursts(cf, days):
    rows = mp_rows(cf, days)
    hours = collections.Counter()
    for r in rows:
        hours[r['t']] += r['count']
    hot = sorted(h for h, n in hours.items() if n >= 50)
    groups, cur = [], []
    for h in hot:                                   # 시간당 50건 이상이 3시간 안쪽으로 이어진 묶음, 합 600건 이상
        if cur and h - cur[-1] > dt.timedelta(hours=3):
            groups.append(cur); cur = []
        cur.append(h)
    if cur: groups.append(cur)
    print('Mediapartners-Google 집중 크롤링 (KST, 시간당 50건 이상이 3시간 안쪽으로 이어진 묶음)')
    print('구간                    요청   200 HTML 고유   태그   분류   글·페이지   홈   태그 비율   표본')
    for g in groups:
        if sum(hours[h] for h in g) < 600:
            continue
        a, b = g[0], g[-1]
        sel = [r for r in rows if a <= r['t'] <= b]
        pages = {}
        for r in sel:
            x = r['dimensions']; p = x['clientRequestPath']
            if x['edgeResponseStatus'] == 200 and p.endswith('/') and not p.startswith(('/wp-', '/cdn-cgi')):
                pages[(x['clientRequestHTTPHost'], p)] = page_kind(p)
        k = collections.Counter(pages.values()); n = len(pages) or 1
        span = f"{a:%m-%d %H}~{b:%m-%d %H}시" if b.date() != a.date() else f"{a:%m-%d %H}~{b:%H}시"
        iv = max(r['avg']['sampleInterval'] for r in sel)
        print(f"{span:<20} {sum(r['count'] for r in sel):>6} {len(pages):>14} {k['태그']:>6} {k['분류']:>6} {k['글·페이지']:>10} {k['홈']:>4} {k['태그'] / n * 100:>9.0f}%   {times(iv) if iv > 1 else '-':>5}")
    print('표본: 그 구간에서 Cloudflare 가 쓴 가장 큰 표본 간격. ×N 이면 요청 수는 추정값이고 고유 페이지 수는 적게 잡혔을 수 있다')


def short_path(p):
    p = p.split('?', 1)[0]
    if len(p) > 28:                                 # 긴 정적 파일 주소는 앞 두 단계만
        parts = [s for s in p.split('/') if s]
        p = '/' + '/'.join(parts[:2]) + '/…' if len(parts) > 2 else p[:27] + '…'
    return p


def cmd_errors(cf, days, top):
    c = collections.defaultdict(collections.Counter); est = set()
    for r in mp_rows(cf, days):
        x = r['dimensions']
        if x['edgeResponseStatus'] != 200:
            key = (short_path(x['clientRequestPath']), x['edgeResponseStatus'])
            c[key][r['t'].strftime('%m-%d')] += r['count']
            if r['avg']['sampleInterval'] > 1: est.add(key)
    print(f'Mediapartners-Google 이 받은 200 아닌 응답 (KST 날짜별, 많은 순 {top}개)')
    print('주소                          상태    합계  날짜')
    for (p, st), ds in sorted(c.items(), key=lambda kv: -sum(kv[1].values()))[:top]:
        days_ = ', '.join(f'{d} {n}' for d, n in sorted(ds.items(), key=lambda kv: -kv[1])[:3])
        print(f"{p:<28} {st:>5} {('~' if (p, st) in est else '') + str(sum(ds.values())):>7}  {days_}")
    if est: print('~ : 표본 추출된 시간대가 섞인 추정값')


def main():
    ap = argparse.ArgumentParser(description='애드센스 심사 흔적(Cloudflare GraphQL Analytics API)')
    ap.add_argument('cmd', choices=['dab', 'bursts', 'errors'])
    g = ap.add_mutually_exclusive_group(required=True)
    g.add_argument('--zone', help='존 이름(예: example.com)')
    g.add_argument('--zone-id', help='존 ID')
    ap.add_argument('--days', type=int, default=31, help='며칠 거슬러 볼지(존의 보존 기간을 넘으면 그 기간까지)')
    ap.add_argument('--workers', type=int, default=4, help='동시에 보낼 GraphQL 조회 수')
    ap.add_argument('--top', type=int, default=10, help='errors 에서 보여 줄 줄 수')
    a = ap.parse_args()
    try:
        cf = CF(a.zone, a.zone_id, max(1, a.workers))
        if a.cmd == 'errors':
            cmd_errors(cf, a.days, a.top)
        else:
            {'dab': cmd_dab, 'bursts': cmd_bursts}[a.cmd](cf, a.days)
    except urllib.error.HTTPError as e:
        sys.exit(f'HTTP {e.code} {e.reason}: {e.read()[:300].decode(errors="replace")}')
    except APIError as e:
        sys.exit(f'GraphQL 오류: {e}')


if __name__ == '__main__':
    main()
Code language: Python (python)