서버 로그를 열면 user-agent 에 Google 이 들어간 요청이 여럿 섞여 있다. 검색 색인을 만드는 Googlebot 만 있는 것이 아니다. 애드센스 광고를 고르는 Mediapartners-Google, 광고 품질을 확인하는 AdsBot-Google, 애드센스에 사이트를 추가하면 사이트를 확인하러 오는 Google-Display-Ads-Bot 은 robots.txt 를 따르는 방식도, 요청을 보내는 IP 대역도 서로 다르다. 게다가 user-agent 는 누구나 흉내 낼 수 있다.
이 블로그는 구글이 실제로 무엇을 요청했는지 Cloudflare 와 nginx 로그로 확인했다. 짐작 대신 로그로 확인한 것만 고치려고 했고, 그러려면 먼저 로그에 남은 구글 크롤러가 각각 누구인지부터 알아야 했다. 아래는 구글 크롤러를 구분하는 방법과 실제 로그에서 찾아 고친 것들이다.
목차
- 구글 크롤러는 이름마다 robots.txt 규칙이 다르다
- Cloudflare 와 nginx 로그에서 찾기
- Cloudflare 대시보드 필터
- GraphQL Analytics API
- nginx 로그
- user-agent 는 흉내 낼 수 있다 — IP 로 확인하기
- 역방향 DNS 와 정방향 DNS 로 확인
- 구글이 공개한 IP 대역 JSON 과 대조
- Cloudflare 검증 봇 분류도 같이 본다
- 광고 크롤러가 몰아서 가져가는 구간 찾기
- 크롤러가 받아 간 페이지에서 찾은 문제
- 대부분이 태그 목록이었다
- 로그인 주소·favicon·폰트에서 받은 4xx
- robots.txt 의 * 그룹은 이 크롤러에게 없는 것과 같았다
- robots.txt·광고 스크립트·favicon 고치기
- 태그 목록에서 광고 스크립트 빼기
- robots.txt 에 애드센스 크롤러 그룹 넣기
- favicon.ico 와 폰트 주소
- 고친 뒤의 크롤링에서 달라진 것
- 정리
구글 크롤러는 이름마다 robots.txt 규칙이 다르다
구글은 크롤러를 일반 크롤러(common crawlers), 예외 상황 크롤러(special-case crawlers), 사용자 트리거 가져오기 도구(user-triggered fetchers)로 나눠 문서에 정리해 두었다. 이 구분에 따라 robots.txt 를 대하는 방식과 IP 대역 파일이 달라진다. 로그에서 자주 보게 되는 것만 추리면 아래와 같다.
| user-agent (robots.txt 토큰) | 하는 일 | robots.txt | IP 대역 파일 |
|---|---|---|---|
Googlebot | 구글 검색 색인을 위한 크롤링 | 자동 크롤링 때 항상 따른다. 자기 이름 그룹이 없으면 * 그룹을 따른다 | common-crawlers.json |
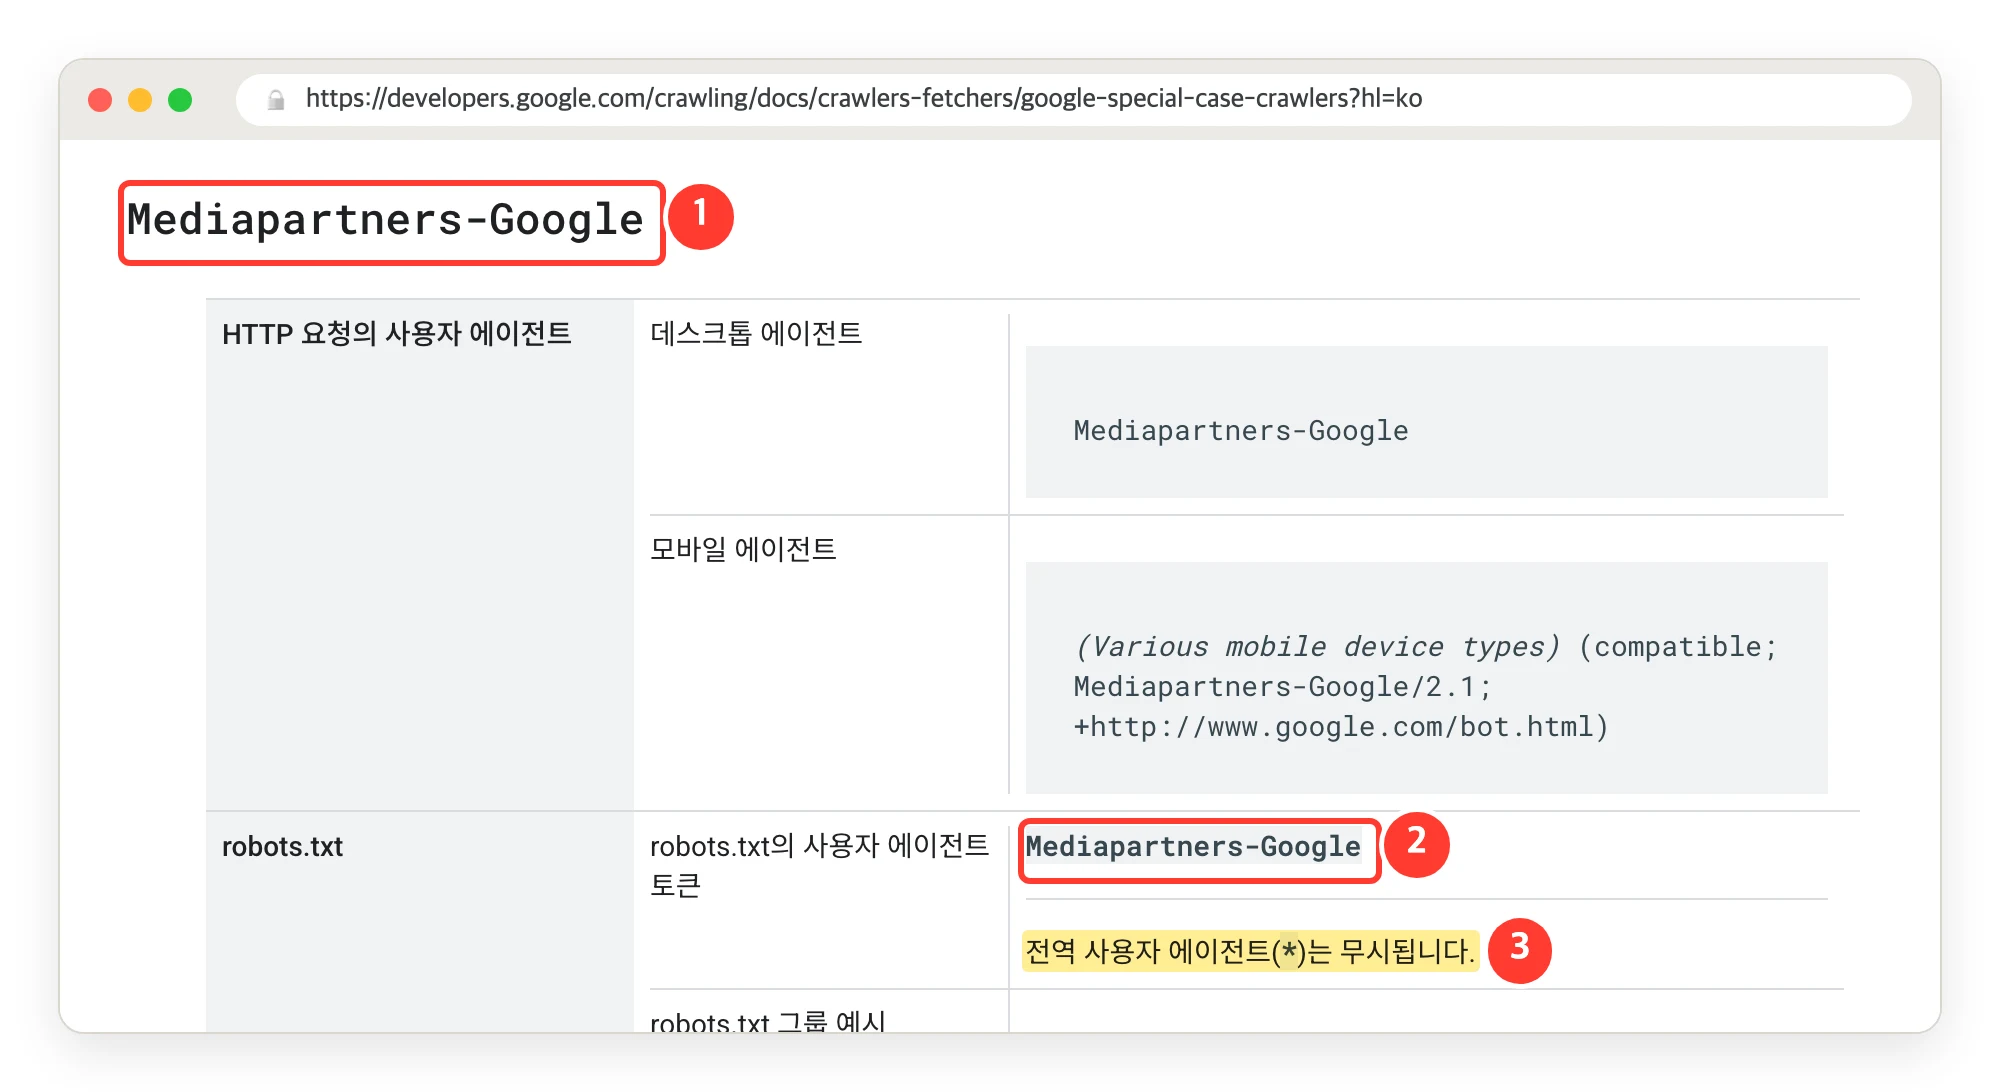
Mediapartners-Google | 애드센스 참여 사이트를 방문해 관련 광고를 고른다 | 자기 이름 그룹만 본다. * 는 무시한다 | special-crawlers.json |
AdsBot-Google | Google Ads 의 웹페이지 광고 품질 확인 | 자기 이름 그룹만 본다. 광고 게시자의 허락 아래 * 를 무시한다 | special-crawlers.json |
Google-Display-Ads-Bot | 애드센스에 사이트를 추가할 때 사이트 확인 | 애드센스 도움말은 robots.txt 명령을 따른다고 적고 있다 | 크롤러 문서에는 없다. 이 사이트에서는 user-triggered-fetchers-google.json 대역에서 왔다 |
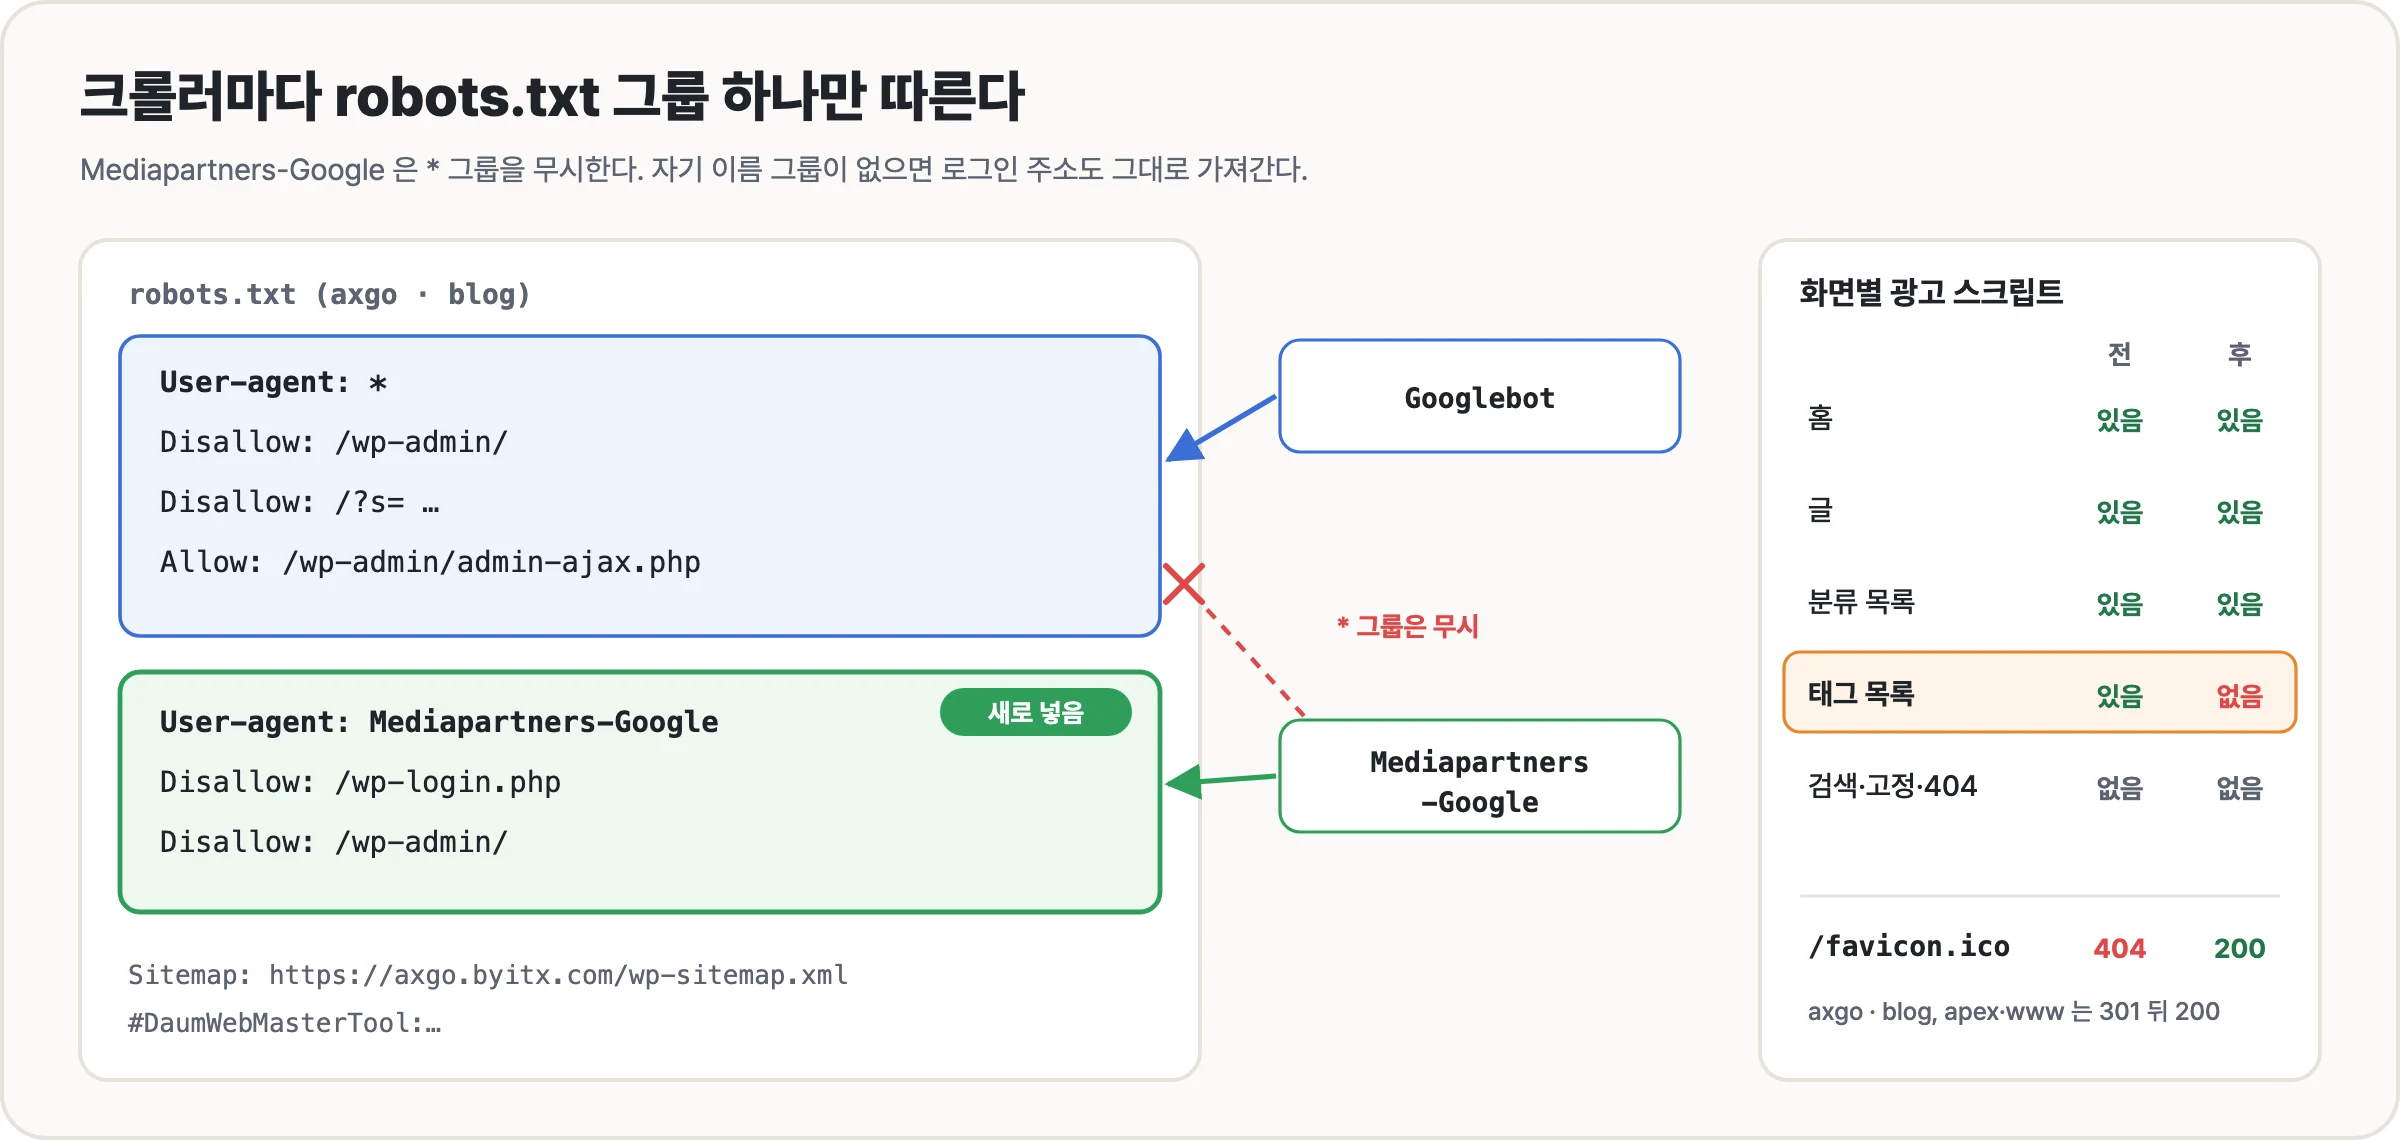
구글 robots.txt 규격에서 크롤러는 자기에게 맞는 그룹 가운데 가장 구체적인 그룹 하나만 따른다. 특정 크롤러 그룹과 * 그룹은 합쳐지지 않는다. 예외 상황 크롤러는 여기에 더해 * 그룹을 아예 보지 않는다. User-agent: * 에 Disallow: /wp-admin/ 을 적어 두어도 Mediapartners-Google 에게는 아무 규칙이 없는 것과 같다.
애드센스 도움말도 같은 말을 한다. User-agent: * 로 막은 페이지라도 광고를 게재하면 애드센스 크롤러는 그 페이지를 크롤링하고, 막으려면 Mediapartners-Google 과 Google-Display-Ads-Bot 을 따로 적으라고 한다. 그리고 이 크롤러는 광고 태그가 구현된 URL 만 가져간다.
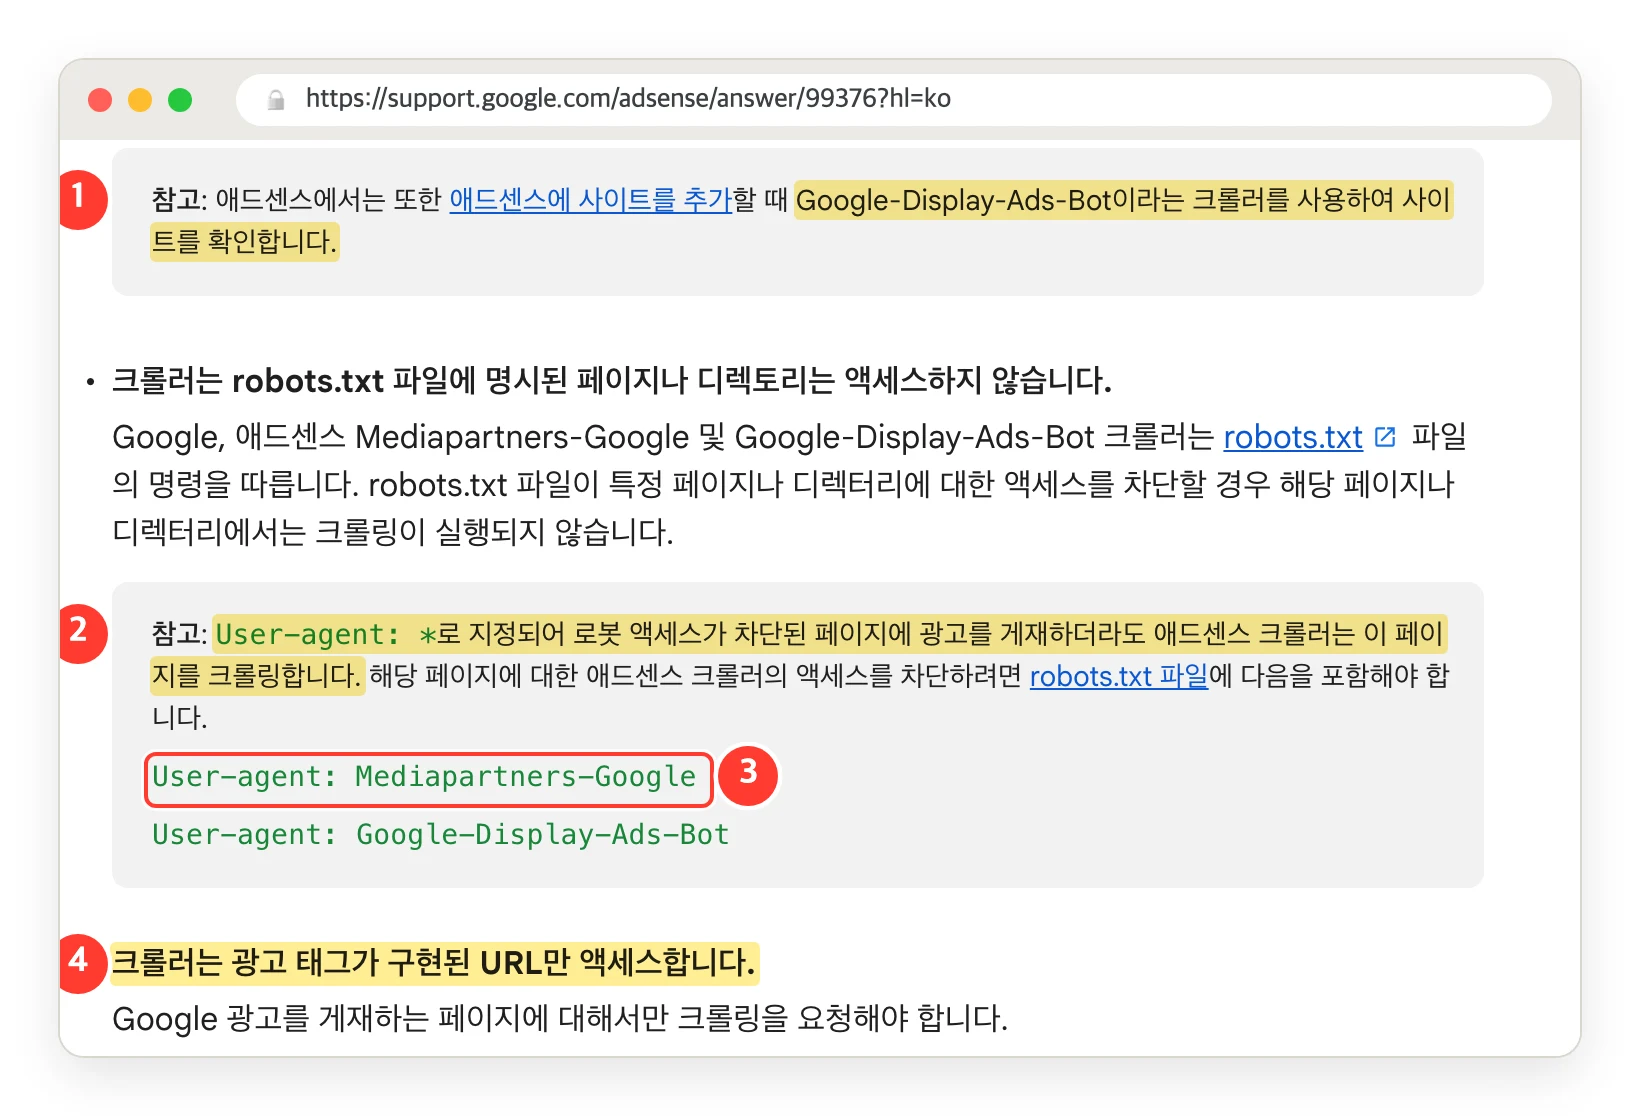
User-agent: * 로 막아도 애드센스 크롤러는 크롤링한다 ③ 막으려면 Mediapartners-Google 을 따로 적는다 ④ 크롤러는 광고 태그가 있는 URL 만 가져간다.noindex 는 이 규칙과 관계가 없다. noindex 는 페이지를 구글 검색 결과에서 빼는 규칙이고 크롤링을 막는 규칙이 아니다. 광고 태그가 있는 페이지라면 noindex 를 붙여도 애드센스 크롤러가 가져간다. 이 사이트에서도 noindex 를 붙인 태그 목록을 광고 크롤러가 계속 가져갔다(아래에서 다시 다룬다).
Cloudflare 와 nginx 로그에서 찾기
이 블로그로 오는 요청은 전부 Cloudflare 엣지를 거친다. 엣지가 캐시로 끝내지 못한 요청만 Cloudflare Tunnel 을 거쳐 오라클 A1 의 nginx 에 도착한다. 그래서 로그를 두 군데에서 확인해야 한다. Cloudflare 는 엣지에 온 요청을 모두 남기고 Free 요금제에서도 GraphQL Analytics API 로 조회할 수 있게 해 준다. nginx 는 원본까지 온 요청만 남긴다.
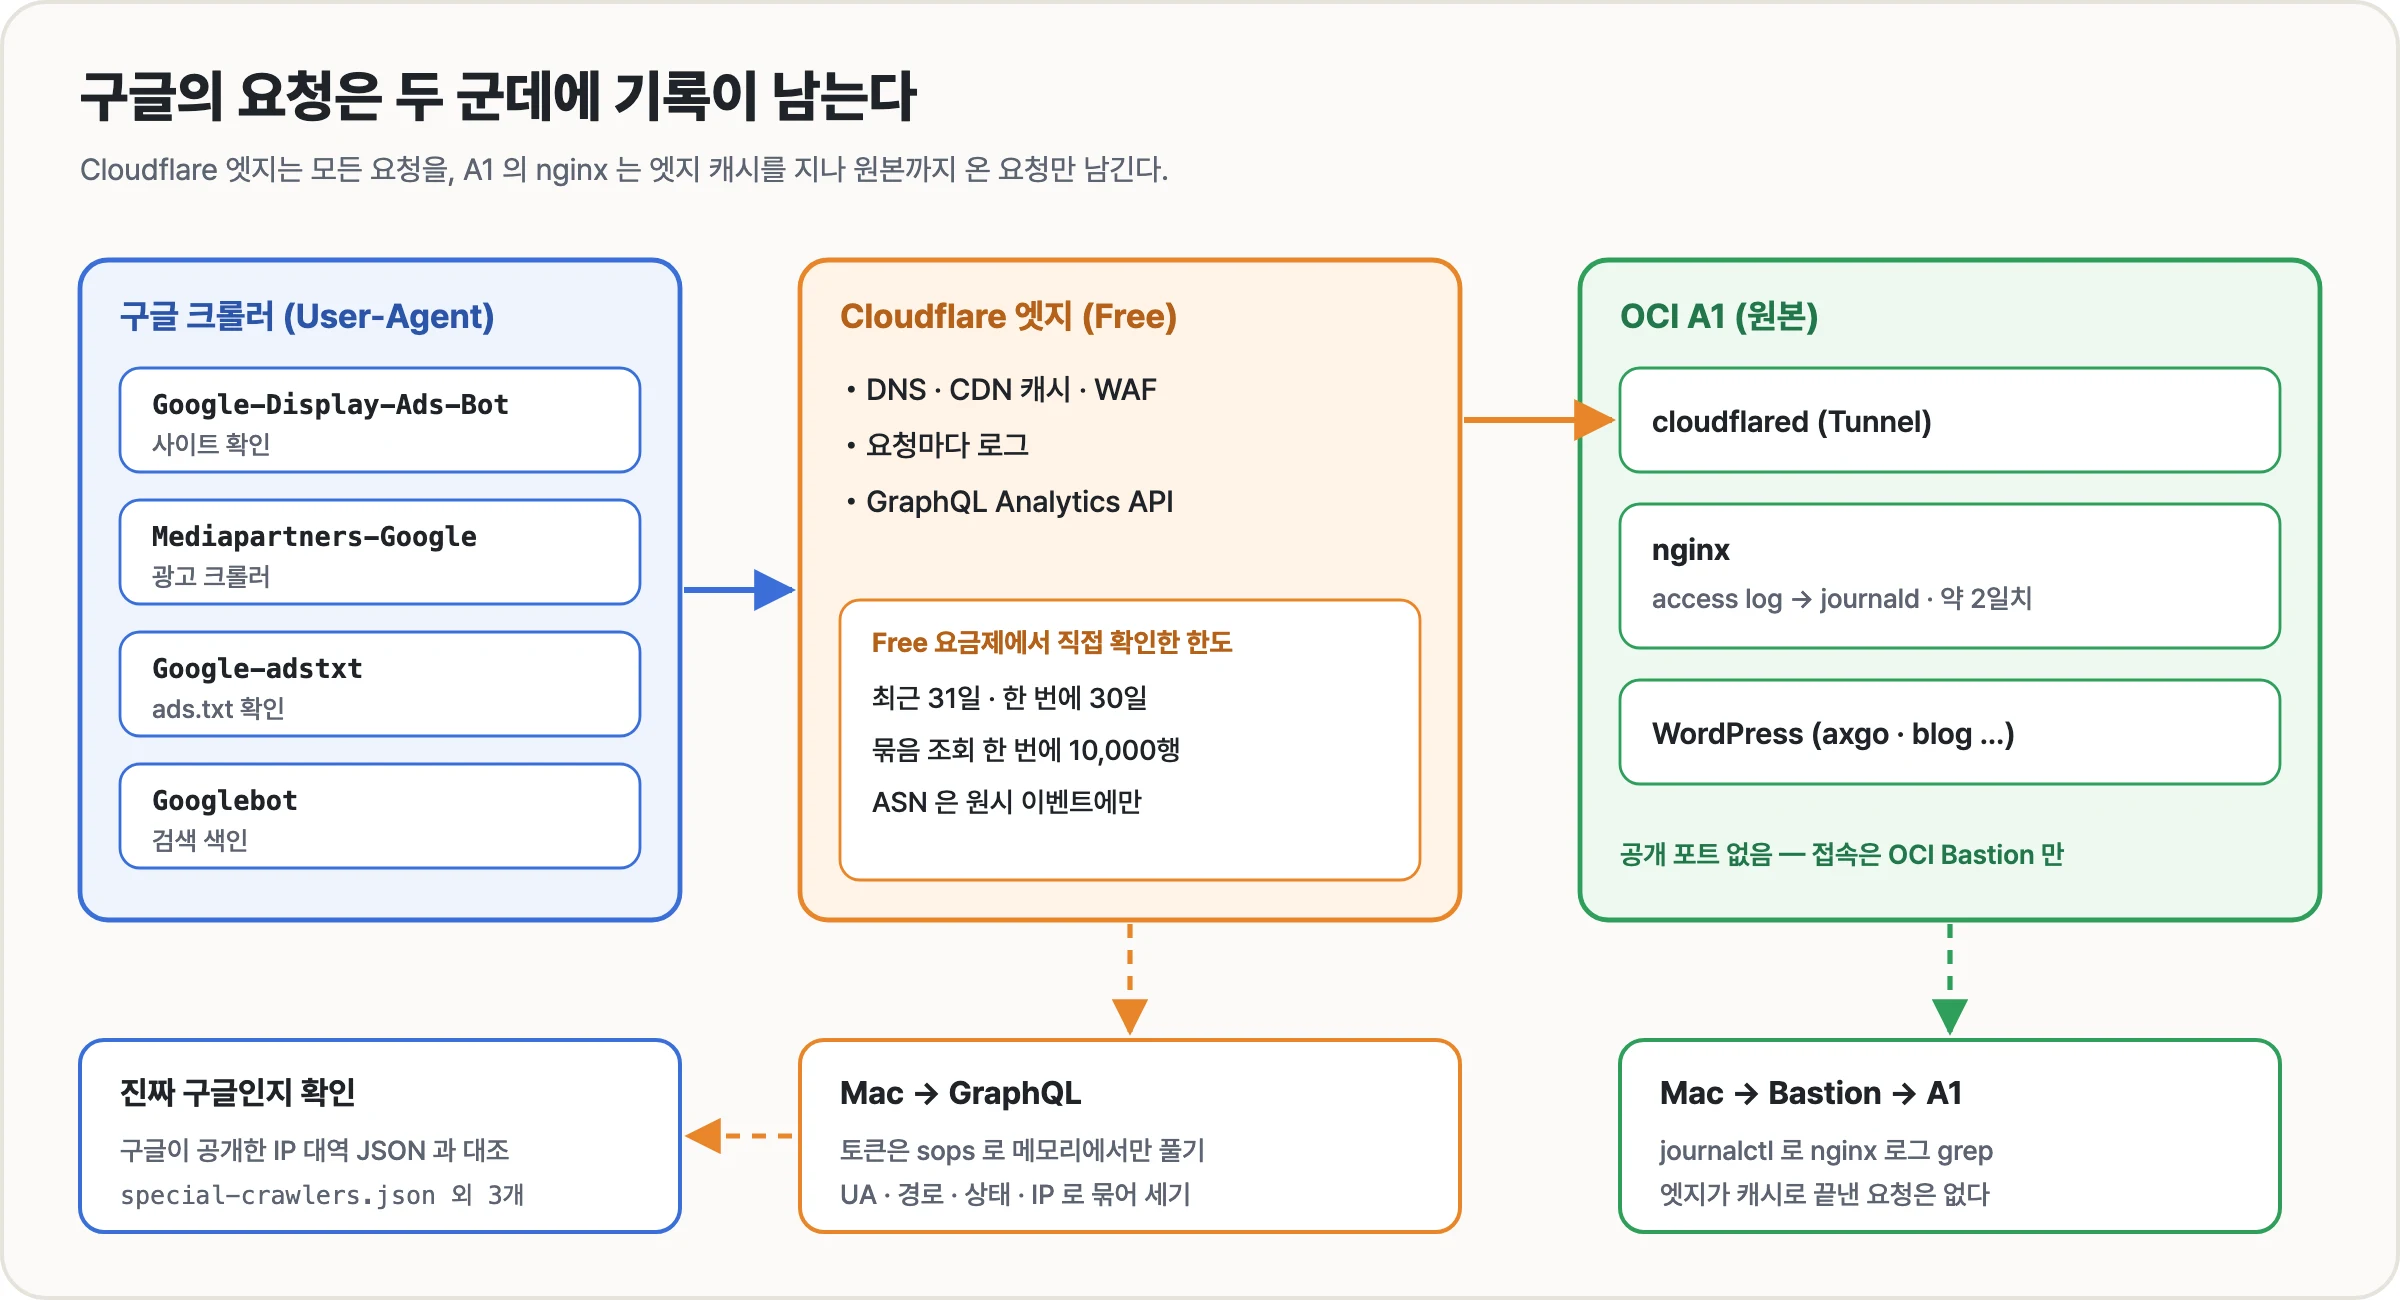
Cloudflare 대시보드 필터
한두 가지를 가볍게 볼 때는 대시보드로 충분하다. 도메인의 Analytics 요청 화면(주소가 /analytics/requests 로 끝난다)에서 user-agent 가 Mediapartners-Google 을 포함하는 조건으로 필터를 걸면 기간별 요청 수와 주소, 상태 코드를 볼 수 있다. 필터 조건은 주소의 filters 매개변수에 남아서 같은 화면을 다시 열기도 쉽다.
GraphQL Analytics API
시간별로 나눠 세거나 IP 를 대조하려면 API 가 낫다. Free 요금제에서 기록은 최근 31일까지만 남고 쿼리 하나로는 30일까지 조회된다. 묶음 조회(httpRequestsAdaptiveGroups)는 한 번에 10,000행까지라 하루씩 나눠서 받았다. ASN(clientAsn)은 묶음 조회에서는 막혀 있고 요청 단위 원시 이벤트(httpRequestsAdaptive)에서만 보였다. 트래픽이 많은 시간대는 Cloudflare 가 표본 추출한 추정값을 주므로 avg { sampleInterval } 도 함께 받아 1보다 큰 시간을 표시해 둔다.
query($z: String!, $since: Time!, $until: Time!) {
  viewer { zones(filter: {zoneTag: $z}) {
    httpRequestsAdaptiveGroups(limit: 10000, filter: {
        datetime_geq: $since, datetime_lt: $until,
        userAgent_like: "%Google-Display-Ads-Bot%"}) {
      count
      avg { sampleInterval }
      dimensions { datetimeHour clientRequestHTTPHost edgeResponseStatus clientIP verifiedBotCategory }
    }
  } }
}
Code language: plaintext (plaintext)
API 토큰에는 Zone → Analytics → Read 권한이 있으면 된다. 31일치를 하루 단위로 나눠 받고 표본이 섞인 시간만 다시 받는 파이썬 CLI 는 Cloudflare GraphQL Analytics API 로그 분석 CLI 글에 전체 코드를 올려 두었다.
nginx 로그
원본 쪽은 nginx 로그를 본다. Cloudflare 뒤의 nginx 는 그대로 두면 $remote_addr 에 Cloudflare 쪽(이 블로그는 cloudflared) 주소가 남는다. realip 모듈로 CF-Connecting-IP 헤더를 실제 클라이언트 IP 로 받아야 로그에서 IP 를 대조할 수 있다. 이 블로그는 로그 형식에 user-agent 와 캐시 상태, 응답 시간을 함께 남긴다.
set_real_ip_from 10.0.0.0/8;
set_real_ip_from 172.16.0.0/12;
set_real_ip_from 192.168.0.0/16;
set_real_ip_from 127.0.0.0/8;
real_ip_header CF-Connecting-IP;
real_ip_recursive off;

log_format blog '$remote_addr peer=$realip_remote_addr - [$time_local] "$host" "$request" '
                '$status $body_bytes_sent cache=$upstream_cache_status '
                'rt=$request_time urt=$upstream_response_time '
                'ref="$http_referer" ua="$http_user_agent"';
Code language: Nginx (nginx)
nginx 를 컨테이너로 돌리고 로그를 journald 로 보내고 있어서 아래처럼 찾는다. 로그 속 시각은 UTC 다.
sudo journalctl CONTAINER_NAME=blog-prod-nginx -o cat --since "2026-10-28 10:00" \
  | grep -E 'Mediapartners-Google|AdsBot-Google|Google-Display-Ads-Bot|Google-adstxt'
Code language: Bash (bash)
grep 에 adsbot 처럼 짧은 글자를 넣으면 엉뚱한 요청도 걸린다. 이 사이트에서는 OAI-AdsBot 이라는 user-agent 를 단 요청이 비밀 파일을 찾고 다녔는데 IP 는 구글 크롤러 대역이 아닌 클라우드 서버였다. 크롤러 이름은 전체를 적고 IP 도 함께 확인한다.
이 서버의 nginx 로그는 journald 용량 설정 때문에 며칠치만 남는다. 지난 기간을 볼 때는 31일이 남는 Cloudflare 기록을 기준으로 삼고, nginx 로그는 캐시 상태나 응답 시간처럼 원본에서만 보이는 값을 확인할 때 쓴다.
user-agent 는 흉내 낼 수 있다 — IP 로 확인하기
user-agent 는 요청을 보내는 쪽이 마음대로 적는 문자열이다. 구글은 진짜 구글 요청인지 확인하는 방법으로 DNS 조회와 IP 대역 대조를 안내한다.
역방향 DNS 와 정방향 DNS 로 확인
로그에 남은 IP 로 역방향 DNS 를 조회해 이름이 googlebot.com, google.com, googleusercontent.com 중 하나로 끝나는지 본다. 그다음 그 이름으로 정방향 조회를 해서 원래 IP 가 나오는지 확인한다. 일반 크롤러는 crawl-…googlebot.com, 예외 상황 크롤러는 rate-limited-proxy-…google.com 꼴의 이름이 나온다.
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
$ host 108.177.2.1
1.2.177.108.in-addr.arpa domain name pointer rate-limited-proxy-108-177-2-1.google.com.
Code language: Bash (bash)
정방향 조회를 빼면 안 된다. 역방향 DNS 이름은 그 IP 를 가진 쪽이 정하는 값이라 이름만 보고는 믿을 수 없다. 정방향으로 다시 풀어 같은 IP 가 나와야 구글이 관리하는 이름이다.
구글이 공개한 IP 대역 JSON 과 대조
요청이 많으면 IP 마다 DNS 를 조회하기보다 구글이 공개한 IP 대역 JSON 과 대조하는 편이 빠르다. 주소는 https://developers.google.com/static/crawling/ipranges/<파일 이름>.json 이고 파일은 다섯 개다.
| 파일 | 대상 | 대역 수(10월 29일 생성 파일) |
|---|---|---|
common-crawlers | Googlebot 같은 일반 크롤러 | 317 |
special-crawlers | AdsBot·Mediapartners-Google 같은 예외 상황 크롤러 | 272 |
user-triggered-fetchers | 사용자 요청으로 가져가는 도구(gae.googleusercontent.com) | 1,068 |
user-triggered-fetchers-google | 구글이 제어하는 사용자 트리거 도구(google.com) | 504 |
user-triggered-agents | 사용자 트리거 에이전트 | 20 |
파이썬이라면 표준 라이브러리 ipaddress 로 포함 여부를 바로 볼 수 있다. 다섯 파일을 받아 IP 를 대조하는 코드는 Cloudflare GraphQL Analytics API 로그 분석 CLI 글에 있다.
Cloudflare 검증 봇 분류도 같이 본다
Cloudflare 를 앞에 두고 있다면 확인할 것이 하나 더 있다. Cloudflare 는 확인을 마친 봇 요청에 검증 봇 분류(verifiedBotCategory)를 붙인다. Googlebot 은 Search Engine Crawler, Mediapartners-Google 은 Advertising & Marketing 으로 나온다. IP 대역과 이 분류를 함께 보면 사칭이 잘 드러난다.
이 사이트의 최근 일주일(10월 23~30일, KST) 기록에서 user-agent 에 Googlebot 이 들어간 요청을 나눠 보면 날마다 수십 건에서 200건 가까이가 구글 대역도 아니고 Cloudflare 검증 봇도 아니었다. 10월 27일에는 Googlebot 을 단 요청 399건 가운데 204건이 그랬다. 트래픽이 많은 몇몇 시간은 Cloudflare 표본 추출로 숫자가 추정값이다.
User-Agent 에 "Googlebot" 가 든 요청 (KST 날짜별, Cloudflare 검증 분류 / 구글 IP 대역)
10-23  검증 안 됨 / NOT-GOOGLE 68 · Search Engine Crawler / common-crawlers 32
10-24  검증 안 됨 / NOT-GOOGLE 77 · Search Engine Crawler / common-crawlers 50
10-25  Search Engine Crawler / common-crawlers 43 · 검증 안 됨 / NOT-GOOGLE 27
10-26  검증 안 됨 / NOT-GOOGLE 45 · Search Engine Crawler / common-crawlers 41
10-27  검증 안 됨 / NOT-GOOGLE 204 · Search Engine Crawler / common-crawlers 195
10-28  Search Engine Crawler / common-crawlers 172
10-29  Search Engine Crawler / common-crawlers 178 · 검증 안 됨 / NOT-GOOGLE 97
10-30  Search Engine Crawler / common-crawlers 22
Code language: plaintext (plaintext)
위 출력은 Cloudflare GraphQL 로 받은 요청을 날짜별로 묶고 IP 를 구글 대역과 대조한 짧은 스크립트의 결과다. 같은 코드에서 user-agent 글자만 바꾸면 다른 봇도 볼 수 있다.
광고 크롤러가 몰아서 가져가는 구간 찾기
여기부터는 이 사이트에서 본 기록이다. 사이트 하나의 기록이라 일반 규칙으로 받아들이면 곤란하지만, 같은 방법으로 자기 로그를 나눠 보면 비슷한 문제를 찾을 수 있다.
광고 크롤러 Mediapartners-Google 은 평소 사흘에 한 번 새벽 3시쯤 와서 76~194건을 가져갔다. 그런데 몇 시간 동안 몰아서 가져가는 때가 있었다. 시간당 50건 넘게 온 시간이 3시간 안쪽으로 이어지고 합쳐서 600건이 넘는 구간을 집중 크롤링으로 잡으면 이 사이트 기록에서는 네 번이 보인다.
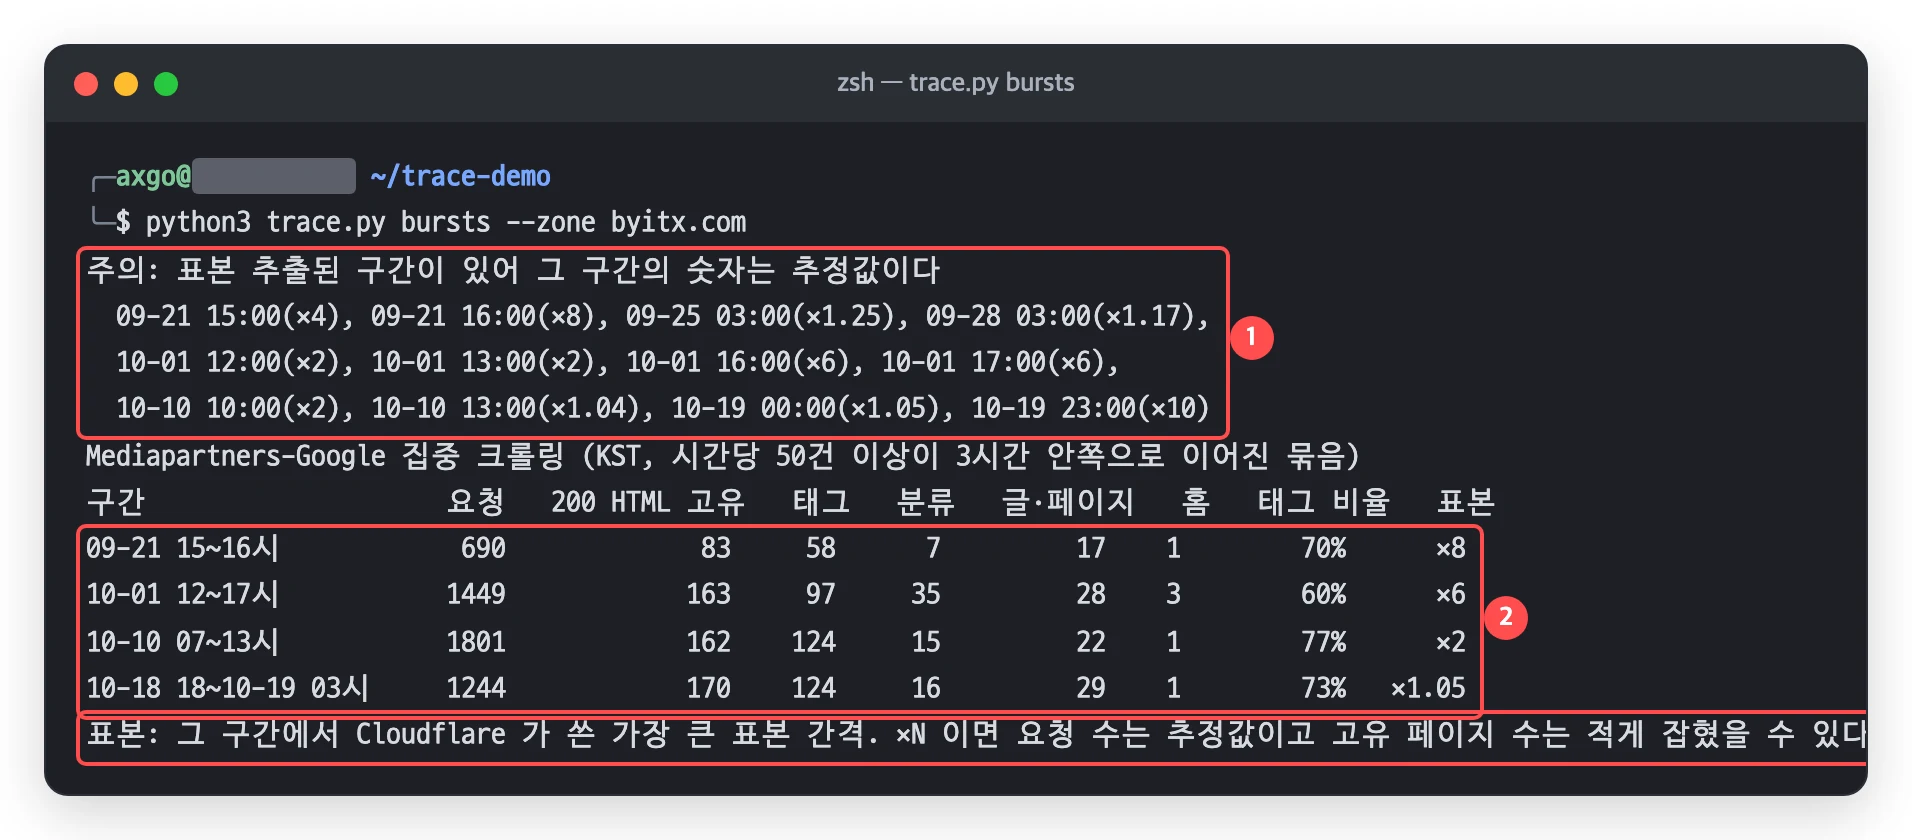
트래픽이 많은 시간대는 Cloudflare 가 표본 추출(×1.05~×8)해서 요청 수는 추정값이고 고유 페이지 수는 실제보다 적게 잡혔을 수 있다.
AdsBot-Google 은 10월 28일 20시 31분에 이 사이트에서 처음 보였다. 모바일용 AdsBot-Google-Mobile 이 글 한 편을, AdsBot-Google 이 정적 파일 몇 개를 가져갔고 둘 다 special-crawlers 대역이었다.
크롤러가 받아 간 페이지에서 찾은 문제
대부분이 태그 목록이었다
집중 크롤링 때 200 으로 받은 HTML 페이지만 골라 종류별로 나눴다. 워드프레스라면 주소에 /tag/·/category/ 가 들어 있는지로 목록 페이지를 구분할 수 있다.
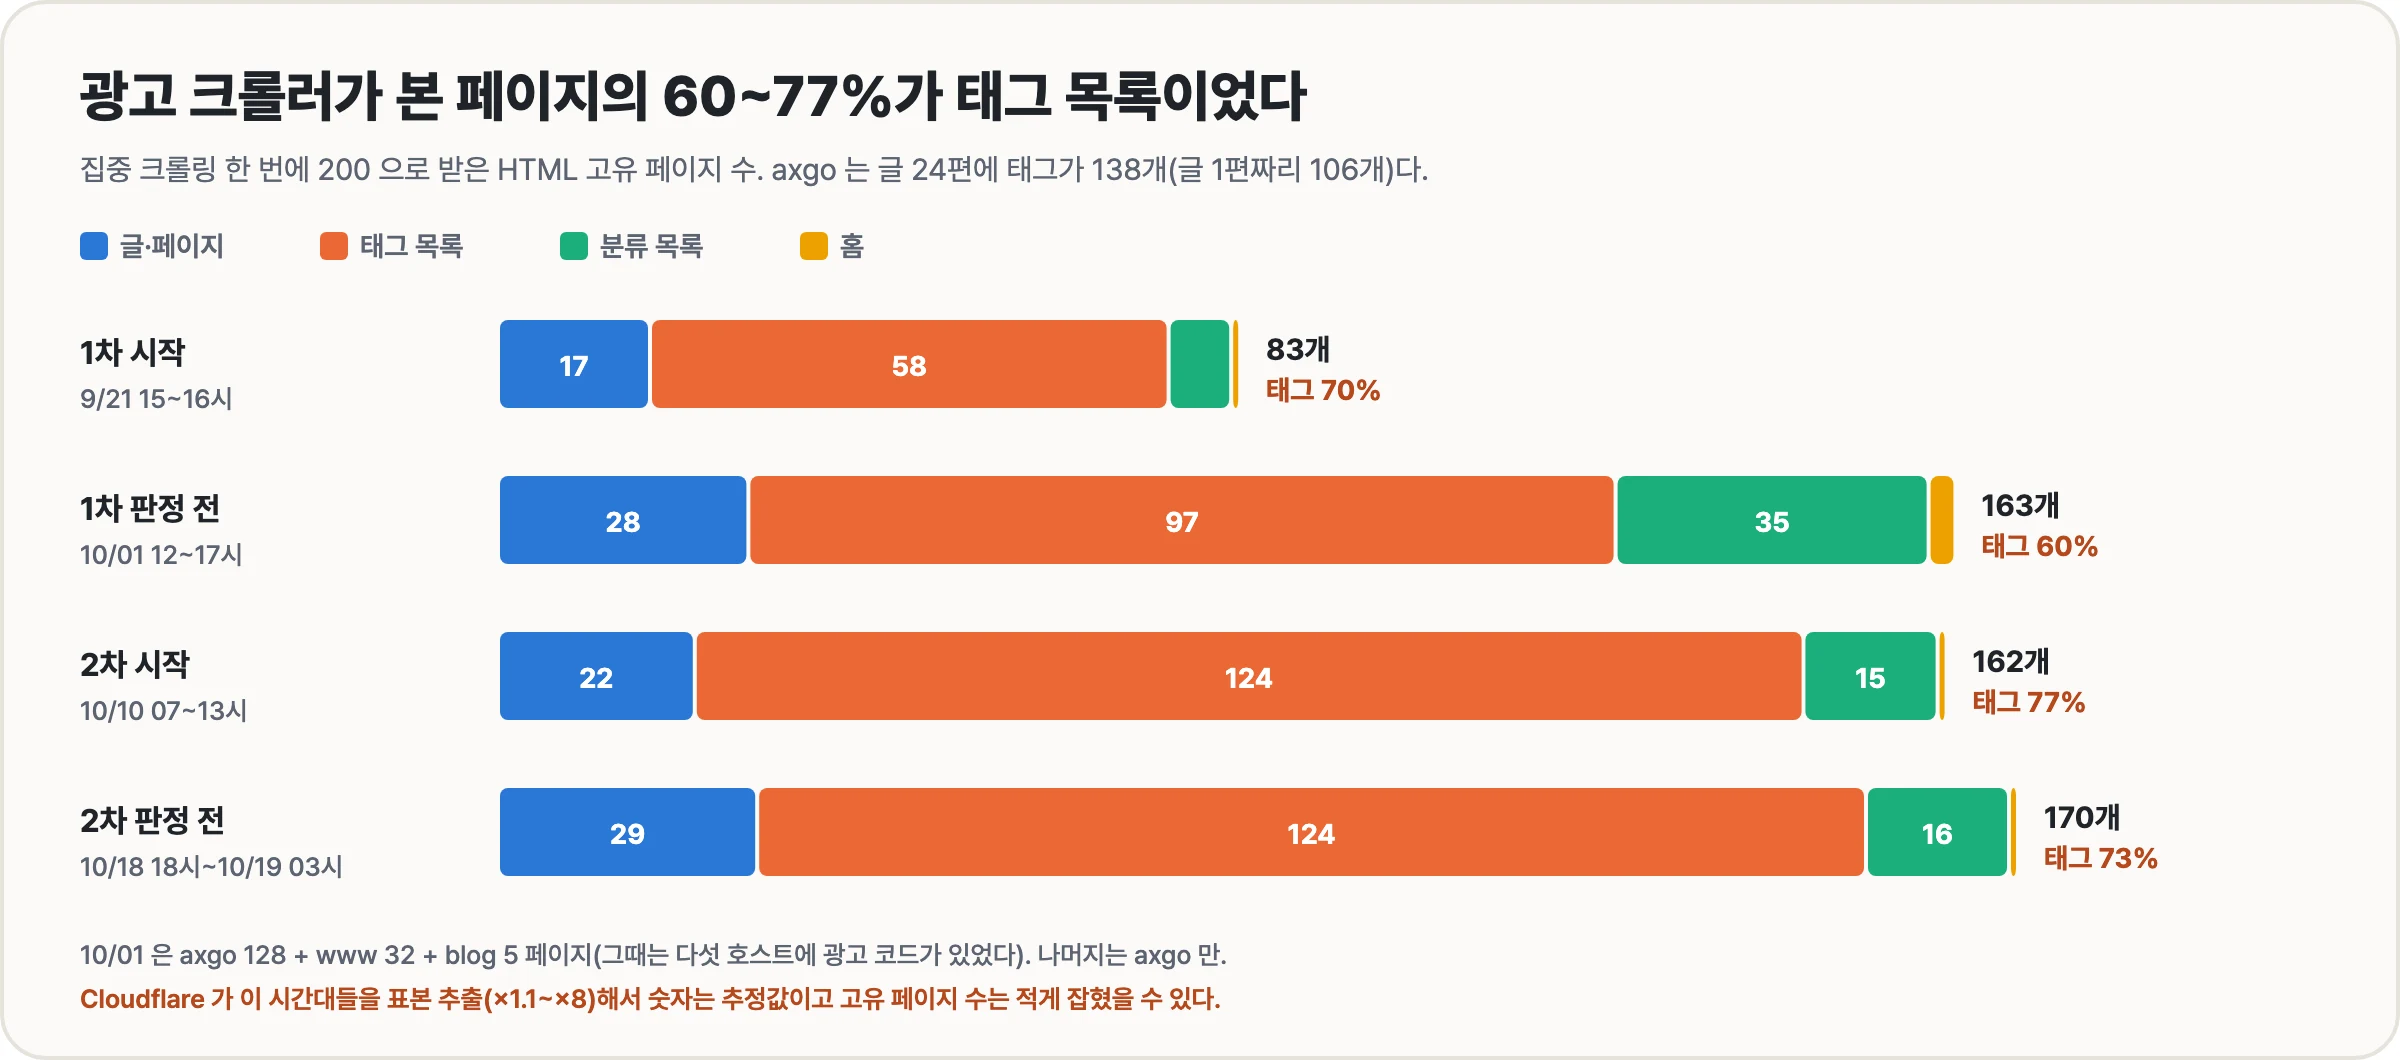
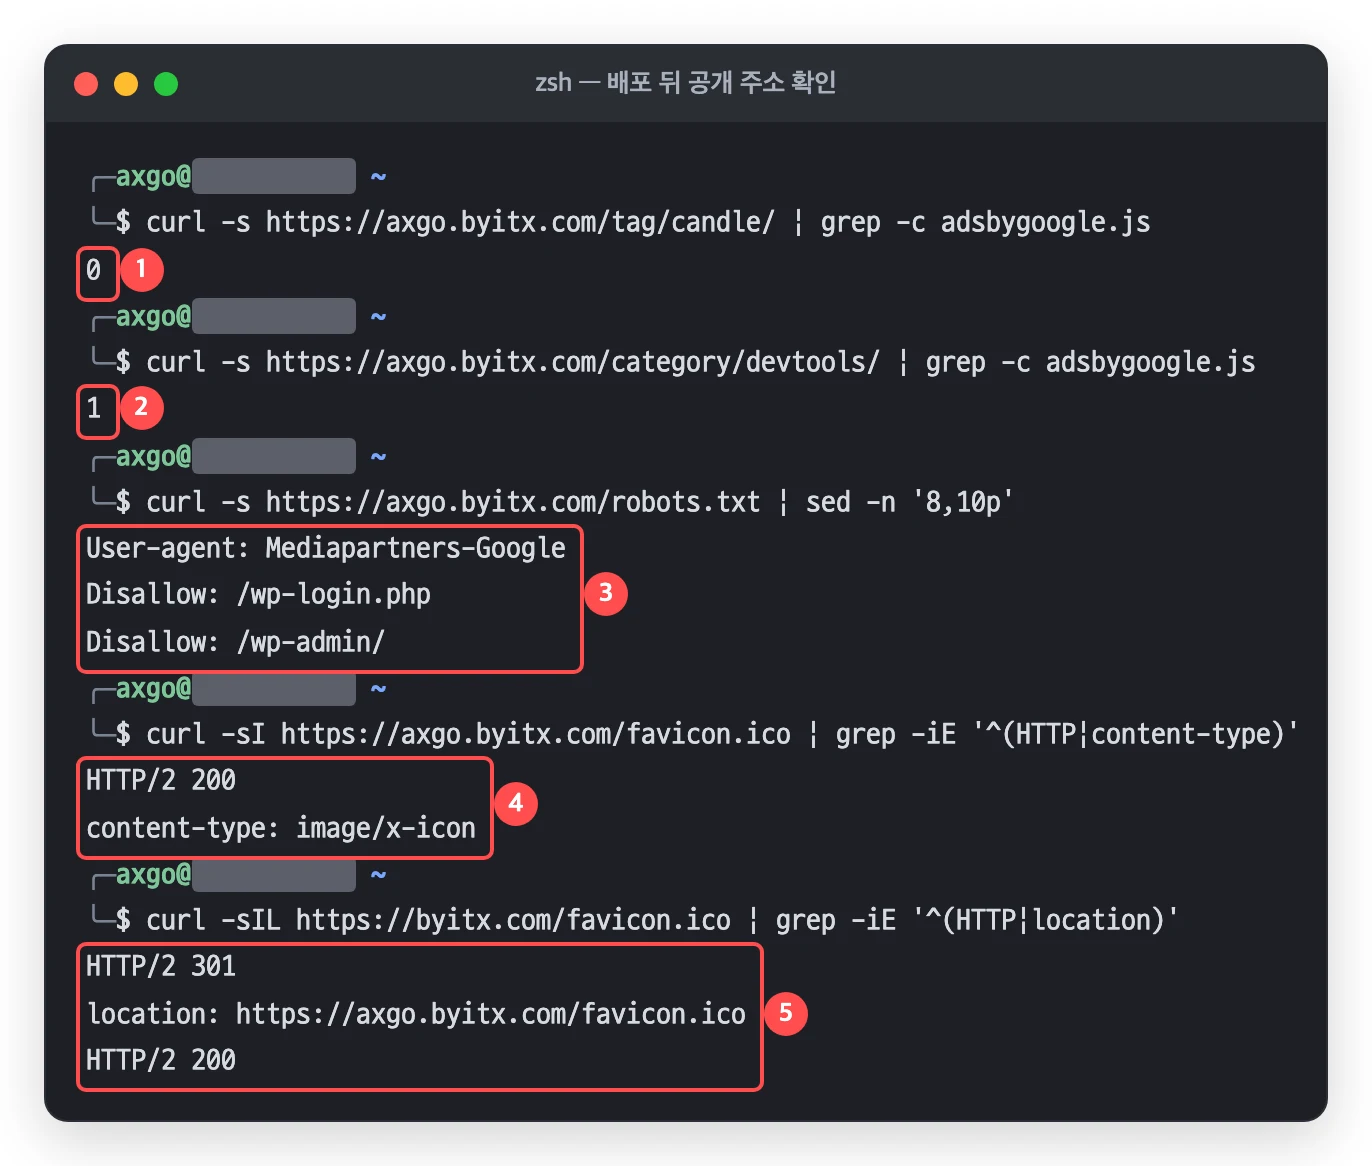
그때 axgo 에는 글이 24편인데 태그는 138개였다. 그중 106개는 글이 1편, 22개는 2편뿐이다. 태그 페이지를 열면 글 카드 한두 장과 광고 스크립트가 있었다. 10월 10일과 18~19일에 크롤러가 본 axgo 는 대부분 태그 페이지였다.
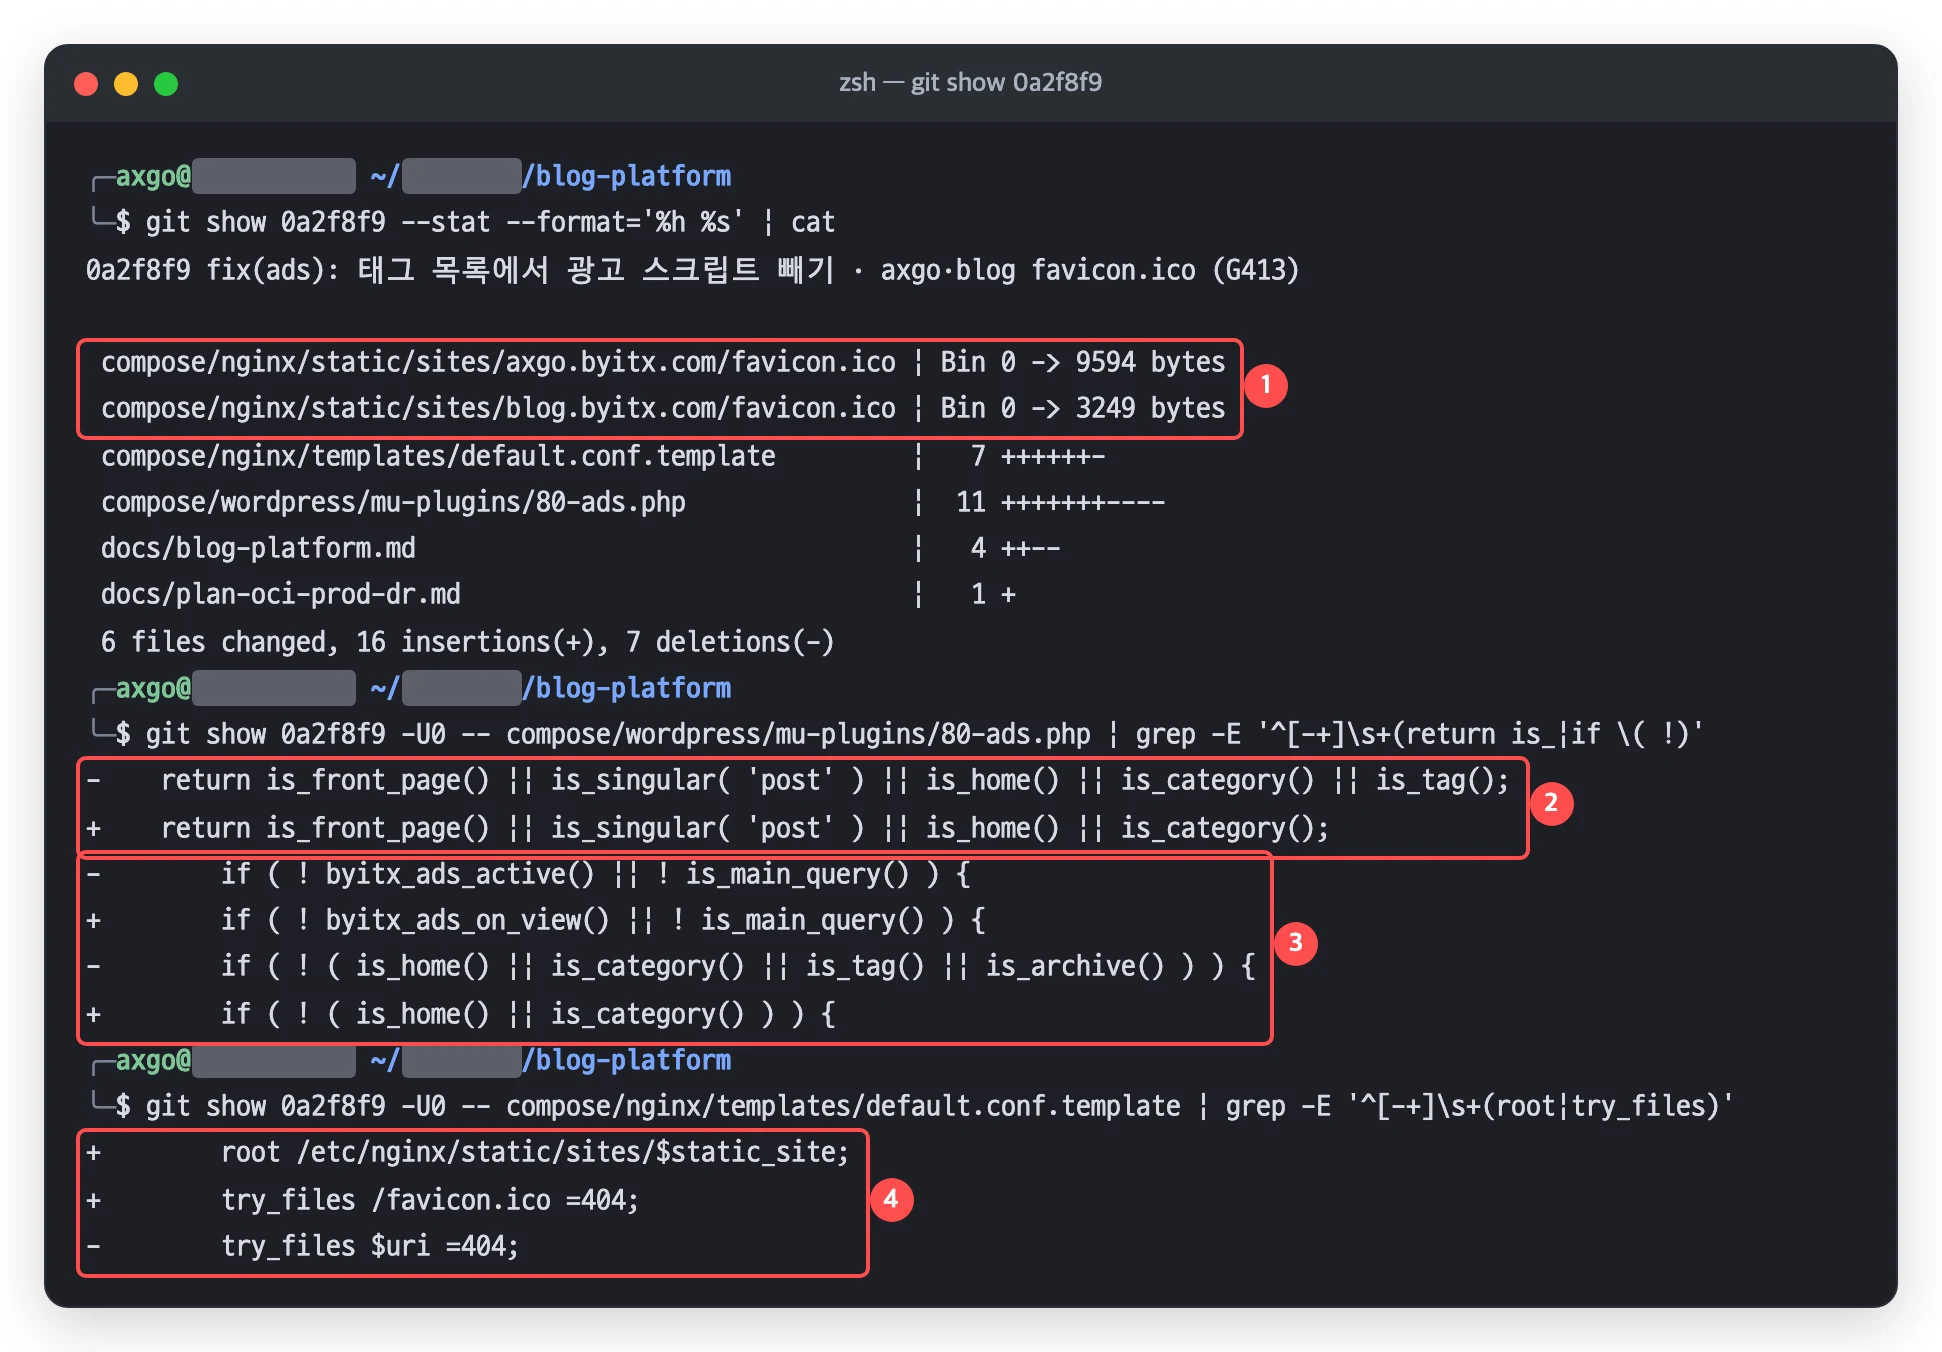
태그 페이지가 크롤링된 건 그 페이지에도 애드센스 스크립트가 있었기 때문으로 보인다. 광고를 놓을 화면을 고르는 PHP 함수가 홈·글·분류 목록과 함께 태그 목록(is_tag())에도 스크립트를 넣고 있었다. 글이 5편 미만인 태그는 noindex 로 바꿔 두었지만 광고 크롤러는 그 태그 페이지도 그대로 가져갔다. 광고 크롤러가 본 이 사이트는 대부분 글 1~2편짜리 목록에 광고 코드가 붙은 페이지였다.
로그인 주소·favicon·폰트에서 받은 4xx
같은 크롤러가 200 이 아닌 응답을 받은 곳도 찾아봤다.
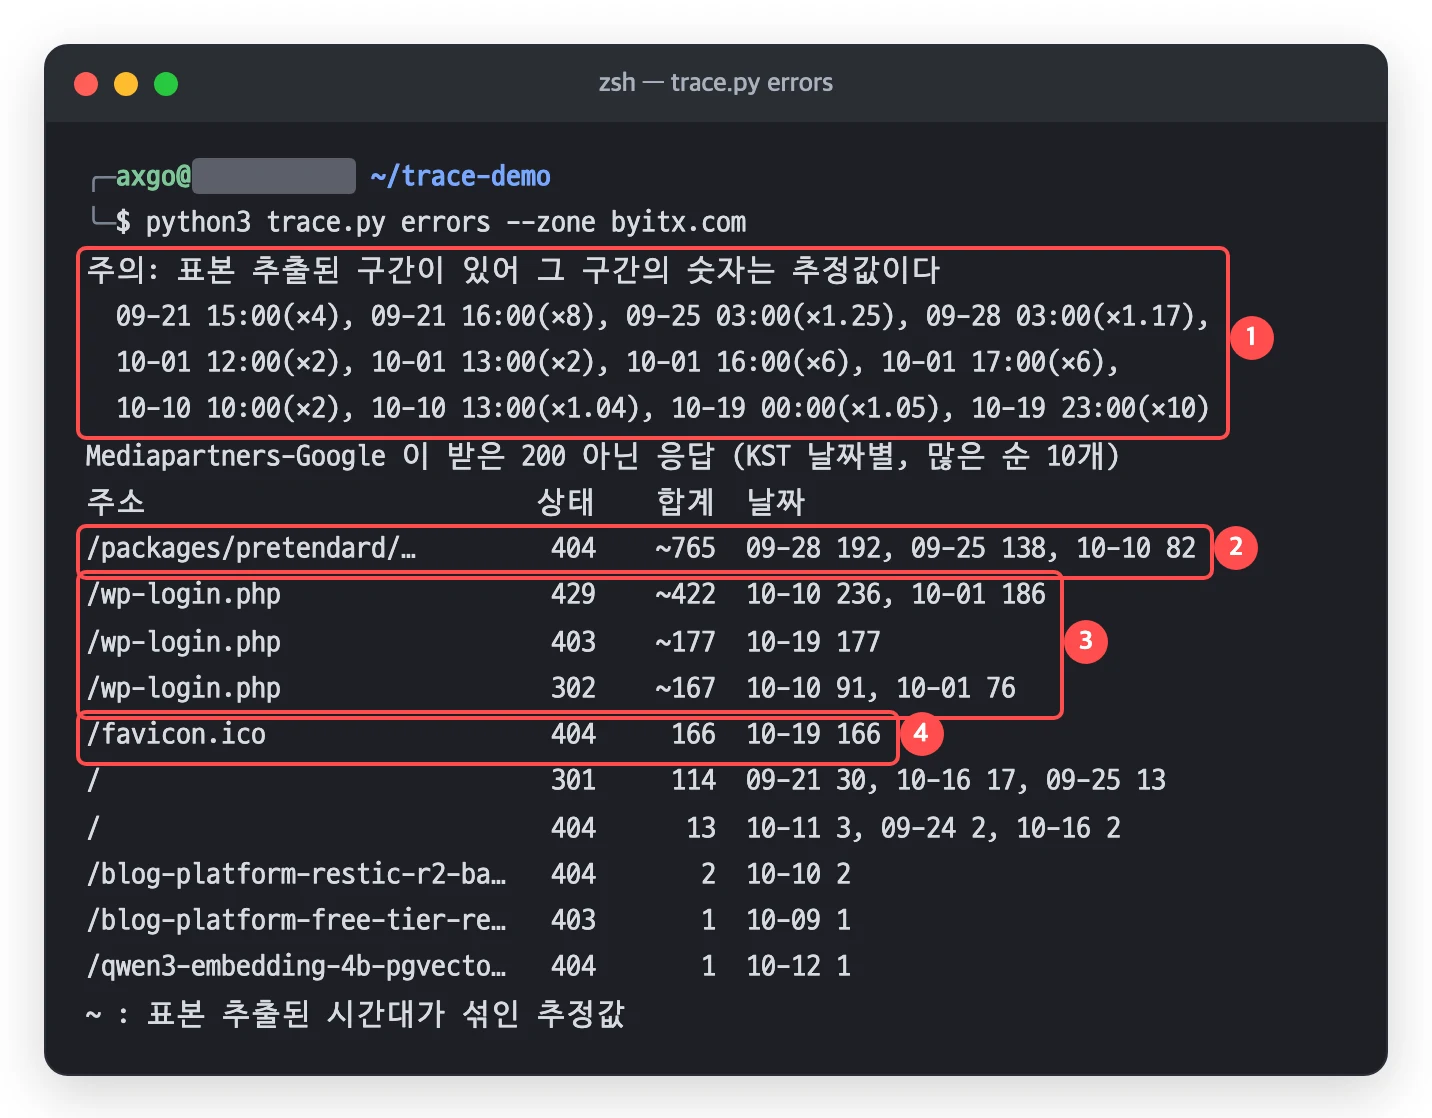
/favicon.ico 404.로그인 주소부터 보면, 상단 사용자 아이콘을 누르면 로그인 창이 뜨고 그 안에 구글 로그인 버튼이 있다. 이 창은 모든 페이지 HTML 에 들어 있다. 링크 주소는 wp-login.php?byitx_google=1&redirect_to=<./{page}> 이고 rel="nofollow" 가 붙어 있다. 그래도 크롤러는 nofollow 와 상관없이 페이지마다 이 로그인 주소를 요청했다. redirect_to 만 다른 로그인 주소가 페이지 수만큼 생긴 셈이다. 원본 nginx 가 로그인 주소에 IP 당 분당 6건(버스트 5) 제한을 걸어 두어서 10월 1일과 10일에는 429 와, 구글 로그인(accounts.google.com)으로 보내는 302 를 받았다. 10월 18일부터는 엣지에서 로그인 주소에 managed challenge 를 걸어 두어 10월 19일 새벽에는 403 이 177건 돌아갔다.
/favicon.ico 는 실제로 404 였다. 페이지는 <link rel="icon"> 으로 사이트 아이콘을 따로 가리키지만 크롤러와 브라우저는 루트의 /favicon.ico 도 찾는다. nginx 가 이 파일을 워드프레스 루트에서 찾았는데 파일이 없었다. 크롤러만이 아니라 브라우저 요청도 30일 동안 82건이 404 였다.
Pretendard 폰트 404 765건은 전부 이 크롤러였다. 폰트 CSS(jsDelivr)는 url(../../../packages/pretendard/…) 처럼 상대 경로로 폰트 파일을 가리킨다. 브라우저는 CSS 주소를 기준으로 풀어 jsDelivr 에서 받는다. 이 크롤러는 우리 페이지 주소를 기준으로 푼 것으로 보인다. 방문자 브라우저에서 온 같은 요청은 0건이라 처음에는 그대로 두었는데, 다른 크롤러 몇 개도 같은 주소를 요청하고 있어서 나중에 nginx 에서 jsDelivr 로 301 하게 바꿨다(아래).
robots.txt 의 * 그룹은 이 크롤러에게 없는 것과 같았다
robots.txt 도 다시 봤다. axgo·blog 의 robots.txt 에는 User-agent: * 그룹만 있었다. 앞에서 본 대로 Mediapartners-Google 은 * 를 무시한다. * 그룹에 /wp-admin/ 을 막아 두어도 이 크롤러에게는 아무 규칙이 없는 것과(우이독경) 같았다.
*)는 무시된다.robots.txt·광고 스크립트·favicon 고치기
로그로 확인한 것만 고쳐서 바로 배포했다.
태그 목록에서 광고 스크립트 빼기
광고 스크립트를 넣는 함수에서 태그 목록을 뺐다. 목록 사이에 넣는 인피드도 같은 함수를 거치게 하고 홈·분류 목록에서만 놓게 했다. 이제 광고 스크립트가 있는 화면은 홈, 글, 분류 목록뿐이다. 도움말대로라면 태그 목록 138개는 더 이상 광고 크롤러가 가져갈 대상이 아니다.
robots.txt 에 애드센스 크롤러 그룹 넣기
User-agent: Mediapartners-Google
Disallow: /wp-login.php
Disallow: /wp-admin/
Code language: plaintext (plaintext)
크롤러는 구체적인 그룹 하나만 따르고 특정 그룹과 * 그룹은 합치지 않는다. 그래서 * 에 있던 /wp-admin/ 도 이 그룹에 다시 적었다. 애드센스 도움말의 예시는 User-agent: Mediapartners-Google 과 User-agent: Google-Display-Ads-Bot 두 줄을 적는데, 이 사이트는 Mediapartners-Google 그룹만 넣었다. 로그인과 관리 화면에는 광고가 없어서 막아도 광고 게재에는 영향이 없다.
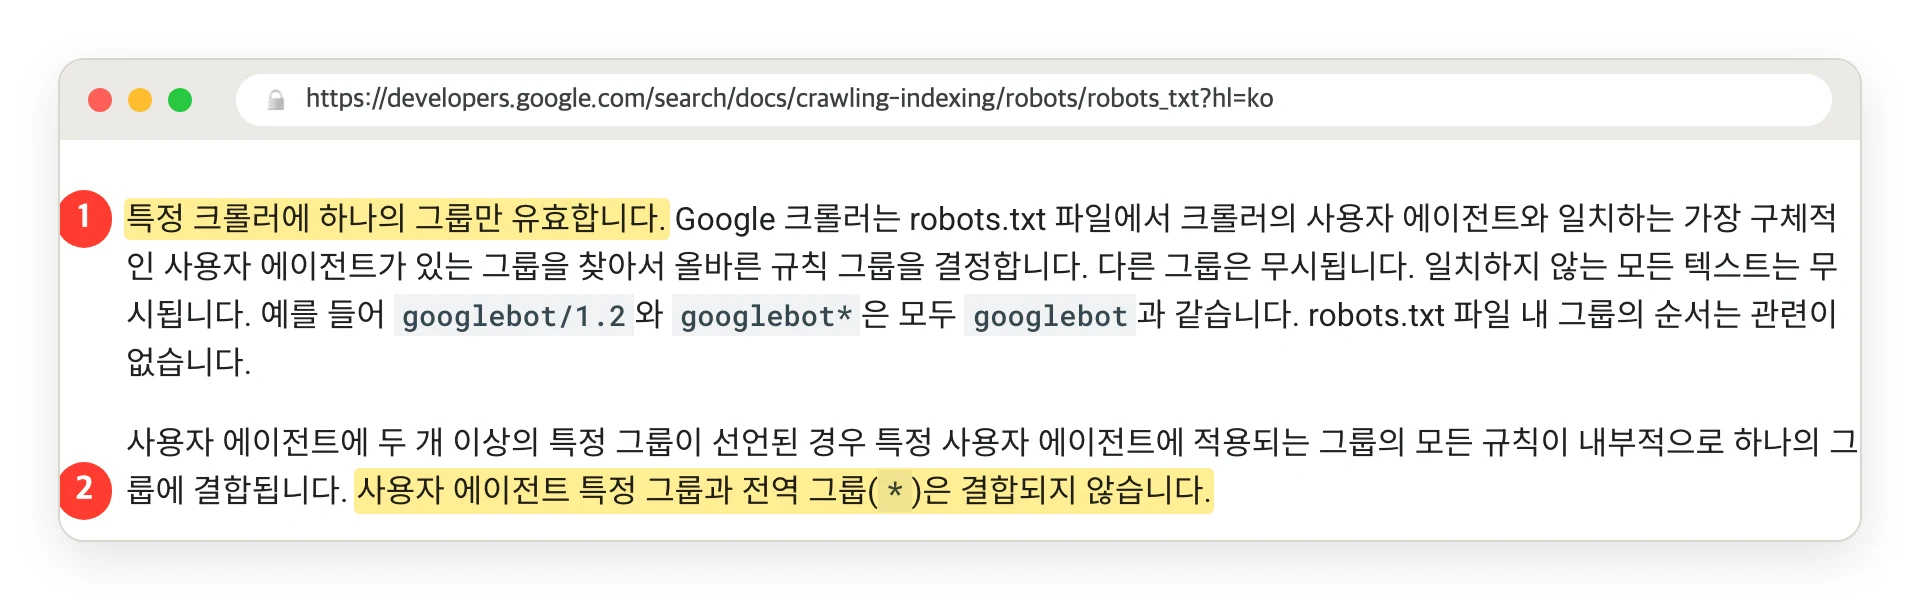
*)은 합쳐지지 않는다.favicon.ico 와 폰트 주소
사이트 아이콘(512px)을 16·32·48px ICO 로 바꿔 nginx 의 사이트별 정적 파일 디렉터리에 넣었다. byitx.com 과 www 는 301 을 따라가 axgo.byitx.com 의 파비콘을 받는다.
location = /favicon.ico {
    root /etc/nginx/static/sites/$static_site;
    try_files /favicon.ico =404;
    access_log off;
    log_not_found off;
    add_header Cache-Control "public, max-age=86400";
}
Code language: Nginx (nginx)
Pretendard 폰트를 페이지 주소 기준으로 찾는 요청은 jsDelivr 의 원래 위치로 301 한다. 10월 26일에 넣었고, 10월 28일 광고 크롤러의 정기 크롤링에서 404 대신 301 이 나가는 것을 확인했다.
location ^~ /packages/pretendard/ { return 301 https://cdn.jsdelivr.net/gh/orioncactus/pretendard@v1.3.9$request_uri; }
Code language: Nginx (nginx)
고친 뒤의 크롤링에서 달라진 것
배포 직후 nginx 로그도 봤다. Google-adstxt 라는 user-agent 가 4~5시간마다 byitx.com/ads.txt 를 가져가고 있었다. 새 글을 발행하고 59초 뒤에는 Mediapartners-Google 이 그 글을 가져갔다. robots.txt 를 바꾼 지 얼마 안 된 02시 16분에도 같은 크롤러가 로그인 주소를 두 번 가져갔다. 구글 문서에 따르면 robots.txt 는 보통 최대 24시간 동안 캐시된다.
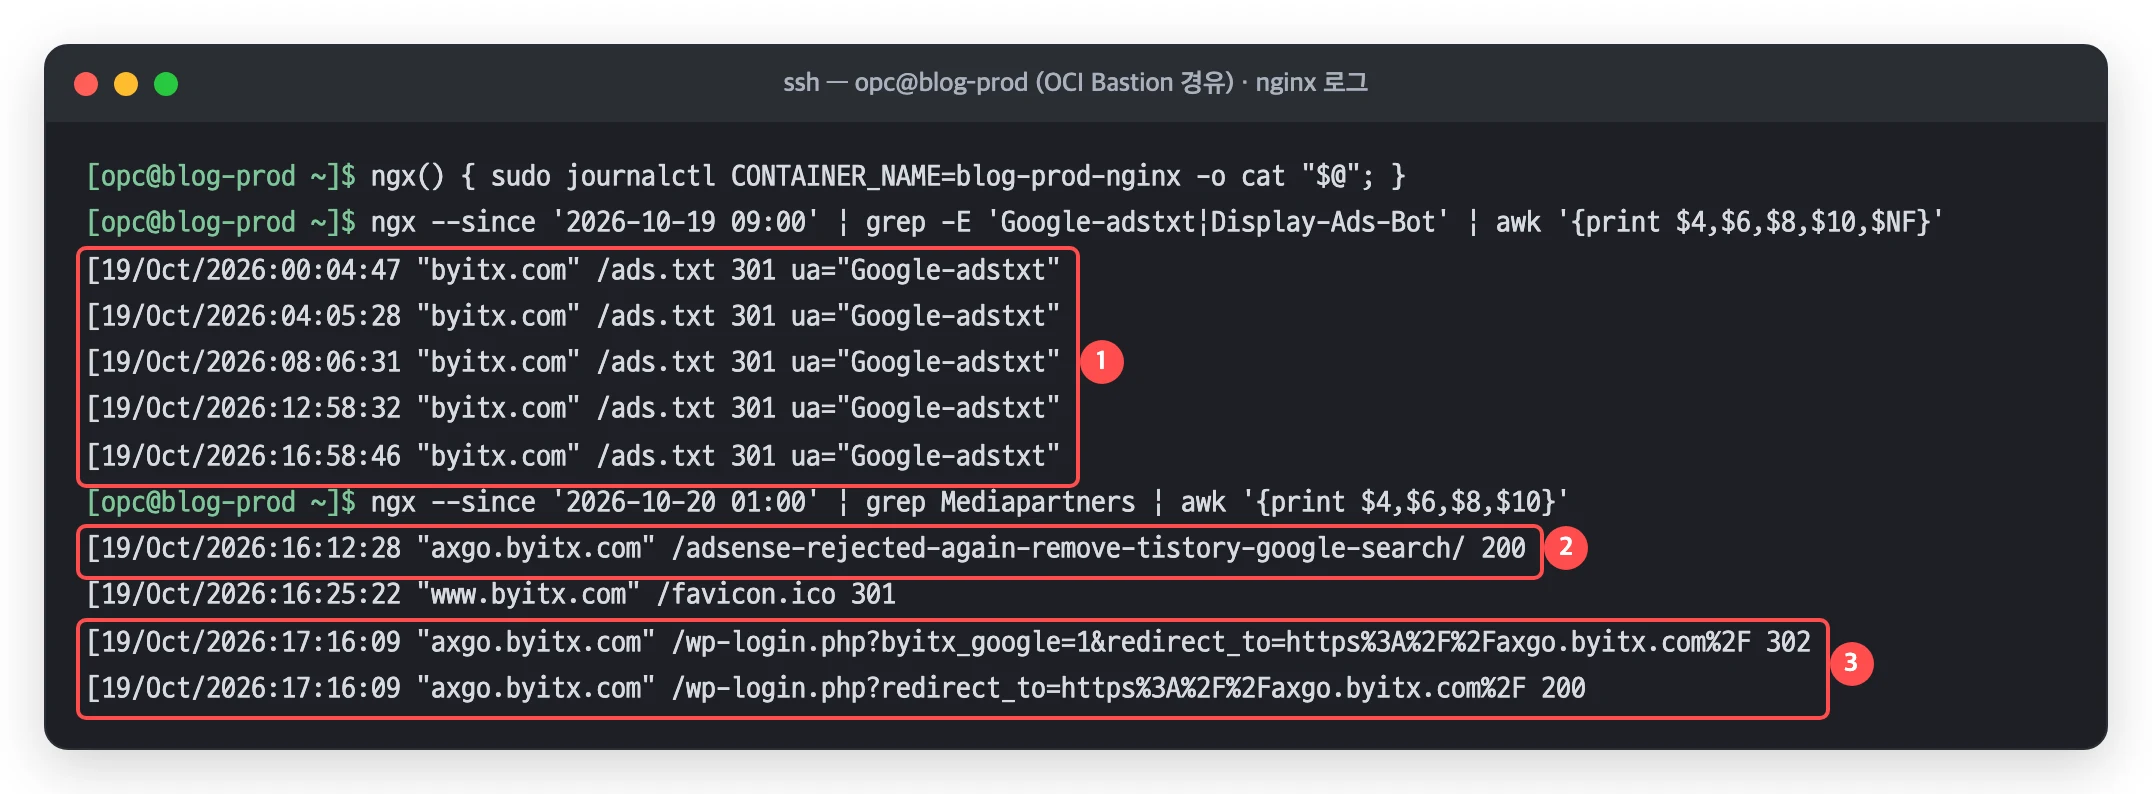
그 뒤의 기록은 이랬다.
- 10월 20일 02시 16분의 두 건을 끝으로 로그인 주소 요청이 사라졌다. 10월 20일 16~18시의 집중 크롤링에도 로그인·관리 화면 요청은 0건이었다. robots.txt 그룹이 반영된 것으로 보인다.
/favicon.ico404 도 10월 20일 뒤로는 나오지 않았다.- 태그 목록은 10월 20일 집중 크롤링에서는 여전히 고유 HTML 181개 중 135개였다. 태그 페이지에 광고 스크립트가 없는데도 가져간 것을 보면 예전에 모아 둔 주소 목록을 다시 쓴 것 같다(추정).
- 10월 28일 19~20시의 집중 크롤링에서는 태그 목록이 0개였다. 고유 HTML 은 50개가 안 됐고 홈·소개·글·분류·연락 페이지만 있었다. 원본까지 온 요청은 모두 200 이었고 가장 느린 응답이 0.167초였다.
정리
- 구글 크롤러는 이름마다 robots.txt 를 처리하는 방식이 다르다. Googlebot 은 자기 그룹이 없으면
*그룹을 따르지만 Mediapartners-Google·AdsBot-Google 은 자기 이름 그룹만 본다. 막을 주소가 있으면 그룹을 따로 적는다. - user-agent 만 믿지 않는다. 역방향·정방향 DNS 나 구글이 공개한 IP 대역 JSON 으로 확인하고, Cloudflare 를 쓴다면 검증 봇 분류도 함께 본다.
- noindex 는 검색 결과에서 빼는 규칙이다. 광고 태그가 있는 페이지는 애드센스 크롤러가 가져가므로 목록 페이지에는 광고 코드를 두지 않는다.
- 로그인 링크는 nofollow 여도 크롤러가 요청한다. 로그인에 건 속도 제한과 챌린지가 크롤러에게는 429·403 으로 돌아간다.
- Cloudflare Free 의 기록은 31일만 남는다. 필요한 기간의 기록은 지나가기 전에 받아 둔다.