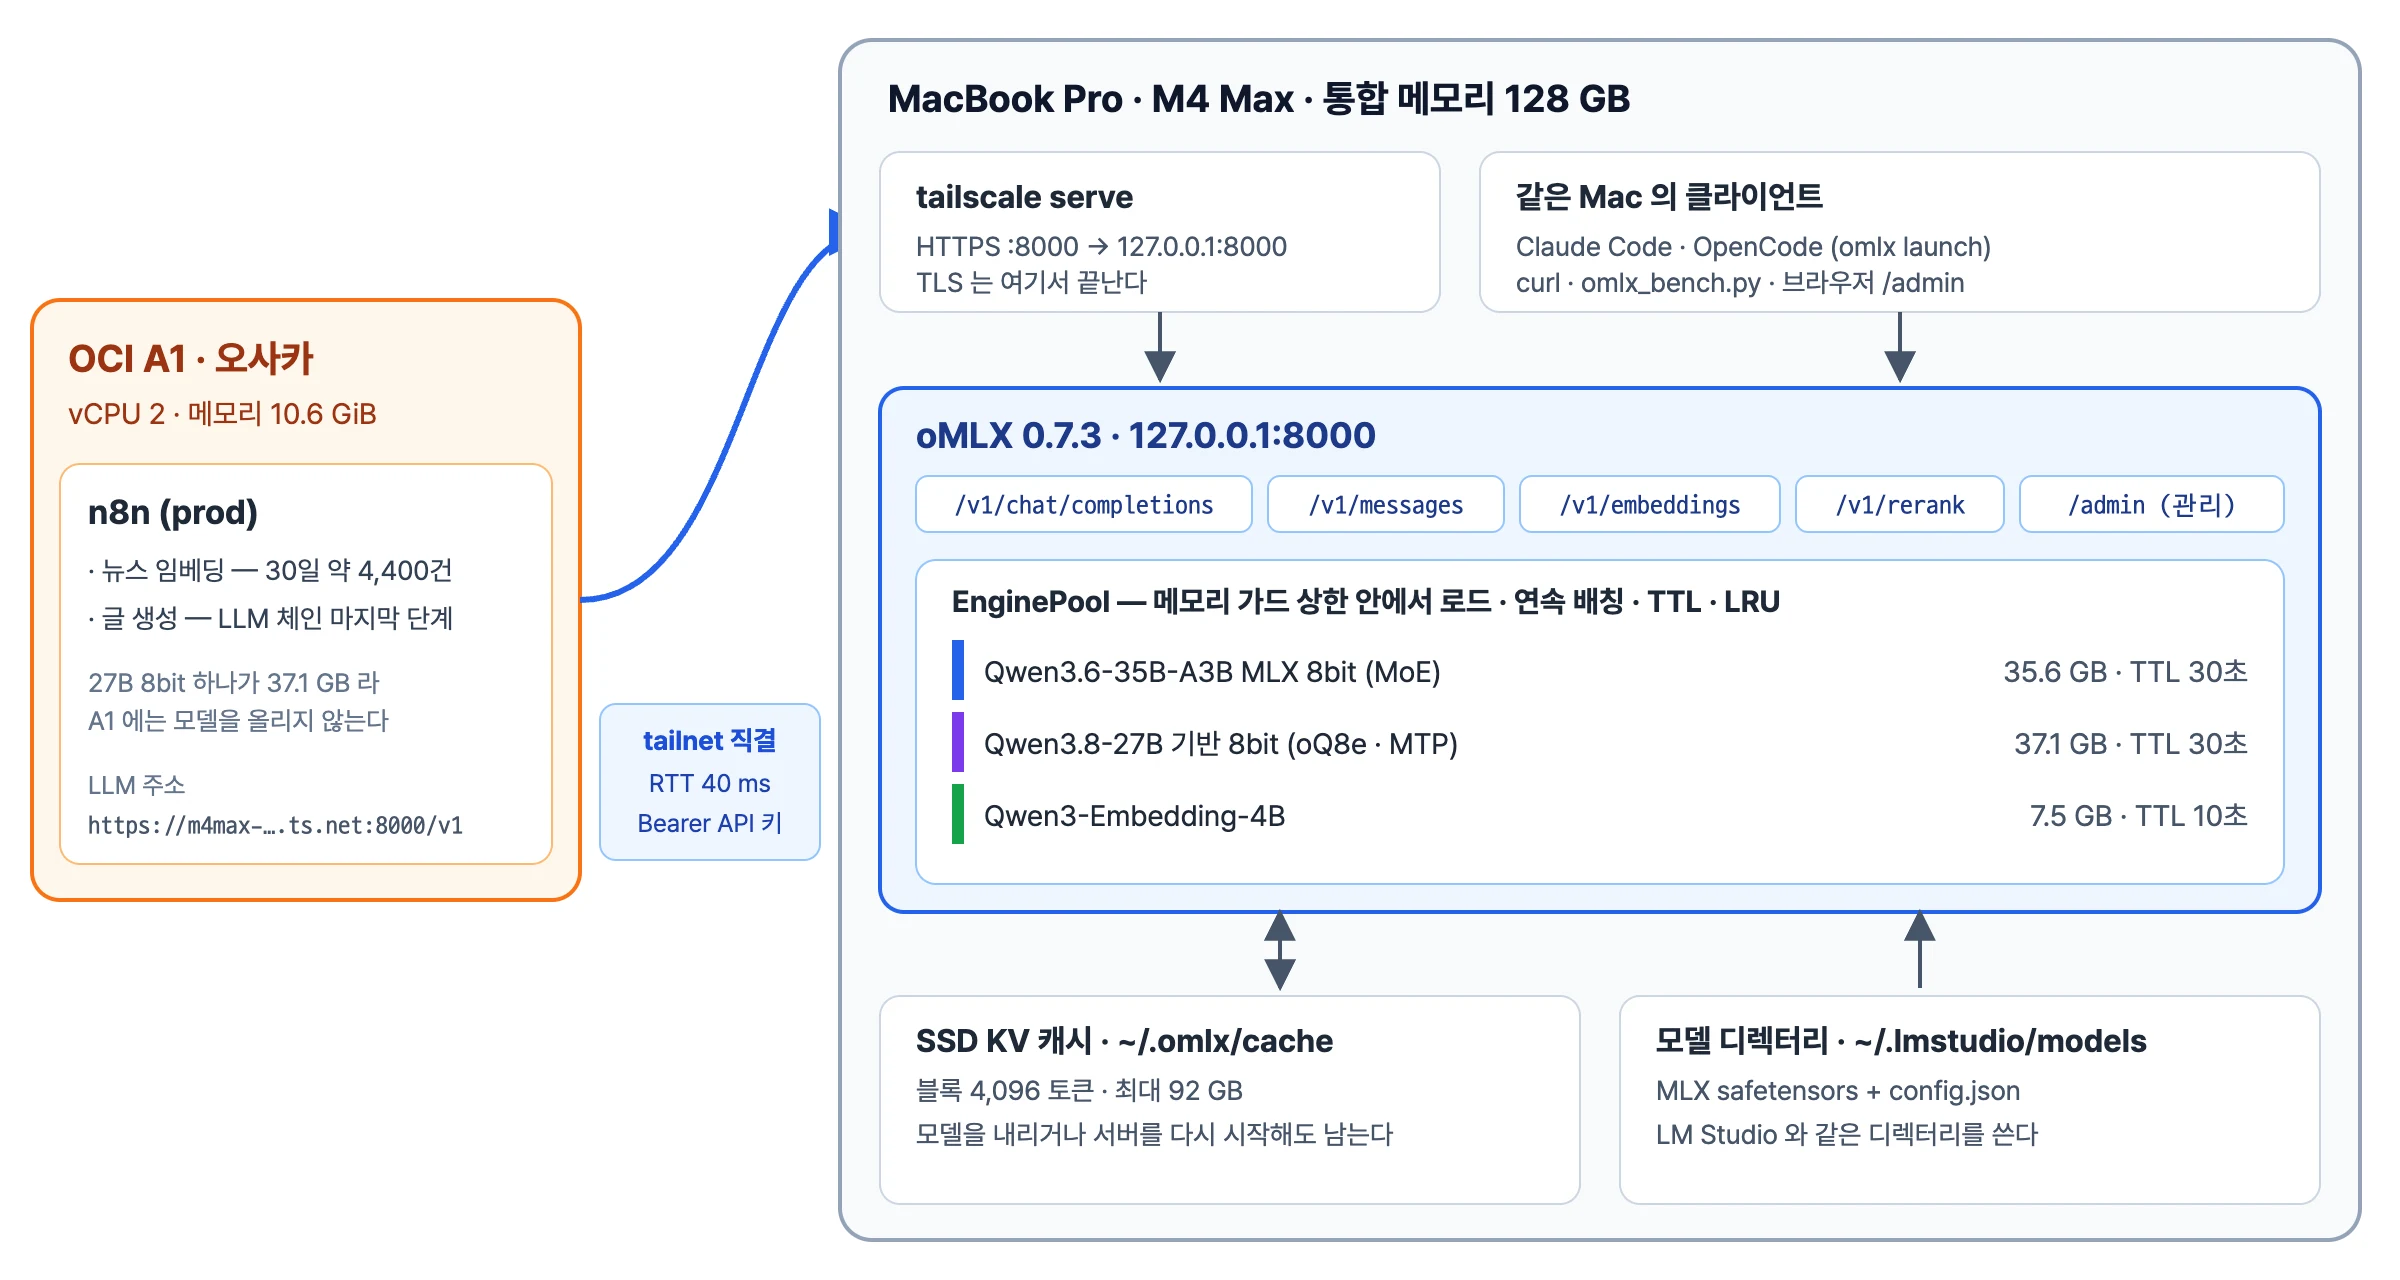
나의 블로그 자동화 워크플로우는 오라클 클라우드 무료 서버(OCI A1)의 n8n 에서 실행된다. 무료 서버에 GPU가 없어 n8n에서 LLM 사용을 위해 외부 LLM 호출 API를 사용해야 하는 상태이고, 임베딩 벡터 생성을 필요로 하는 작업까지 한 달에 8천 건 이상의 LLM·임베딩 모델 API 호출이 발생한다.
- OCI A1.Flex는 vCPU 2개, 메모리 12GB 다. 글 생성에 적합한 27B 4bit 양자화 모델 조차 메모리에 올리려면 17.6 GB 메모리가 필요해 A1 에서는 모델 로딩 자체가 불가능하다. (GPU가 아닌 CPU이기 때문에 더욱 그렇다)
- 때문에 A1에서 Tailscale로 연결된 Mac을 로컬 LLM 서버로 사용 가능하도록 했다.
- Mac 에서 LLM을 API로 서빙 해주는 프로그램은 oMLX을 사용중이다. 아래 측정 자료는 모두 oMLX 0.7.3 으로 측정했다.
현재 맥북에서 운영중인 oMLX의 주요 성능 측정값은 아래와 같다.
- Qwen3.6-35B-A3B MLX 8bit 디코딩: 초당 110.8 토큰
- 12,497(12K) 토큰 프리필 프롬프트의 첫 토큰 시간(TTFT): 첫 요청 7.66초
- 같은 프롬프트를 다시 보내면 0.17초가 걸린다. (oMLX 프롬프트 캐시)
- Qwen3.8-27B 기반 8bit 모델 디코딩: MTP 를 켜면 초당 15.6 토큰에서 29.1 토큰 정도의 생성 속도가 나온다.
목차
- oMLX 는 LM Studio·Ollama 와 무엇이 다른가
- 핵심 기능
- LM Studio·Ollama·vLLM 과 비교
- 내가 Mac 에서 oMLX 를 메인으로 사용하는 이유
- oMLX 설치 — 다운로드 설치 or Homebrew 설치
- 설치 요구 사항
- 메뉴바 앱(DMG)
- Homebrew
- 설치 확인
- 모델 관리 — MLX, GGUF 지원
- GGUF 를 쓰려면
- 모델 이름의 oQ
- OpenAI·Anthropic 호환 API 로 부르기 — curl·n8n·Claude Code
- API 키
- curl 로 호출
- 다른 서버에서 부르기 — tailscale serve
- n8n 에서 부르기
- Claude Code 연결 — omlx launch
- oMLX의 로컬 LLM 메모리 관리 — 고정·TTL·메모리 가드·SSD KV 캐시
- 메모리 상한값 계산
- 모델별 TTL — 놀고 있는 모델은 바로 메모리에서 내려준다
- 고정(pin)과 LRU
- SSD KV 캐시
- M4 Max 128G 벤치마킹 — 초당 토큰 수·상주 메모리·MTP
- 측정 스크립트
- 결과
- 27B 디코딩을 1.9배 향상시키는 MTP 헤드
- 동시 요청 — 연속 배칭의 장단점
- 정리 — oMLX 가 맞는 경우와 다른 도구가 나은 경우
- 참고 자료
oMLX 는 LM Studio·Ollama 와 무엇이 다른가
oMLX 는 Apple Silicon MacOS 전용 LLM 서버다.(한국인이 시작한 프로젝트!) 추론은 Apple 의 MLX 위에서 mlx-lm·mlx-vlm·mlx-embeddings·mlx-audio 사용이 가능하다. oMLX는 관리UI로 Swift 로 만든 메뉴바 앱과 웹 관리 화면을 제공하며, 라이선스는 Apache-2.0 을 따른다.
핵심 기능
- 여러 모델을 한 서버에서: LLM·VLM·T2S·임베딩·리랭커를 하나의 포트로 서빙할 수 있다.
- 연속 배칭: 동시에 들어오는 요청을 mlx-lm 의
BatchGenerator로 묶어 처리할 수 있다. - 강력한 2단 KV 캐시: 메모리(hot)와 SSD(cold)에 프롬프트 KV 블록을 저장한다. 저장된 SSD 캐시 블록은 서버를 다시 시작해도 재사용이 가능하다.
- 효율적인 메모리 관리: LLM 서빙은 메모리 관리가 핵심이다. 모델별 TTL·고정(pin), LRU(상한을 넘으면 오래 쓰지 않은 모델부터 내림)와 전체 상한을 관리하는 메모리 가드를 통해 메모리 관리가 너무너무 편리하다.
- API: OpenAI 호환 API 와 Anthropic Messages API(
/v1/messages)를 모두 제공한다. (Jev 지원도 좀…) - 관리 화면(앱·웹):
/admin웹과 앱에서 모델 다운로드와 설정·로그·벤치마크를 할 수 있고, 리더 보드도 제공 하고있다.
LM Studio·Ollama·vLLM 과 비교
| 항목 | oMLX | LM Studio | Ollama | vLLM |
|---|---|---|---|---|
| 추론 엔진 | MLX. GGUF 는 외부 엔진 Splash 가 별도 프로세스로 실행 | llama.cpp(GGUF)와 MLX | llama.cpp 중심, 0.19 부터 Apple Silicon 에서 MLX 미리보기 | CUDA 중심. Apple Silicon 은 vllm-metal 플러그인(MLX 백엔드) |
| 모델 메모리 정책 | JIT 모델 로딩을 지원한다. 모델별 TTL·고정, 상한을 넘으면 LRU가 동작한다. 모델 유휴 TTL은 초단위로 설정이 가능하다. | JIT 로드 모델은 유휴 TTL은 최소 1분, Auto-Evict 가 켜져 있으면 JIT 모델을 하나만 유지 | keep_alive(기본 5분)가 지나면 언로드 | 프로세스 하나에 모델 하나 |
| 실행 형태 | 메뉴바 앱 + 서버(헤드리스 실행 가능) | 데스크톱 앱 + lms CLI 서버 모드 | 데몬 + CLI | Python 서버 |
| 오픈소스 여부 | O | X | O | O |
내가 Mac 에서 oMLX 를 메인으로 사용하는 이유
- 하나의 엔드포인트로 임베딩과 생성을 모두 사용할 수 있다. n8n 에서 주소 1개만 설정하면 된다.
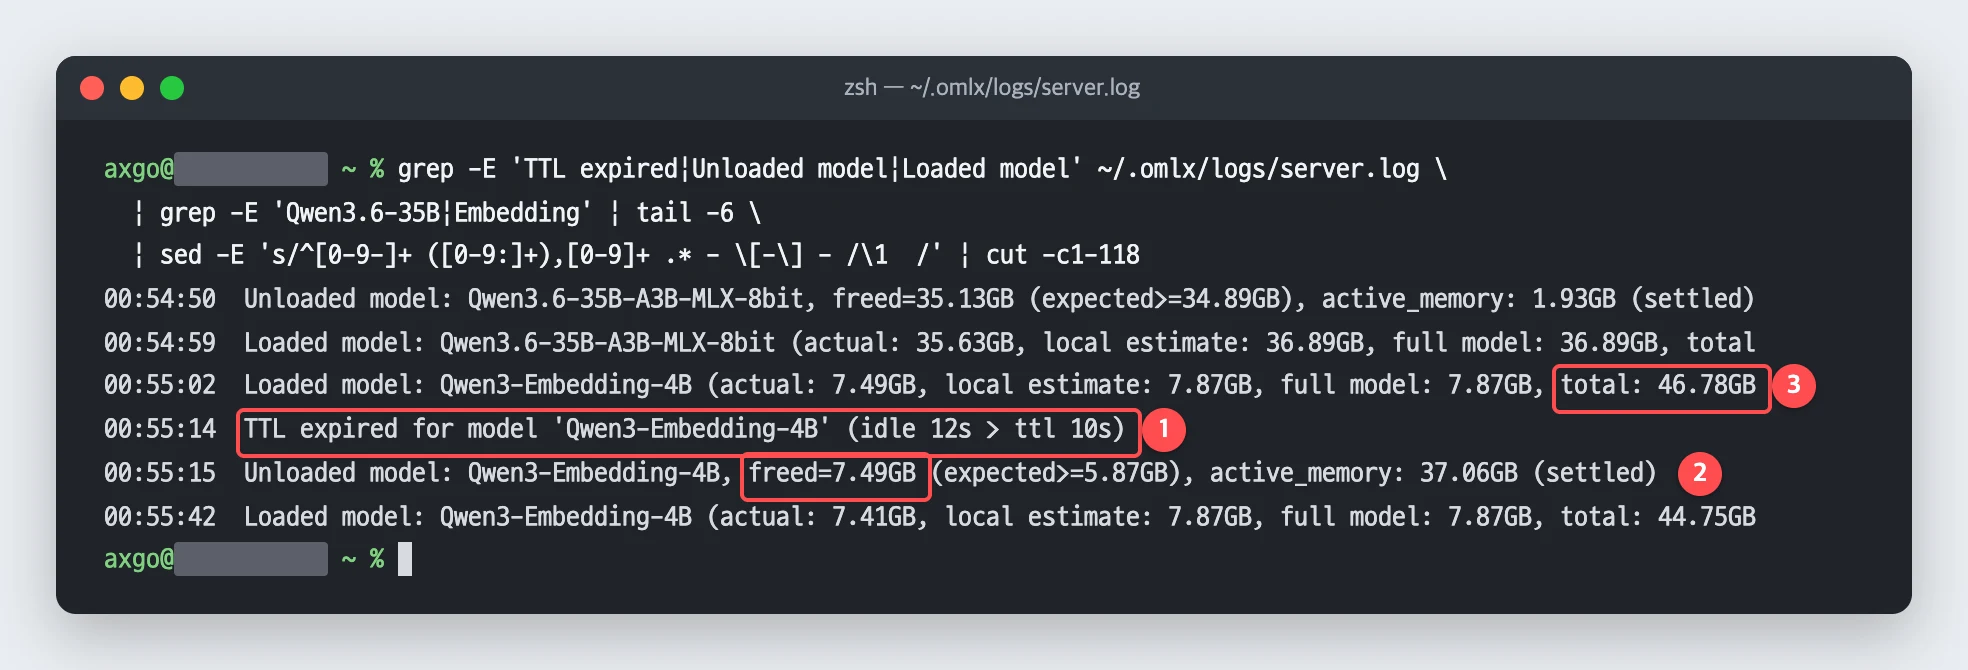
https://m4max-….ts.net:8000/v1하나로 필요한 모델을 호출만 하면 된다. (LLM + 임베딩) - 모델별 TTL 로 메모리를 바로 회수한다. 같은 Mac 에서 Draw Things 로 이미지도 생성하고 있다. 임베딩 모델은 10초, 생성 모델은 30초 동안 추가 요청이 없으면 바로 메모리가 회수 되도록 했다. (LMStudio는 1분 단위)
- 같은 프리픽스를 반복하는 요청에서 SSD 캐시가 효과를 낸다. 누적 프롬프트 토큰 17.7억 개 중 12.8억 개(72.3%)를 캐시에서 읽었다. 코딩 에이전트용으로 쓰는 35B 모델은 90% 정도다.
- LM Studio 가 받아 둔 모델 디렉터리를 그대로 읽을 수 있다. LMStudio 로 다운받은 모델을 다시 다운로드하지 않아도 된다.
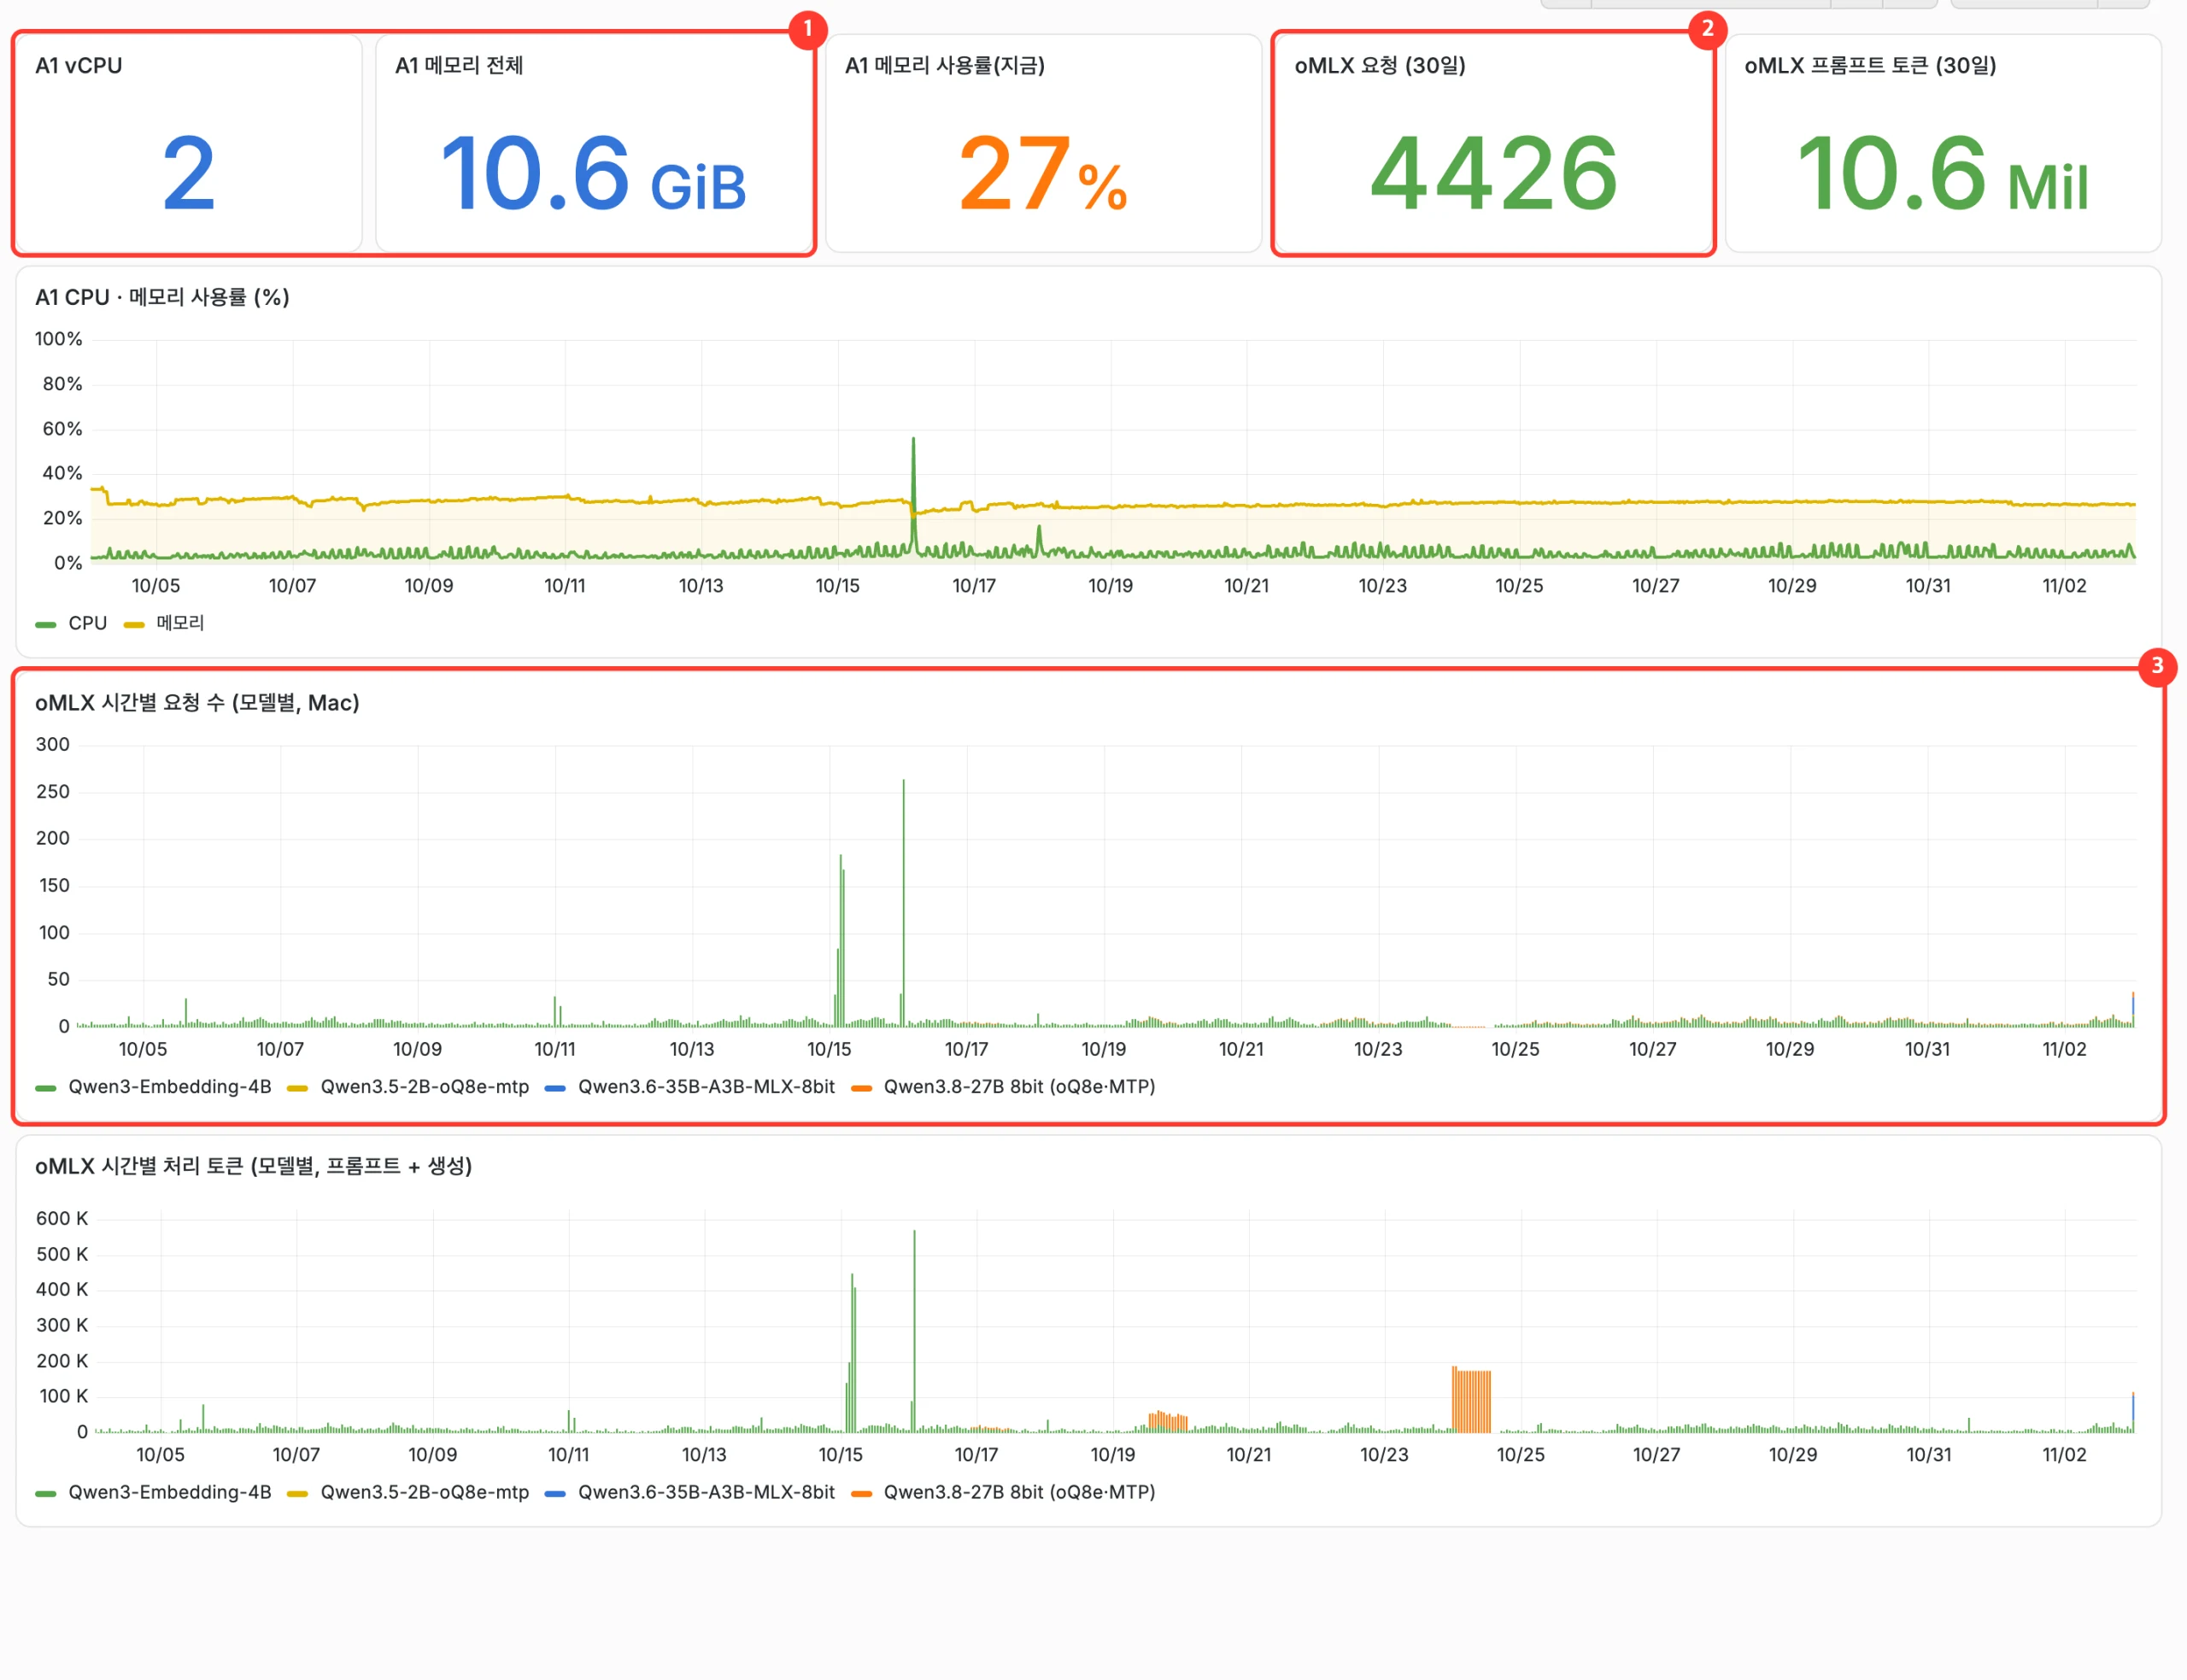
usage.sqlite3 시간별 집계를 VictoriaMetrics 로 가져와 A1 지표와 함께 그렸다.① A1 은 vCPU 2개·메모리 10.6 GiB
② 30일 동안 oMLX 요청 4,426건
③ 시간별 요청 — 녹색(임베딩)이 대부분이다.
oMLX 설치 — 다운로드 설치 or Homebrew 설치
설치 요구 사항
- macOS 15 이상, Apple Silicon(M1~M5).
- 2026.11.03 현재 최신 버전은 0.7.3(빌드 3574)이다.
메뉴바 앱(DMG)
- GitHub Releases 에서 DMG 를 받아
/Applications로 복사하고 실행한다. - 앱은 CLI 실행 파일
~/.omlx/bin/omlx를 만들고~/.zshrc에 PATH 블록을 추가한다. - 서버 시작·중지는 메뉴바 아이콘에서 할수 있다. 서버가 비정상 종료되면 앱이 다시 시작한다.
# ~/.zshrc 에 앱이 추가하는 블록
# oMLX: CLI shim path begin
case ":$PATH:" in
  *":$HOME/.omlx/bin:"*) ;;
  *) export PATH="$HOME/.omlx/bin:$PATH" ;;
esac
# oMLX: CLI shim path end
Code language: Bash (bash)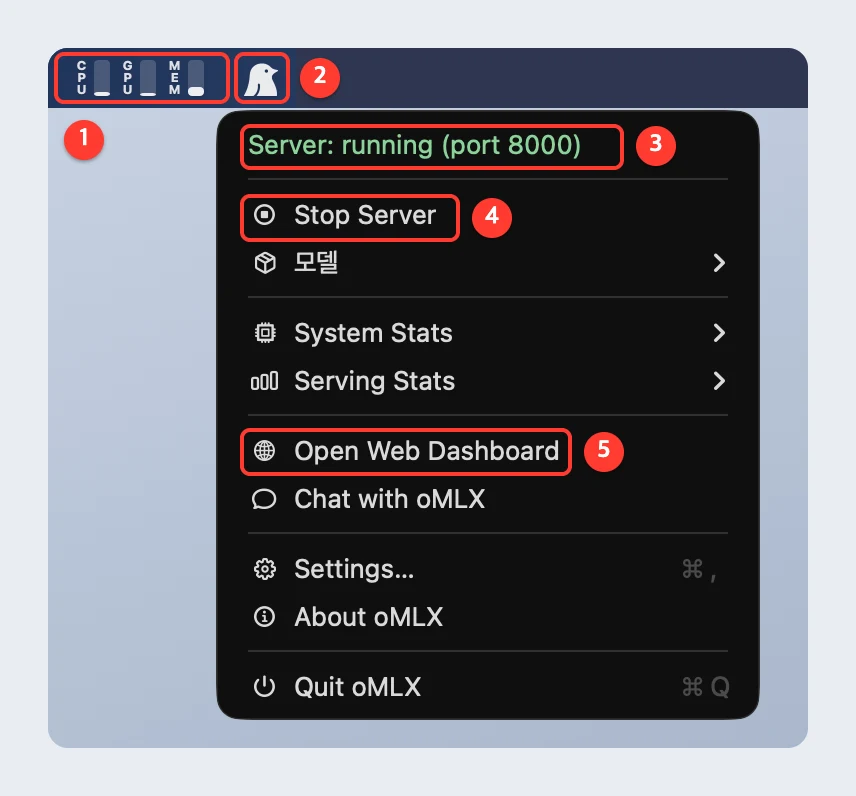
③ 서버 상태와 포트 ④ 서버 중지 ⑤ 웹 관리 대시보드 열기
Homebrew
brew tap jundot/omlx https://github.com/jundot/omlx
brew install jundot/omlx/omlx

# 백그라운드 서비스로 실행 (비정상 종료 시 다시 시작)
brew services start omlx
# 또는 oMLX CLI 로
omlx start      # stop · restart
Code language: Bash (bash)
설치 확인
omlx --version
tail -1 ~/.omlx/bin/omlx
curl -s http://127.0.0.1:8000/health \
  | jq '{status, models: .engine_pool.model_count, loaded: .engine_pool.loaded_count}'
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:8000/v1/models   # 키 없이 → 401
Code language: Bash (bash)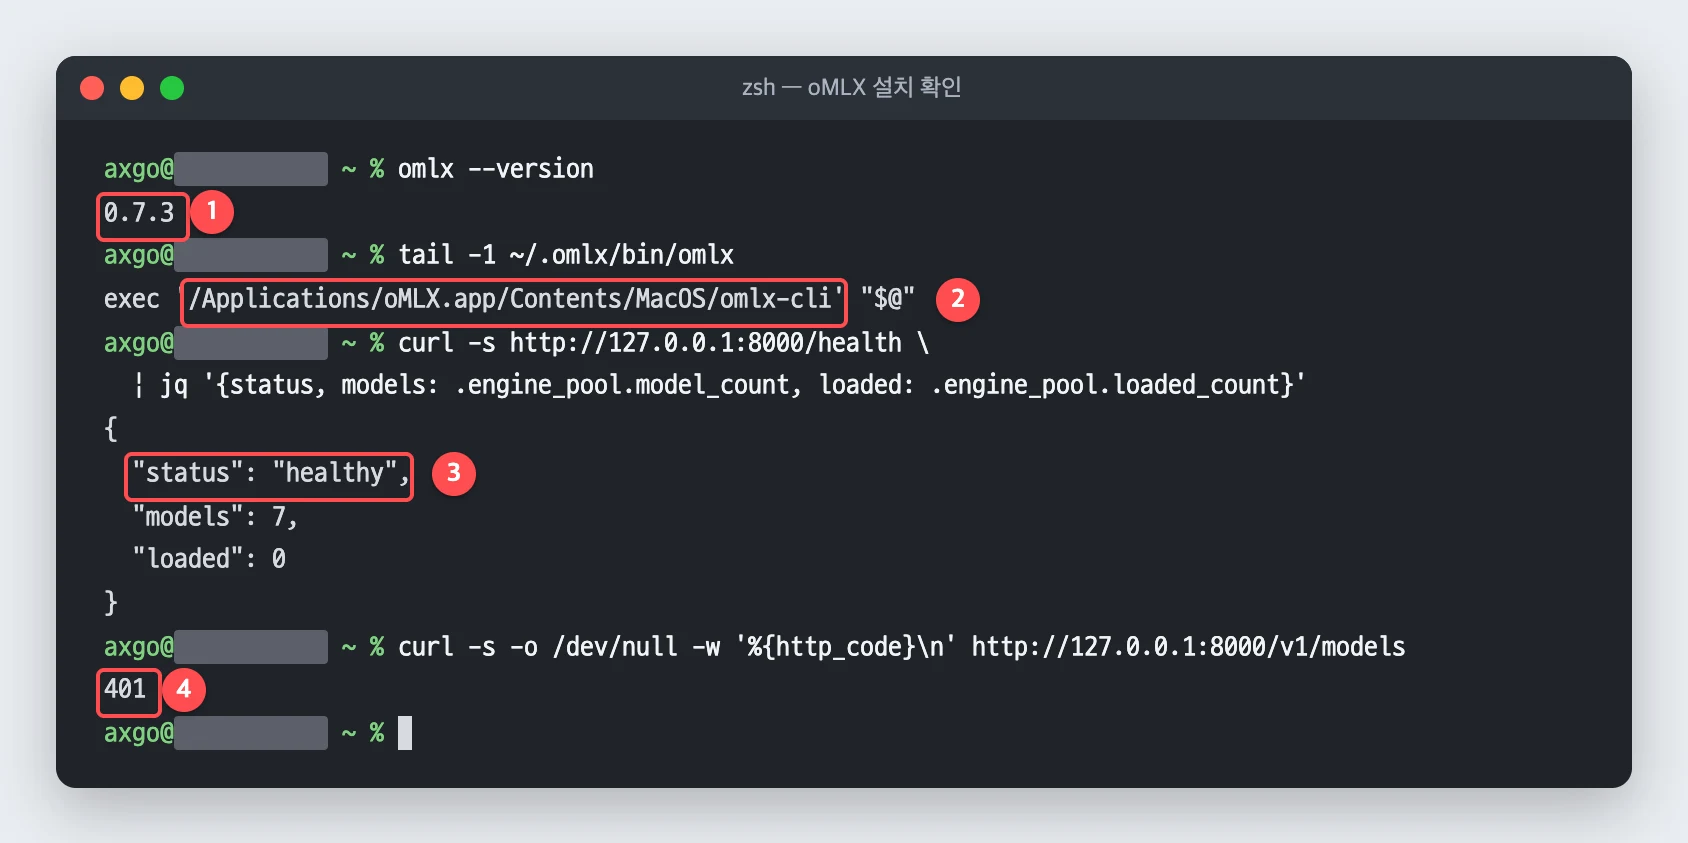
설정과 상태는 모두 ~/.omlx/ 아래 파일에 있다.
| 경로 | 내용 |
|---|---|
settings.json | 서버·모델 디렉터리·메모리 가드·캐시·인증 |
model_settings.json | 모델별 TTL·고정·샘플링·MTP |
logs/server.log | 로드·언로드·TTL 만료·MTP 수락률 |
cache/ | SSD KV 캐시 블록 |
usage.sqlite3 | 모델별 시간 단위 사용량 |
앱 없이 터미널에서 직접 실행할 때는 omlx serve 를 사용한다.
omlx serve --model-dir ~/models --host 127.0.0.1 --port 8000 \
  --memory-guard balanced \
  --paged-ssd-cache-dir ~/.omlx/cache --paged-ssd-cache-max-size 100GB \
  --max-concurrent-requests 4
# 127.0.0.1 이 아닌 주소에 열 때는 --api-key 가 필요하다
Code language: Bash (bash)
모델 관리 — MLX, GGUF 지원
- oMLX 는 모델 디렉터리 아래 하위 디렉터리 하나를 모델 하나로 인식한다.
- 하위 디렉터리에
config.json과*.safetensors가 있어야 한다. - 기본 위치는
~/.omlx/models다. 나의 경우 LM Studio 모델 폴더를 지정했다.
"model": {
  "model_dirs": ["/Users/axgo/.lmstudio/models"]
}
Code language: JSON / JSON with Comments (json)
모델은 아래 방법 가운데 하나로 받는다.
- 관리 화면 > 모델 > 다운로드에 HuggingFace 모델 리포지토리 ID 를 넣는다.
- 나의 경우는 아래와 같이 LMStudio로 다운로드후 oMLX로 모델을 서빙하고 있다.
- 모델 다운로드 = LM Studio
- 모델 서빙 = oMLX
# hf로 직접 다운로드를 진행할 경우
hf download unsloth/Qwen3.6-35B-A3B-MLX-8bit \
  --local-dir ~/.lmstudio/models/unsloth/Qwen3.6-35B-A3B-MLX-8bit
Code language: Bash (bash)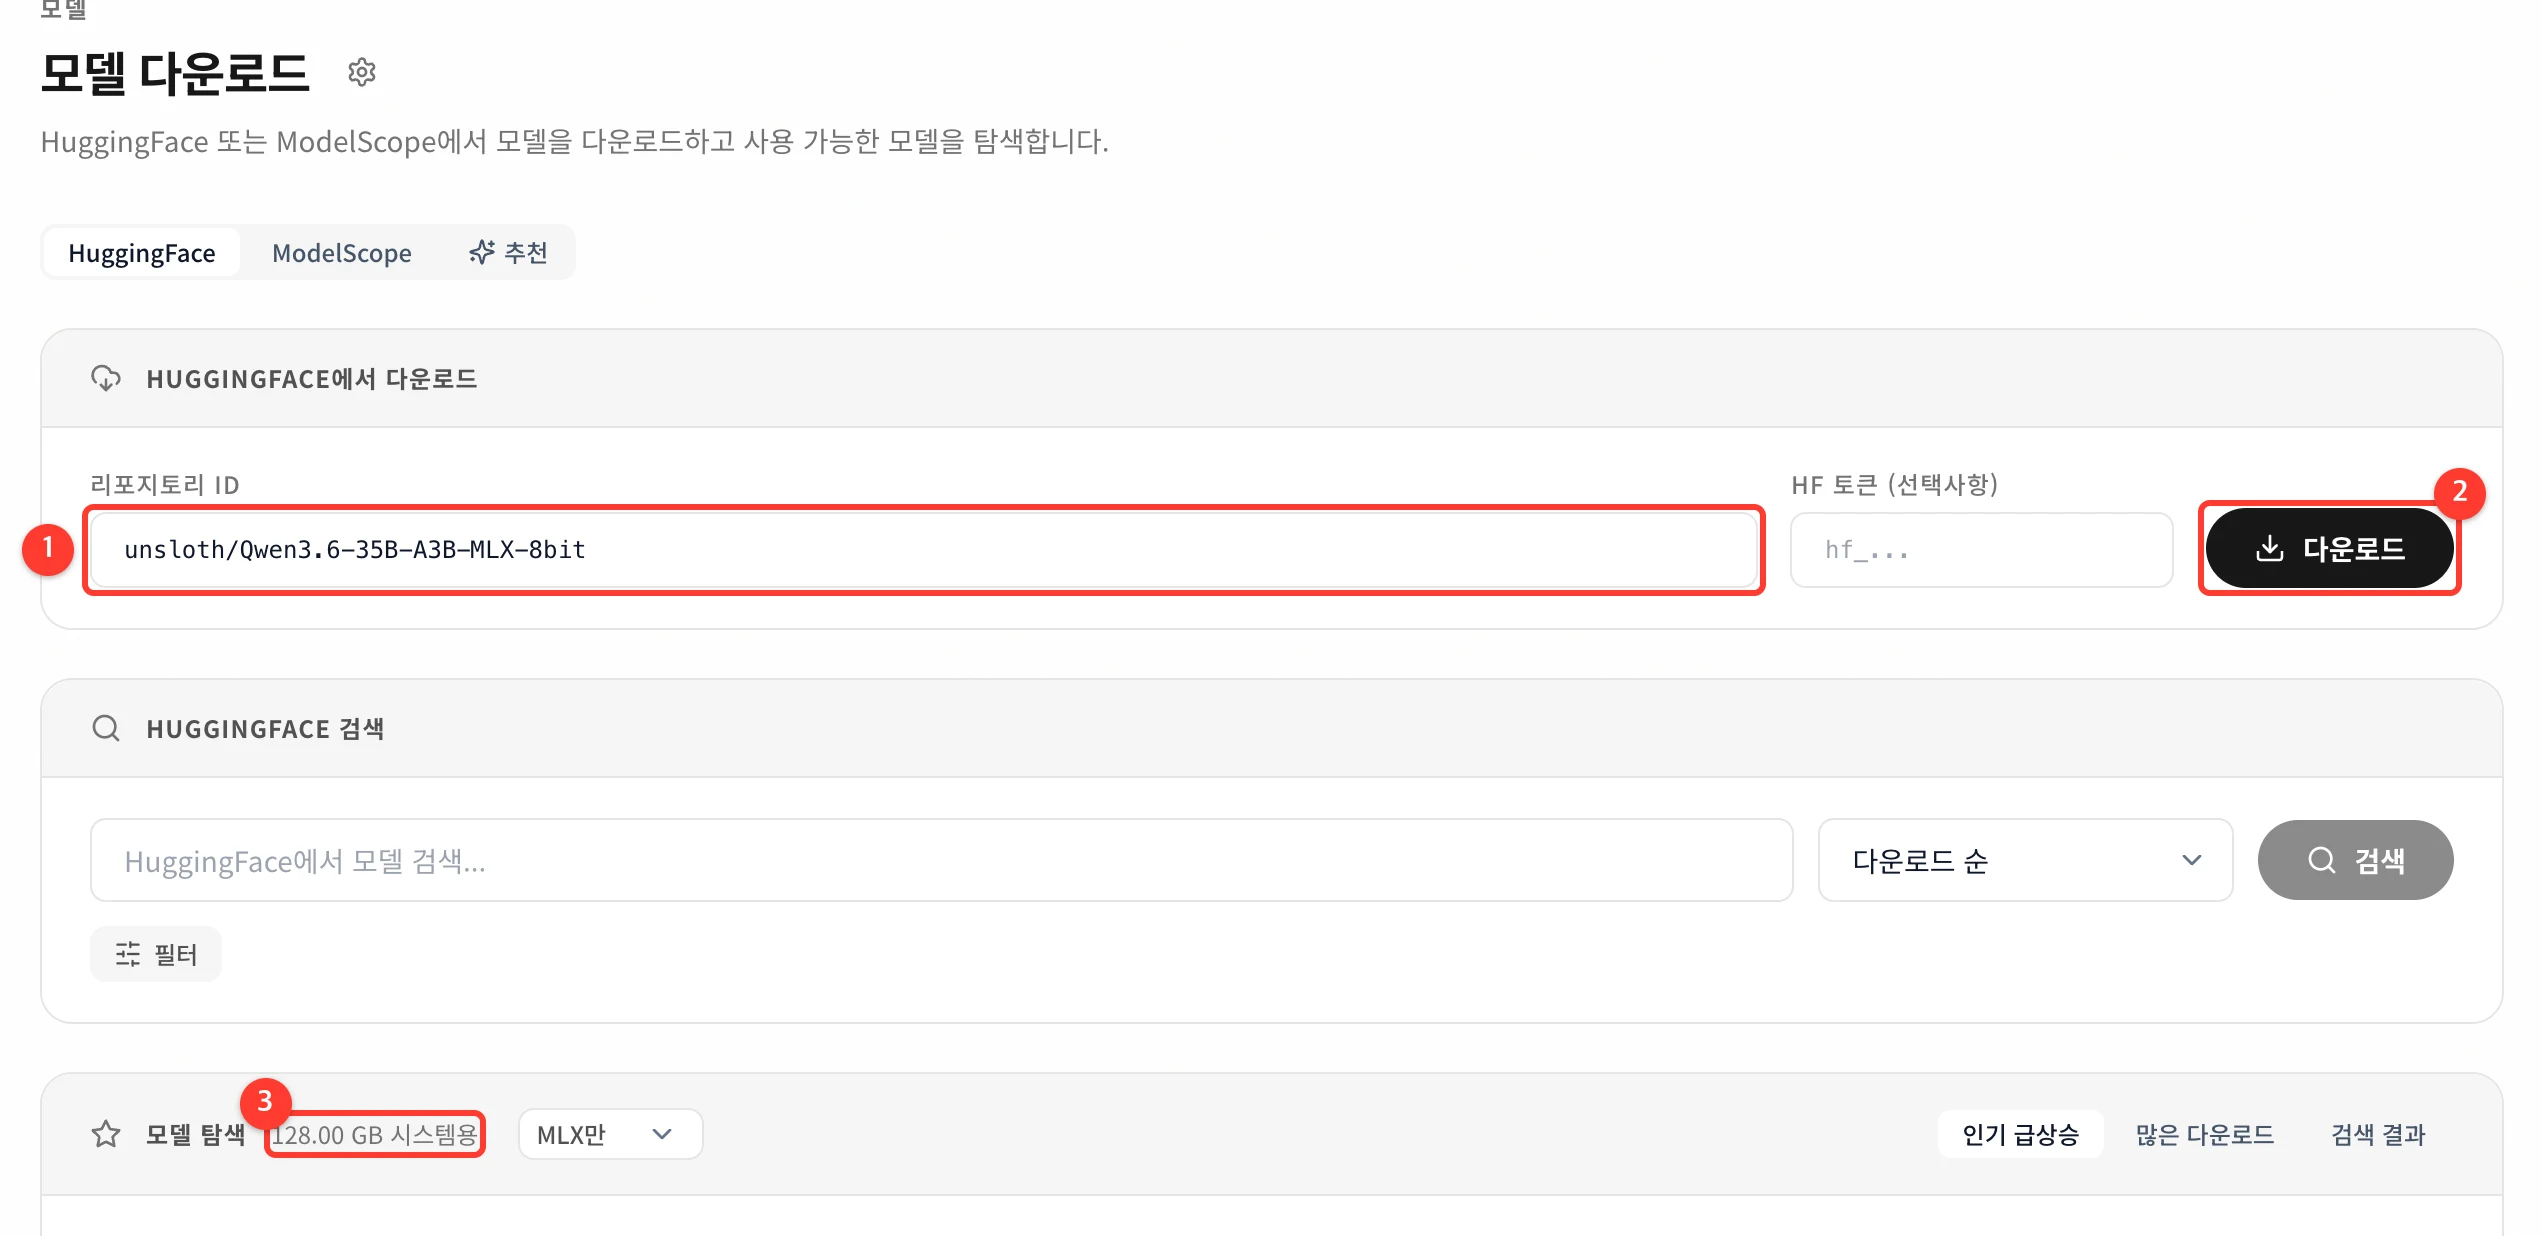
③ 사용중인 Mac의 메모리(128 GB)에 맞는 모델만 추천 받을 수 있다.
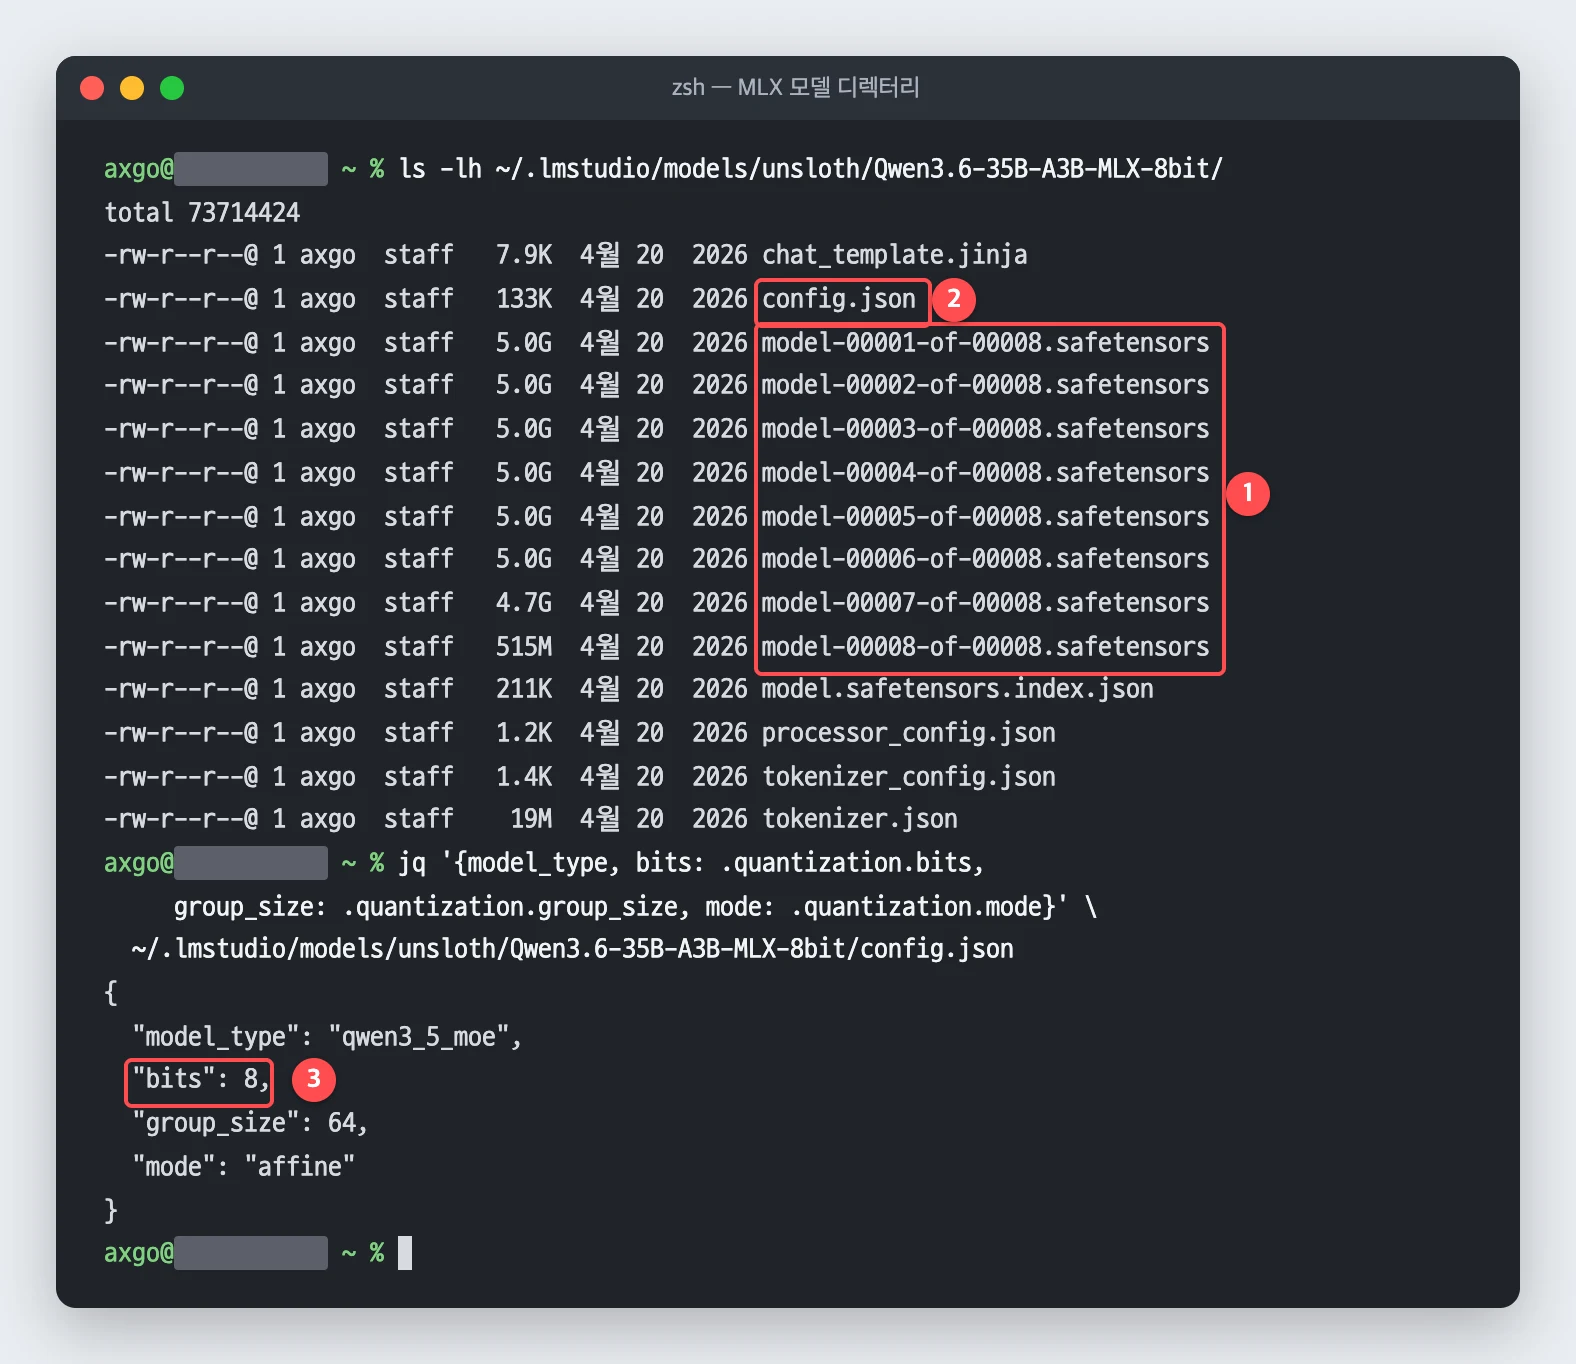
③ 8bit 양자화(group 64, affine)
GGUF 를 쓰려면
- oMLX 의 추론 엔진은 MLX 다. GGUF 타입은 Splash 라는 외부 엔진이 별도 프로세스로 실행한다.
- 여기서 다루는 연속 배칭·SSD KV 캐시는 MLX 엔진의 동작이다. Splash 는 설치하지 않았다.
- 가진 모델이 GGUF 뿐이면 MLX 로 변환해서 쓰는 편이 낫다. 변환 방법은 GGUF 대신 MLX로: Hugging Face 모델을 MLX 8bit로 직접 변환하기에 정리했다.
모델 이름의 oQ
oQ8e·oQ4e처럼 이름에 붙은 oQ 는 oMLX 의 자체 양자화 형식이다. (요즘 로컬모델쪽 양자화는 군웅할거의 시대다)- 레이어 위치에 따라 비트 수를 다르게 주는 혼합 정밀도 방식이다. GGUF K-quant 의 레이어 배치 전략과 일부 레이어를 양자화하지 않는 방식을 함께 쓴다.
- oQ2 부터 oQ8 까지 있다. 변환은
관리 화면 > 모델 > oQ Quantization에서 한다.
OpenAI·Anthropic 호환 API 로 부르기 — curl·n8n·Claude Code
| 경로 | 형식 | 용도 |
|---|---|---|
/v1/chat/completions | OpenAI | 채팅 |
/v1/completions | OpenAI | 텍스트 완성 |
/v1/messages | Anthropic | Claude Code 같은 Anthropic 클라이언트 |
/v1/embeddings | OpenAI | 임베딩 |
/v1/rerank | – | 리랭커 |
/v1/models, /v1/models/status | OpenAI, oMLX | 모델 목록, 로드 상태·메모리 상한 |
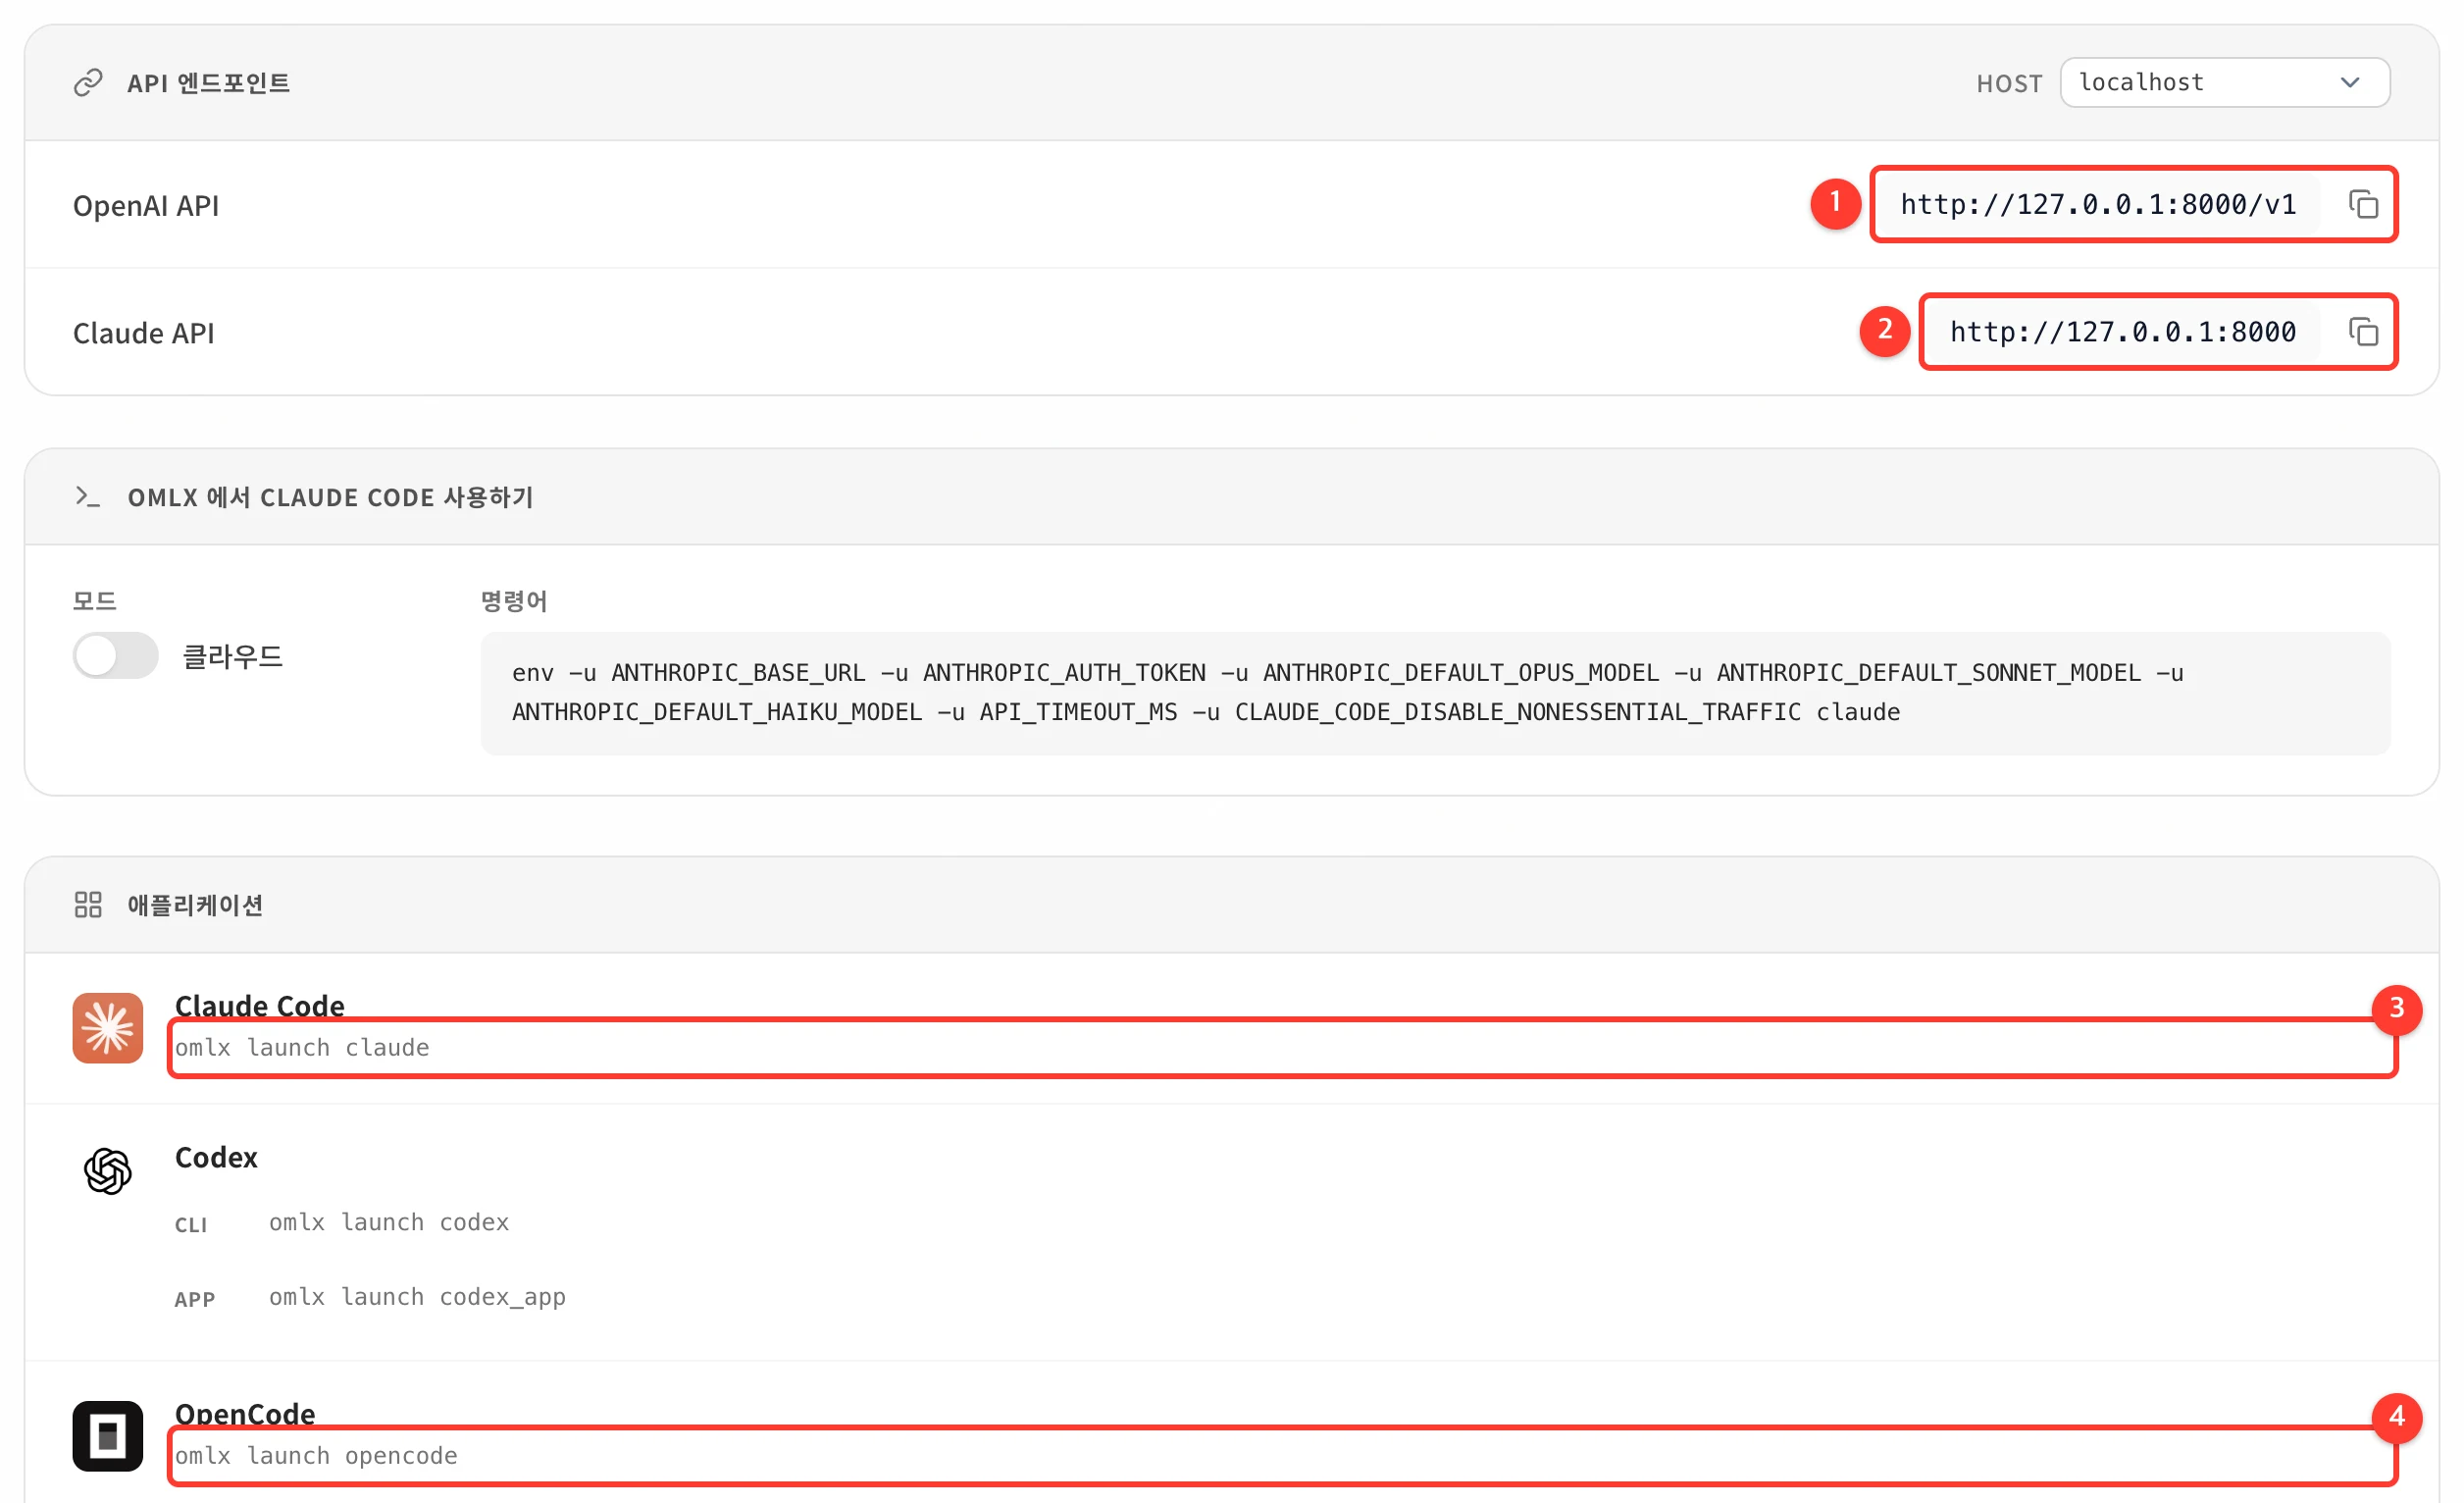
API 키
- 127.0.0.1 이 아닌 주소에 서버를 열면 API 키가 필수다(
--api-key또는OMLX_API_KEY). - OpenAI 형식은
Authorization: Bearer <키>, Anthropic 형식은x-api-key: <키>헤더로 보낸다. - 관리 화면은 4자 이상이면 키로 받아 주므로 길게 만든다.
openssl rand -hex 32   # 이 값을 관리 화면 > 설정 > 인증 및 정보 > API 키에 넣는다
export OMLX_API_KEY='<위에서 만든 키>'
Code language: Bash (bash)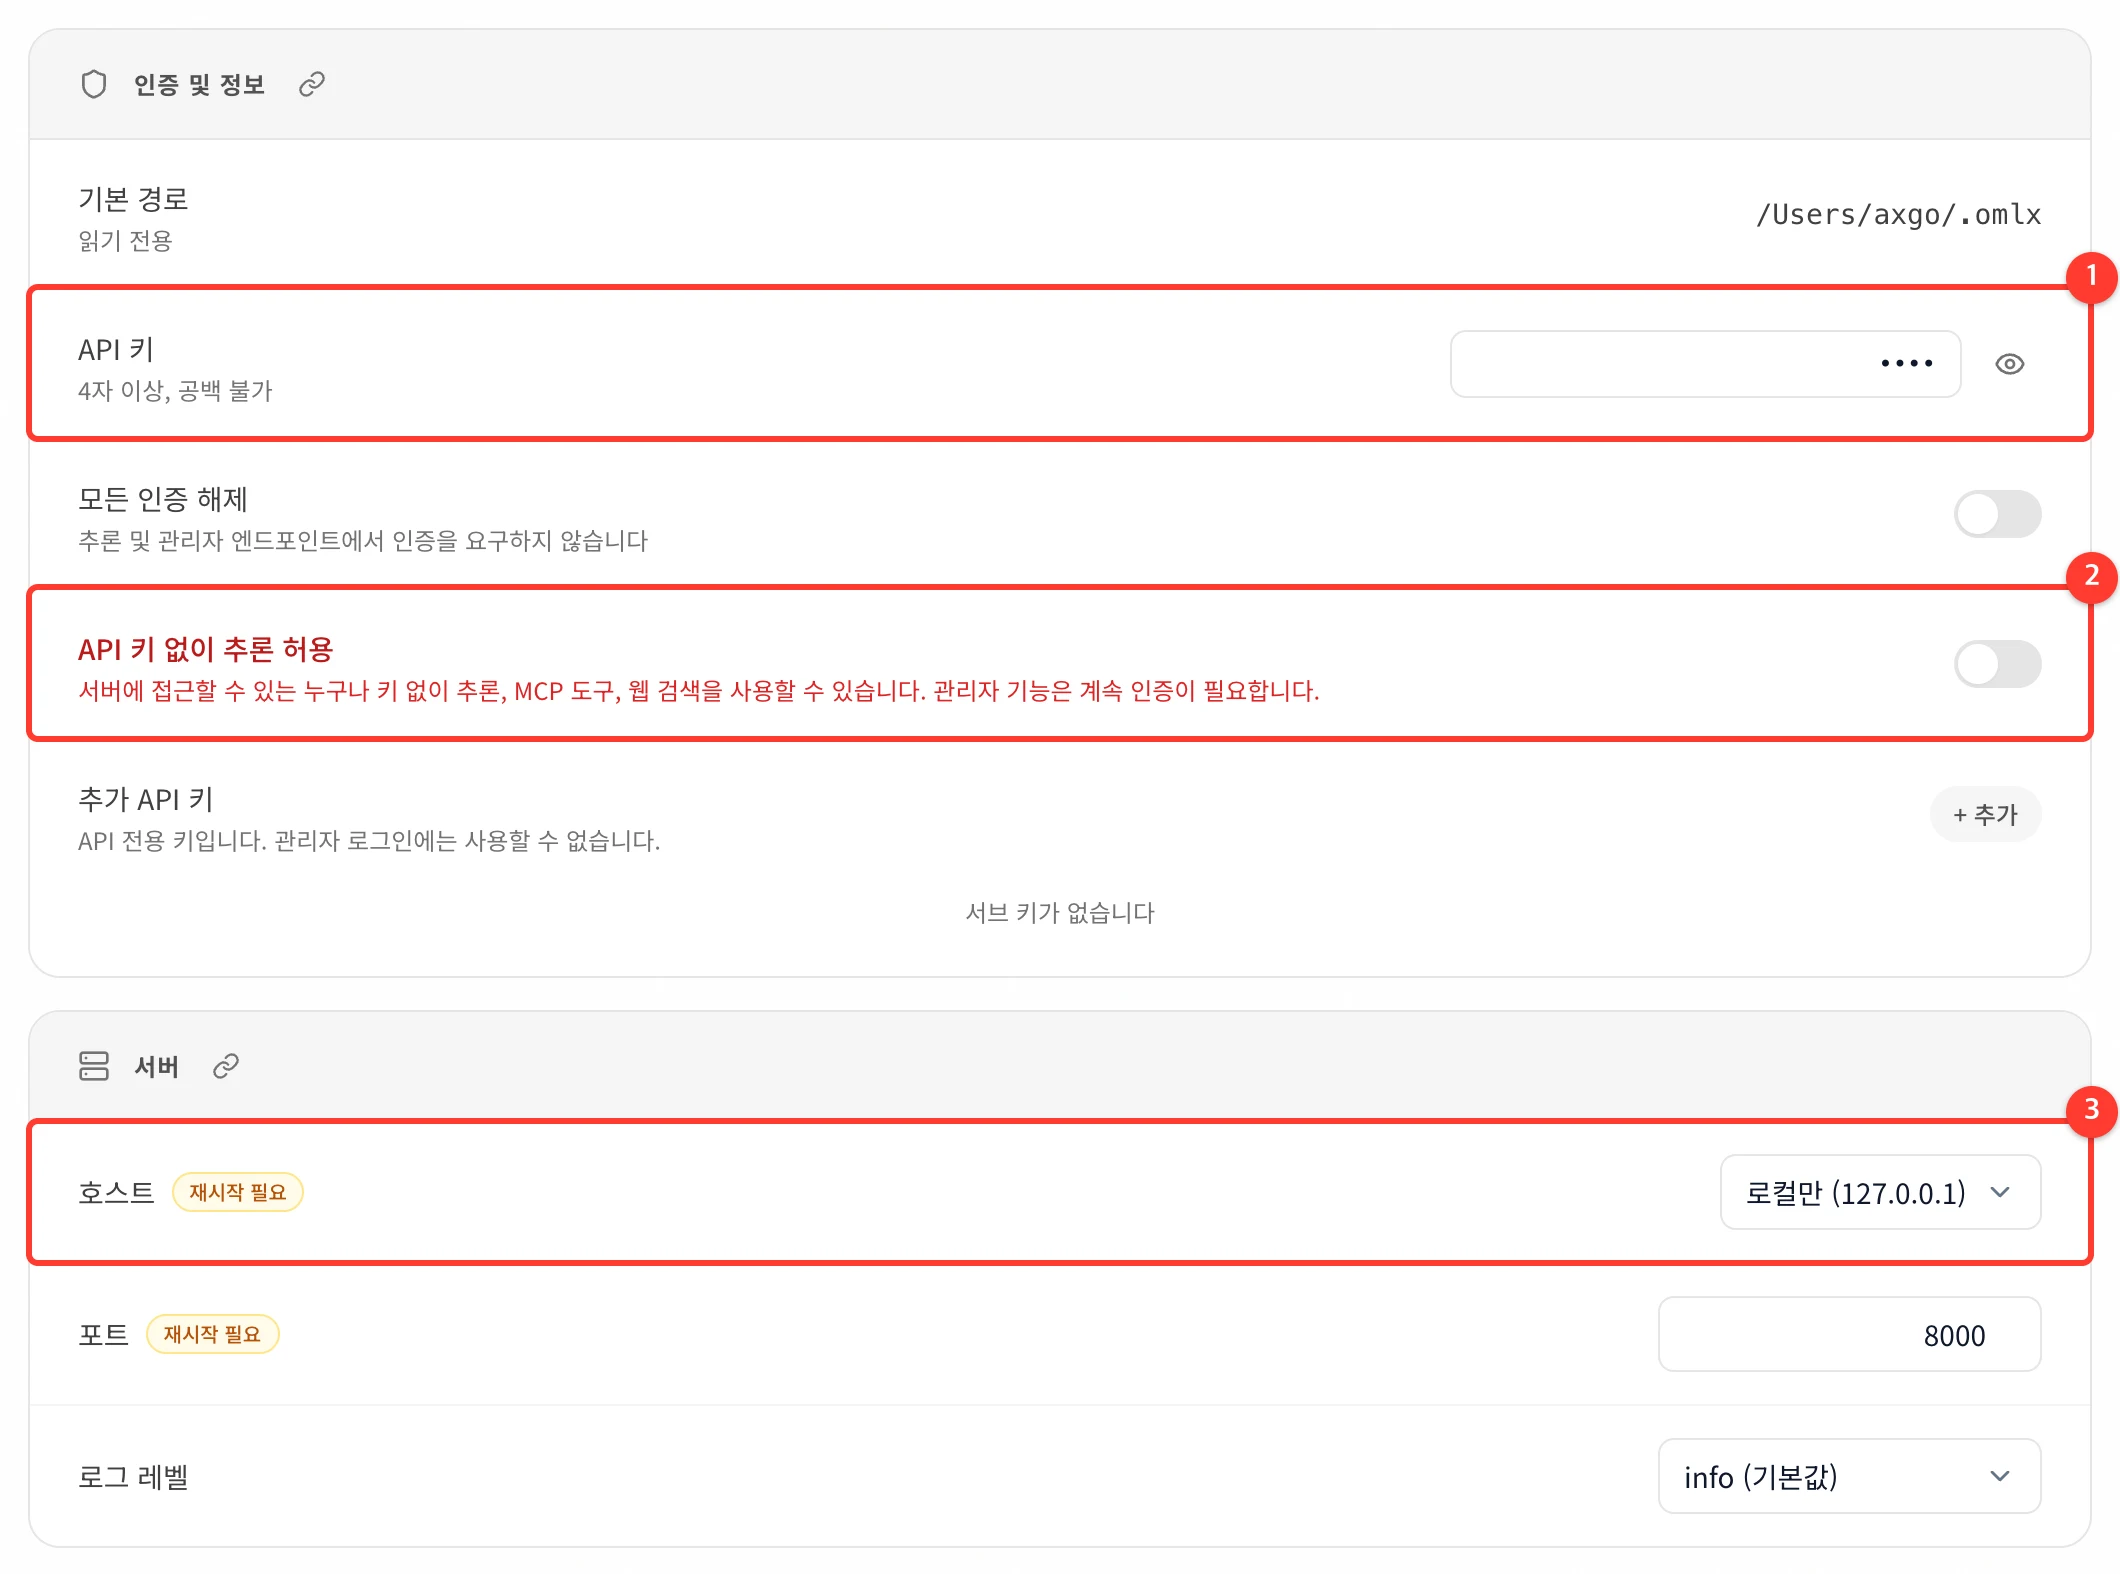
curl 로 호출
# OpenAI 채팅 — 이 서버의 Qwen3.6 모델은 thinking 이 켜져 있어 요청에서 끈다
curl -s http://127.0.0.1:8000/v1/chat/completions \
  -H "Authorization: Bearer $OMLX_API_KEY" -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.6-35B-A3B-MLX-8bit","max_tokens":200,
       "chat_template_kwargs":{"enable_thinking":false},
       "messages":[{"role":"user","content":"MLX가 뭔지 한 문장으로"}]}'

# Anthropic Messages — 응답 content 에 thinking 블록이 먼저 온다
curl -s http://127.0.0.1:8000/v1/messages \
  -H "x-api-key: $OMLX_API_KEY" -H 'anthropic-version: 2023-06-01' \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.6-35B-A3B-MLX-8bit","max_tokens":1024,
       "messages":[{"role":"user","content":"MLX를 한 문장으로"}]}'

# 임베딩
curl -s http://127.0.0.1:8000/v1/embeddings \
  -H "Authorization: Bearer $OMLX_API_KEY" -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3-Embedding-4B","input":["기준금리 동결","국채 금리 상승"]}'
Code language: Bash (bash)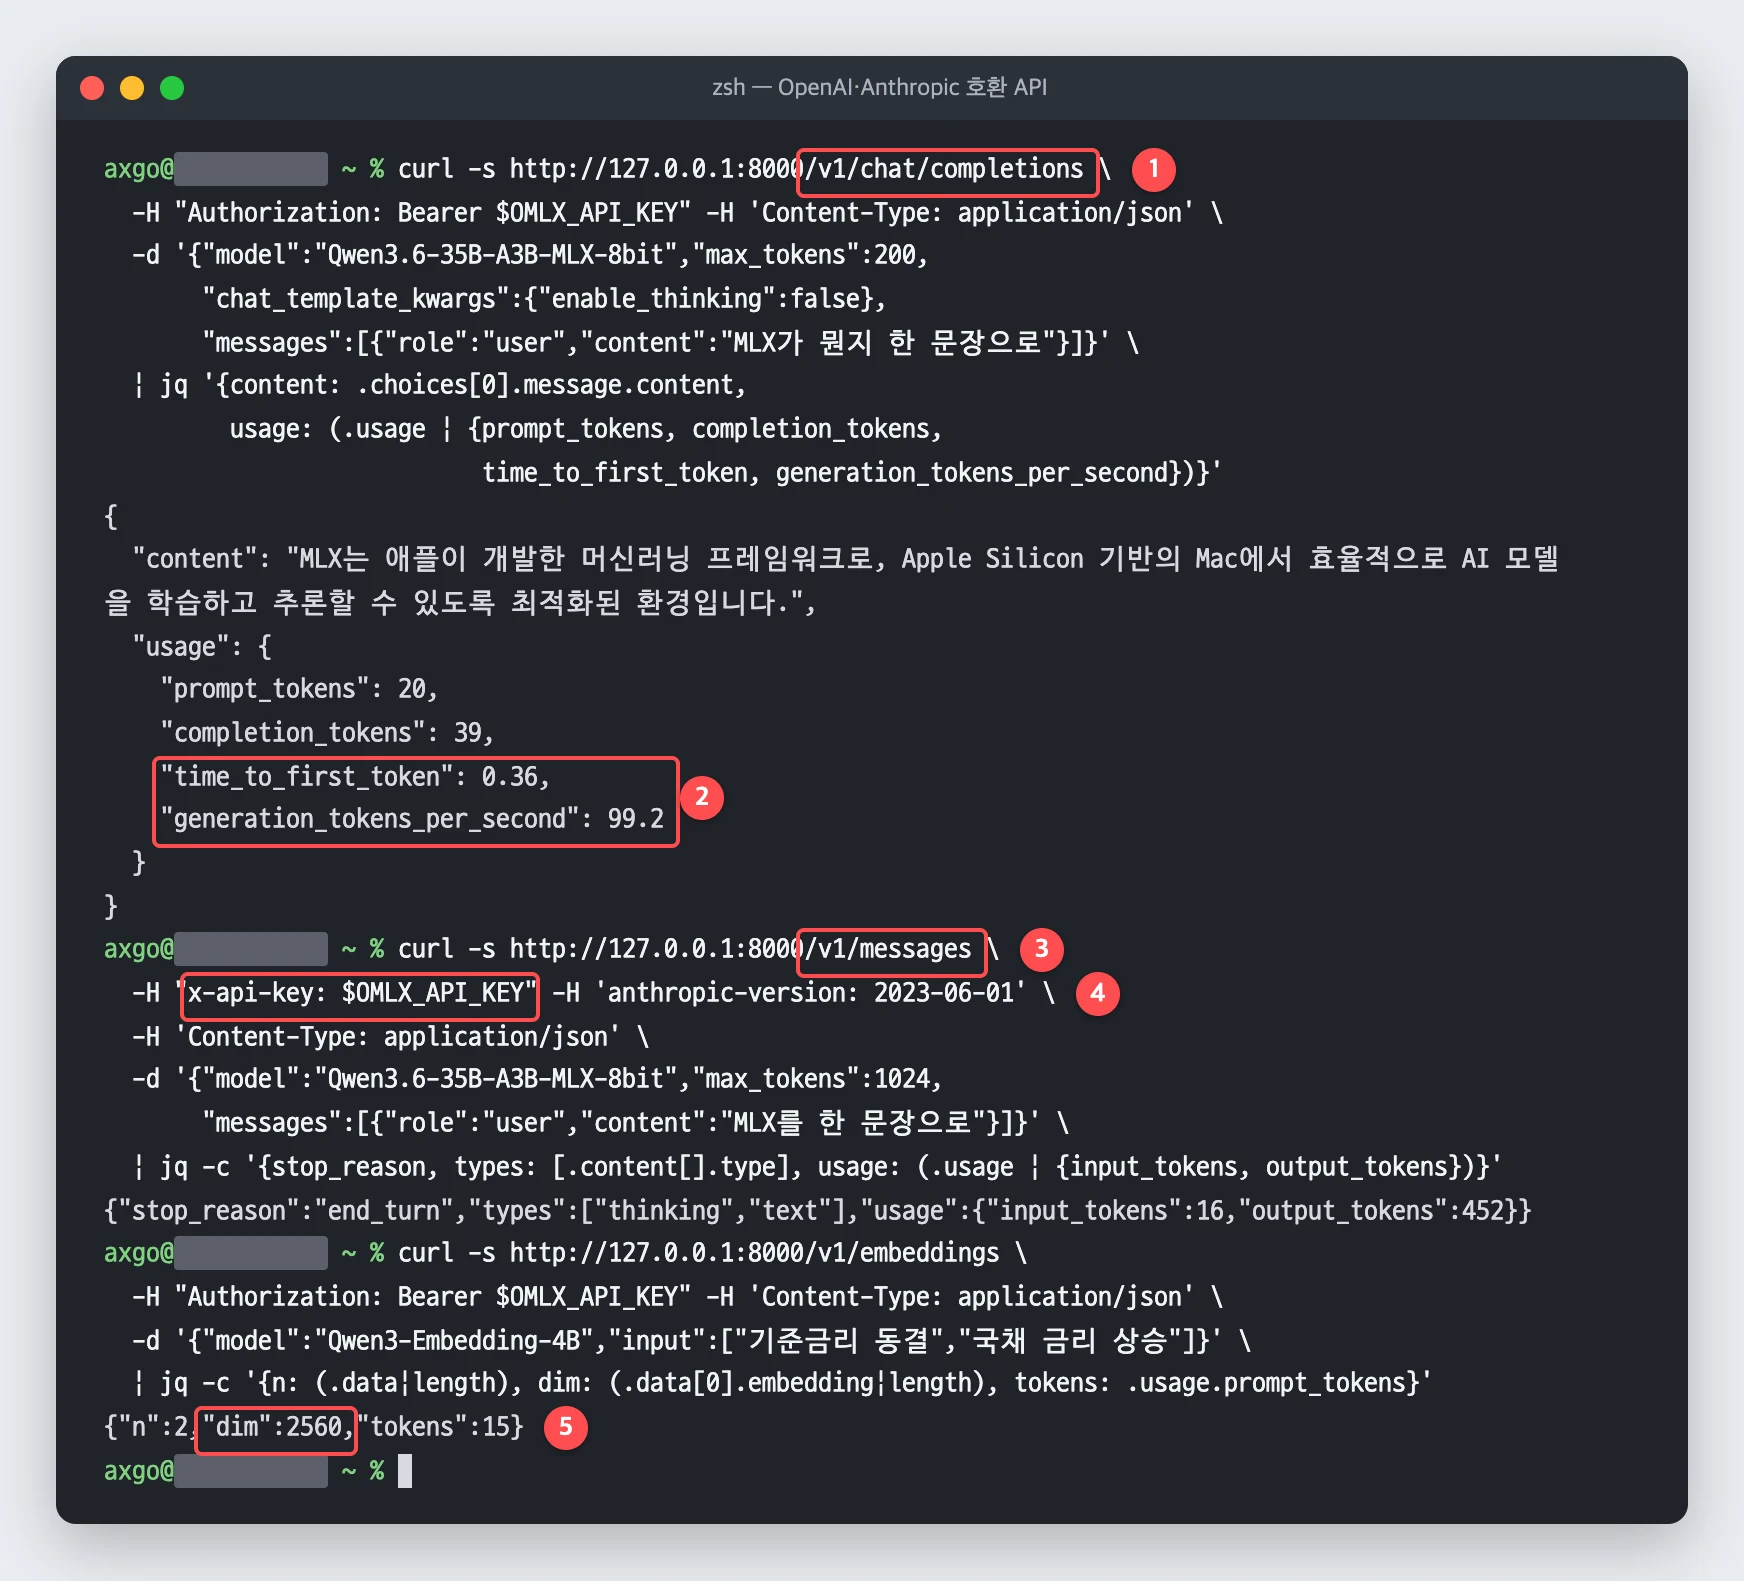
- oMLX 는 usage 에
time_to_first_token·generation_tokens_per_second같은 필드를 더 넣는다. 속도를 잴 때 클라이언트에서 시간을 따로 잴 필요가 줄어든다.
다른 서버에서 부르기 — tailscale serve
- oMLX 는 127.0.0.1 에만 열어 두고 TLS 는 Tailscale 에서 처리한다.
- 인증서가 tailnet 이름으로 발급되므로 IP 가 아니라
m4max-….ts.net이름으로 호출한다. - 구성 과정은 Tailscale로 클라우드 서버와 로컬 Mac을 프라이빗 네트워크로에 정리했다.
tailscale serve --bg --https=8000 http://127.0.0.1:8000
Code language: Bash (bash)
A1 에서 경로·인증·지연을 한 번에 확인하는 스크립트다. 키는 명령줄 인자가 아니라 표준 입력으로 curl 에 넘긴다.
#!/usr/bin/env bash
# 다른 서버에서 oMLX 까지의 경로·인증·지연을 확인한다
#   OMLX_URL=https://<mac>.<tailnet>.ts.net:8000/v1 OMLX_API_KEY=<키> bash omlx-check.sh
set -euo pipefail
U="${OMLX_URL:?OMLX_URL 이 필요하다}"; K="${OMLX_API_KEY:?OMLX_API_KEY 가 필요하다}"
auth() { printf 'Authorization: Bearer %s\n' "$K"; }   # 키를 명령줄 인자(ps)에 남기지 않는다

echo "== no key"
curl -s -o /dev/null -w '%{http_code} %{time_total}s\n' "$U/models"
echo "== with key"
auth | curl -s -o /dev/null -H @- -w '%{http_code} connect=%{time_connect}s tls=%{time_appconnect}s total=%{time_total}s\n' "$U/models"

B='{"model":"Qwen3-Embedding-4B","input":["한국은행이 기준금리를 동결했다.","미국 국채 10년물 금리가 올랐다.",
"코스피가 외국인 매도에 하락했다.","원달러 환율이 1,400원을 넘었다.","반도체 수출이 석 달 연속 늘었다.",
"비트코인 ETF 에 자금이 순유입됐다.","유가가 OPEC 감산 소식에 올랐다.","삼성전자가 자사주 소각을 발표했다."]}'
echo "== embeddings x5 (8 texts)"
for _ in 1 2 3 4 5; do
  auth | curl -s -H @- -H 'Content-Type: application/json' -d "$B" -o /tmp/emb.json -w '%{http_code} total=%{time_total}s ' "$U/embeddings"
  python3 -c "import json;d=json.load(open('/tmp/emb.json'));print(len(d['data']),'x',len(d['data'][0]['embedding']),'tok',d['usage']['prompt_tokens'])"
done
rm -f /tmp/emb.json

H=$(sed -E 's#^https?://([^:/]+).*#\1#' <<<"$U")
if [[ "$H" == *.ts.net ]]; then tailscale ping -c 3 "$H" | tail -1; fi   # 권한에 따라 sudo 가 필요하다
Code language: Bash (bash)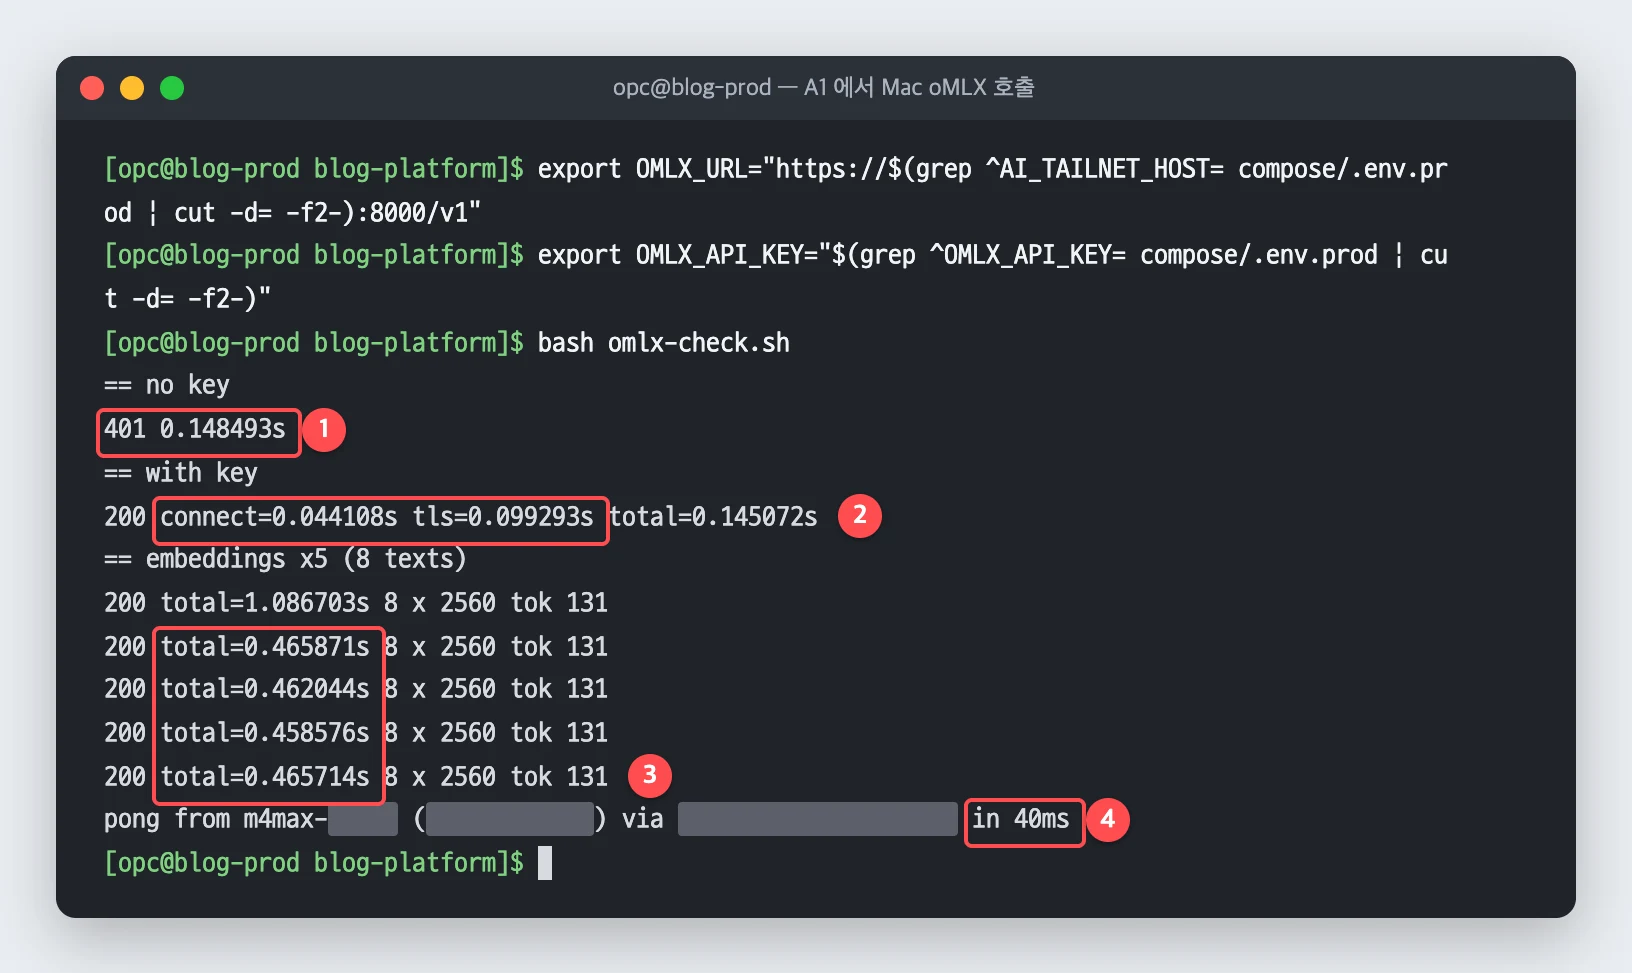
① 키가 없으면 HTTP 401을 리턴한다 ② TCP 연결 44 ms · TLS 완료 99 ms
③ 임베딩 8건 0.46초 ④ tailnet 지연속도는 40 ms 이다.
- 첫 임베딩 호출은 1.09초가 소요되었다. (TTL 로 내려간 임베딩 모델을 로딩하는 시간 추가)
- 같은 호출을 Mac 안에서 보내면 0.14초다. A1 에서는 0.46초다. 차이 0.3초는 새 연결(TCP·TLS 약 0.1초)과 tailnet 왕복, tailscale serve 프록시를 거치면서 발생하는 지연 시간이다.
n8n 에서 부르기
- N8N에서 LLM Provider 마다 HTTP Request 노드를 하나 두고 Header Auth 자격증명에
Authorization: Bearer <키>를 넣는 방식으로 사용할 수 있다. - URL 은
https://m4max-….ts.net:8000/v1/chat/completions, 모델 이름은 표현식으로 넘긴다. - 임베딩을 1536차원으로 잘라 pgvector 에 저장하는 과정은 Qwen3-Embedding-4B + pgvector로 한국어 뉴스 중복 제거에 있다.
Claude Code 연결 — omlx launch
omlx launch claude --model Qwen3.6-35B-A3B-MLX-8bit
# 티어별로 다른 모델을 쓸 때
omlx launch claude --opus Qwen3.6-35B-A3B-MLX-8bit --haiku Qwen3.5-2B-oQ8e-mtp
Code language: Bash (bash)
omlx launch claude는ANTHROPIC_BASE_URL·ANTHROPIC_AUTH_TOKEN·ANTHROPIC_MODEL과 티어별 모델 변수(ANTHROPIC_DEFAULT_OPUS_MODEL등)를 넣고claude를 실행한다.- oMLX 는 모델의 실제 컨텍스트 길이를 Claude Code 에 알려 준다. Claude Code 는 그 값을 보고 대화를 자동 압축한다.
- Codex·OpenCode·Hermes Agent 도
omlx launch <도구>와 같은 방식으로 연결할 수 있다.
oMLX의 로컬 LLM 메모리 관리 — 고정·TTL·메모리 가드·SSD KV 캐시
oMLX가 MacOS의 메모리 전부를 LLM모델이 모두 사용하게 둘 수는 없다. OS, 다른 어플리케이션들도 메모리를 사용할 여유가 반드시 필요한데, oMLX 는 정적 상한·Metal 한도·동적 상한을 계산해 가장 낮은 값을 LLM 모델 메모리의 상한값으로 설정 할 수 있다.
메모리 상한값 계산
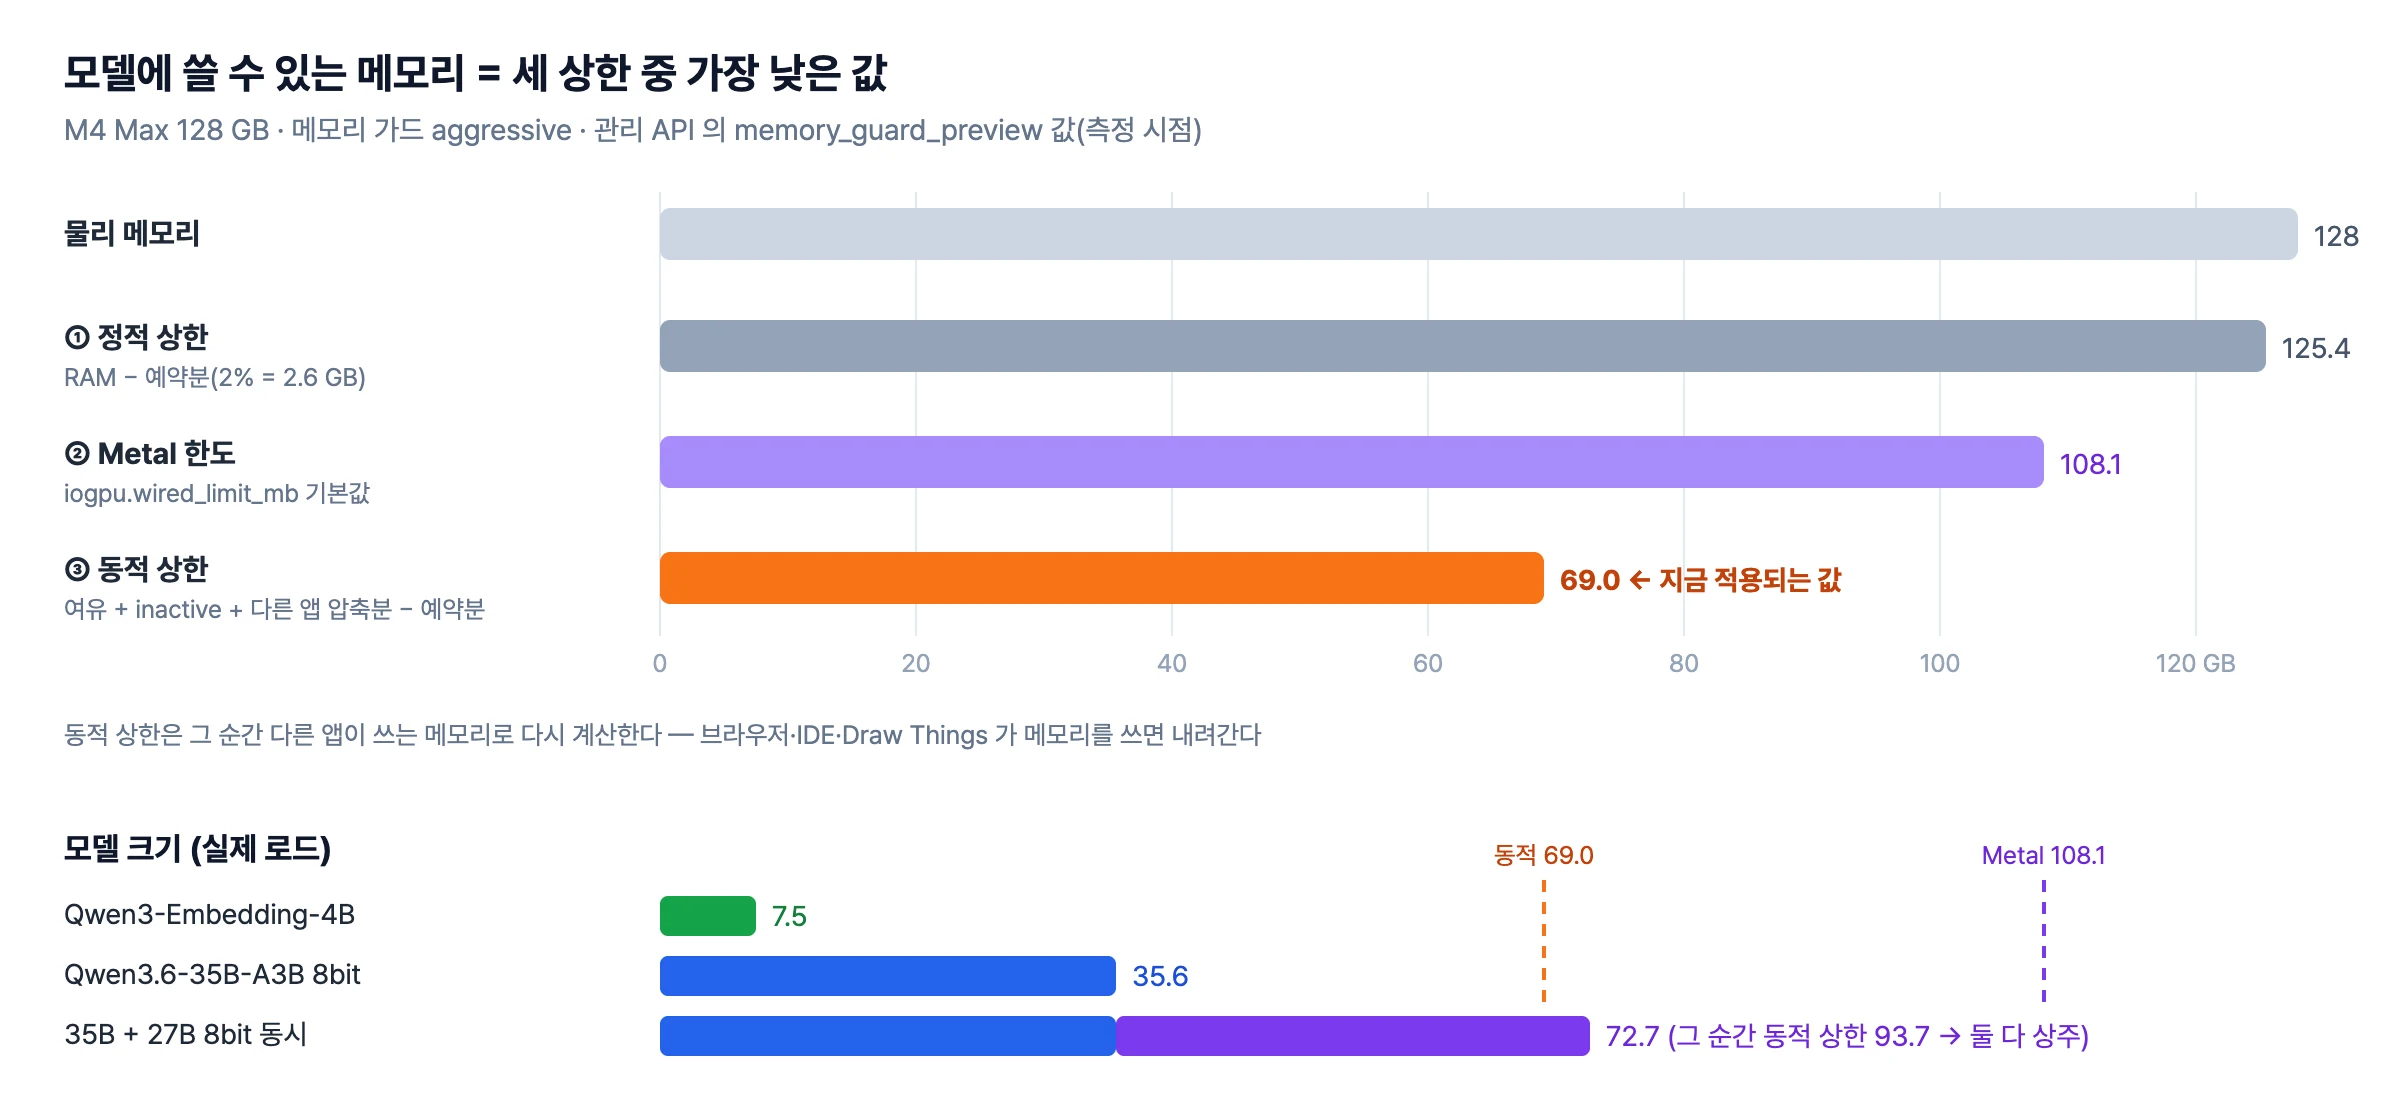
- 정적 상한: 물리 메모리에서 등급별 예약분을 뺀 값이다.
- Metal 한도: 커널의
iogpu.wired_limit_mb다. macOS 기본값이면 이 Mac 에서 약 108 GB 다. - 동적 상한: 여유 메모리 + inactive + 다른 앱 메모리 중 압축할 수 있는 몫 − 예약분이다. 그 순간 다른 앱이 사용중인 메모리 크기에 따라 바뀐다.
| 등급 | 남겨 두는 메모리 | 다른 앱 메모리 압축 | 측정 시점 상한 |
|---|---|---|---|
| safe | RAM 의 약 20% (6~16 GB) | 하지 않음 | 42.8 GB |
| balanced (기본값) | 약 8% (3~8 GB) | 1/4 까지 | 57.2 GB |
| aggressive (현재 설정) | 약 2% (1.5~4 GB) | 1/2 까지 | 69.0 GB |
custom (--memory-guard-gb) | 직접 지정 | – | Metal 한도 108.1 GB 까지 |
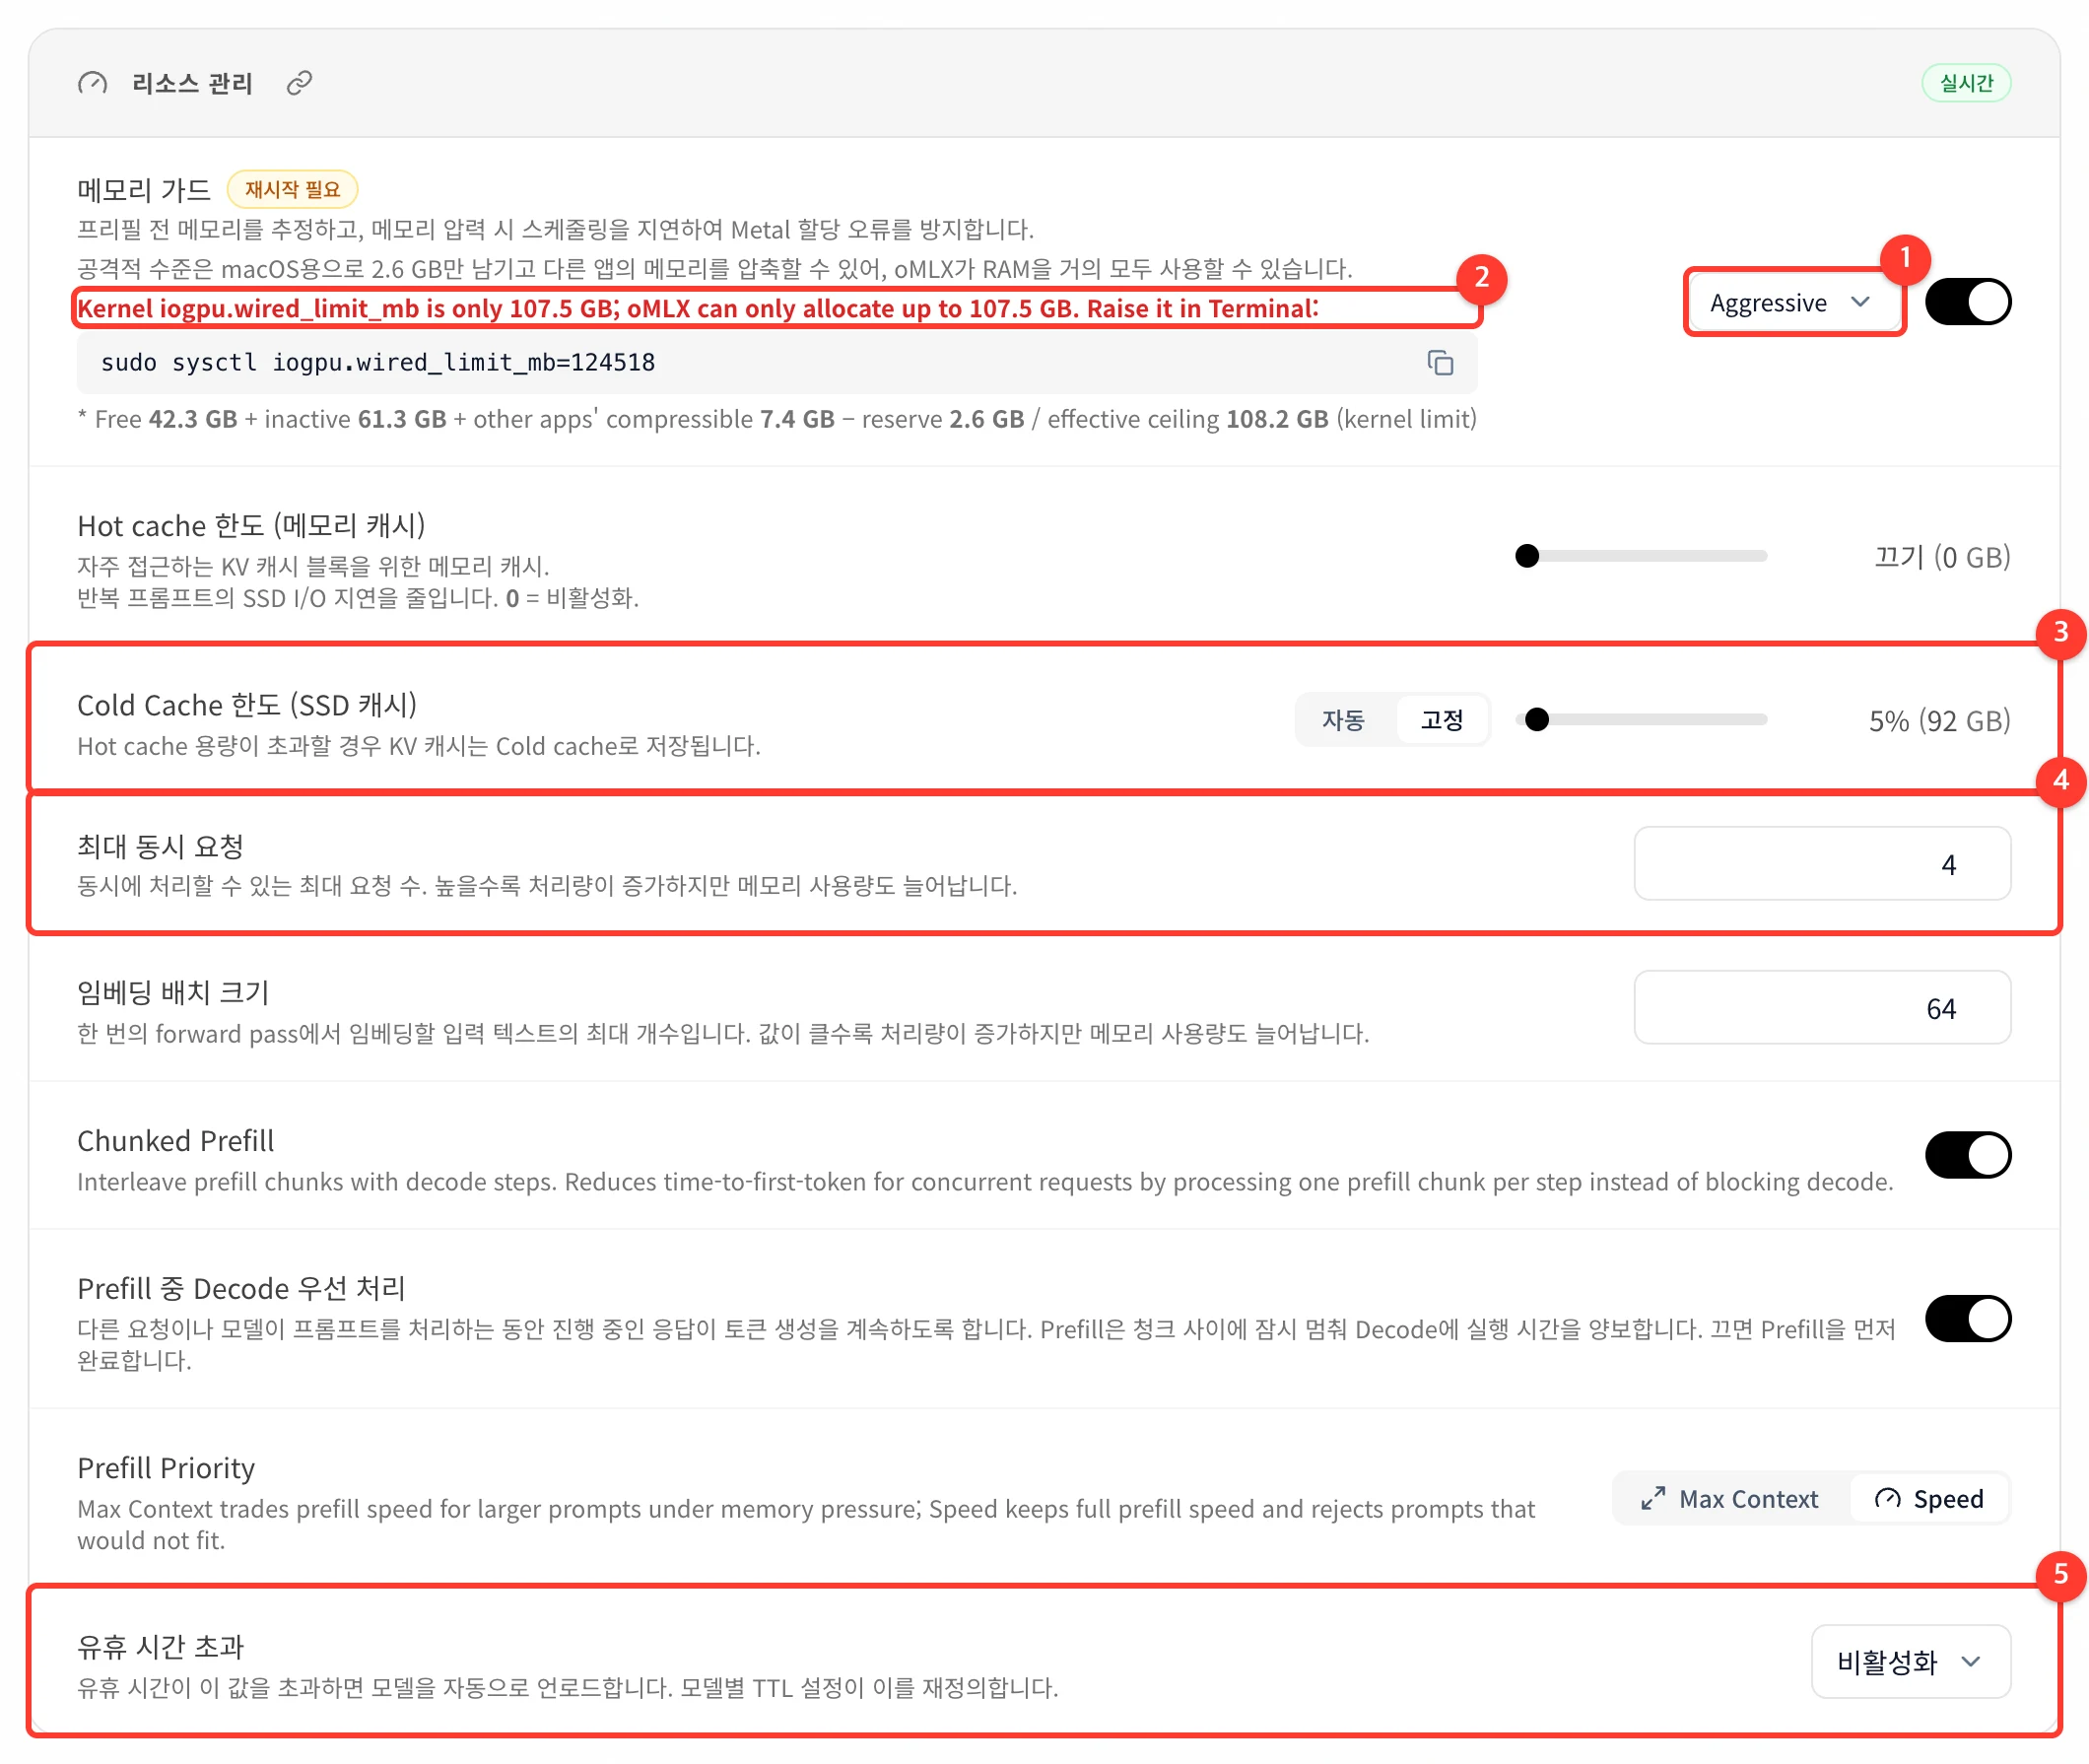
② Metal 한도 경고와 리밋을 상향 시키는데 필요한 명령 안내
③ SSD 캐시 92 GB ④ 최대 동시 요청 4 ⑤ 전체 유휴 시간 초과는 끄고 모델별 TTL 을 쓴다
- Metal 한도를 넘는 모델을 올리려면
iogpu.wired_limit_mb를 올려야 한다.- aggressive 모드에서 128GB 물리메모리에 대해 oMLX 가 제안하는 값은 124,518 MB 다.
sysctl로 바꾼 값은 재부팅하면 기본값으로 돌아간다.
- 한도는 올리지 않았다. 지금 쓰는 모델은 하나씩 올려도, 두세 개를 같이 올려도 108.1 GB 안에 들어간다.
sysctl iogpu.wired_limit_mb          # 0 이면 macOS 기본값
sudo sysctl iogpu.wired_limit_mb=124518
Code language: Bash (bash)
모델별 TTL — 놀고 있는 모델은 바로 메모리에서 내려준다
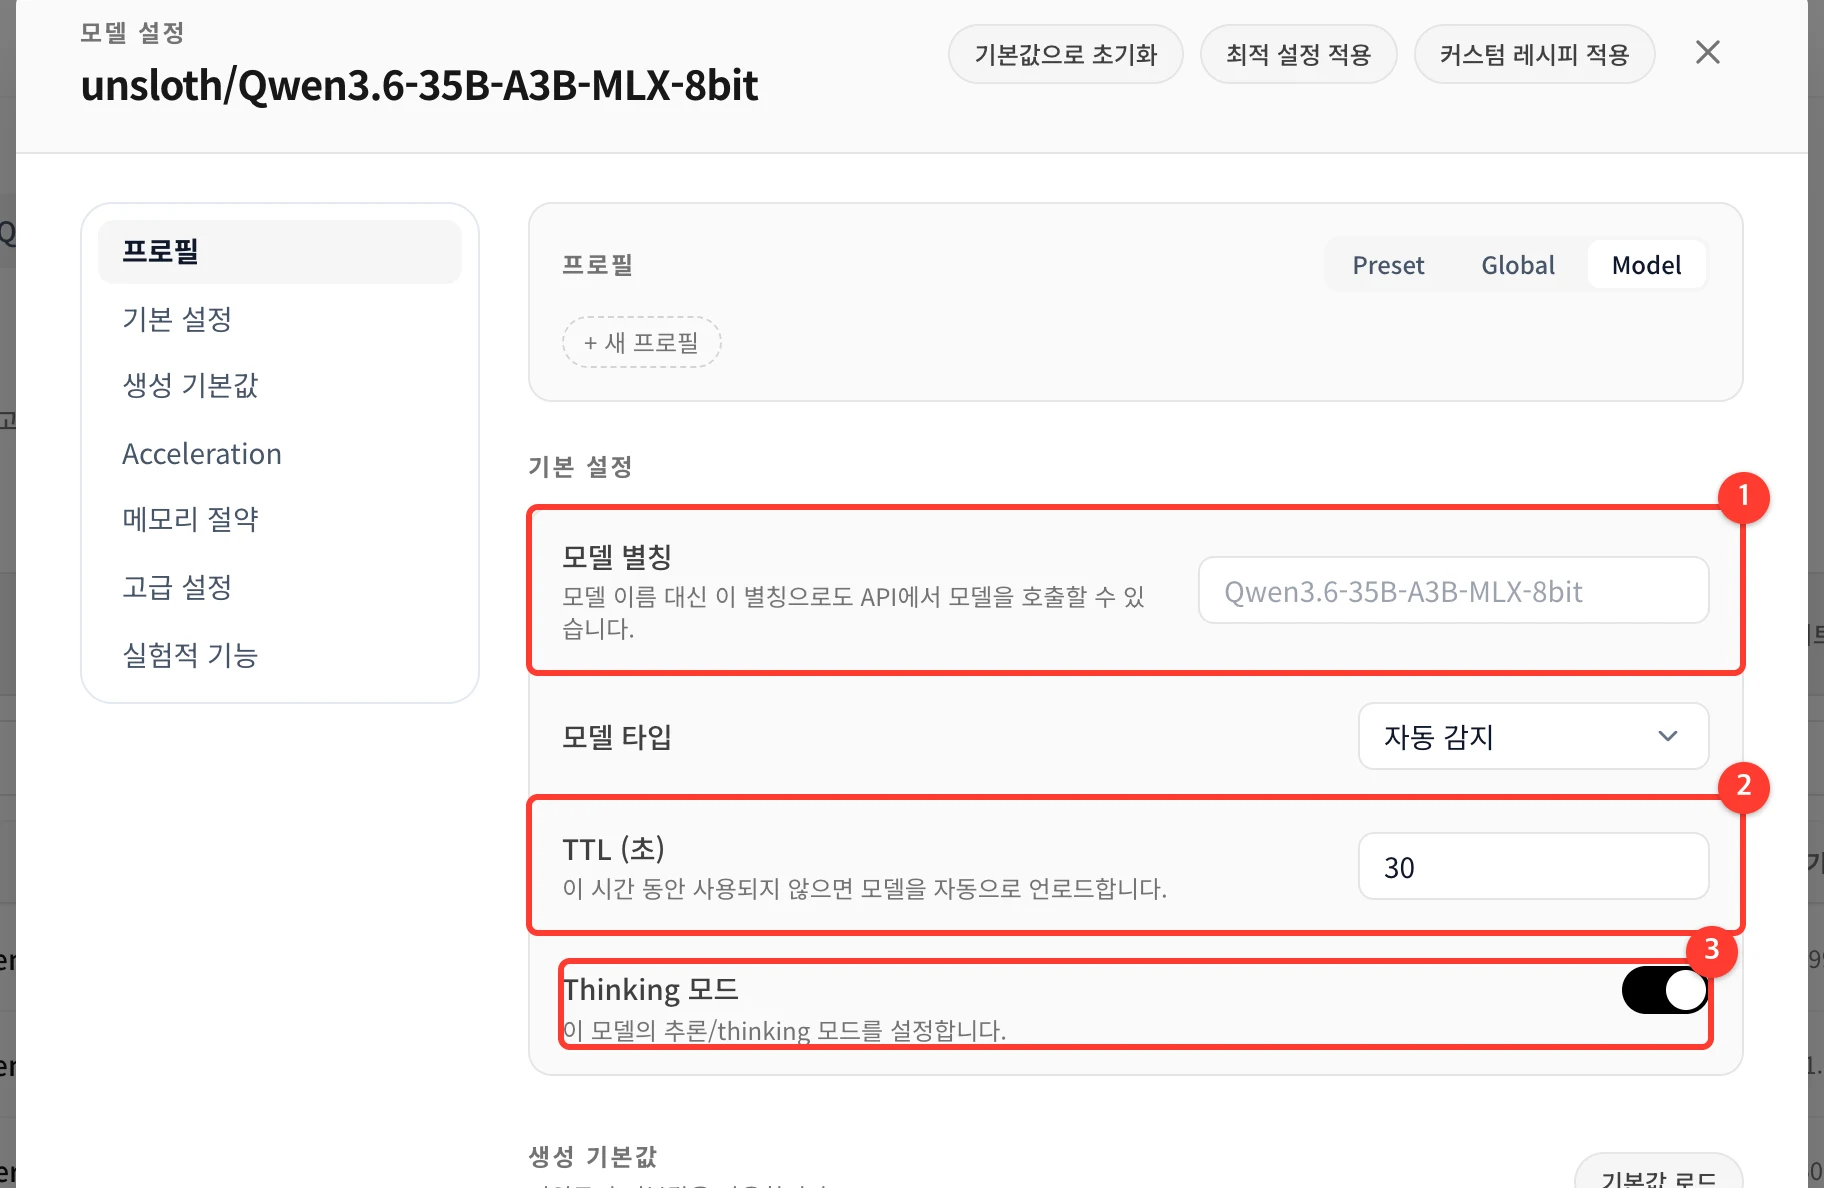
- 나의 경우 은 생성 모델 TTL 을 30초, 임베딩 모델을 10초로 두었다.
- 같은 Mac 에서 Draw Things 로 이미지를 생성하니 놀고 있는 모델은 빨리 내리는 편이 낫다.
- 다시 모델을 로딩하는 부담은 크지 않다.
- oMLX 가 98번 관측한 로드 속도는 GB 당 0.216초다.
- 35B 모델은 디스크 캐시에 남아 있을 때 4.5초 만에 다시 올라왔다.
- n8n 은 임베딩을 한 번에 모아서 보낸다. 10초면 한 묶음을 처리하는 동안 모델이 내려가지 않는다.
고정(pin)과 LRU
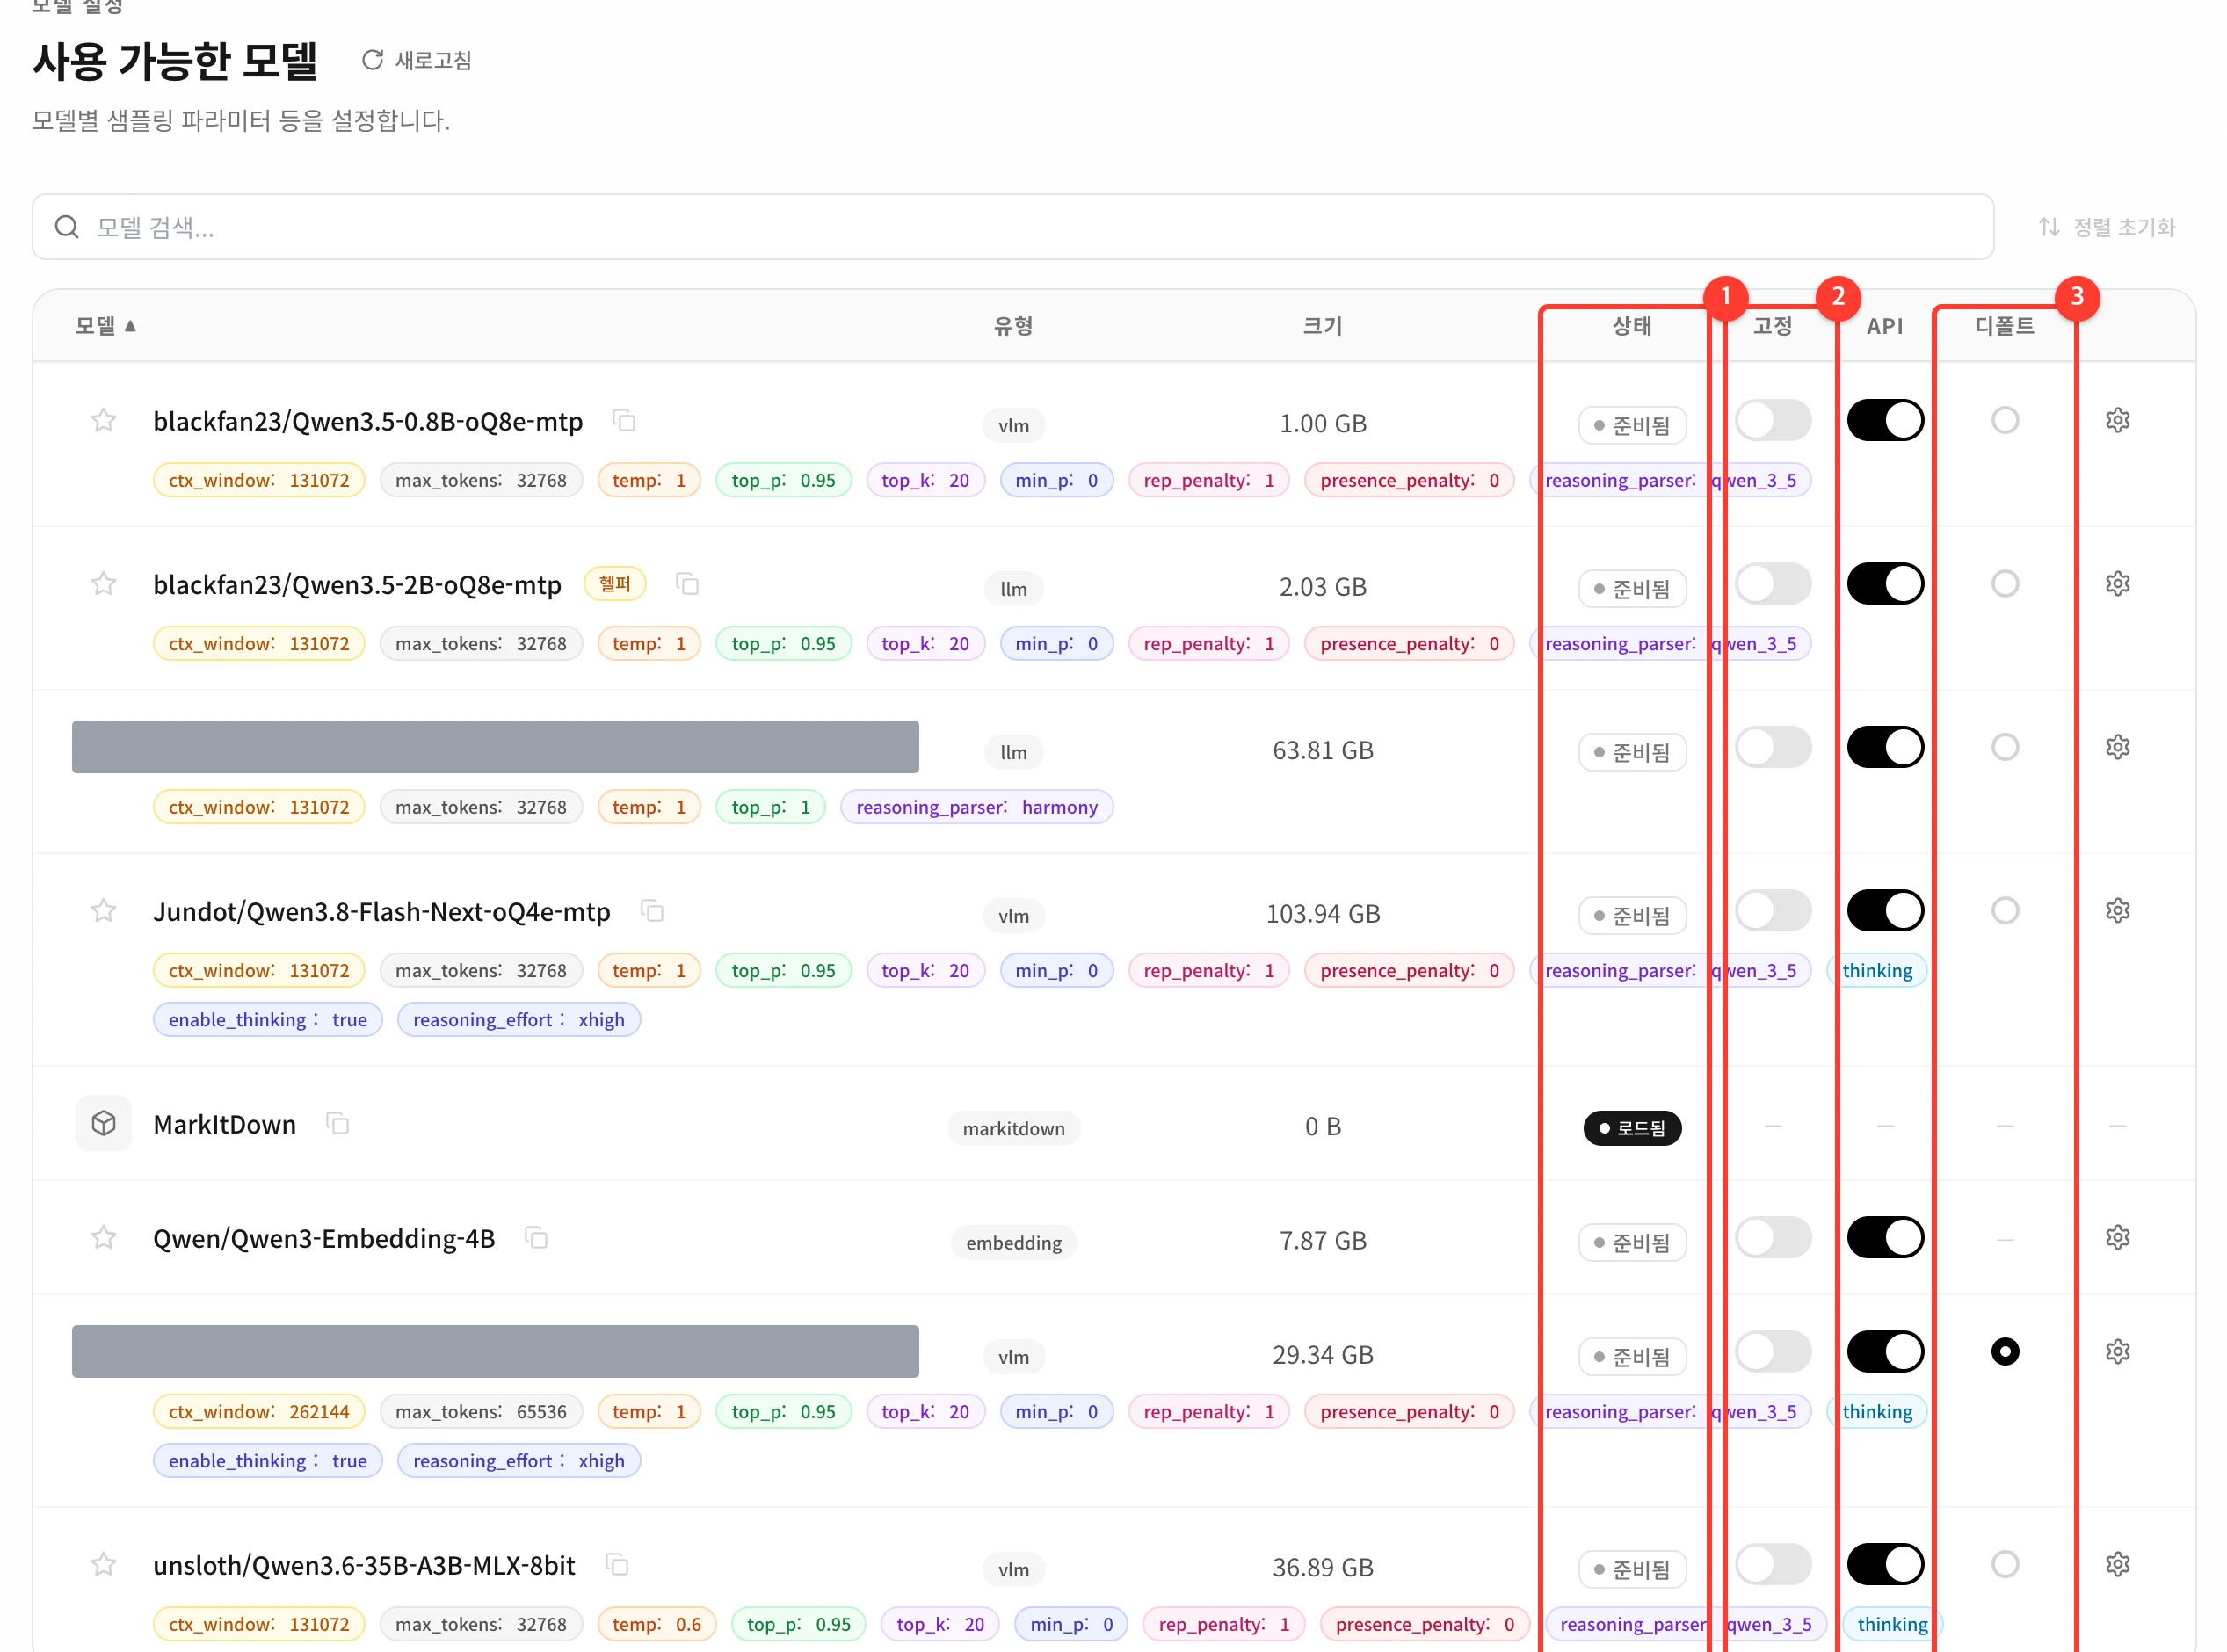
- 고정한 모델은 TTL·LRU 대상에서 빠지고 계속 메모리에 남는다. 상시 사용 모델에 권장된다.
- 고정 모델 미사용중: 다시 올리는 데 몇 초면 되니 TTL 로 충분하다.
- LRU 는 새 모델을 올릴 때 상한을 넘으면 가장 오래 쓰지 않은 모델부터 내린다.
- 나의 경우 TTL 이 먼저 메모리를 비워서 LRU 까지 가는 일이 드물었다.
- 측정 중 35B(35.6 GB)와 27B(37.1 GB)가 함께 올라갔을 때도
- 동적 상한이 93.7 GB 라 두 모델이 동시에 메모리에 올라가 있는 상태였다.
SSD KV 캐시
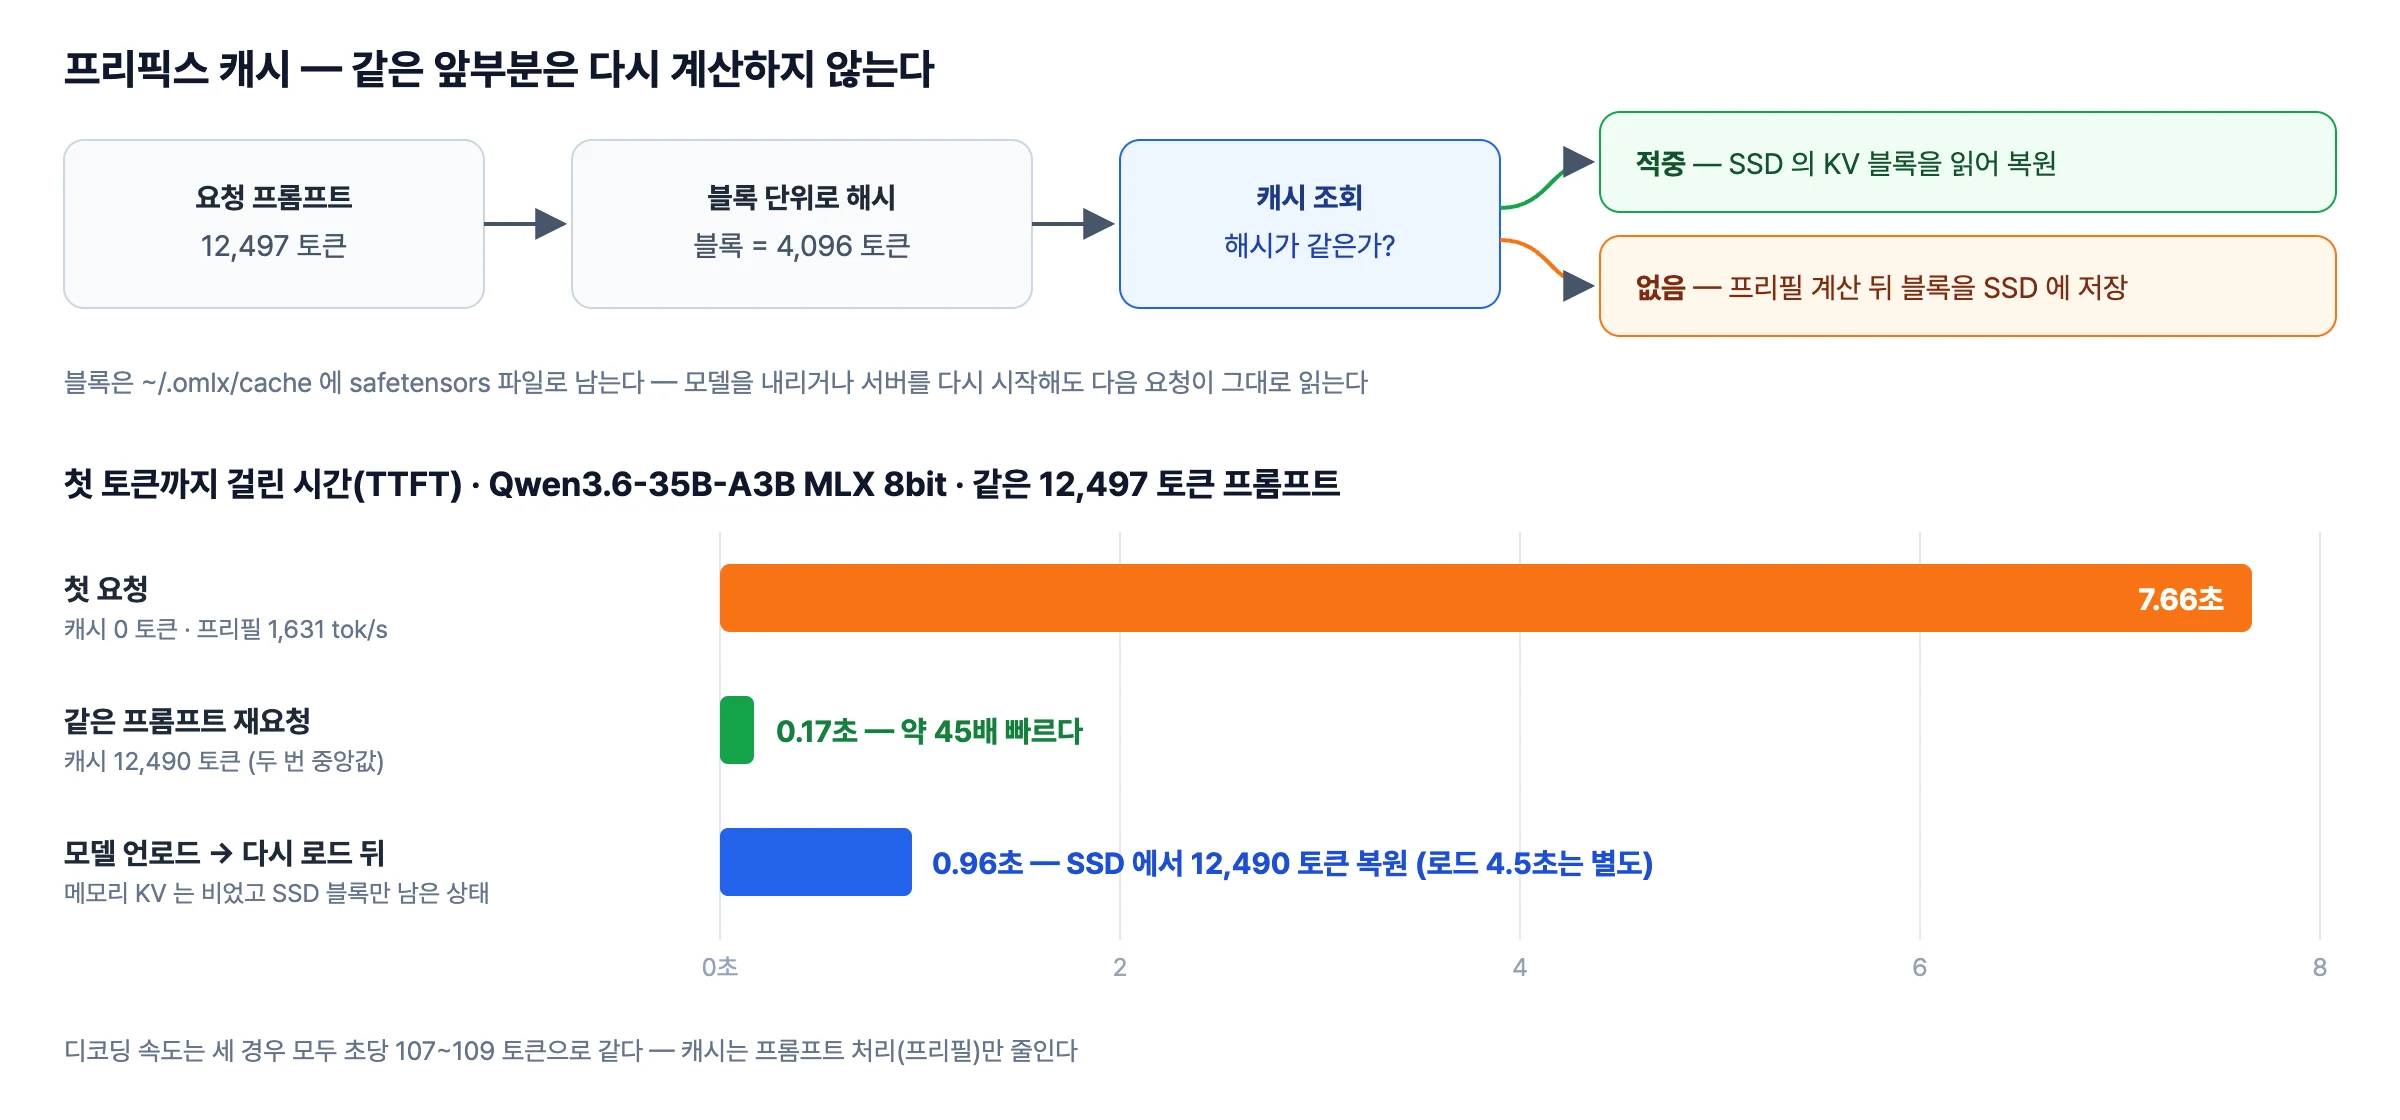
- 현재 Mac 의 설정: SSD 캐시 최대 92 GB(
~/.omlx/cache), 메모리 hot 캐시는 꺼짐(0). - 블록 크기는 4,096 토큰이다(
server.log). - 같은 프롬프트를 세 번 보내 TTFT 를 비교했다. 측정 스크립트는 아래 실측 절에 있다.
# 같은 seed 는 같은 프롬프트다
python3 omlx_bench.py chat Qwen3.6-35B-A3B-MLX-8bit --prompt-tokens 12000 --gen 64 --runs 1 --seed 1793634811 --reuse
python3 omlx_bench.py chat Qwen3.6-35B-A3B-MLX-8bit --prompt-tokens 12000 --gen 64 --runs 2 --seed 1793634811 --reuse

# 관리 화면(모델 > 관리)이나 관리 API 로 모델을 내렸다 다시 올린 뒤
python3 omlx_bench.py chat Qwen3.6-35B-A3B-MLX-8bit --prompt-tokens 12000 --gen 64 --runs 1 --seed 1793634811 --reuse
Code language: Bash (bash)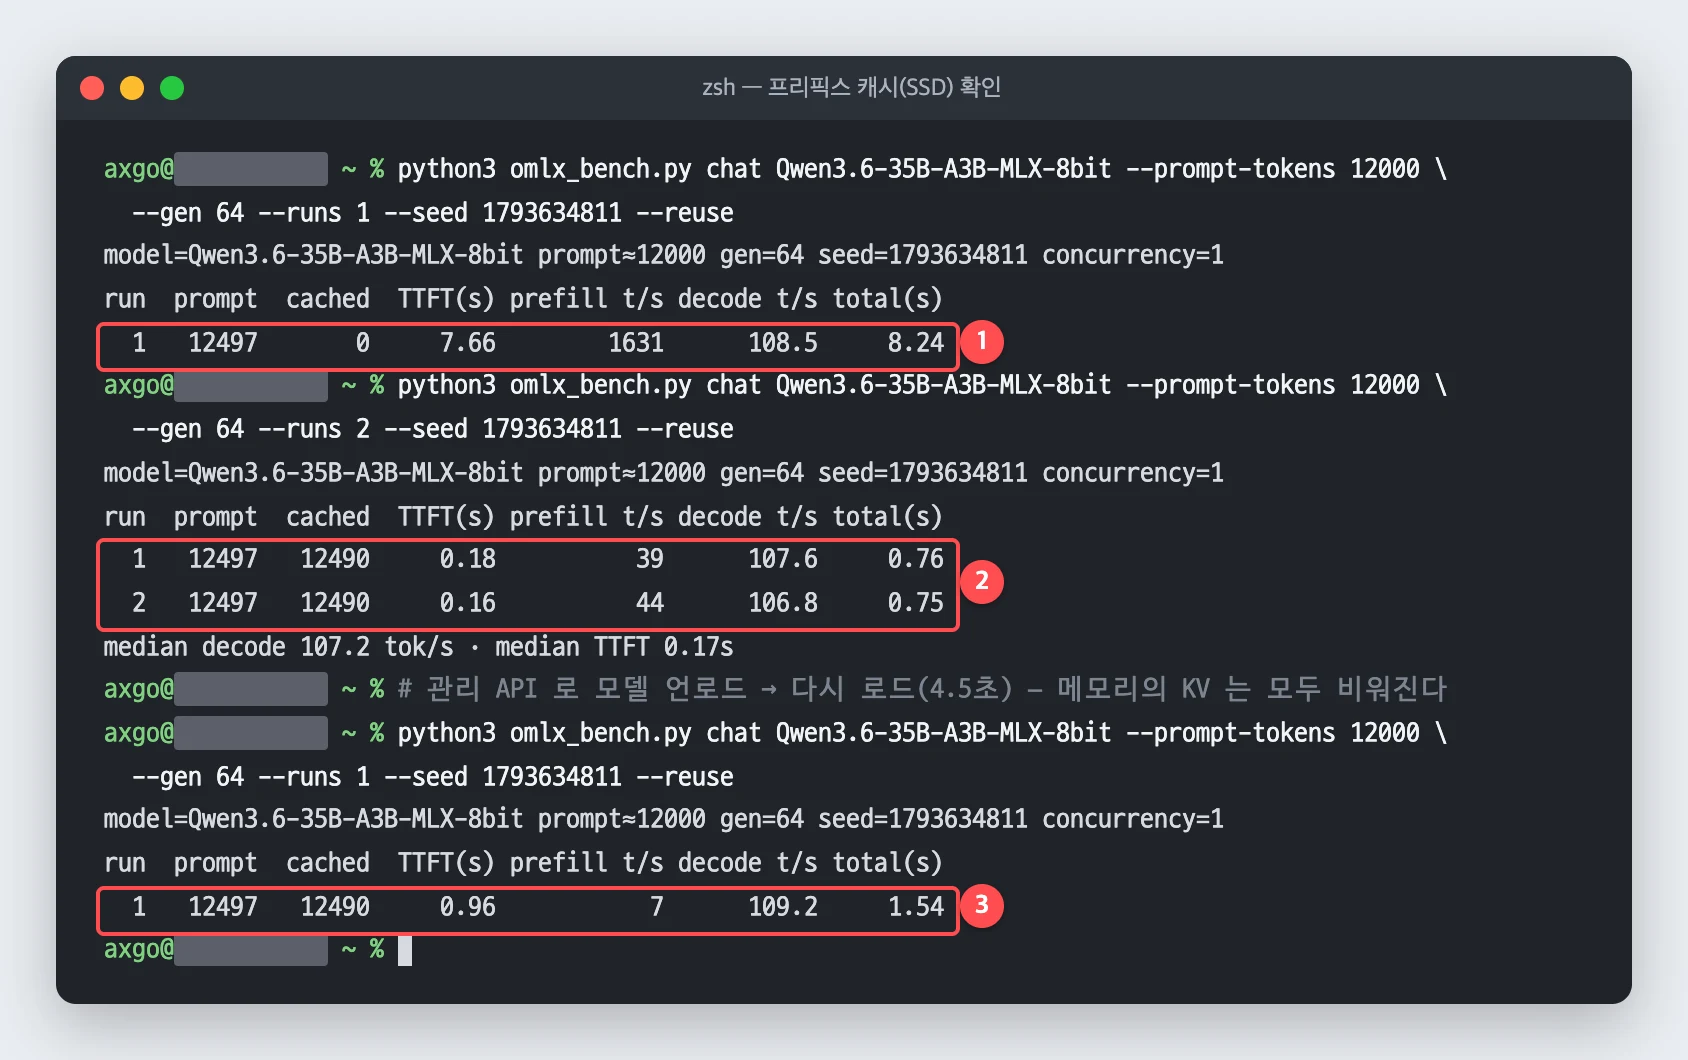
② 같은 프롬프트 재요청 0.18·0.16초
③ 모델을 내렸다 다시 올린 뒤 0.96초
- 첫 요청은 12,497 토큰을 모두 프리필해서 7.66초가 걸렸다.
- 같은 프롬프트를 다시 보내면 12,490 토큰을 캐시에서 읽고 0.17초에 첫 토큰이 나왔다. (약 45배 빠르다)
- 모델을 내려 메모리의 KV 가 모두 비워진 뒤에도 SSD 블록에서 12,490 토큰을 복원해 0.96초가 걸렸다.
- 이 모델은 하이브리드 어텐션 구조라 블록 경계 스냅샷까지 저장해서 4,096 토큰 블록 단위보다 촘촘하게 Hit 됐다.
- 디코딩 속도는 세 경우 모두 초당 107~109 토큰으로 같았다. 캐시 효과는 프롬프트 처리에만 나타난다.
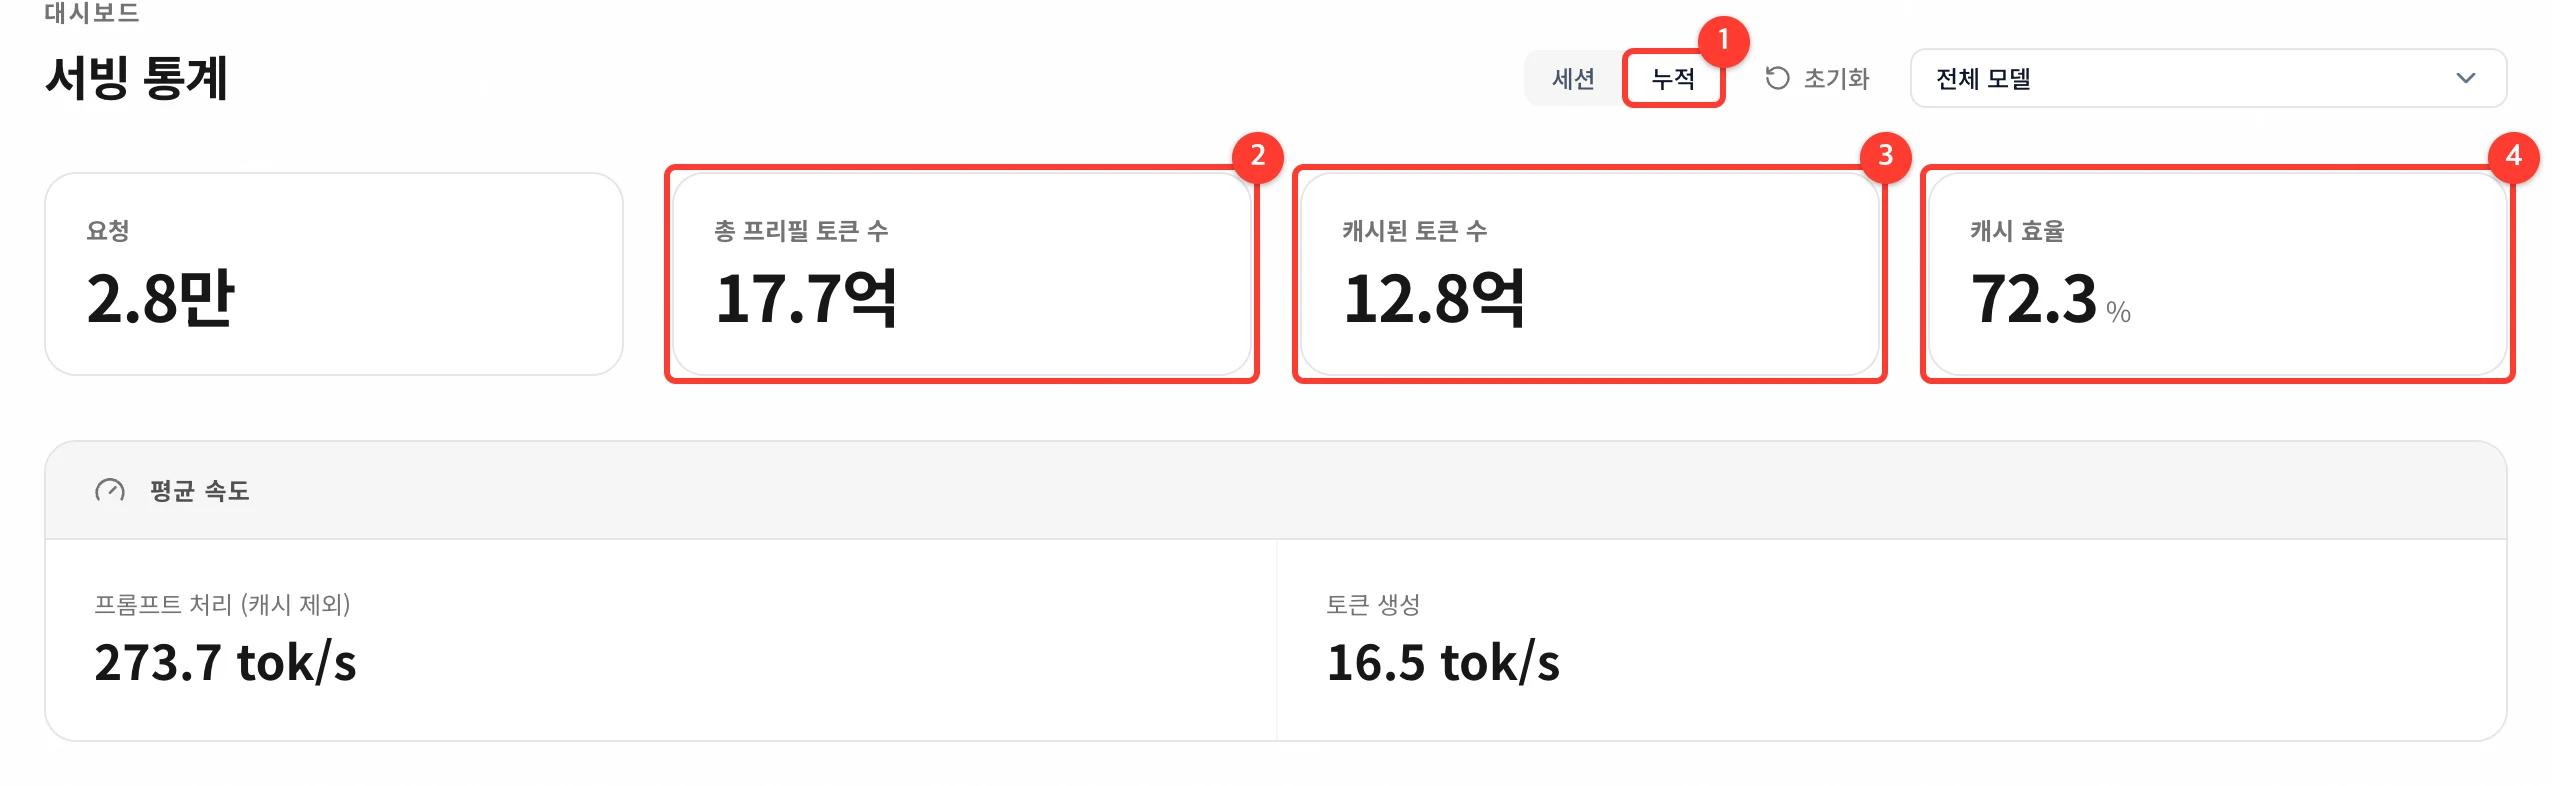
- 누적 효율 72.3% 는 주로 코딩 에이전트 요청에서 나온다. 시스템 프롬프트와 도구 정의가 매번 앞에 붙기 때문이다.
- 임베딩은 매번 다른 텍스트라 캐시 효율이 0% 다.
- 한 번만 쓸 요청은
X-oMLX-Cache-Store: off헤더를 붙여 캐시에 저장하지 않는다. 캐시 조회는 그대로 한다.
curl -s http://127.0.0.1:8000/v1/chat/completions -H 'X-oMLX-Cache-Store: off' ...
Code language: Bash (bash)
M4 Max 128G 벤치마킹 — 초당 토큰 수·상주 메모리·MTP
측정 스크립트
- 간단하게 벤치마킹 스크립트를 돌려보자.
(OMLX_BASE·OMLX_API_KEY환경 변수 사용) chat: 스트리밍으로 TTFT·프리필·디코딩 속도와 캐시 적중 토큰을 잰다.embed: 임베딩 배치 처리량을 잰다.
#!/usr/bin/env python3
"""oMLX(OpenAI 호환 서버) 속도 측정 — 표준 라이브러리만 쓴다.

  chat : TTFT · 프리필(tok/s) · 디코딩(tok/s) · 캐시 적중 토큰
  embed: 임베딩 배치 처리량

환경 변수 OMLX_BASE(기본 http://127.0.0.1:8000/v1), OMLX_API_KEY
"""
import argparse, json, os, random, statistics, time, urllib.request
from concurrent.futures import ThreadPoolExecutor

BASE = os.environ.get("OMLX_BASE", "http://127.0.0.1:8000/v1").rstrip("/")
KEY = os.environ.get("OMLX_API_KEY", "")
LINE = ("Unified memory lets the GPU read model weights without a PCIe copy, "
        "so decode speed is bound by memory bandwidth rather than FLOPS. ")


def post(path, body, stream=False):
    req = urllib.request.Request(
        BASE + path, data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json", "Authorization": f"Bearer {KEY}"})
    return urllib.request.urlopen(req, timeout=900)


def make_prompt(tokens, seed):
    # 앞머리 seed 가 같으면 같은 프리픽스 → 두 번째 요청부터 프리픽스 캐시 적중
    body = LINE * max(1, tokens // 26)
    return (f"[doc {seed}]\n{body}\n\nExplain the document above to an SRE team "
            "in at least 800 words, with examples.")


def chat_once(model, prompt, gen, think):
    body = {"model": model, "stream": True, "max_tokens": gen, "temperature": 0,
            "messages": [{"role": "user", "content": prompt}],
            "stream_options": {"include_usage": True},
            "chat_template_kwargs": {"enable_thinking": think}}
    t0 = time.perf_counter(); first = None; usage = {}
    with post("/chat/completions", body, stream=True) as r:
        for raw in r:
            line = raw.decode().strip()
            if not line.startswith("data:") or line.endswith("[DONE]"):
                continue
            chunk = json.loads(line[5:])
            delta = (chunk.get("choices") or [{}])[0].get("delta") or {}
            if first is None and (delta.get("content") or delta.get("reasoning_content")):
                first = time.perf_counter()
            usage = chunk.get("usage") or usage
    end = time.perf_counter()
    p, c = usage.get("prompt_tokens", 0), usage.get("completion_tokens", 0)
    cached = (usage.get("prompt_tokens_details") or {}).get("cached_tokens") or 0
    ttft = (first or end) - t0
    return {"prompt": p, "cached": cached, "gen": c, "ttft": ttft,
            "prefill_tps": (p - cached) / ttft if ttft else 0,
            "decode_tps": (c - 1) / (end - first) if first and c > 1 else 0,
            "total": end - t0}


def cmd_chat(a):
    seed = a.seed or random.randrange(10**9)
    print(f"model={a.model} prompt≈{a.prompt_tokens} gen={a.gen} seed={seed} concurrency={a.concurrency}")
    print(f"{'run':>3} {'prompt':>7} {'cached':>7} {'TTFT(s)':>8} {'prefill t/s':>11} {'decode t/s':>10} {'total(s)':>8}")
    rows = []
    for i in range(1, a.runs + 1):
        prompt = make_prompt(a.prompt_tokens, seed if a.reuse else f"{seed}-{i}")
        with ThreadPoolExecutor(a.concurrency) as ex:
            batch = list(ex.map(lambda _: chat_once(a.model, prompt if a.reuse else prompt + f" #{_}", a.gen, a.think),
                                range(a.concurrency)))
        for r in batch:
            rows.append(r)
            print(f"{i:>3} {r['prompt']:>7} {r['cached']:>7} {r['ttft']:>8.2f} {r['prefill_tps']:>11.0f} "
                  f"{r['decode_tps']:>10.1f} {r['total']:>8.2f}")
        if a.concurrency > 1:
            wall = max(r["total"] for r in batch)
            print(f"    aggregate decode {sum(r['gen'] for r in batch) / wall:.1f} tok/s over {wall:.1f}s")
    if a.runs > 1:
        print(f"median decode {statistics.median(r['decode_tps'] for r in rows):.1f} tok/s · "
              f"median TTFT {statistics.median(r['ttft'] for r in rows):.2f}s")


def cmd_embed(a):
    texts = [f"뉴스 {i}: " + "한국은행이 기준금리를 동결했다. 시장은 연내 인하 가능성을 반영했다. " * 4 for i in range(a.batch)]
    for i in range(1, a.runs + 1):
        t0 = time.perf_counter()
        with post("/embeddings", {"model": a.model, "input": texts}) as r:
            d = json.load(r)
        dt = time.perf_counter() - t0
        tok = (d.get("usage") or {}).get("prompt_tokens", 0)
        print(f"run {i}: {len(d['data'])} x {len(d['data'][0]['embedding'])}d  {dt:.2f}s  {tok} tok  {tok / dt:.0f} tok/s")


p = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawDescriptionHelpFormatter)
sub = p.add_subparsers(dest="cmd", required=True)
c = sub.add_parser("chat")
c.add_argument("model"); c.add_argument("--prompt-tokens", type=int, default=1024)
c.add_argument("--gen", type=int, default=256); c.add_argument("--runs", type=int, default=3)
c.add_argument("--concurrency", type=int, default=1); c.add_argument("--seed")
c.add_argument("--reuse", action="store_true", help="모든 실행에 같은 프롬프트(프리픽스 캐시 확인)")
c.add_argument("--think", action="store_true", help="thinking 켜기(기본 끔)")
e = sub.add_parser("embed")
e.add_argument("model"); e.add_argument("--batch", type=int, default=64); e.add_argument("--runs", type=int, default=3)
a = p.parse_args()
cmd_chat(a) if a.cmd == "chat" else cmd_embed(a)
Code language: Python (python)
export OMLX_API_KEY='<키>'
python3 omlx_bench.py chat Qwen3.6-35B-A3B-MLX-8bit --prompt-tokens 1024 --gen 512 --runs 3
python3 omlx_bench.py chat Qwen3.6-35B-A3B-MLX-8bit --prompt-tokens 1024 --gen 512 --runs 1 --concurrency 4
python3 omlx_bench.py embed Qwen3-Embedding-4B --batch 64 --runs 3
Code language: Bash (bash)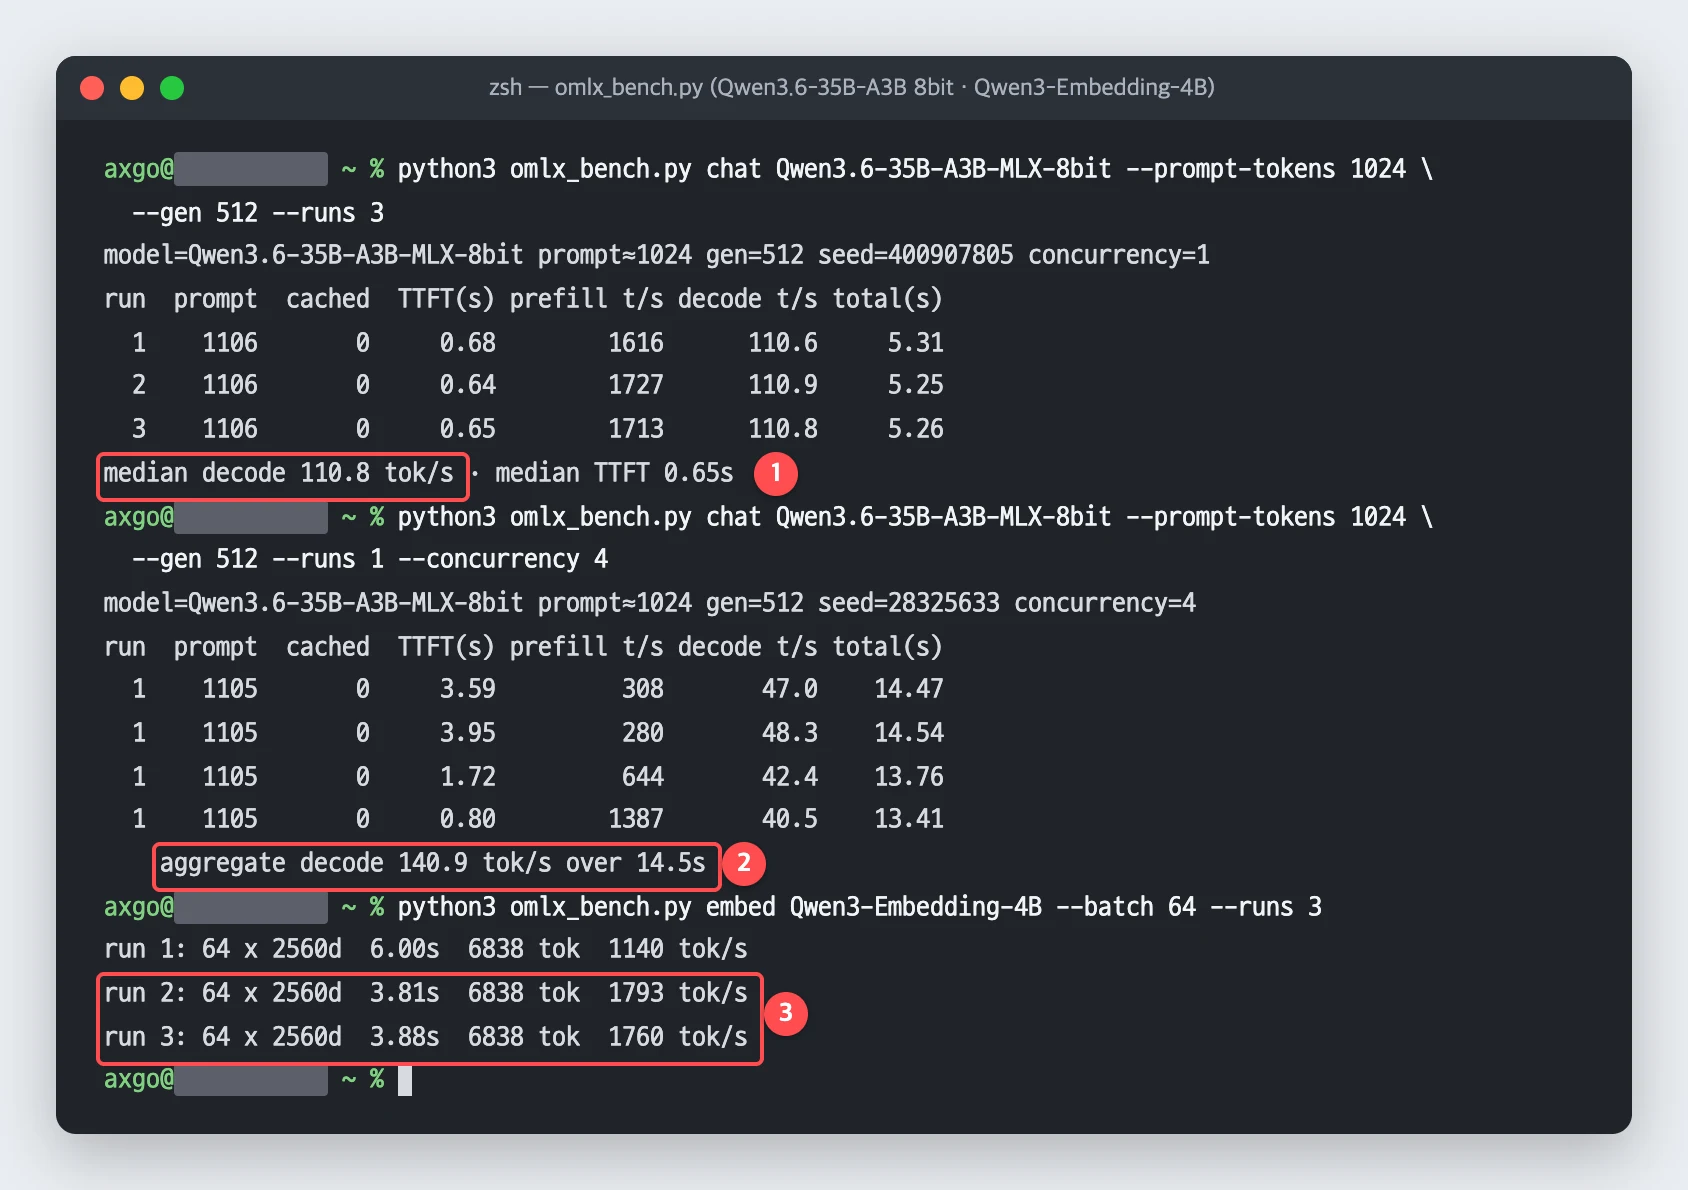
② 4요청 동시 합계 140.9 tok/s
③ 임베딩 64건 배치 약 1,770 tok/s
결과
| 모델 | 상주 메모리 | 로드 | TTFT (1.1K 토큰) | 프리필 | 디코딩 |
|---|---|---|---|---|---|
| Qwen3.6-35B-A3B MLX 8bit (MoE, 활성 3B) | 35.6 GB | 4.5~14.6초 | 0.65초 | 1,713 tok/s | 110.8 tok/s |
| Qwen3.8-27B 기반 8bit (oQ8e, MTP 켬) | 37.1 GB | 43.2초 (첫 로드) | 5.89초 | 188 tok/s | 29.1 tok/s |
| 같은 27B 모델, MTP 끔 | 37.1 GB | – | 6.07초 | 182 tok/s | 15.6 tok/s |
| Qwen3-Embedding-4B (64건 배치) | 7.5 GB | – | – | 약 1,770 tok/s | – |
- 상주 메모리는
server.log의 실제 로드 크기다. 로드 시간은 디스크에서 처음 읽을 때와 디스크 캐시에 남아 있을 때 차이가 크다. - 35B MoE 는 토큰마다 활성 파라미터가 3B 라 MTP 를 켠 27B dense 모델보다도 디코딩이 3.8배 빠르다.
27B 디코딩을 1.9배 향상시키는 MTP 헤드
- MTP(Multi-Token Prediction) 헤드가 다음 토큰 여러 개를 먼저 제안하면 본 모델이 한 번에 검증한다.
- 같은 모델·같은 조건에서 초당 15.6 토큰이 29.1 토큰이 됐다(1.87배).
server.log를 보면 512 토큰을 생성하는 데 193~210 사이클이 걸렸다. 사이클당 2.44~2.65 토큰을 확정했고 제안 수락률은 67~72% 였다.- TTFT 는 거의 같다(6.07초 → 5.89초). MTP 는 디코딩 연산 필요성을 줄인다.
- MTP 헤드가 있는 모델(이름 끝
-mtp)에서만 활성화할 수 있다. 모델 설정 > Acceleration 에서 활성화할 수 있다.
동시 요청 — 연속 배칭의 장단점
- 35B 에 요청 4개를 동시에 보내면 합계가 초당 140.9 토큰이 된다. 단일 요청(110.8)의 1.27배다.
- 하지만, 요청 하나만 보면 초당 40~48 토큰으로 느려진다. (반비례!)
- 서빙 처리량은 늘어나지만 요청자 입장에서는 응답이 지연되는 것으로 느껴진다.
- 현재 최대 동시 요청은 4로 두었다. oMLX를 여러곳에서 사용해야 한다면 이 값을 적당히 맞춰줘야 한다.
정리 — oMLX 가 맞는 경우와 다른 도구가 나은 경우
- oMLX 가 맞는 경우
- Mac 한 대를 여러 클라이언트가 API 로 쓰는 서버로 둘 때
- 임베딩·생성·리랭커를 한 포트로 서비스할 때
- 코딩 에이전트처럼 같은 프리픽스를 반복해서 보낼 때
- 다른 도구가 나은 경우
- GUI 에서 모델을 골라 대화하는 개인 사용, GGUF 와 MLX 를 같이 쓰려면 LM Studio
- 리눅스·윈도우·맥을 같은 CLI 로 맞추려면 Ollama
- NVIDIA GPU 서버라면 vLLM (부럽다…)
- 나의 로컬 LLM Mac 설정
- 메모리 가드 aggressive, 생성 모델 TTL 30초·임베딩 10초, 고정 없음
- SSD 캐시 92 GB, 최대 동시 요청 4
- 127.0.0.1 에만 열고 tailscale serve 로 TLS 프라이빗 서빙중
A1 처럼 작은 서버가 워크플로우를 돌리고 무거운 추론을 Mac 으로 넘긴다. 이 구성에서 oMLX 는 주소 하나, 키 하나로 모든 모델을 서빙 받는다. TTL 과 메모리 가드가 모델 메모리를 효율적으로 관리하며, 반복되는 프롬프트는 SSD 캐시가 지연시간을 줄여 준다.