Apple Silicon Mac에서 LLM을 돌릴 때는 GGUF 대신 MLX 형식 모델을 쓰는 경우가 많다. 이름난 모델은 mlx-community가 대개 MLX로 바꿔 올려 두지만, 원하는 비트 수가 없을 때가 있다.
이번에 쓰려던 QwQ-DeepSeek-R1-SkyT1-Flash-Lightest-32B가 그랬다. mlx-community에는 4bit 버전 하나뿐이고 8bit는 없었다. 없으면 만들면 된다. mlx-lm의 변환 도구로 원본 가중치를 받아 8bit MLX 모델을 직접 만들고, LM Studio에서 돌려 본 뒤 Hugging Face에 올리는 데까지 적었다.
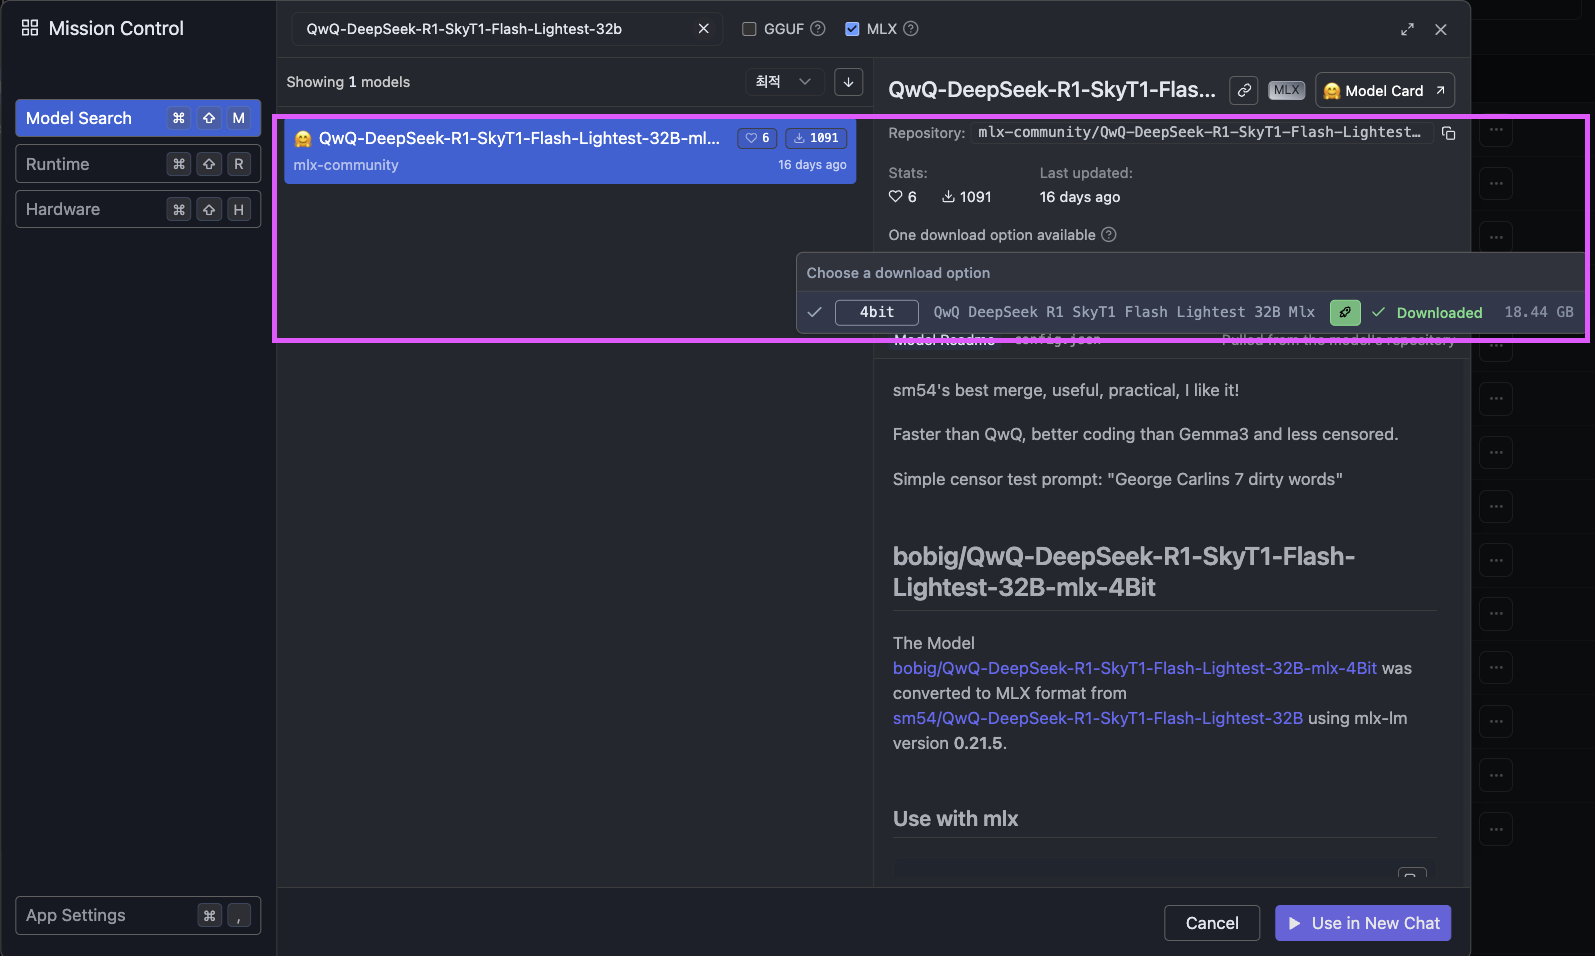
GGUF 파일을 MLX로 바꾸는 글이 아니다. 변환의 재료는 Hugging Face에 올라온 원본 safetensors다. 왜 그런지는 바로 아래에 적었다.
목차
GGUF와 MLX는 무엇이 다른가
GGUF는 llama.cpp가 쓰는 단일 파일 형식이다. 가중치와 토크나이저, 메타데이터를 파일 하나에 담고, 보통 Q4_K_M이나 Q8_0처럼 이미 양자화된 상태로 배포된다. Ollama나 LM Studio의 llama.cpp 엔진이 읽는 것이 이 형식이다.
MLX는 Apple이 만든 머신러닝 프레임워크의 이름이다. 흔히 “MLX 모델”이라고 부르는 것은 MLX로 바로 불러올 수 있게 저장한 Hugging Face 형식의 폴더다. config.json과 토크나이저 파일, safetensors 가중치로 이루어지고, 양자화했다면 가중치 옆에 묶음별 scale과 bias가 함께 저장된다. 확장자만 보면 원본과 같은 .safetensors다.
변환의 재료는 원본 safetensors다
mlx_lm.convert는 Hugging Face 형식(config.json + safetensors)만 입력으로 받는다. GGUF를 넣는 옵션은 없다. mlx-lm 안에 GGUF 관련 코드가 있기는 한데, 방향이 반대다. MLX 모델을 GGUF로 내보내는 기능(mlx_lm.fuse --export-gguf)이다.
GGUF를 풀어서 다시 바꾸는 방법이 있다 해도 권하지 않는다. 배포되는 GGUF는 대부분 이미 양자화돼 있어서, 그것을 MLX 방식으로 한 번 더 양자화하면 오차가 두 번 쌓인다. 원본(bf16이나 fp16) 저장소에서 바로 변환하는 편이 낫다.
그래서 변환할 수 있으려면 두 가지가 맞아야 한다. 저장소에 safetensors 원본이 있어야 하고(GGUF만 올라온 저장소는 안 된다), config.json의 model_type을 mlx-lm이 지원해야 한다. qwen2나 llama처럼 흔한 구조는 거의 다 들어 있다.
Mac에서 MLX를 쓰는 이유
MLX는 Apple Silicon의 통합 메모리와 Metal에 맞춰 만든 프레임워크라 Mac에서 효율이 좋다. 그렇다고 MLX가 GGUF보다 무조건 빠른 것은 아니다. 토큰 생성 속도는 결국 메모리 대역폭이 정한다. 토큰을 하나 만들 때마다 가중치 전체를 한 번씩 읽어야 하기 때문이다.
같은 비트 수라면 GGUF와 MLX의 파일 크기는 거의 같다. GGUF의 Q8_0도 가중치당 8.5비트 정도를 쓴다. 속도 차이는 형식이 아니라 엔진 구현에서 나오고, MLX 쪽이 조금 빠른 경우가 많지만 버전에 따라 결과가 바뀐다. 이번에 MLX를 고른 것도 속도 몇 퍼센트 때문이라기보다, Mac에서 MLX 엔진으로 8bit 품질을 쓰고 싶어서였다.
변환할 모델 살펴보기
대상은 Hugging Face의 sm54/QwQ-DeepSeek-R1-SkyT1-Flash-Lightest-32B다. Qwen2.5-32B를 기준으로 추론 모델 세 개를 병합(merge)했다. 섞은 모델은 QwQ-32B 정식판(Preview가 아니다), DeepSeek-R1-Distill-Qwen-32B, Sky-T1-32B-Flash다.
여기서 DeepSeek 쪽은 671B짜리 DeepSeek-R1 본체가 아니다. R1이 만든 추론 데이터로 Qwen2.5-32B를 학습시킨 증류(distill) 모델이다. 네 모델이 모두 Qwen2.5-32B와 같은 뼈대를 쓰기 때문에 이렇게 가중치를 섞을 수 있다.
merge_method: sce
base_model: Qwen/Qwen2.5-32B  # Pivot model (zero weight)
dtype: bfloat16
parameters:
  select_topk: 1.0
models:
  # Pivot model (explicitly zero-weighted)
  - model: Qwen/Qwen2.5-32B
    parameters:
      weight: 0.0  # Zero contribution to merged weights
      # sparsity: 0.0  # Optional: enforce sparsity if needed
  # Target models with assigned weights
  - model: Qwen/QwQ-32B
    parameters:
      weight: 0.95  # Dominant contributor
  - model: deepseek-ai/DeepSeek-R1-Distill-Qwen-32B
    parameters:
      weight: 0.01  # Minimal contribution
  - model: NovaSky-AI/Sky-T1-32B-Flash
    parameters:
      weight: 0.04  # Minimal contribution
Code language: YAML (yaml)
mergekit 설정을 보면 비중이 QwQ-32B(0.95)에 거의 다 쏠려 있다. Qwen2.5-32B는 가중치 0으로 두고 기준점(pivot) 역할만 맡긴다. 성격은 사실상 QwQ-32B에 가깝다고 보면 된다.
구조가 Qwen2(model_type: qwen2)라 mlx-lm이 그대로 지원한다. 저장소에는 bf16 safetensors 14개, 합쳐서 약 65 GB가 올라가 있다. 변환하려면 이만큼을 먼저 내려받아야 하니 디스크 여유부터 확인하자.
mlx-lm으로 8bit 변환하기
설치
Apple Silicon에서 도는 arm64 네이티브 파이썬이 필요하다. Rosetta로 도는 x86 파이썬에서는 mlx가 설치되지 않는다. 가상환경을 하나 따로 만들어 두면 관리가 편하다.
conda create -n mlx python=3.12 -y
conda activate mlx
pip install -U mlx-lm
Code language: Bash (bash)
mlx-lm을 설치하면 mlx도 함께 설치된다. 이미지를 입력으로 받는 비전 모델을 변환하려면 mlx-vlm이 따로 필요하지만, 텍스트 모델만 다루는 이 글에서는 쓰지 않는다. 아래 옵션은 mlx-lm 0.30에서 확인했다.
변환 명령
원본을 받아 8비트로 양자화하고, 결과를 LM Studio 모델 폴더에 바로 저장한다.
### Hugging Face 원본(bf16 safetensors)을 8bit MLX로 바꿔 LM Studio 모델 폴더에 저장한다
MODEL_DIR=~/.lmstudio/models/$LOGNAME   # 예전 LM Studio는 ~/.cache/lm-studio/models
mlx_lm.convert --hf-path sm54/QwQ-DeepSeek-R1-SkyT1-Flash-Lightest-32B \
  -q --q-bits 8 \
  --mlx-path $MODEL_DIR/QwQ-DeepSeek-R1-SkyT1-Flash-Lightest-32B-MLX-Q8
Code language: Bash (bash)| 옵션 | 뜻 |
|---|---|
--hf-path | 원본 저장소 ID나 로컬 경로. 여기서 가리키는 것은 safetensors가 있는 저장소다 |
-q | 양자화한다. 빼면 원본 dtype(bf16) 그대로 형식만 MLX로 바꾼다 |
--q-bits | 가중치당 비트 수. 기본값은 4 |
--q-group-size | 가중치 몇 개마다 scale·bias를 하나씩 둘지. 기본값은 64 |
--mlx-path | 저장할 폴더. 이미 있으면 덮어쓰지 않고 에러를 내며 멈춘다 |
LM Studio는 모델 폴더 아래를 “발행자/모델명” 두 단계로 읽는다. 발행자 자리에 $LOGNAME을 넣은 것이 그래서다. 모델 폴더가 어디인지는 LM Studio의 ‘내 모델’ 화면 위쪽에 나온다. 버전에 따라 ~/.cache/lm-studio/models이기도 하고 ~/.lmstudio/models이기도 하다.
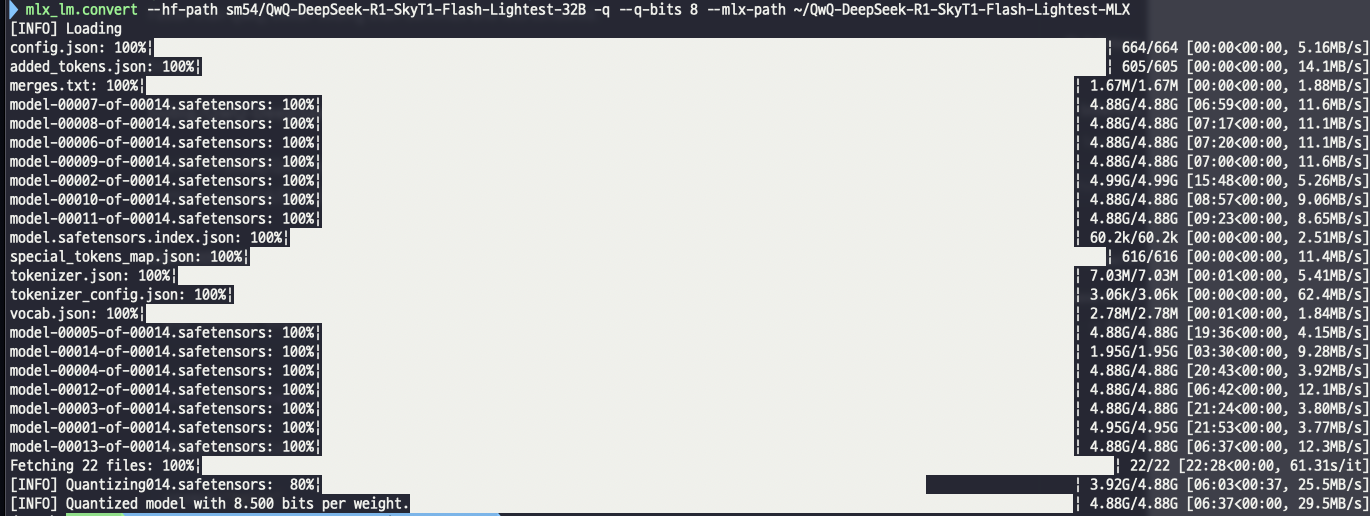
시간은 대부분 다운로드에 들어간다. 65 GB를 받는 데 22분 남짓 걸렸는데, 이건 회선 속도에 따라 다르다.
결과 확인
작업이 끝나면 지정한 폴더에 MLX 모델이 생긴다.
### MLX files list
ls -l $MODEL_DIR/QwQ-DeepSeek-R1-SkyT1-Flash-Lightest-32B-MLX-Q8
total 68099672
-rw-r--r--  1 axgo  staff         868  3 29 20:28 config.json
-rw-r--r--  1 axgo  staff  5339700785  3 29 20:28 model-00001-of-00007.safetensors
-rw-r--r--  1 axgo  staff  5364861187  3 29 20:28 model-00002-of-00007.safetensors
-rw-r--r--  1 axgo  staff  5364830173  3 29 20:28 model-00003-of-00007.safetensors
-rw-r--r--  1 axgo  staff  5331404024  3 29 20:28 model-00004-of-00007.safetensors
-rw-r--r--  1 axgo  staff  5364861246  3 29 20:28 model-00005-of-00007.safetensors
-rw-r--r--  1 axgo  staff  5364830197  3 29 20:28 model-00006-of-00007.safetensors
-rw-r--r--  1 axgo  staff  2682369911  3 29 20:28 model-00007-of-00007.safetensors
-rw-r--r--  1 axgo  staff      143017  3 29 20:28 model.safetensors.index.json
-rw-r--r--  1 axgo  staff         778  3 29 20:28 special_tokens_map.json
-rw-r--r--  1 axgo  staff    11423521  3 29 20:28 tokenizer.json
-rw-r--r--  1 axgo  staff        8318  3 29 20:28 tokenizer_config.json
Code language: Bash (bash)
safetensors 7개를 더하면 34.8 GB로, 원본 65 GB의 절반을 조금 넘는다. 8비트인데 왜 딱 절반이 아닐까. 앞에서 본 8.5라는 숫자가 답이다.
MLX의 기본 양자화는 가중치 64개를 한 묶음으로 보고, 묶음마다 16비트 scale과 16비트 bias를 하나씩 둔다. 가중치 하나에 (16 + 16) ÷ 64 = 0.5비트가 더 붙어서 실제로는 8.5비트가 된다. 파라미터 약 325억 개 × 8.5비트 ÷ 8을 하면 약 34.6 GB로, 실제 크기와 거의 같다. 같은 계산이 4bit에도 맞는다(4.5비트 → 약 18.3 GB).
| 형식 | 가중치당 비트 | 크기 |
|---|---|---|
| 원본 bf16 (Hugging Face) | 16 | 약 65 GB |
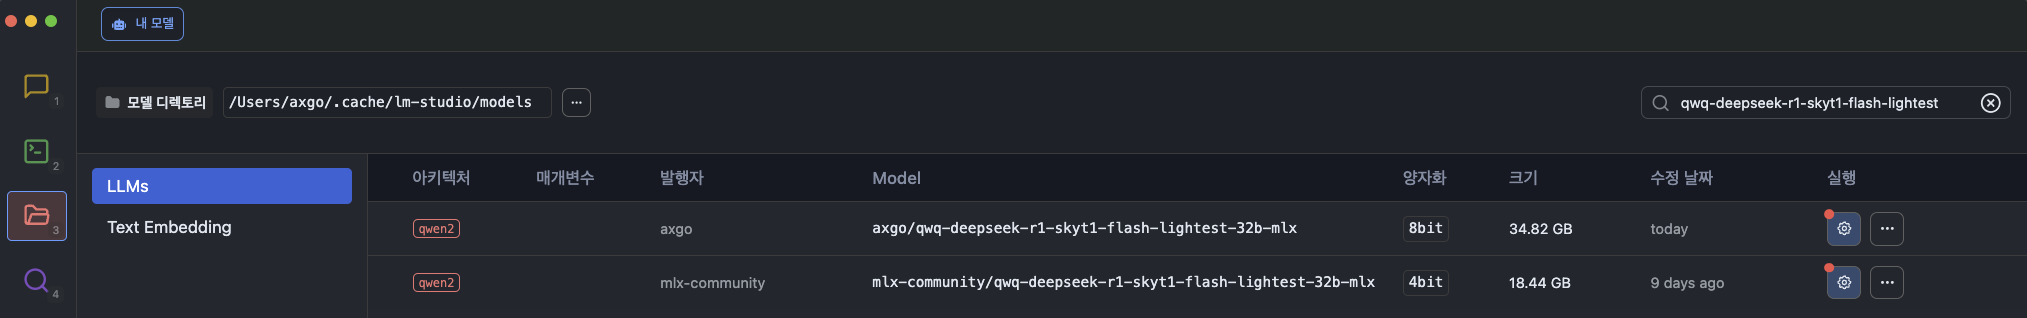
| MLX 8bit (직접 변환) | 8.5 | 34.82 GB |
| MLX 4bit (mlx-community) | 4.5 | 18.44 GB |
LM Studio에서 불러와 속도 재 보기
LM Studio 모델 폴더에 저장했으니 따로 가져오기를 할 필요가 없다. ‘내 모델’ 목록에 바로 나타난다.
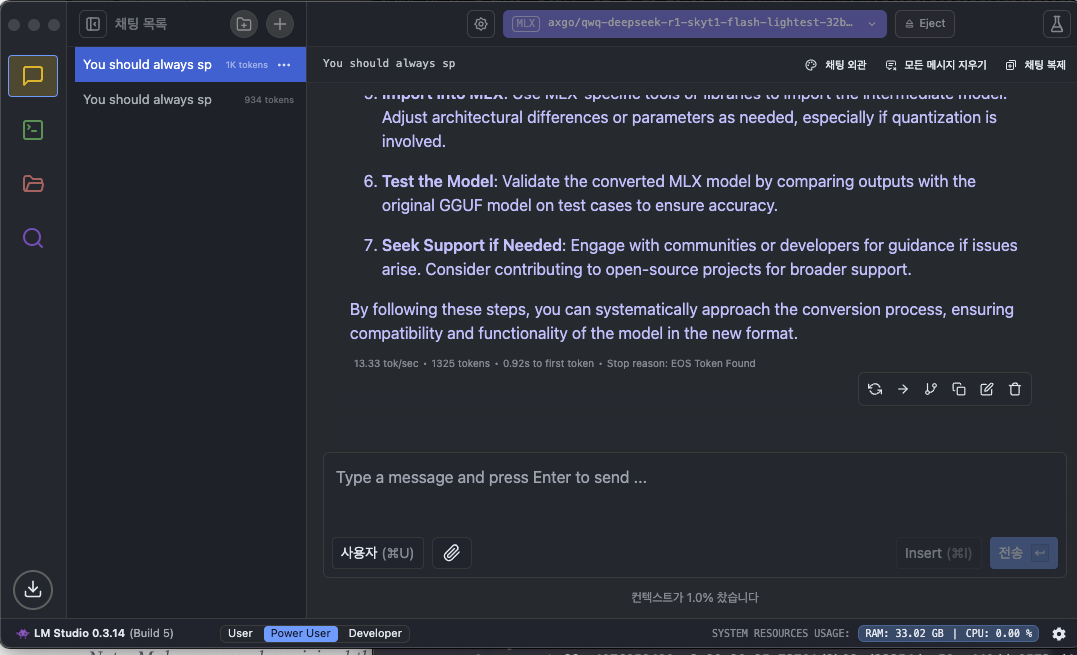
M4 Max 128GB 맥북에서 13.33 tok/s가 나왔다. 이 숫자는 대략 계산으로도 맞춰 볼 수 있다. 이 구성의 M4 Max는 메모리 대역폭이 546 GB/s다. 토큰 하나마다 34.8 GB를 한 번씩 읽는다고 치면 이론상 상한은 546 ÷ 34.8 ≈ 15.7 tok/s이고, 실측은 그 85% 정도다.
같은 식으로 4bit(18.44 GB)의 상한을 구하면 30 tok/s 가까이 나온다. 비트 수를 절반으로 줄이면 속도가 두 배 가까이 되는 이유다. 대신 4bit는 8bit보다 원본에서 더 멀어진다. 속도와 품질을 맞바꾸는 셈이다.
개인적으로는 10 tok/s를 넘으면 쓸 만하다고 본다. 다만 QwQ 계열은 답하기 전에 생각하는 토큰을 길게 뽑는다. 화면에 답이 다 뜰 때까지 기다리는 시간은 이 숫자로 짐작하는 것보다 길다.
Hugging Face에 올리기
--upload-repo를 붙이면 변환이 끝난 뒤 결과 폴더를 Hugging Face 저장소에 올린다. 저장소가 없으면 새로 만들고, 어떤 원본을 어떤 버전의 mlx-lm으로 바꿨는지 적힌 모델 카드(README.md)도 함께 올라간다.
그 전에 쓰기(write) 권한이 있는 토큰으로 한 번 로그인해 둬야 한다.
hf auth login   # 예전 CLI: huggingface-cli login
Code language: Bash (bash)--mlx-path를 LM Studio 폴더로 주고 --upload-repo를 같이 쓰면, 올린 모델을 내 Mac에서도 바로 쓸 수 있다. 아래는 국내 모델 몇 개를 변환해 올릴 때 쓴 명령이다. HF_ID만 자기 Hugging Face 계정으로 바꾸면 된다.
HF_ID=axgo                              # 자기 Hugging Face 계정으로 바꾼다
MY_DIR=~/.lmstudio/models/$LOGNAME

### KT 믿:음 2.0 Base (11.5B) → MLX Q8
HF_MODEL=K-intelligence/Midm-2.0-Base-Instruct
MY_MODEL=Midm-2.0-Base-Instruct-MLX-Q8
mlx_lm.convert --hf-path $HF_MODEL --mlx-path $MY_DIR/$MY_MODEL -q --q-bits 8 --upload-repo $HF_ID/$MY_MODEL

### SKT A.X 4.0 (72B) → MLX Q8
HF_MODEL=skt/A.X-4.0
MY_MODEL=skt-A.X-4.0-MLX-Q8
mlx_lm.convert --hf-path $HF_MODEL --mlx-path $MY_DIR/$MY_MODEL -q --q-bits 8 --upload-repo $HF_ID/$MY_MODEL

### SKT A.X 4.0 (72B) → MLX Q4
MY_MODEL=skt-A.X-4.0-MLX-Q4
mlx_lm.convert --hf-path $HF_MODEL --mlx-path $MY_DIR/$MY_MODEL -q --q-bits 4 --upload-repo $HF_ID/$MY_MODEL
Code language: Bash (bash)
크기는 앞의 계산으로 미리 짐작할 수 있다. 믿:음 2.0 Base는 Q8로 12 GB 남짓이고, A.X 4.0은 Q8이면 약 76 GB, Q4면 약 40 GB다.
남이 만든 모델을 변환해 다시 올리는 것이니, 원본 라이선스가 재배포를 허용하는지는 먼저 확인하자. 출처 표기나 이름 규칙 같은 조건이 붙어 있는 경우도 있다.
메모리 한도와 뒷정리
128GB Mac에서 어디까지 돌아가나
M4 Max 128GB에서는 72B 모델까지 Q8로 바꿔 쓸 만했다. 이때 LM Studio에 표시된 MLX 최대 메모리는 96 GB였다.
이 값은 macOS가 GPU용으로 고정(wired)해 줄 수 있는 메모리의 상한이다. 통합 메모리라고 해도 전부를 GPU에 내주지는 않는다. 상한은 macOS 버전마다 조금씩 다르고, sudo sysctl iogpu.wired_limit_mb=<MB>로 올릴 수 있다. 재부팅하면 기본값으로 돌아온다. 너무 높이면 시스템이 쓸 메모리가 모자라 멈출 수 있으니 조금씩 올리는 게 좋다.
모델 파일 크기만 보고 판단하면 안 되는 이유가 하나 더 있다. 대화가 길어질수록 KV 캐시가 따로 늘어난다. Qwen2.5-72B 구조(레이어 80개, KV 헤드 8개, 헤드 차원 128)를 예로 들면 fp16 KV 캐시가 토큰당 약 0.33 MB다. 3만 2천 토큰이면 약 11 GB, 128K를 꽉 채우면 43 GB쯤 된다.
가중치 76 GB에 43 GB를 더하면 96 GB를 훌쩍 넘는다. 128K 컨텍스트를 지원하는 72B 모델이라도, 이 메모리에서 Q8로 실제로 쓸 수 있는 길이는 대략 5만 토큰 안팎이다. 더 길게 쓰려면 Q4로 내리거나, mlx-lm의 --kv-bits처럼 KV 캐시를 양자화하는 방법이 있다.
원본 캐시 정리
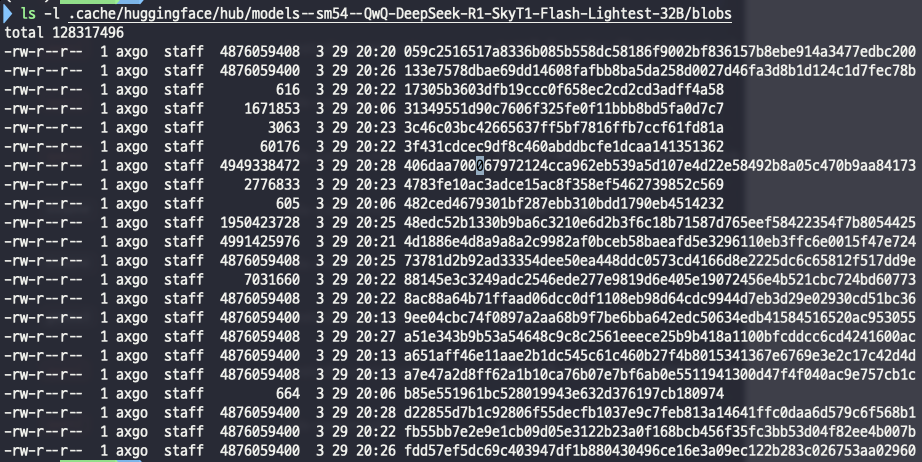
변환이 끝나도 내려받은 원본은 ~/.cache/huggingface/hub 아래에 그대로 남아 있다. 이번 모델만 해도 65 GB다. 변환한 모델이 잘 도는 것을 확인했으면 지워 두자.
hf cache ls                                                         # 캐시에 무엇이 얼마나 있는지 본다
hf cache rm model/sm54/QwQ-DeepSeek-R1-SkyT1-Flash-Lightest-32B       # 예전 CLI: huggingface-cli delete-cache
hf cache rm model/K-intelligence/Midm-2.0-Base-Instruct model/skt/A.X-4.0
Code language: Bash (bash)
참고: https://huggingface.co/mlx-community · https://github.com/ml-explore/mlx-lm