블로그를 자동으로 운영하는 시스템(blog-platform)을 만들고 있다. n8n이 RSS로 경제·투자 기사를 하루 1,500건쯤 모으고, 기사를 분류해 글감을 고르고, LLM이 초안을 쓰면 텔레그램에서 사람이 승인해 WordPress에 올린다. 모델은 Mac의 로컬 LLM(oMLX)과 무료 API를 섞어 쓰고, 유료 API는 되도록 피하는 방식이다.
처음에는 모든 판단을 LLM에게 맡겼다. 뉴스 기사가 주식 이야기인지 코인 이야기인지, 한국 시장인지 미국 시장인지, 광고인지까지 전부 LLM 모델에게 물었다. 그러다 분류작업이 들어오는 기사의 양을 소화할 수 없는 상태가 이어졌고, 분류 대기열에 1,800건 이상이 쌓여 계속 증가만 하는 상태가 발생했다. (밀린 숙제처럼 밀려 버린다고 ㅎㅎ)
이 글은 그 분류를 담당하는 LLM 역할을 결정 모델인 Jev로 변경한 작업 기록이다. 판정은 Jev가, 문장 생성은 LLM이 맡도록 나눴더니 한 회차(최대 200건)가 8~32분에서 3분대로 줄었고, LLM으로 36%가 실패하던 분류 작업이 기사 1% 미만(3,421건 중 9건) 분류가 실패하게 되었다. 요즘 이미지를 처리할 수 있다는 Cloudflare의 Clef 결정 모델로 그림 속 한글 검사를 맡기려다 실패한 이야기도 뒤에 붙였다.
목차
- LLM으로 분류하던 뉴스기사
- 무엇이 비효율이었나
- 객관식 문제를 글로 풀게 했다
- 무료 체인은 한도와 대기열을 탄다
- 답에 확신도가 없다
- 따끈한 해결사 등장 – Jev가 글을 쓰지 않고 판정만 해줄 수 있다!
- 결정모델 사용을 위해 LLM 호출 API를 하나 추가해야 한다
- Jev vs LLM 테스트로 115건을 대조해 봤다
- n8n 분류 워크플로우에 Jev 결정모델을 끼워 넣었다
- 첫 시험에서 걸린 것: 은행 해킹 기사가 '무관'으로
- Jev 결정모델의 시간·비용·정확도
- 실패: Cloudflare Clef로 그림 속 한글 텍스트 판정
- 정리: 언제 Jev를 쓰고 언제 LLM을 쓰나
LLM으로 분류하던 뉴스기사
분류 작업은 기사 한 건마다 아래 항목을 정해 DB에 기록하는 n8n 워크플로우로 동작하는 상태였다.
- 판정: 자산군(주식·코인·부동산·거시·기술·무관), 지역(한국·미국·글로벌), 긴급도(0~3), 상시성(0~1), 광고 여부
- 문장: 테마, 종목·인물, 한국어 요약, 투자 관점 한 줄
Jev로 전환하기 전에는 프롬프트 하나로 한꺼번에 LLM에 전달했다. 기사 10건을 묶어 유/무료 LLM 체인에 보내고 JSON으로 받는다. 사용중인 LLM 체인은 모든 LLM 호출이 지나가는 공용 워크플로우로, 무료 모델 여러 개를 순서대로 시도하다가 앞 모델이 한도에 걸리면 다음 모델로 넘어가도록 했다.
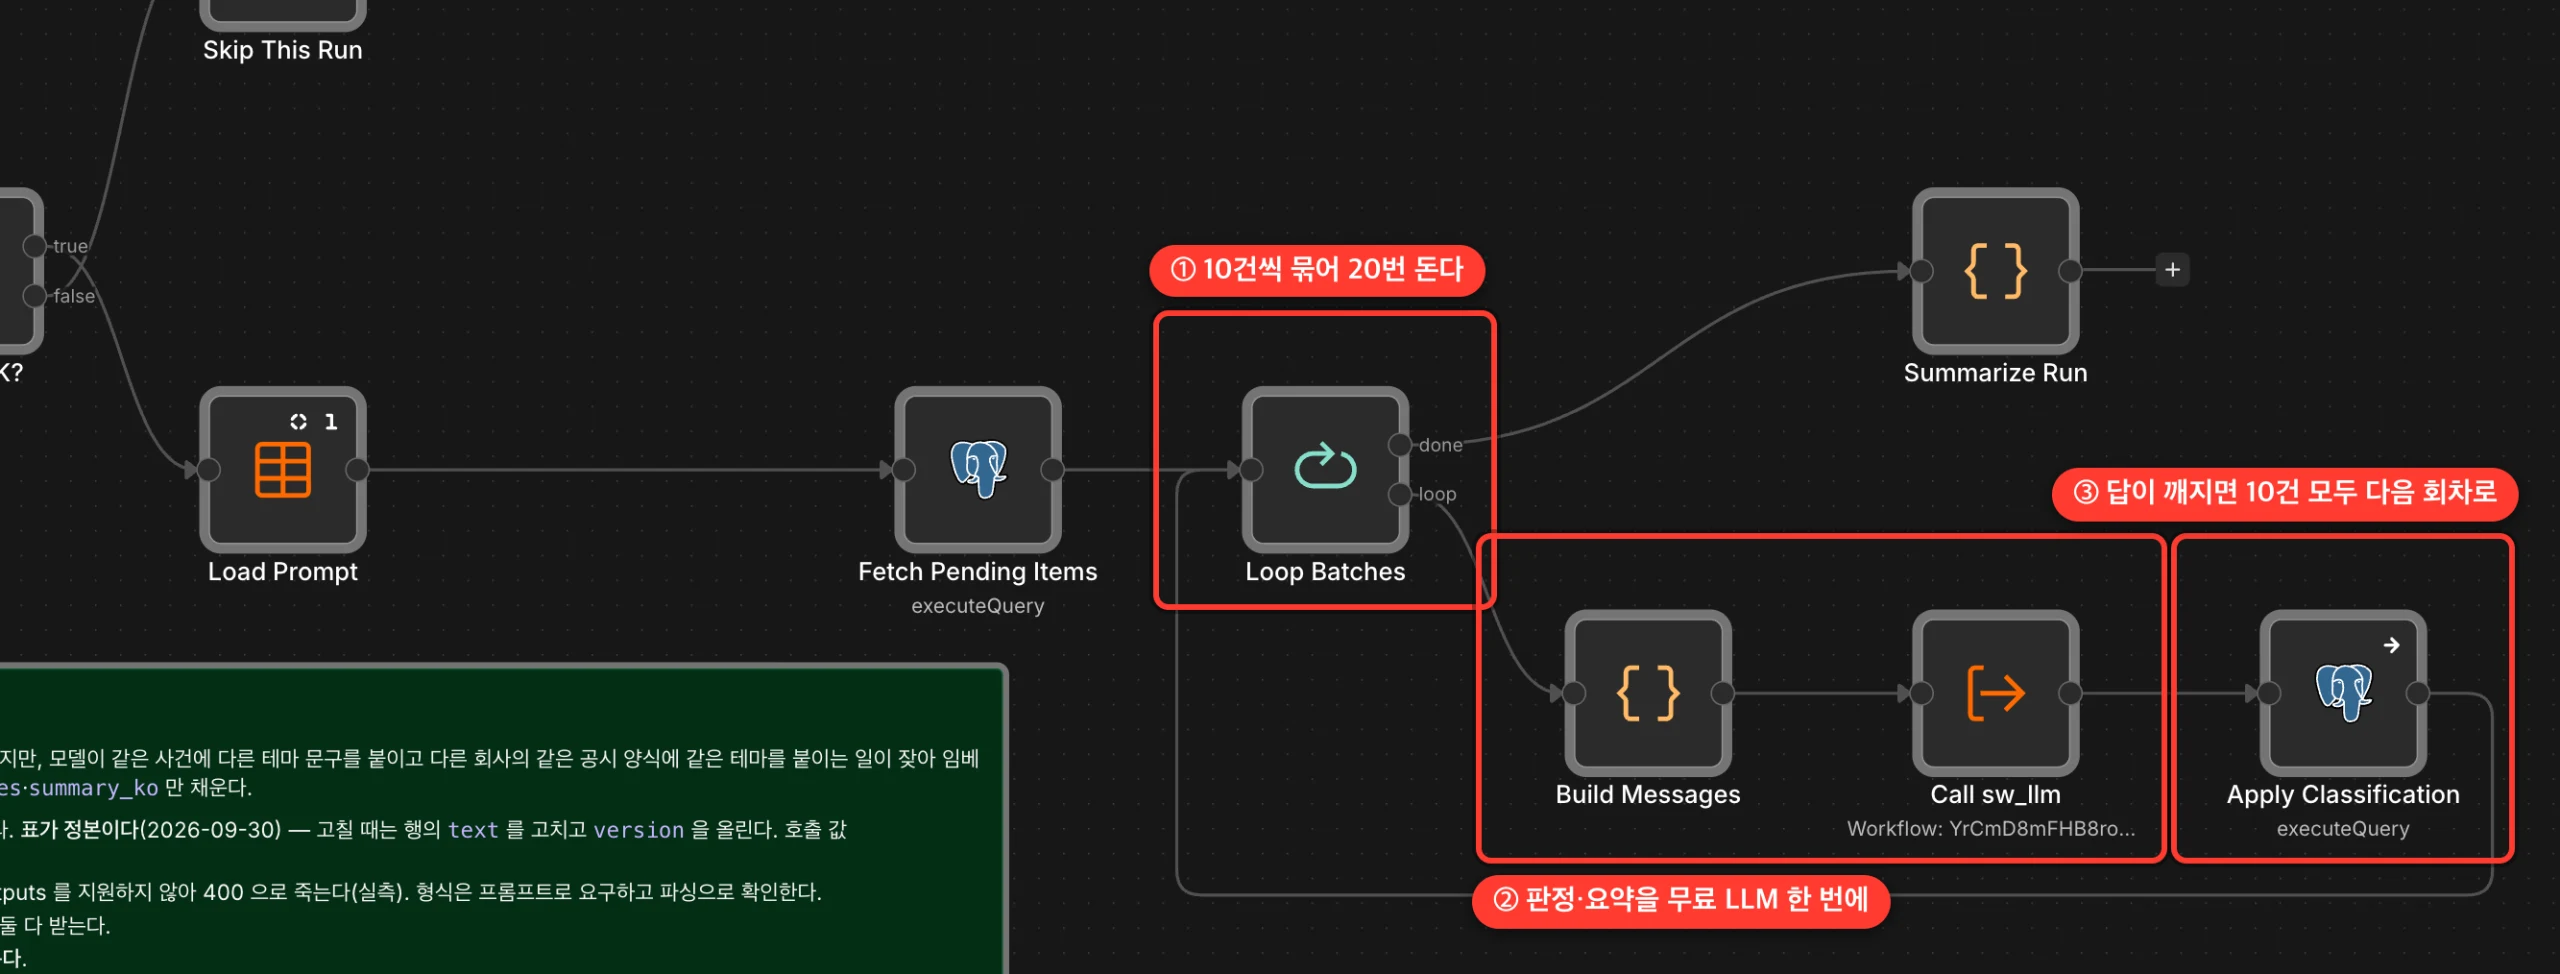
① 200건을 10건씩 묶어 20번 돈다
② 판정과 요약을 프롬프트 하나로 무료 LLM에 묻는다
③ 답이 깨지면 그 10건은 통째로 다음 회차로 밀린다.
무엇이 비효율이었나
2026-10-03에 prod 기록을 뽑아 봤다. 최근 3일 동안 분류 작업에서 LLM을 691번 불렀는데 성공은 64%였고, 10건을 묶은 한번의 분류작업이 평균 29초가 걸렸다. 200건을 처리하는 한 회차는 8분에서 32분까지 걸렸다. 하루 7회차를 돌려도 처리할 수 있는 양은 1,400건 남짓인데, 들어오는 기사는 1,500여건이었다. 집계 워크플로우가 72시간 안의 기사만 보도록 해서 오래 기다린 기사는 그대로 버려지기까지 했다.
원인은 세 가지였다.
객관식 문제를 글로 풀게 했다
자산군이나 지역은 정해진 선택지 중 하나를 고르면 끝나는 문제다. 그런데 LLM에게 물으면 답을 JSON 문장으로 써야 하고, 10건이 한 응답에 들어가니 출력이 길어진다. 무료 모델들은 출력이 길수록 느리고, JSON이 한 군데만 깨져도 10건이 함께 실패하는 경우가 발생한다. (심지어 10개를 가차없이 버린다)
무료 체인은 한도와 대기열을 탄다
무료 API는 분당 요청 수와 입력 토큰 수에 한도가 있다. Groq 무료 등급은 분당 입력이 7,000토큰이라 긴 묶음은 보내기 전에 건너뛰어야 했다. 한 모델이 실패하면 다음 모델로 넘어가는데, 그 사이 기다린 시간까지 워크플로우의 작업을 더디게 하는 원인이 된다.
답에 확신도가 없다
LLM은 애매한 기사도 같은 말투로 답한다. 얼마나 확실한지 알 수 없으니 틀린 답을 골라낼 방법이 없었다. 나중에 대조해 보니 LLM은 광고(Spam 뉴스) 칸을 ‘투자와 무관’을 모아 두는 칸으로 쓰고 있었다. 광고로 분류된 9건 가운데 실제 광고는 1~2건뿐이었고, 신한은행 AI 해킹 기사와 SEC 사기 기소, DART 투자설명서까지 광고로 처리돼 글감에서 빠졌다.
따끈한 해결사 등장 – Jev가 글을 쓰지 않고 판정만 해줄 수 있다!
Jev는 TypeSafe의 결정 모델(decision model)이고, 이 모델을 부르는 API 형식을 System One이라고 부른다. 일반 LLM API(chat/completions)가 문장을 받아 문장을 돌려준다면, System One은 판단할 내용(state)과 타입이 정해진 질문(questions)을 받아 질문마다 고른 값과 확률을 돌려준다.
질문 타입은 세 가지다.
choice: 선택지 중 하나를 고른다. 선택지마다 설명을 붙인다.score: 순서가 있는 등급 중 어디쯤인지 고른다. 등급 설명을 순서대로 적는다.noul: 예·아니오 질문이다. ‘예’일 확률을 준다.
문장을 만들지 않으니 빠르고 싸다. OpenRouter에서 Jev를 부르면 한국어 질문에 0.2~0.4초가 걸렸고, 요금은 입력 100만 토큰당 $0.042이며 출력 요금은 붙지 않는다. 뉴스 제목 하나를 분류하는 데 약 $0.00002가 든다(2026-10-01 실측). 사람이 정답을 적어 둔 뉴스 제목 10개로 시험했을 때는 29칸 중 28칸을 맞혔다.
Jev 분류 작업에서 실제로 보내는 요청은 아래와 같다. 길어서 선택지 설명 일부와 상시성 질문은 줄였다.
{
  "model": "typesafe/jev-1.13-20260917",
  "state": {
    "title": "[美특징주]어플라이드 디지털, 첫 해외 진출 계약에도 개장전↓…장 마감후 실적 발표",
    "source": "edaily-stock",
    "summary": "어플라이드 디지털(APLD)이 핀란드에 최대 1기가와트 규모의 전력 용량을 확보할 수 있는 계약을…"
  },
  "questions": {
    "asset_class": {
      "type": "choice",
      "instructions": "이 뉴스가 다루는 투자 자산군은?",
      "criteria": {
        "stock": "개별 기업(은행·증권·보험·카드 등 금융회사 포함)의 사업·사고·공시·실적, 업종, 주가·증시",
        "macro": "금리·물가·환율·중앙은행·금융당국·정부 경제정책·국가 경제지표",
        "none": "투자·경제와 무관한 생활·사회·정치·연예 기사, 광고·홍보·리딩방"
      }
    },
    "region": {
      "type": "choice",
      "instructions": "어느 시장의 이야기인가?",
      "criteria": { "kr": "한국", "us": "미국", "global": "그 밖의 나라·여러 나라·국경 없는 자산" }
    },
    "urgency": {
      "type": "score",
      "instructions": "투자자에게 얼마나 급한 소식인가?",
      "criteria": ["참고용 — 급하지 않다", "이번 주 안에 알면 된다", "오늘 알아야 한다", "지금 바로 — 장중 이벤트·공시 속보"]
    },
    "spam": { "type": "noul", "instructions": "광고·홍보·리딩방·유료 회원 모집 글인가?" }
  }
}Code language: JSON / JSON with Comments (json)
아래와 같은 답을 받을 수 있다. 지역은 미국(0.61)과 글로벌(0.22) 사이에서 망설여 확신도가 0.41로 낮다. 이 숫자가 뒤에서 LLM과 섞을 때의 기준이 된다.
{
  "asset_class": { "choice": "stock", "confidence": 1,
                   "probabilities": { "stock": 1, "tech": 0, "macro": 0, "none": 0 } },
  "region":      { "choice": "us", "confidence": 0.41,
                   "probabilities": { "us": 0.61, "global": 0.22, "kr": 0.17 } },
  "urgency":     { "score": 2.2,
                   "probabilities": { "0": 0.04, "1": 0.07, "2": 0.54, "3": 0.35 } },
  "spam":        { "noul": 0.04 }
}Code language: JSON / JSON with Comments (json)
이 한 건에 입력 1,058토큰, $0.0000444가 들었다(응답의 type 필드 등은 줄였다).
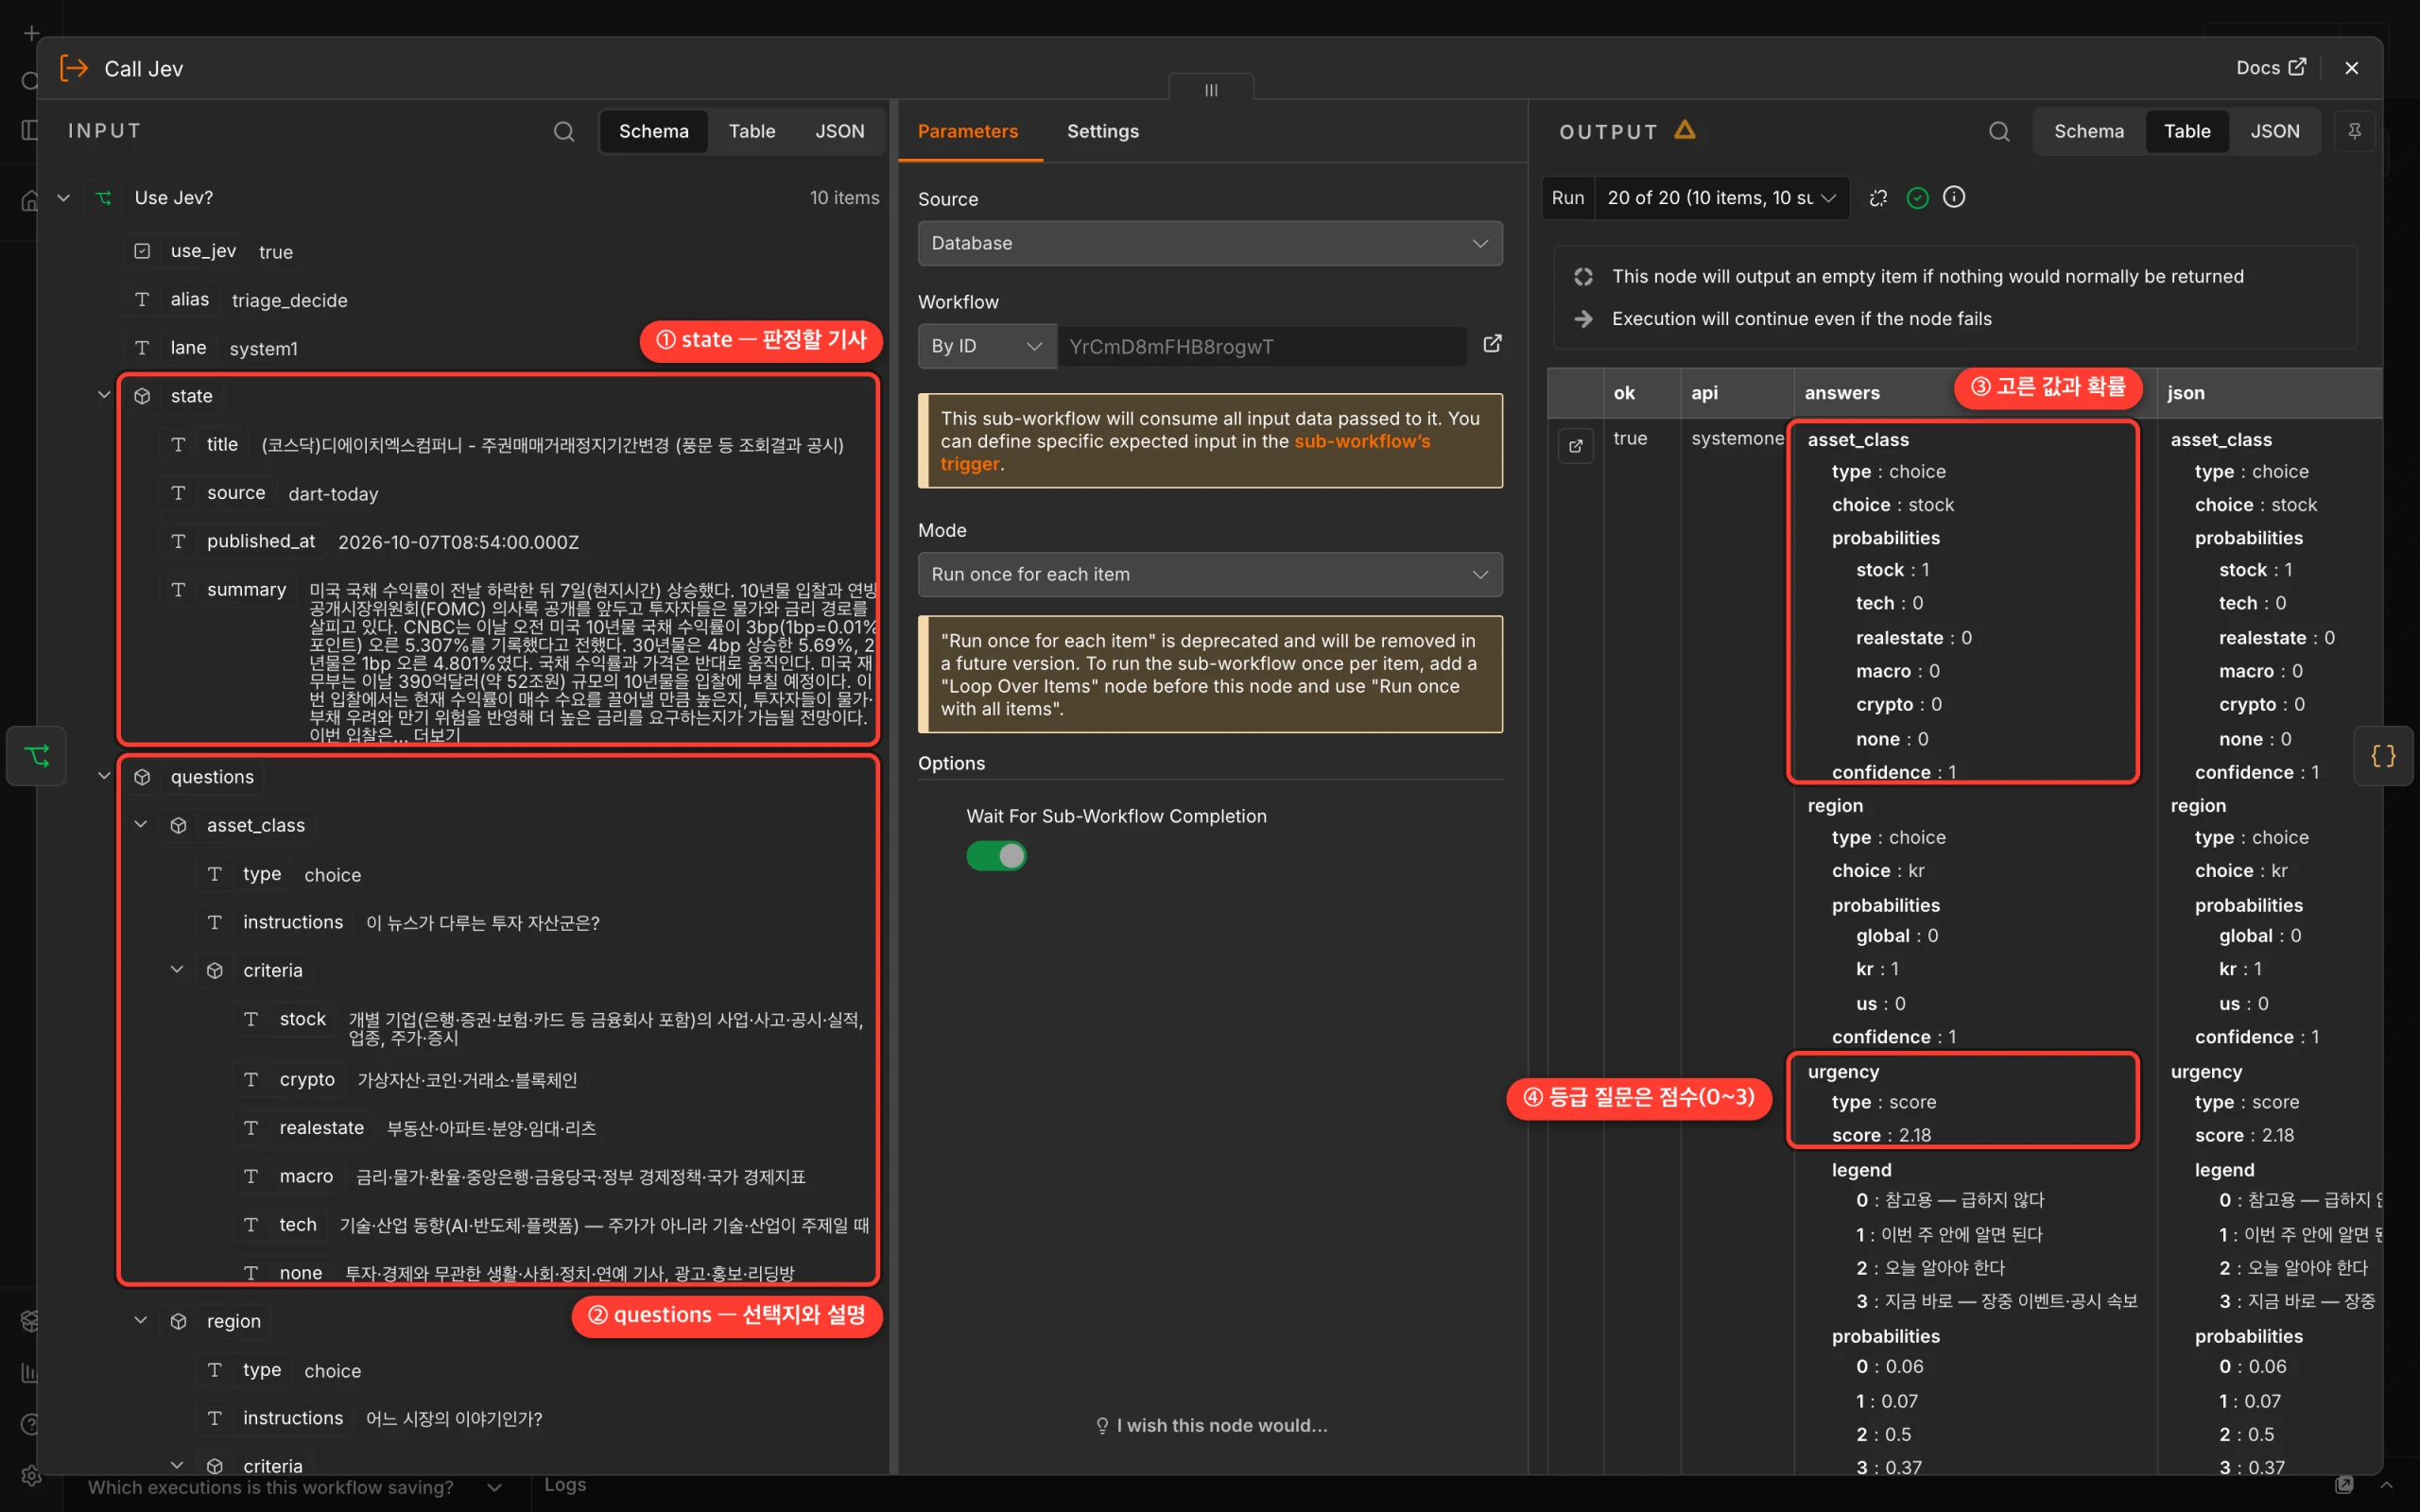
① 판정할 기사(state)
② 질문과 선택지 설명(questions)
③ 고른 값과 선택지별 확률 ④ 등급 질문은 0~3 사이 점수로 돌아온다.
결정모델 사용을 위해 LLM 호출 API를 하나 추가해야 한다
AI 모델 호출시 LLM 체인에서 용도에 따라 LLM, Jev로 경로를 나눠 API를 호출할 수 있도록 했다.
system2(LLM): OpenAI 호환 LLM 모델 chat/completions 호출용 API다. 문장을 생성하는 용도다.system1(Jev): Jev 호환 결정 모델을 호출하는 API용도다. 호출하는 쪽이questions를 넘기면 이 경로로 간다.
system1의 순서는 LLM 체인의 순서표(n8n Data table)에 적었다. 1순위는 Mac의 로컬 oMLX, 2순위는 OpenRouter의 Jev다. 로컬 모델 oMLX 서버가 System One을 지원하게 되면 코드를 고치지 않아도 그대로 1순위가 되게 하려는 배치다. 지금은 oMLX에 그 주소가 없어 404가 나는데, LLM 체인의 차단기가 404를 한 번 보면 60분 동안 oMLX를 건너뛴다. 호출마다 404를 기다리지 않게 하려는 장치다.
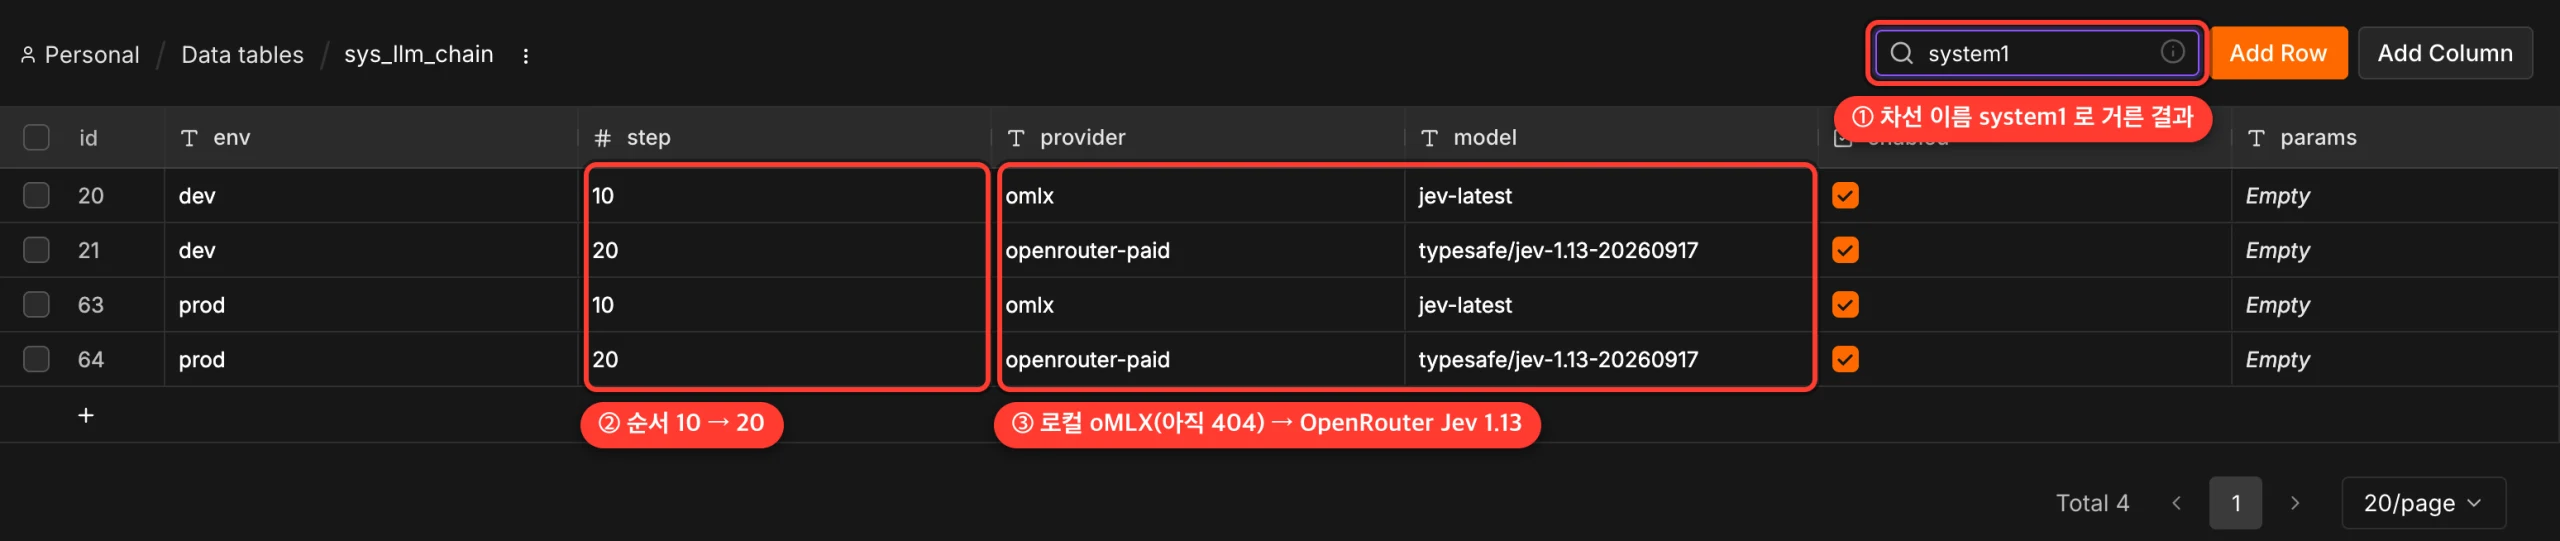
① system1 경로만 보이도록 했다
② 순서는 step 10 → 20
③ 로컬 oMLX의 jev-latest가 먼저, OpenRouter의 jev-1.13이 다음이다.
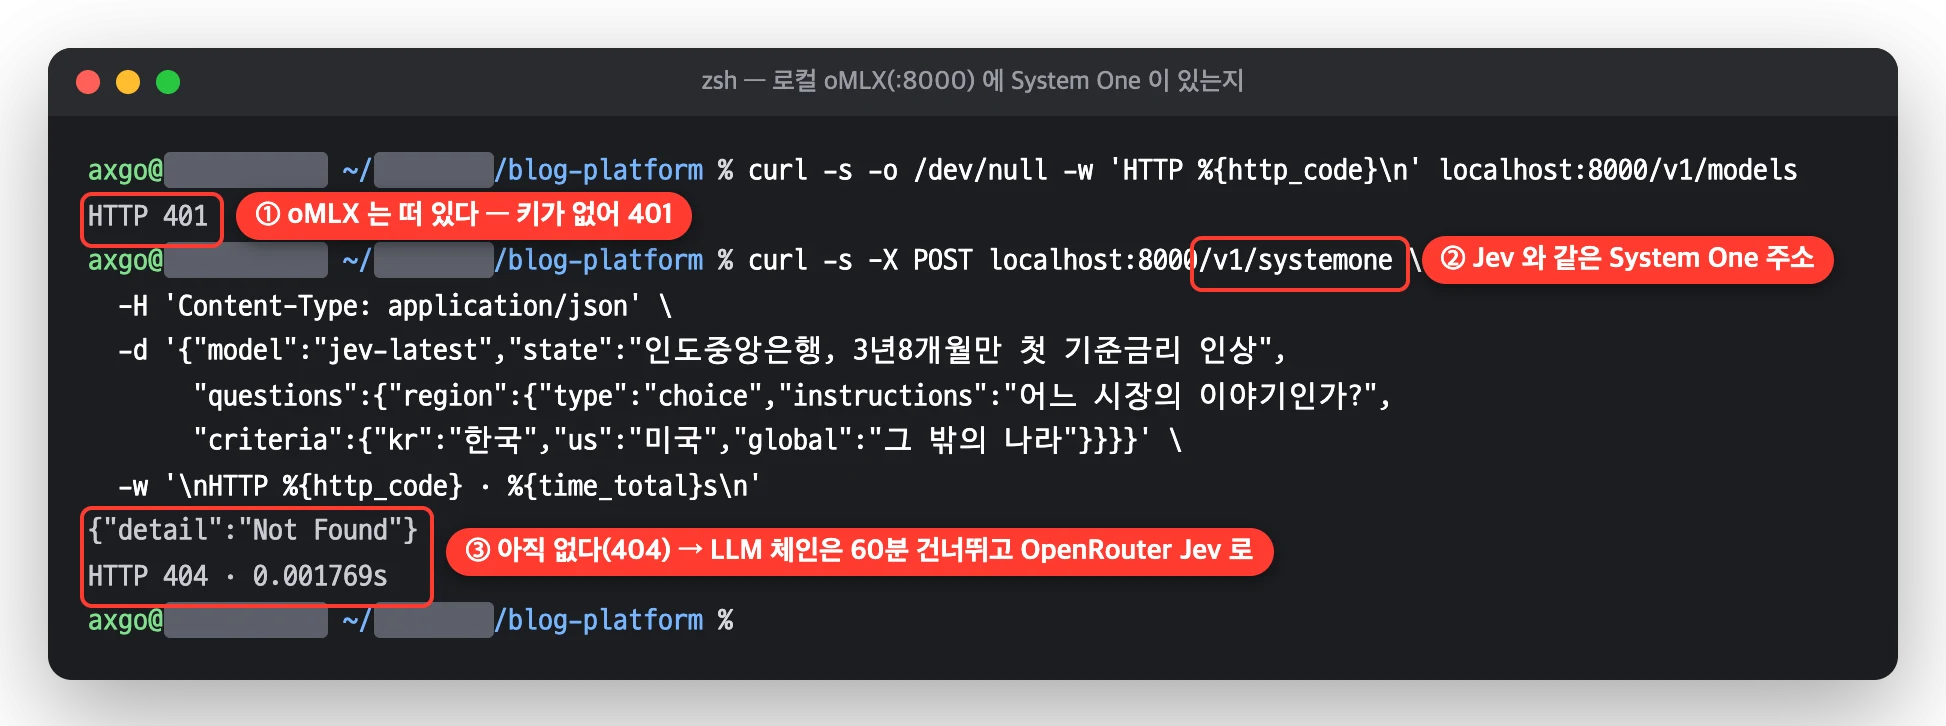
① 서버는 떠 있지만
② System One 주소에는
③ 404가 돌아온다. 그래서 지금은 2순위인 OpenRouter의 Jev가 답한다.
유료 모델 호출이 하나 생기는 셈이라 하루 상한도 걸었다. 유료 비용을 호출마다 LLM 체인의 호출 기록표에 적고, 그날 합계가 상한(paid.daily_usd)에 닿으면 Jev를 건너뛰도록 했다. (처음 상한은 $0.2였다)
Jev 버전은 latest에서 1.13 으로 고정했다. 처음에는 최신 판을 따라가게 뒀는데, 버전이 바뀌면 분류 기준이 모르는 사이에 바뀔 수도 있어서다. 지금은 typesafe/jev-1.13-20260917을 쓰고, 새 판이 나오면 아래의 대조 시험을 다시 돌린 뒤 바꿀 생각이다.
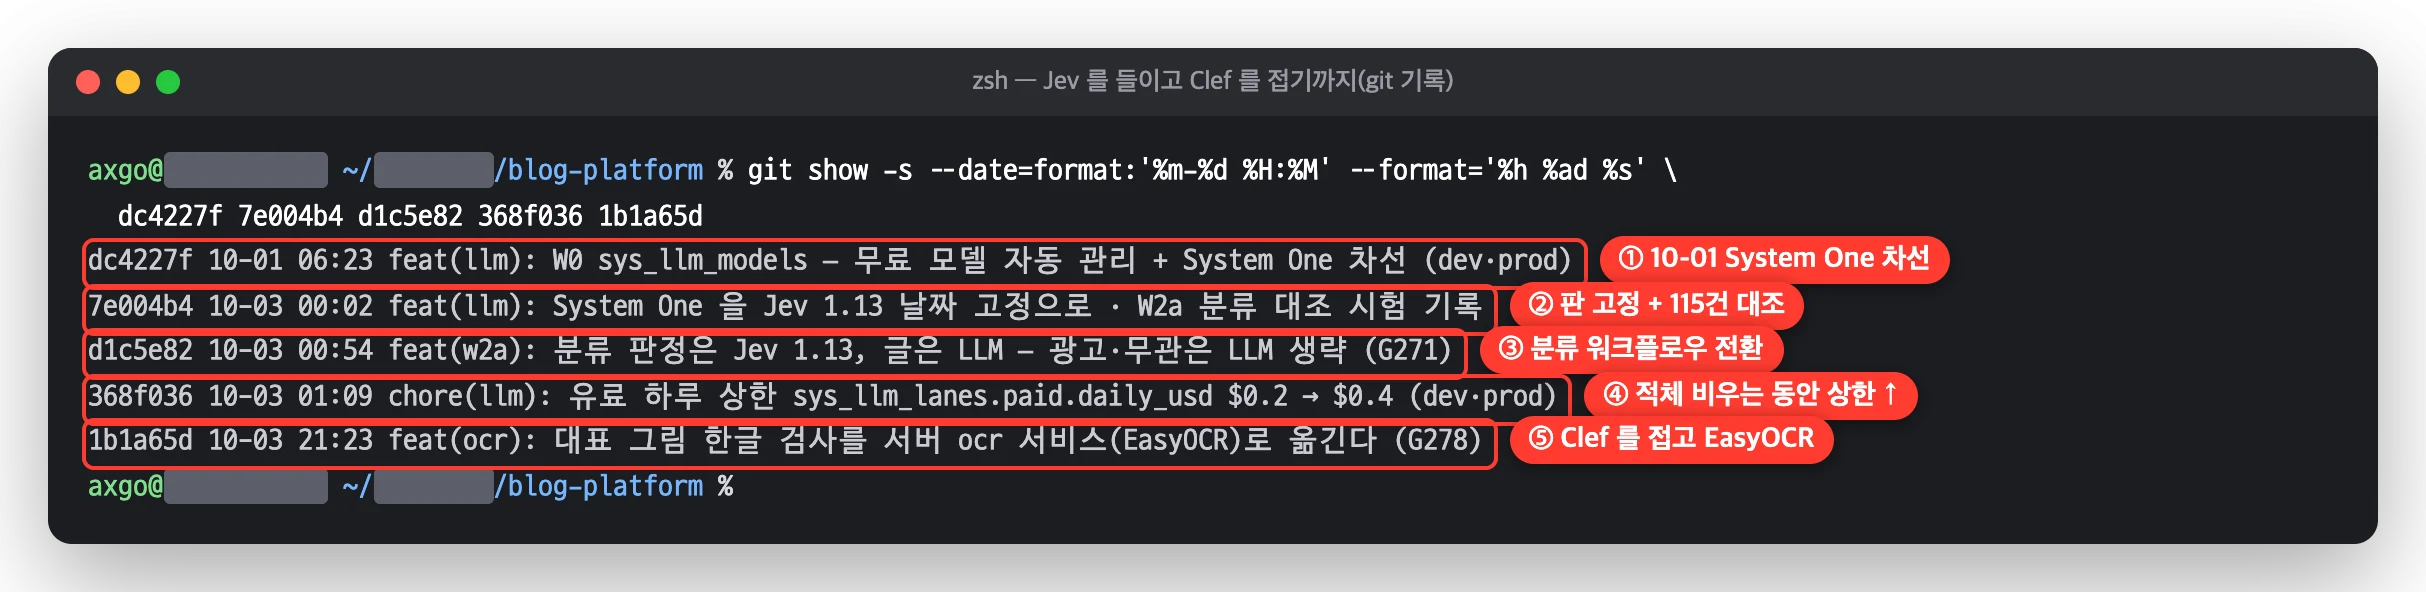
① 10-01 System One 차선
② 판 고정과 115건 대조 시험
③ 분류 워크플로우 전환
④ 쌓인 기사를 비우는 동안 유료 상한을 올림
⑤ Clef 시험이 실패한 뒤 EasyOCR로 바꿈.
Jev vs LLM 테스트로 115건을 대조해 봤다
곧바로 바꾸지 않고, prod에서 최근 3일 동안 분류된 기사 115건을 카테고별로 고르게 뽑아 LLM이 이미 낸 답과 Jev의 답을 비교했다. 입력은 같은 제목·요약·출처·시각이다. Jev는 115건 모두 답했고, 한 건에 평균 0.25초, 입력 948토큰, 약 $0.00004가 들었다. (Jev는 Input만 돈을 받고 Output은 돈을 안 받음)
| 항목 | 일치율 | 정답 판정 |
|---|---|---|
| 자산군 | 67%(77/115) | 일치하지 않은 38건 중 Jev의 정답=21 / LLM정답=5, 추정 정확도는 Jev 약 90%, LLM는 약 76% |
| 지역 | 89%(102/115) | 일치하지 않은 13건 중 Jev가 맞음 5, LLM이 맞음 5, Jev가 틀린 답은 모두 확신도 0.44 이하였다 |
| 광고 | 0%(2/115) | 실제 광고는 2건 정도였는데 LLM이 광고로 판단한건 9건 Jev는 광고와 ‘투자와 무관’을 따로 분류함. |
| 긴급도 | – | 정답이 없는 판단에서 Jev는 美 PCE·HBM 가격·은행 해킹처럼 시장 소식을 2로, LLM은 0으로 둔 경우가 많았다 |
LLM과 Jev의 오답에는 약간의 편향이 있는듯 했다. LLM은 의료비·캠핑 숯·청년 지원금 같은 생활 기사를 거시경제로, 워비파커 급등 같은 종목 기사를 기술(tech)로 분류하고, Jev는 골프장 회원 모집 광고를 부동산으로, 구글 어시스턴트 종료를 주식으로 보는 정도였다.
테스트에서 가장 쓸모 있었던 것은 확신도다. Jev가 확신도 0.8 이상으로 답한 92건은 LLM과 76% 정도로 정답이 일치했고, 0.5 이하로 답한 8건은 25%만 같았다. 확신도가 낮은 답들은 실제로 애매한 부분이 많은 기사였다. 그래서 확신도 0.5 이상이면 Jev의 답을 사용하고, 그보다 낮으면 LLM의 답을 사용하기로 했다.
나눈 일은 이렇다.
- Jev: 자산군·지역·긴급도·상시성·광고. 선택지가 정해진 판정에 사용.
- LLM: 테마·종목·투자 관점·한국어 요약. 문장을 생성 하는 일이다. 한국어 요약 생성도 영어 기사의 요약을 한국어로 바꾸는 일까지 해야하기 때문에 LLM으로 처리하는 편이 나을 것 같았다.
n8n 분류 워크플로우에 Jev 결정모델을 끼워 넣었다
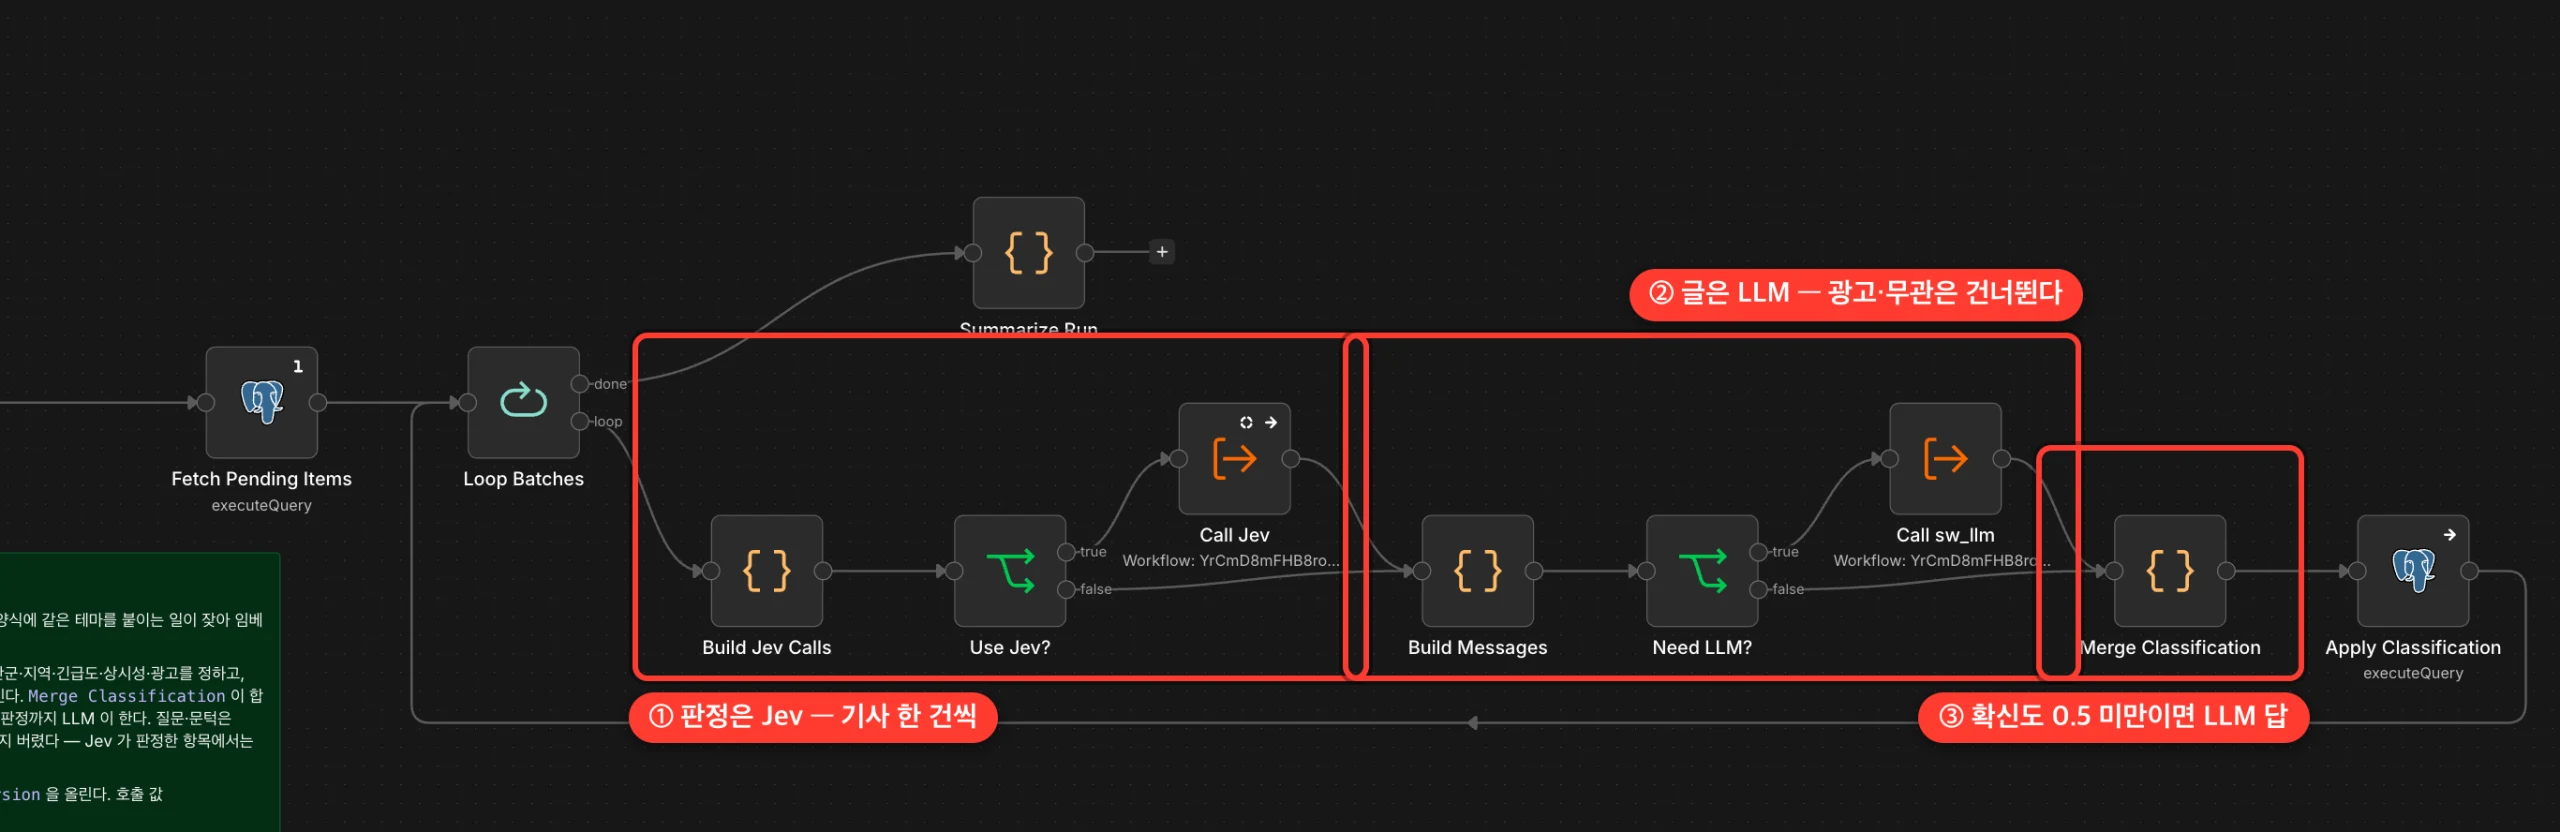
① 기사마다 Jev에 판정을 묻는다
② LLM에는 문장만 묻고, 광고·무관 기사는 LLM을 건너뛴다
③ 확신도 0.5 미만인 판정은 LLM 답으로 바꾼다.
흐름은 다섯 단계다.
Build Jev Calls: 10건 묶음 안의 기사마다 System One 요청을 만든다. 질문과 문턱은 프롬프트 표(sys_prompts)의byitx_triage-decide행에 있어서, 질문을 고칠 때 워크플로우를 건드리지 않는다.Call Jev: 기사마다 LLM 체인을system1차선으로 부른다.Build Messages: 광고 확률이 0.5 이상이거나 ‘무관’ 확신도가 0.9 이상이면 LLM을 부르지 않는다. 나머지는 문장만 묻는 짧은 프롬프트(byitx_triage-text)로 보낸다. Jev 답이 없으면(상한 초과·장애) 예전의 전체 프롬프트로 돌아간다.Call sw_llm: 무료 LLM 체인을 부른다(노드 이름에는 LLM 체인의 옛 이름 sw_llm이 남아 있다).Merge Classification: 두 답을 합친다. 자산군과 지역은 Jev 확신도가 0.5 미만이면 LLM 답을 쓰고, Jev가 판정한 기사에서는 LLM의 광고 판정을 버린다.
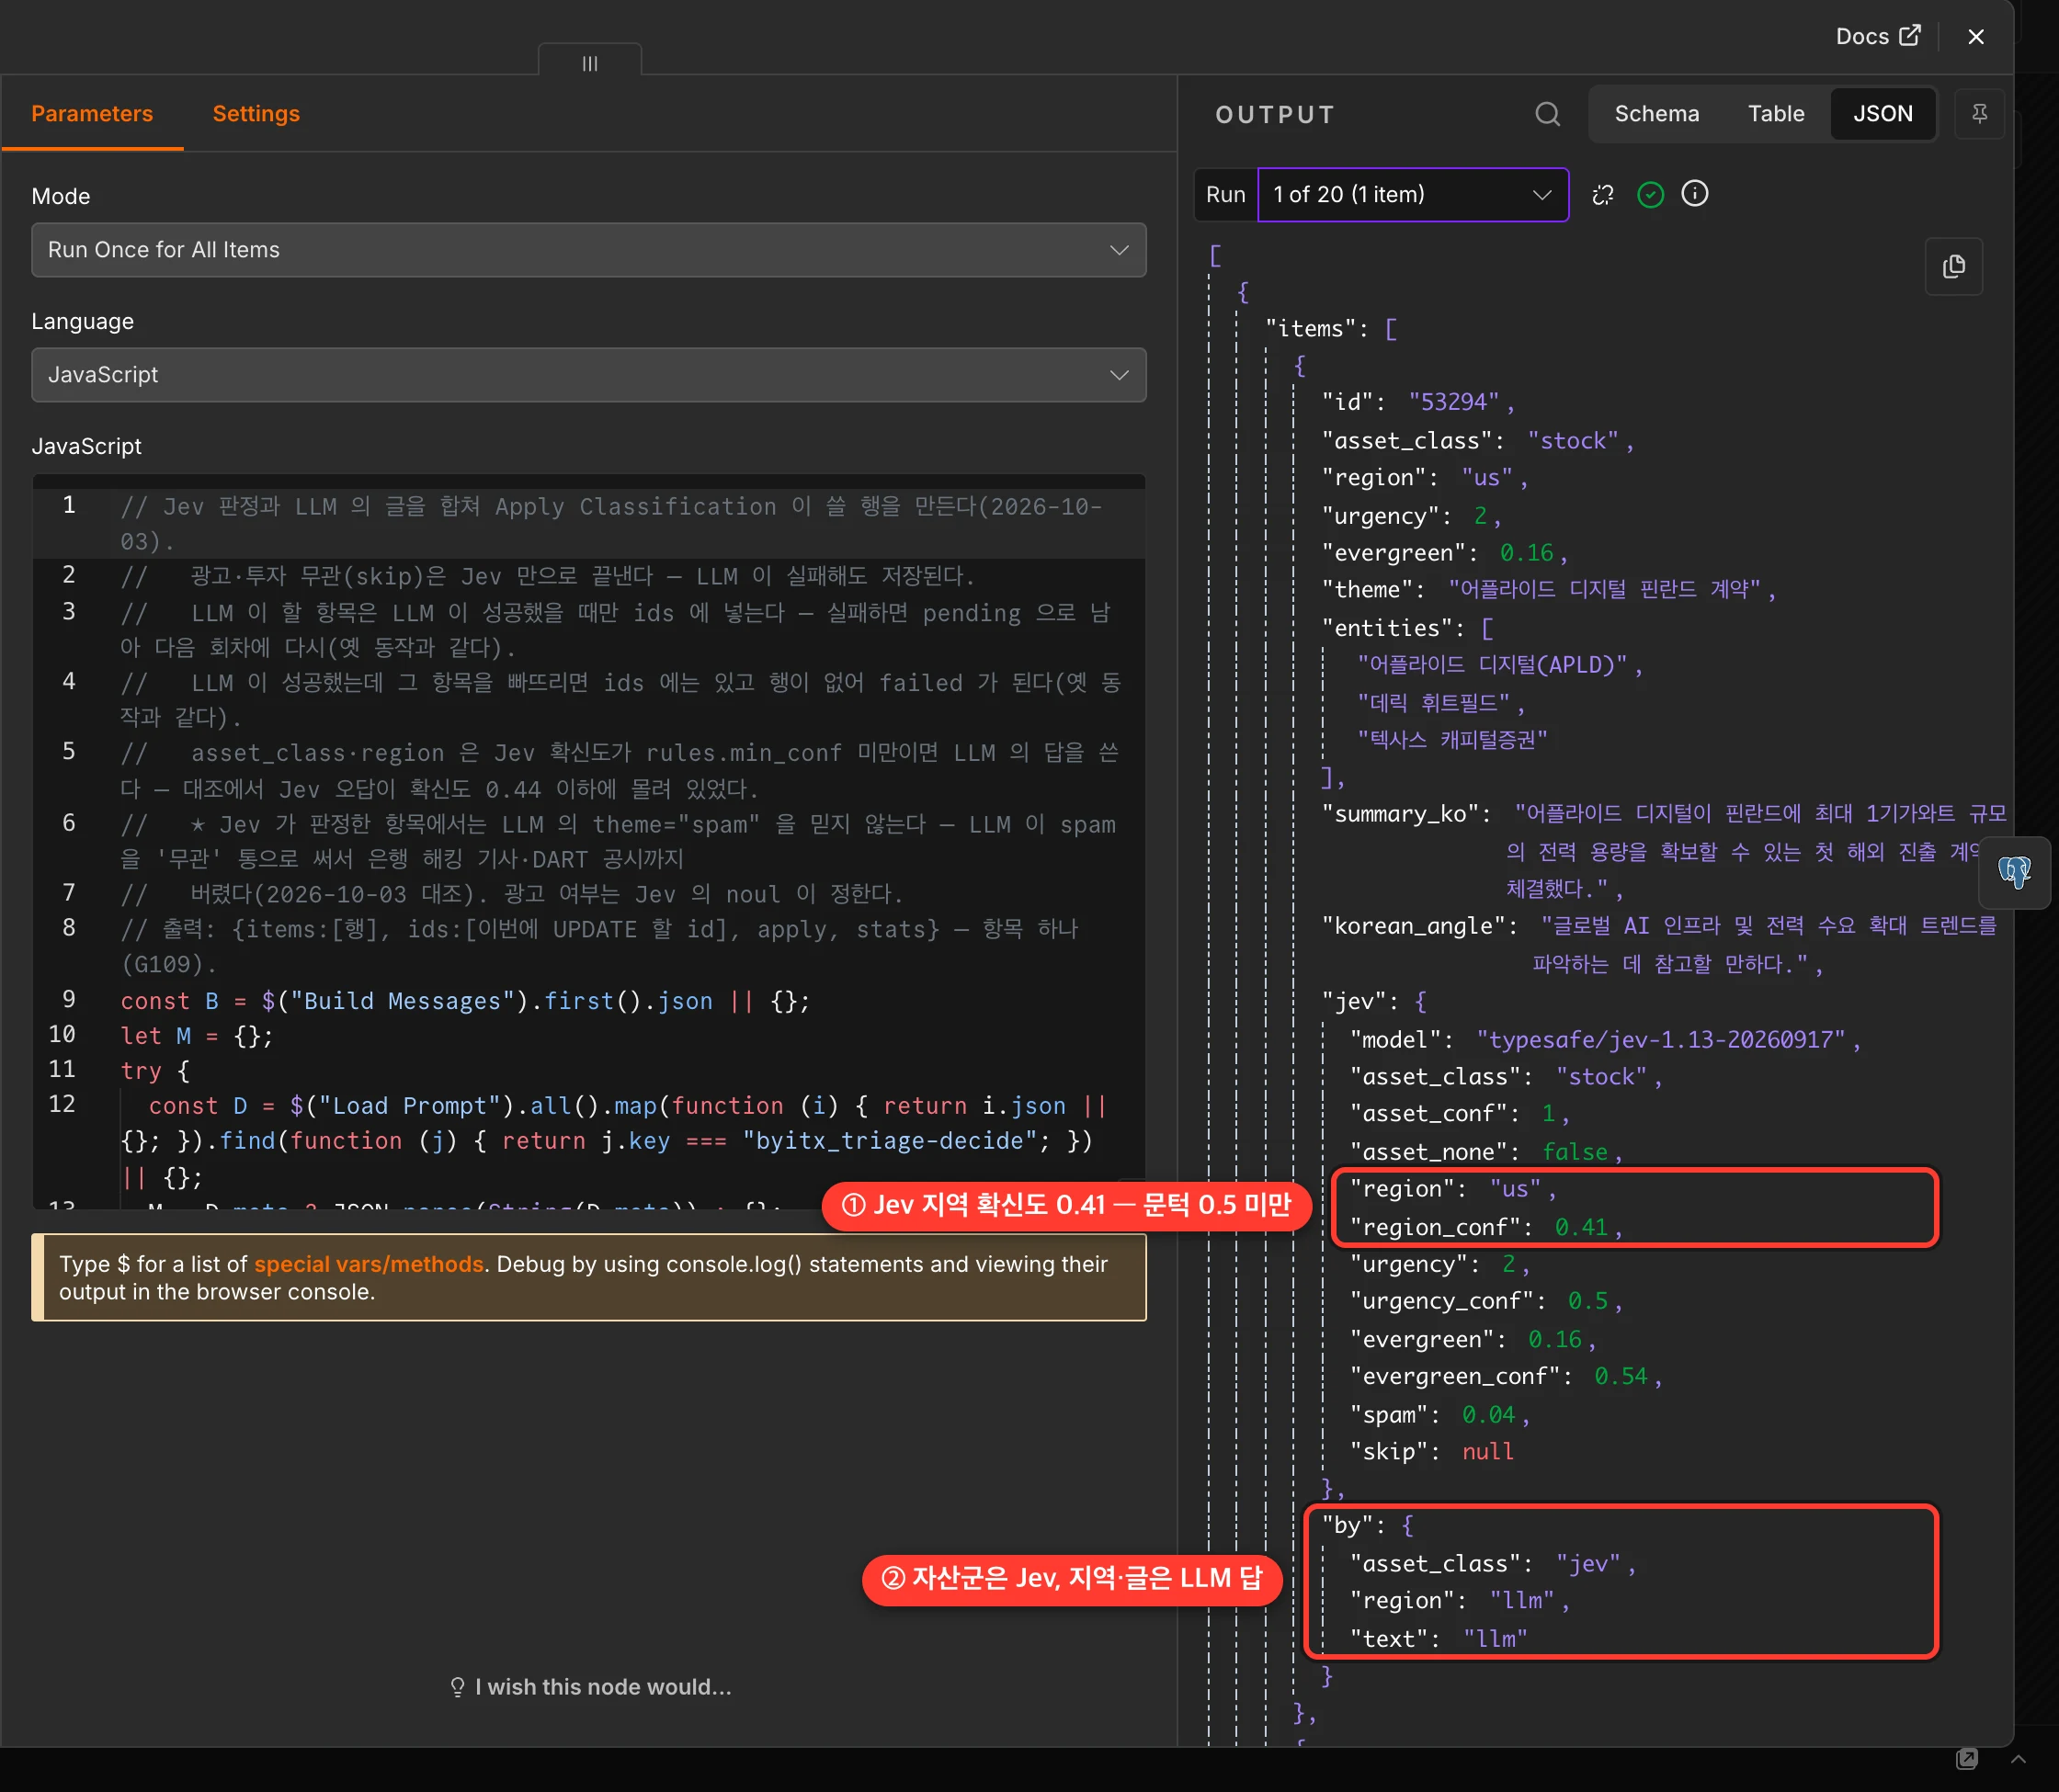
① Jev가 지역을 us로 골랐지만 확신도가 0.41이라
② 지역은 LLM 답을 쓰고 자산군은 Jev 답을 썼다. 어느 쪽 답을 썼는지 by에 남는다.
dev에서 한 회차(200건)를 세어 봤더니 판정 두 개를 모두 Jev 답으로 쓴 기사가 179건, 지역만 LLM 답으로 바꾼 기사가 9건, 자산군만 바꾼 기사가 9건, Jev 판정에서 광고나 무관으로 분류되어 LLM을 아예 호출하지 않은 기사가 3건이었다.
첫 시험에서 걸린 것: 은행 해킹 기사가 ‘무관’으로
dev 첫 실행(200건, 6.3분)은 실패 없이 끝났다. 그런데 결과를 들여다보니 Jev가 금융회사·금융당국 기사를 투자와 무관하다고 봤다. 저축은행 해킹 기사는 ‘무관’ 확신도 0.91로 LLM 단계까지 건너뛰었다. 선택지 설명에 금융회사라는 말이 없었기 때문이다.
주식(stock) 설명에 “은행·증권·보험·카드 등 금융회사 포함”을, 거시(macro) 설명에 “금융당국”을 넣었다. 그러자 세 기사가 모두 주식(확신도 0.87~0.98)으로 바뀌었고, 금융위원회 기사는 확신도 0.49로 LLM에 넘어갔다. 115건을 다시 돌렸을 때 LLM과 같은 답도 77건에서 80건으로 늘었다. Jev에 전달하는 선택지 설명이 곧 프롬프트 역할을 한다. 따라서, 경계에 걸리는 사례는 설명에 직접 적어야 한다.
Jev 결정모델의 시간·비용·정확도
prod에 적용한 뒤 첫 회차는 200건을 3.9분에 끝냈다. 실패는 0건, Jev 비용은 $0.008이었다. 그 뒤 10-05 05:40부터 10-07 22:00(KST)까지 21회차의 기록을 모으면 아래와 같다.
| 항목 | 전환 전(LLM만) | 전환 후(Jev + LLM) |
|---|---|---|
| 한 회차(최대 200건) | 8~32분 | 0.6~8.5분, 중앙값 3.4분 |
| 기사 한 건당 | 2.4~9.6초 | 1.2초 |
| 실패 | LLM 호출의 36%가 실패, 그 묶음 10건은 다음 회차로 | 3,421건 중 9건(0.26%) |
| 분류 대기열 | 1,828건 | 10-05 07:00 회차에 남은 기사 31건. 쌓인 기사가 다 빠졌다 |
| 자산군 정확도(115건 대조) | 약 76% | 약 90% |
| 광고 판정 | 은행 해킹·SEC 기소·DART 공시까지 광고로 버림 | 광고를 따로 판정하고, 광고·무관만 LLM을 생략 |
| 분류 비용 | $0 (무료 LLM체인) | Jev 건당 약 $0.00004, 하루 1,500건이면 약 $0.06 |
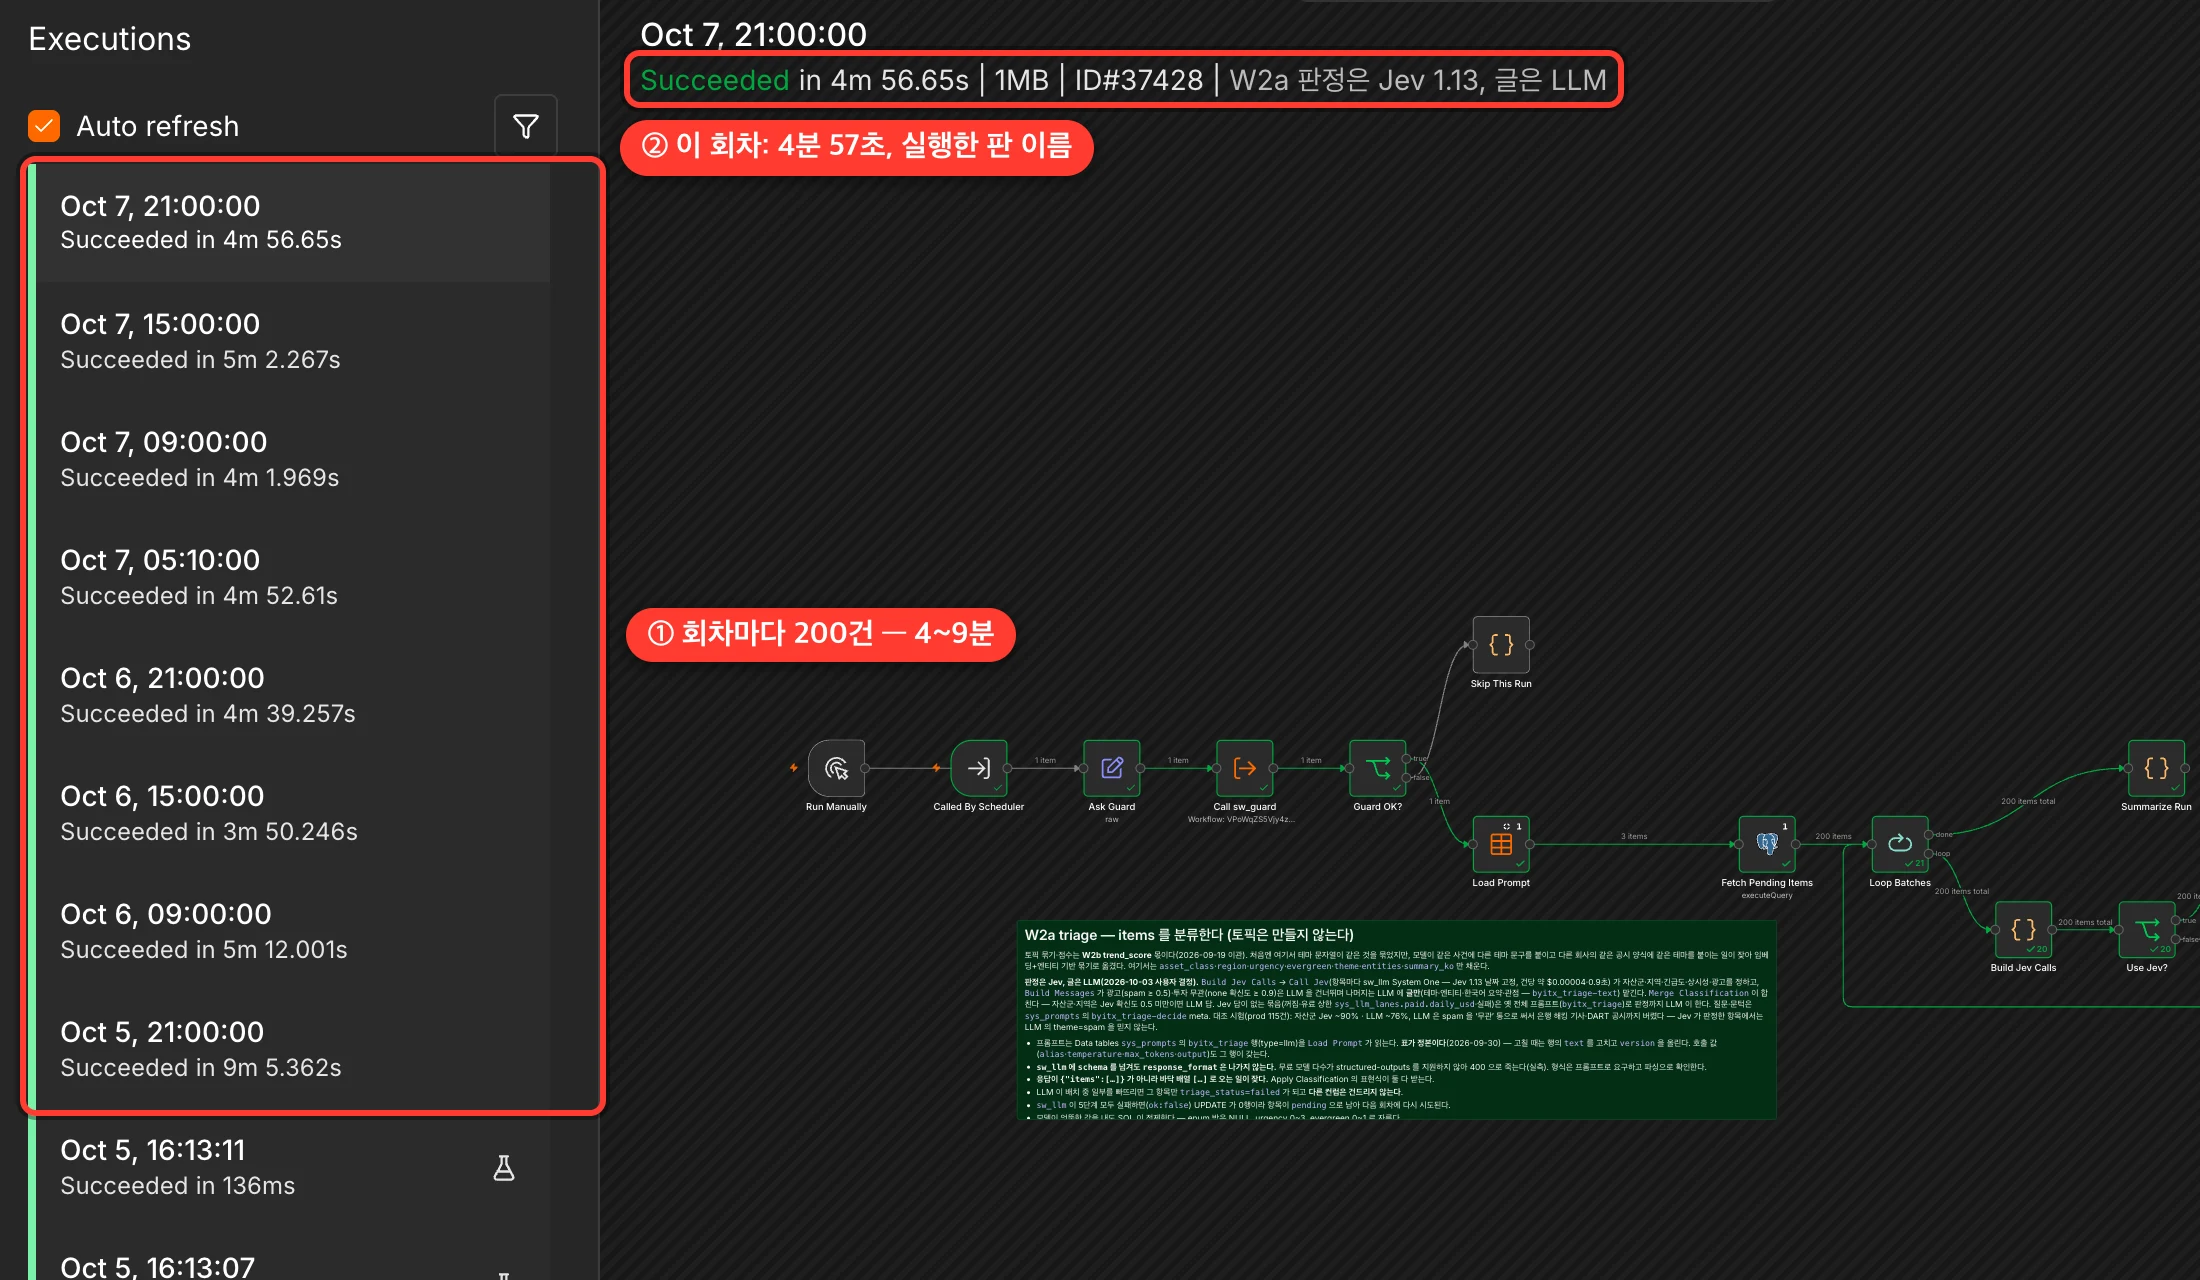
① 회차마다 200건을 4~9분에 처리한다
② 실행 머리에 걸린 시간과 그 회차를 돌린 워크플로우 판 이름이 남는다.
하루로 보면 n8n이 분류에 쓰는 시간이 1~4시간에서 25분 안팎으로 줄었다. 비용은 0에서 하루 6센트쯤으로 늘었지만, 한 달로 쳐도 2달러가 안 된다.(아아 한잔 포기!) LLM 쪽 부담은 확실히 가벼워졌다. 문장만 묻는 프롬프트는 짧고, 광고·무관 기사는 아예 보내지 않으니 무료 체인의 첫 모델이 대부분 처리할 수 있게 되었다. prod 첫 회차에서는 20묶음이 모두 첫 시도에 성공했다.
쌓인 기사를 비우는 며칠 동안은 유료 상한을 $0.4로 올리고 진행했다. 지금은 기획·판정용 유료 모델과 합쳐 하루 $5 상한 안에서 돈다. 상한에 닿아도 분류가 멈추지는 않는다. Jev를 건너뛰고 예전의 LLM 전체 프롬프트로 돌아갈 뿐이다.
남은 숙제도 있다. 10-06 낮부터는 회차마다 상한 200건을 꽉 채우고 있다. 이 200은 한 회차에 가져오는 기사 수 설정이지 모델 속도의 한계가 아니다. 회차가 3~5분이면 끝나니, 유입이 더 늘면 이 숫자를 올리면 된다.
실패: Cloudflare Clef로 그림 속 한글 텍스트 판정
Jev가 잘 맞자 같은 방식을 다른 곳에도 써 보고 싶었다. 블로그 대표 그림에는 이미지 모델이 그린 한글 문구가 들어가는데, 받침 하나가 틀리는 오자가 자주 난다. 그때까지는 Mac의 Vision OCR로 글자를 읽어 검사했는데, Mac이 꺼져도 돌아가도록 이 검사를 서버로 옮기고 싶었다.
마침 10월 1일에 Cloudflare가 Workers AI에 결정 모델 Clef(27B)와 Clef-flash(9B)를 내놨다. Jev와 같은 System One API를 쓰고 그림까지 입력으로 받을 수 있다고 한다. 요금은 입력 100만 토큰당 Clef가 $0.24, Clef-flash가 $0.09이고, Workers AI는 하루 10,000 뉴런까지 무료다. 그림과 함께 “그림 속 큰 글자가 정확히 ‘금리 상승의 압박’인가?” 같은 noul 질문을 던지면 될 것 같았다.
대표 그림 19장(정상 12장, 불량 7장: 오자 3, 깨진 글자 3, 가짜 간판 글자 1)으로 시험했다. 결과는 실패였다.
- 원본 크기(1344×768)는 보내지도 못했다. Cloudflare가 요청 크기로 토큰 수를 측정하는데, 그림 한 장이 116,008토큰으로 잡혀 문맥 한도 65,536을 넘는다며 413을 돌려줬다. 130KB 이하로 줄여야 보낼 수 있었다. ㅠㅠ
- 줄여서 보내니 답은 왔지만 오자를 가려내지 못했다. 불량을 한 장도 통과시키지 않게 문턱을 잡으면 정상 그림은 Clef-flash가 12장 중 7장, Clef가 5장만 통과했다. prod에서 실제로 사고가 났던 ‘압막'(압박의 오자) 그림을 Clef는 0.92~0.94로 ‘정확하다’고 봤다. 정상 그림 여러 장보다 높은 값이다.
- 비교 삼아 Workers AI의 비전 모델(llama-4-scout, mistral-small, qwen3.8)에게 글자를 받아 적게 했더니, 오자를 ‘압박’으로 고쳐 적었다. 불량 7장 중 3~4장이 통과했다.
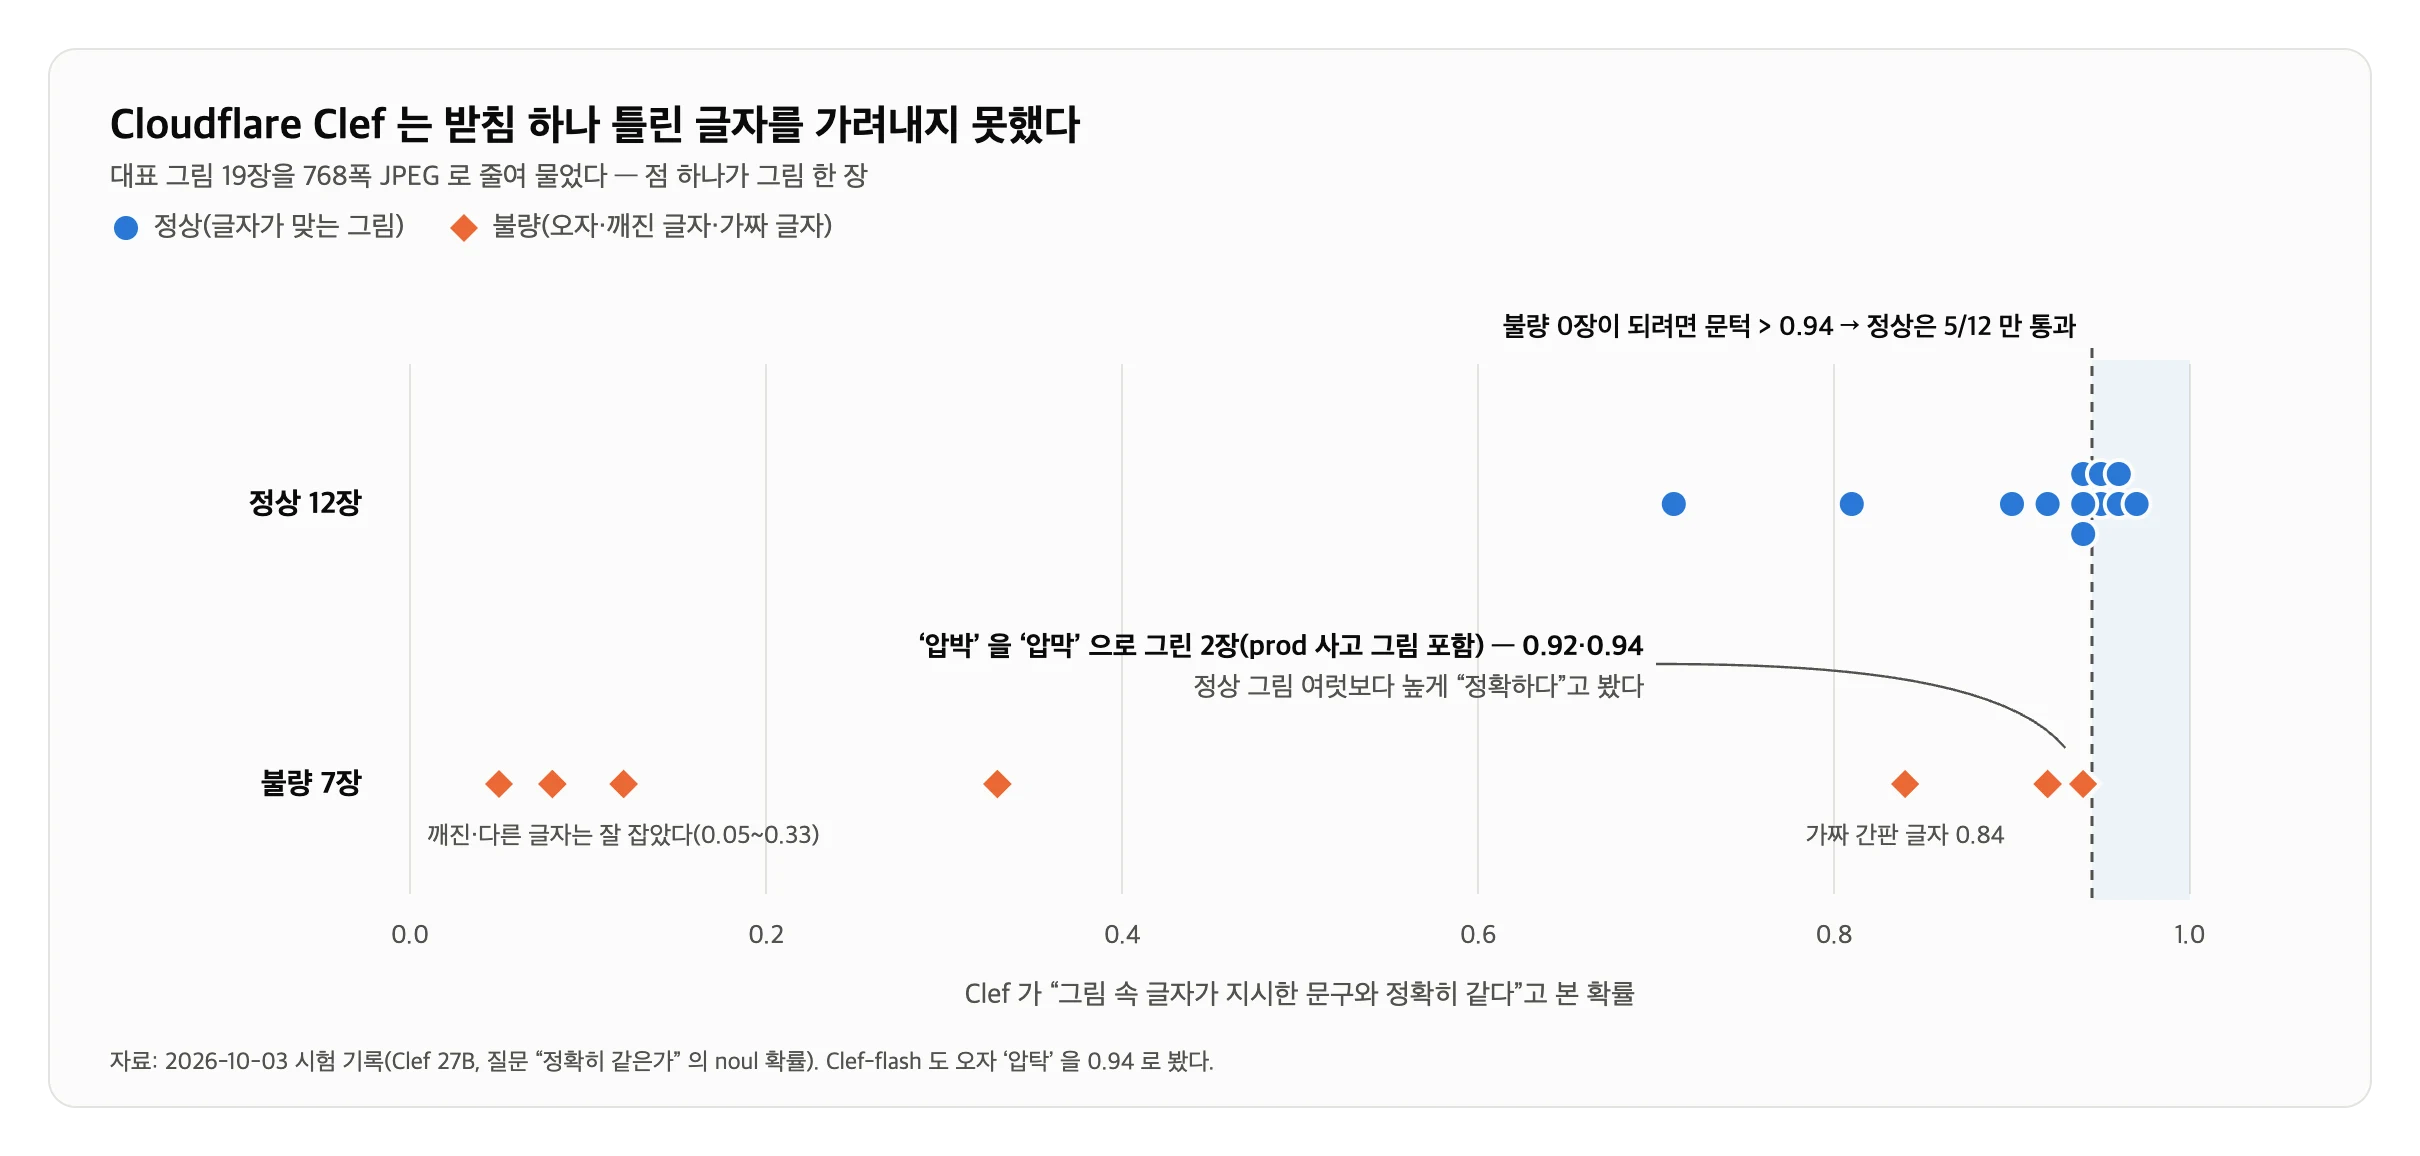
결정 모델은 문장의 뜻을 보고 고른다. ‘금리 상승의 압박’과 ‘금리 상승의 압막’은 뜻으로 보면 같은 문장이고, 모델은 받침 획 하나를 따로 읽지 않는다. Jev가 기사 분류를 잘하는 까닭과 Clef가 오자를 못 잡는 까닭이 같은 곳에 있었다.
결국 글자 검사는 서버 컨테이너에서 도는 EasyOCR로 바꿨다. 원본 크기로 읽히면 정상 10/12, 불량 0/7이었다. 줄여서 읽히면 8/12, 1/7로 나빠져서 원본 그대로 읽힌다. 한 장 읽는 데 서버에서 12초쯤 걸리지만, 그림 한 장을 그리는 데 35~150초가 걸리니 문제가 되지 않는다.
정리: 언제 Jev를 쓰고 언제 LLM을 쓰나
- 답이 정해진 선택지 중 하나면 System One(Jev)에 묻는다. 빠르고, 싸고, 확률이 붙는다.
- 문장을 만들어야 하면 LLM에 묻는다. 요약·테마·관점은 계속 LLM의 몫이다.
- 둘을 섞을 때는 확신도로 나눈다. 나의 데이터에서는 0.5가 경계였다.
- 선택지 설명이 곧 프롬프트다. 금융회사·금융당국처럼 경계에 걸리는 사례는 설명에 직접 적는다.
- Jev 버전은 날짜까지 고정하고, 바꿀 때는 대조 시험을 다시 한다.
- 이미지의 글자 모양(오자) 판정은 결정 모델이 아니라 OCR에 맡기는편이 좋다.